


Úvod
Efektivita AI agentov kriticky závisí od jedného základného faktora: mať prístup k správnym informáciám v správnom čase. Keď organizácie interne nasadzujú čoraz sofistikovanejších AI agentov, objavil sa jasný vzorec – keď agenti dostávajú riadne pripravený a indexovaný kontext, ich presnosť sa dramaticky zlepšuje a zároveň ich spotreba tokenov výrazne klesá. Tento posun predstavuje zásadnú zmenu v tom, ako uvažujeme o architektúre AI agentov. Namiesto poskytovania surového, nefiltrovaného prístupu ku všetkým dostupným dátam sa moderné prístupy zameriavajú na budovanie inteligentných kontextových enginov, ktoré slúžia ako mozog AI systémov. V tomto článku preskúmame, ako vytvoriť a implementovať kontextový engine, prečo je dôležitý pre vašu organizáciu a ako môže znížiť prevádzkové náklady a zároveň zlepšiť výkon agentov.
Čo je kontextový engine?
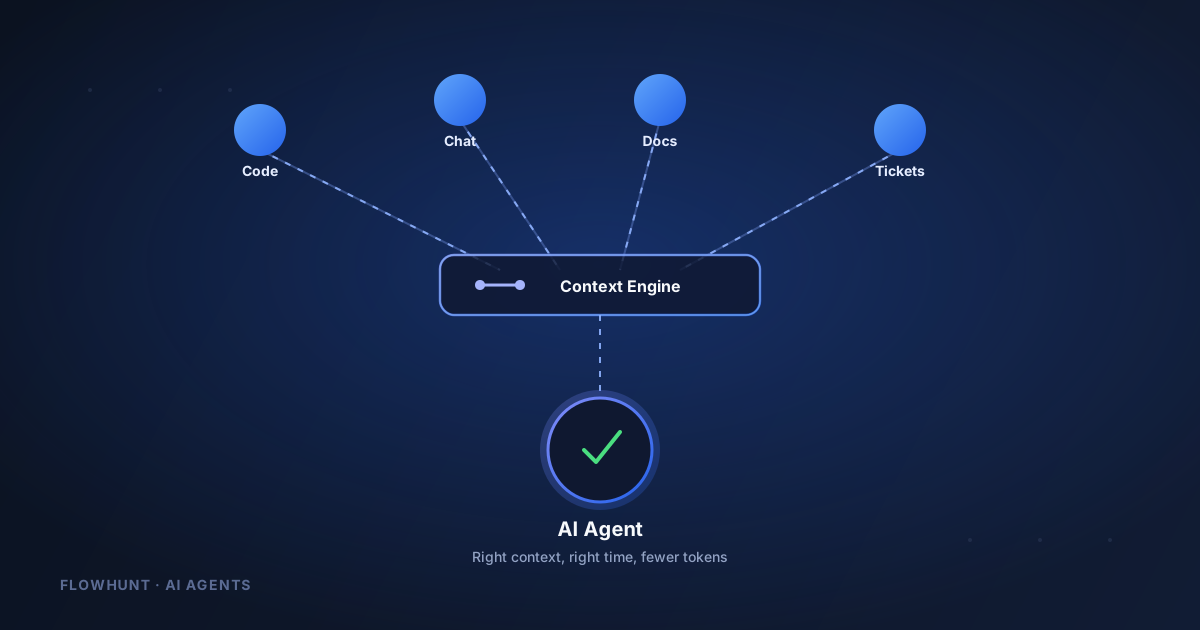
Kontextový engine je v podstate sofistikovaný systém navrhnutý na agregáciu, indexovanie a poskytovanie kontextových informácií AI agentom čo najefektívnejším možným spôsobom. Namiesto toho, aby agenti museli manuálne prehľadávať celé repozitáre, dokumentáciu alebo dátové úložiská, kontextový engine funguje ako inteligentný sprostredkovateľ, ktorý rozumie tomu, aký kontext agent potrebuje, a dodáva ho presne vtedy, keď je to potrebné.
Základným princípom kontextového enginu je optimalizácia. Tradičné architektúry AI agentov často trpia tým, čo by sme mohli nazvať „kontextová nafúknutosť“ – agenti dostávajú príliš veľa informácií, čo vedie k dlhším časom spracovania, vyššej spotrebe tokenov a niekedy dokonca k zníženej presnosti kvôli šumu v kontextovom okne. Kontextový engine to rieši implementáciou inteligentných mechanizmov filtrovania a indexovania, ktoré zabezpečujú, že agenti dostávajú len tie najrelevantnejšie dáta pre svoju konkrétnu úlohu.

Pripravení rozšíriť svoje podnikanie?
Začnite svoju 30-dňovú skúšobnú verziu ešte dnes a vidzte výsledky behom pár dní.
Prečo je manažment kontextu dôležitý pre výkon AI agentov
V rýchlo sa vyvíjajúcom prostredí vývoja poháňaného AI sa schopnosť efektívne spravovať kontext stala konkurenčnou výhodou. Ako organizácie škálujú svoje využívanie AI agentov na kontrolu kódu, opravu chýb, generovanie dokumentácie a ďalšie komplexné úlohy, nákladové dôsledky neefektívneho manažmentu kontextu sa stávajú čoraz významnejšími.
Zvážte praktické dôsledky:
- Efektivita tokenov: Každý token spotrebovaný AI modelom predstavuje priamy náklad. Zbytočný kontext zvyšuje spotrebu tokenov exponenciálne, čo vedie k vyšším prevádzkovým nákladom a pomalším reakčným časom.
- Zlepšenie presnosti: Keď majú agenti prístup presne k správnemu kontextu bez šumu alebo irelevantných informácií, ich rozhodovanie sa zlepšuje. Môžu sa sústrediť na riešenie skutočného problému namiesto prechádzania nadbytočných dát.
- Škálovateľnosť: Ako rastie počet agentov a zložitosť úloh, manuálny manažment kontextu sa stáva nemožným. Automatizovaný kontextový engine umožňuje organizáciám škálovať ich AI operácie bez proporcionálneho nárastu nákladov.
- Reakcia v reálnom čase: Dobre navrhnutý kontextový engine dokáže agentom poskytovať čerstvé, aktuálne informácie, čím zabezpečuje, že vždy pracujú s aktuálnymi dátami a nie so zastaranými snímkami.
Ako FlowHunt integruje princípy kontextového enginu
FlowHunt si uvedomuje, že moderné AI pracovné postupy vyžadujú vo svojom jadre inteligentný manažment kontextu. Ako platforma pre AI agentov má za úlohu zabezpečiť, aby vaši inteligentní agenti vždy pracovali so správnym výrezom vašich dát, nie s celým skladom. Platforma začleňuje princípy kontextového enginu do svojho automatizačného rámca, čo používateľom umožňuje vytvárať AI pracovné postupy, ktoré si zachovávajú efektivitu aj pri veľkom rozsahu. Vďaka integrácii s viacerými dátovými zdrojmi a implementácii inteligentného indexovania FlowHunt zabezpečuje, že vaši AI agenti – či už generujú obsah, kontrolujú kód alebo analyzujú dáta – majú vždy prístup k najrelevantnejšiemu kontextu bez režijných nákladov na spracovanie irelevantných informácií.
Prihláste sa na newsletter
Získajte najnovšie tipy, trendy a ponuky zadarmo.
Budovanie efektívneho kontextového enginu: Architektúra a komponenty
Produkčne zrelý kontextový engine vyžaduje starostlivé architektonické plánovanie. Systém musí súčasne spracovávať viacero dátových zdrojov, efektívne indexovať informácie a poskytovať tento kontext rôznym AI agentom prostredníctvom štandardizovaného protokolu.
| Komponent | Účel | Integračné body |
|---|---|---|
| Vrstva agregácie dát | Zhromažďuje udalosti a dáta z viacerých zdrojov | GitHub, Slack, Discord, Stripe, webové stránky |
| Indexovací engine | Organizuje a optimalizuje dáta pre rýchle vyhľadávanie | Fulltextové vyhľadávanie, sémantické indexovanie, označovanie metadátami |
| Dotazovacie rozhranie | Poskytuje štandardizovaný prístup pre AI agentov | MCP (Model Context Protocol) server |
| Vrstva vyrovnávacej pamäte | Znižuje latenciu pre často používaný kontext | Vyrovnávacia pamäť v pamäti s politikami TTL |
| Integračný rámec | Umožňuje pripojenie k novým dátovým zdrojom | Prijímače webhookov, API konektory, poslucháče udalostí |
Najefektívnejšie kontextové enginy používajú hybridný prístup, ktorý kombinuje viacero stratégií vyhľadávania. Namiesto spoliehania sa výlučne na jednu metódu používajú inteligentné smerovanie na určenie, či má kontext pochádzať z indexovaného enginu, z priameho prístupu k súborom alebo z vyhľadávania v dokumentácii – na základe konkrétneho dotazu a požiadaviek agenta. V praxi je toto dotazovacie rozhranie zvyčajne vystavené ako MCP server, takže akýkoľvek kompatibilný agent sa k nemu môže pripojiť rovnako, ako by sa pripojil k akémukoľvek inému nástroju.
Kontextový engine FlowHunt: Praktická implementácia
FlowHunt vyvinul open-source kontextový engine špeciálne navrhnutý pre pracovné postupy AI agentov. Prístupný prostredníctvom harx.dev, tento kontextový engine demonštruje, ako prakticky implementovať manažment kontextu v produkčných prostrediach. Systém je postavený na Model Context Protocol (MCP), štandardizovanom rozhraní, ktoré umožňuje viacerým AI agentom dotazovať kontextový engine bez ohľadu na ich základnú architektúru.
Implementácia obsahuje niekoľko kľúčových funkcií:
- Integrácia viacerých zdrojov: Kontextový engine agreguje dáta z repozitárov GitHub, kanálov Slack, serverov Discord, fakturačných informácií Stripe, obsahu YouTube, webových stránok a systémov tiketov. Táto komplexná integrácia znamená, že agenti majú prístup k organizačným znalostiam z každého kritického systému.
- Inteligentná správa súborového systému: Engine automaticky organizuje indexované dáta do logických entít – hlásenia o chybách, požiadavky na funkcie, používateľské faktúry, informácie o zákazníkoch – čo agentom uľahčuje navigáciu a vyhľadávanie konkrétnych informácií.
- Aktualizácie v reálnom čase: Keď v pripojených platformách nastanú nové udalosti, kontextový engine ich automaticky spracuje a zaindexuje, čím zabezpečí, že agenti vždy pracujú s aktuálnymi informáciami.
- Dizajn s ohľadom na náklady: Celý systém je postavený s ohľadom na efektivitu tokenov, pričom používa sofistikované algoritmy na určenie toho, ktorý kontext je pre daný dotaz skutočne potrebný.
Meranie dopadu: Výsledky z reálneho prostredia pri úlohách kontroly kódu
Teoretické prínosy kontextového enginu sú presvedčivé, ale overenie v reálnych podmienkach je nevyhnutné. FlowHunt vykonal komplexné hodnotenie svojho kontextového enginu pomocou skutočných úloh kontroly kódu vykonávaných ich interným kódovacím agentom. Výsledky poskytujú konkrétny dôkaz o efektívnosti tohto prístupu.
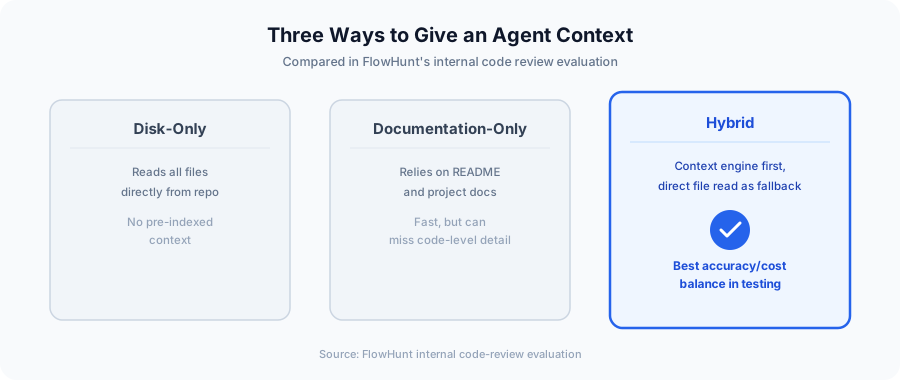
Hodnotenie porovnalo tri odlišné prístupy k poskytovaniu kontextu kódovaciemu agentovi:
- Prístup iba z disku: Agent číta všetky relevantné súbory priamo z repozitára bez akéhokoľvek predindexovaného kontextu.
- Prístup iba z dokumentácie: Agent sa spolieha výlučne na projektovú dokumentáciu a súbory README.
- Hybridný prístup: Agent používa kontextový engine pre indexovaný kontext a zároveň si zachováva schopnosť čítať súbory priamo z repozitára, keď je to potrebné.
Výsledky boli pozoruhodné. Hybridný prístup, ktorý kombinuje kontextový engine so selektívnym prístupom k súborom, dosiahol najlepšiu rovnováhu medzi presnosťou a nákladovou efektívnosťou. Konkrétne táto metóda znížila spotrebu tokenov o 23 % v porovnaní s tradičnými prístupmi a zároveň zachovala alebo zlepšila metriky presnosti. To predstavuje významné zníženie nákladov pre organizácie, ktoré nepretržite prevádzkujú viacero agentov.
Dáta ukazujú, že najefektívnejšou cestou vpred nie je voľba medzi kontextovými enginmi a tradičným prístupom k súborom – je to inteligentné kombinovanie oboch prístupov. Kontextový engine slúži ako primárny zdroj pre často potrebné informácie, zatiaľ čo priamy prístup k súborom poskytuje záložnú možnosť pre okrajové prípady alebo špecializované dotazy.
Implementácia kontextových enginov na rôznych AI platformách
Jedným z najsilnejších aspektov dobre navrhnutého kontextového enginu je jeho nezávislosť od platformy. Namiesto budovania samostatných kontextových systémov pre každý typ AI agenta môže jednotný kontextový engine obsluhovať viacero agentových rámcov súčasne.
Kontextový engine FlowHunt demonštruje tento princíp podporou integrácie s:
- Harx (interný kódovací agent FlowHunt)
- Claude Code (kódovací asistent od Anthropic)
- Codeex (špecializovaný agent na vykonávanie kódu)
- Pi.dev (vývojový agent zameraný na Python)
- Harness (platforma na nasadenie a testovanie)
Tento multi-platformový prístup ponúka významné výhody. Organizácie môžu štandardizovať svoju kontextovú infraštruktúru a zároveň si zachovať flexibilitu pri výbere rôznych implementácií agentov pre rôzne úlohy. Kontextový engine sa stáva spoľahlivou chrbticou, ktorá zabezpečuje, že všetci agenti, bez ohľadu na ich konkrétnu architektúru, majú prístup ku konzistentnému, vysokokvalitnému kontextu.
Ekonomika optimalizácie tokenov
Pochopenie finančných dôsledkov implementácie kontextového enginu je kľúčové pre rozhodovanie. Spotreba tokenov sa pri používaní komerčných AI modelov priamo premieta do prevádzkových nákladov. Zníženie spotreby tokenov o 23 % predstavuje podstatnú úsporu nákladov, najmä pre organizácie, ktoré prevádzkujú agentov nepretržite.
Zvážte scenár: organizácia prevádzkuje agentov na kontrolu kódu pri 100 pull requestoch denne, pričom každá kontrola spotrebuje v priemere 10 000 tokenov. Zníženie o 23 % prostredníctvom implementácie kontextového enginu by ušetrilo približne 230 000 tokenov denne. Za mesiac je to takmer 7 miliónov tokenov – čo predstavuje tisíce dolárov ušetrených na nákladoch za API. Pre väčšie organizácie sa tieto úspory škálujú proporcionálne.
Okrem priameho zníženia nákladov optimalizácia tokenov umožňuje rýchlejšie reakčné časy agentov. Menšie kontextové okná znamenajú rýchlejšie spracovanie, čo agentom umožňuje dokončiť úlohy rýchlejšie a poskytnúť vývojárom spätnú väzbu skôr. To vytvára multiplikačný efekt, kde sa úspora nákladov spája so zvýšenou produktivitou.
Najlepšie postupy pre nasadenie kontextového enginu
Úspešná implementácia kontextového enginu vyžaduje starostlivé plánovanie a realizáciu. Z nasadení v reálnom svete vyplynulo niekoľko najlepších postupov:
Začnite s prípadmi použitia s najvyššou hodnotou: Namiesto pokusu o okamžité zaindexovanie všetkých organizačných dát začnite s konkrétnymi úlohami, kde je spotreba tokenov najvyššia a efektivita kontextu najdôležitejšia. Kontrola kódu, generovanie dokumentácie a triáž chýb sú výbornými východiskovými bodmi.
Implementujte postupnú integráciu zdrojov: Nepokúšajte sa pripojiť všetky dátové zdroje súčasne. Budujte integrácie postupne a pred pridaním ďalšieho overte, že každý nový zdroj skutočne zlepšuje výkon agenta.
Nepretržite monitorujte a merajte: Pred implementáciou kontextového enginu stanovte základné metriky a potom starostlivo sledujte zmeny. Spotreba tokenov, miery presnosti, reakčné časy a nákladové metriky by sa mali sledovať dôsledne.
Používajte hybridné prístupy: Dáta jednoznačne naznačujú, že čisto kontextové enginové prístupy nie sú optimálne. Namiesto toho kombinujte indexovaný kontext so schopnosťou priamo pristupovať k zdrojovým súborom, čo agentom umožní zvoliť najefektívnejšiu metódu vyhľadávania pre každý dotaz.
Plánujte škálovanie: Navrhnite svoj kontextový engine s ohľadom na rast. Ako pridávate viac agentov a viac dátových zdrojov, systém musí naďalej fungovať efektívne bez degradácie.
Budúcnosť architektúry AI agentov
Nástup kontextových enginov ako kritickej súčasti architektúry AI agentov predstavuje dozretie tohto odboru. Skoré implementácie AI agentov považovali kontext za dodatočnú záležitosť – agenti dostali, akékoľvek dáta boli k dispozícii, a snažili sa s nimi pracovať čo najlepšie. Moderné prístupy uznávajú, že manažment kontextu je pre výkon agentov zásadný.
Pri pohľade do budúcnosti sa kontextové enginy pravdepodobne stanú čoraz sofistikovanejšími. Modely strojového učenia, ktoré predpovedajú, ktorý kontext bude najrelevantnejší pre konkrétne typy úloh, by mohli ďalej optimalizovať spotrebu tokenov. Integrácia s viac špecializovanými dátovými zdrojmi a doménovo špecifickými znalostnými bázami umožní agentom pracovať efektívnejšie v špecializovaných doménach. Systémy učenia v reálnom čase by mohli upravovať stratégie poskytovania kontextu na základe spätnej väzby o výkone agentov.
Princíp, ktorý je základom všetkých týchto vývojových smerov, zostáva konštantný: najvýkonnejší AI agenti nie sú tí s najväčšími modelmi alebo najväčším surovým výpočtovým výkonom, ale tí s prístupom presne k správnemu kontextu v správnom čase.
Záver
Budovanie efektívneho kontextového enginu pre AI agentov už nie je voliteľné pre organizácie, ktoré to s automatizáciou poháňanou AI myslia vážne. Dôkazy sú jasné – dobre implementovaný kontextový engine znižuje spotrebu tokenov o 23 % a zároveň zlepšuje presnosť, čo sa priamo premieta do nižších nákladov a lepšieho výkonu agentov. Technológia je dostatočne zrelá na produkčné nasadenie, s dostupnými open-source implementáciami a osvedčenými výsledkami z reálnych prípadov použitia.
Cesta vpred zahŕňa implementáciu kontextových enginov ako základného komponentu vašej AI infraštruktúry, počnúc prípadmi použitia s vysokou hodnotou a postupným rozširovaním. Kombináciou indexovaného kontextu so selektívnym priamym prístupom môžu organizácie dosiahnuť optimálnu efektivitu. Organizácie, ktoré kontextové enginy prijmú skoro, získajú významné konkurenčné výhody prostredníctvom nižších prevádzkových nákladov, rýchlejších reakčných časov agentov a lepšej presnosti pri úlohách poháňaných AI.
Nakopnite svoj pracovný postup s FlowHunt
Zažite, ako FlowHunt automatizuje vaše AI pracovné postupy pre obsah a SEO – od výskumu a generovania obsahu až po publikovanie a analytiku – všetko na jednom mieste.
