


Introduction
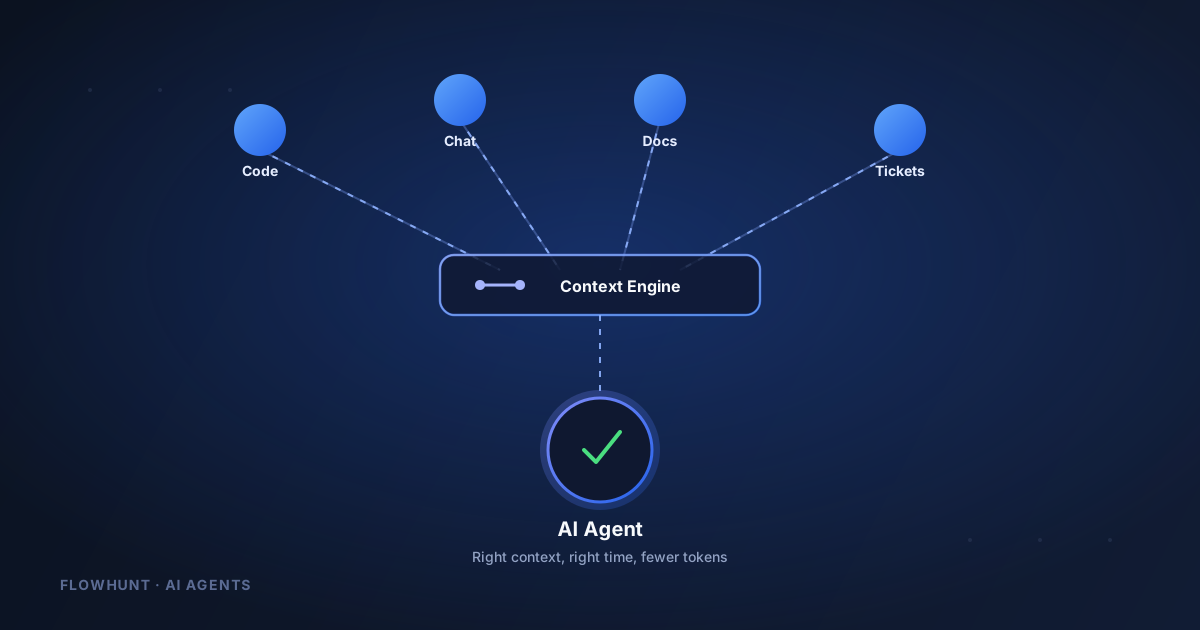
L’efficacité des agents IA dépend de manière critique d’un facteur fondamental : avoir accès à la bonne information au bon moment. À mesure que les organisations déploient en interne des agents IA toujours plus sophistiqués, un schéma clair s’est dessiné : lorsque les agents reçoivent un contexte correctement sélectionné et indexé, leur précision s’améliore considérablement tandis que leur consommation de tokens diminue de façon significative. Ce changement représente une transformation fondamentale de notre façon de concevoir l’architecture des agents IA. Plutôt que de donner aux agents un accès brut et non filtré à toutes les données disponibles, les approches modernes se concentrent sur la construction de moteurs de contexte intelligents qui servent de cerveau aux systèmes d’IA. Dans cet article, nous explorerons comment construire et mettre en œuvre un moteur de contexte, pourquoi cela compte pour votre organisation et comment cela peut réduire les coûts opérationnels tout en améliorant les performances des agents.
Qu’est-ce qu’un moteur de contexte ?
Un moteur de contexte est fondamentalement un système sophistiqué conçu pour agréger, indexer et fournir des informations contextuelles aux agents IA de la manière la plus efficace possible. Plutôt que de forcer les agents à parcourir manuellement des dépôts, des documentations ou des bases de données entiers, un moteur de contexte agit comme un intermédiaire intelligent qui comprend de quel contexte un agent a besoin et le fournit précisément au moment requis.
Le principe fondamental d’un moteur de contexte est l’optimisation. Les architectures traditionnelles d’agents IA souffrent souvent de ce que l’on pourrait appeler une « inflation du contexte » : les agents reçoivent trop d’informations, ce qui allonge les temps de traitement, augmente la consommation de tokens et parfois même réduit la précision en raison du bruit présent dans la fenêtre de contexte. Un moteur de contexte résout ce problème en mettant en œuvre des mécanismes de filtrage et d’indexation intelligents qui garantissent que les agents ne reçoivent que les données les plus pertinentes pour leur tâche spécifique.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
Pourquoi la gestion du contexte est essentielle aux performances des agents IA
Dans le paysage en évolution rapide du développement assisté par IA, la capacité à gérer efficacement le contexte est devenue un avantage concurrentiel. À mesure que les organisations étendent leur usage des agents IA pour la revue de code, la correction de bugs, la génération de documentation et d’autres tâches complexes, les implications financières d’une gestion inefficace du contexte deviennent de plus en plus importantes.
Considérez les implications pratiques :
- Efficacité des tokens : chaque token consommé par un modèle d’IA représente un coût direct. Un contexte inutile augmente exponentiellement la consommation de tokens, ce qui entraîne des dépenses opérationnelles plus élevées et des temps de réponse plus lents.
- Amélioration de la précision : lorsque les agents ont accès précisément au bon contexte, sans bruit ni informations non pertinentes, leur prise de décision s’améliore. Ils peuvent se concentrer sur la résolution du problème réel plutôt que sur l’analyse de données superflues.
- Évolutivité : à mesure que le nombre d’agents et la complexité des tâches augmentent, la gestion manuelle du contexte devient impossible. Un moteur de contexte automatisé permet aux organisations de faire évoluer leurs opérations d’IA sans augmentation proportionnelle des coûts.
- Réactivité en temps réel : un moteur de contexte bien conçu peut fournir aux agents des informations fraîches et à jour, garantissant qu’ils travaillent toujours avec des données actuelles plutôt qu’avec des instantanés obsolètes.
Comment FlowHunt intègre les principes du moteur de contexte
FlowHunt reconnaît que les workflows d’IA modernes exigent une gestion intelligente du contexte en leur cœur. En tant que plateforme d’agents IA, sa mission est de veiller à ce que vos agents intelligents travaillent toujours à partir de la bonne tranche de vos données, et non de l’entrepôt entier. La plateforme intègre les principes du moteur de contexte dans son framework d’automatisation, permettant aux utilisateurs de construire des workflows alimentés par l’IA qui restent efficaces même à grande échelle. En s’intégrant à de multiples sources de données et en mettant en œuvre une indexation intelligente, FlowHunt garantit que vos agents IA — qu’ils génèrent du contenu, révisent du code ou analysent des données — ont toujours accès au contexte le plus pertinent sans la surcharge liée au traitement d’informations non pertinentes.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Construire un moteur de contexte efficace : architecture et composants
Un moteur de contexte de niveau production exige une planification architecturale minutieuse. Le système doit traiter simultanément de multiples sources de données, indexer efficacement l’information et fournir ce contexte à divers agents IA via un protocole standardisé.
| Composant | Objectif | Points d’intégration |
|---|---|---|
| Couche d’agrégation de données | Collecte les événements et les données de multiples sources | GitHub, Slack, Discord, Stripe, sites web |
| Moteur d’indexation | Organise et optimise les données pour une récupération rapide | Recherche plein texte, indexation sémantique, étiquetage de métadonnées |
| Interface de requête | Fournit un accès standardisé aux agents IA | Serveur MCP (Model Context Protocol) |
| Couche de cache | Réduit la latence pour le contexte fréquemment consulté | Mise en cache en mémoire avec politiques TTL |
| Framework d’intégration | Permet la connexion à de nouvelles sources de données | Récepteurs de webhooks, connecteurs API, écouteurs d’événements |
Les moteurs de contexte les plus efficaces adoptent une approche hybride, combinant plusieurs stratégies de récupération. Plutôt que de s’appuyer sur une seule méthode, ils utilisent un routage intelligent pour déterminer si le contexte doit provenir du moteur indexé, d’un accès direct aux fichiers ou de recherches dans la documentation, en fonction de la requête spécifique et des besoins de l’agent. En pratique, cette interface de requête est généralement exposée sous forme de serveur MCP, afin que tout agent compatible puisse s’y connecter de la même manière qu’il se connecterait à n’importe quel autre outil.
Le moteur de contexte FlowHunt : mise en œuvre pratique
FlowHunt a développé un moteur de contexte open source spécialement conçu pour les workflows d’agents IA. Accessible via harx.dev, ce moteur de contexte montre comment mettre en œuvre concrètement la gestion du contexte en environnement de production. Le système est construit sur le Model Context Protocol (MCP), une interface standardisée qui permet à de multiples agents IA d’interroger le moteur de contexte indépendamment de leur architecture sous-jacente.
La mise en œuvre comprend plusieurs fonctionnalités clés :
- Intégration multi-sources : le moteur de contexte agrège des données issues de dépôts GitHub, de canaux Slack, de serveurs Discord, d’informations de facturation Stripe, de contenus YouTube, de sites web et de systèmes de ticketing. Cette intégration complète signifie que les agents ont accès à la connaissance organisationnelle de chaque système critique.
- Gestion intelligente du système de fichiers : le moteur organise automatiquement les données indexées en entités logiques — rapports de bugs, demandes de fonctionnalités, factures utilisateurs, informations clients — ce qui facilite la navigation et la récupération d’informations spécifiques par les agents.
- Mises à jour en temps réel : à mesure que de nouveaux événements se produisent sur les plateformes connectées, le moteur de contexte les traite et les indexe automatiquement, garantissant que les agents travaillent toujours avec des informations à jour.
- Conception soucieuse des coûts : l’ensemble du système est conçu dans un souci d’efficacité des tokens, en utilisant des algorithmes sophistiqués pour déterminer quel contexte est réellement nécessaire pour une requête donnée.
Mesurer l’impact : résultats concrets des tâches de revue de code
Les bénéfices théoriques d’un moteur de contexte sont séduisants, mais une validation en conditions réelles est essentielle. FlowHunt a mené une évaluation complète de son moteur de contexte à l’aide de tâches réelles de revue de code réalisées par son agent de codage interne. Les résultats fournissent des preuves concrètes de l’efficacité de l’approche.
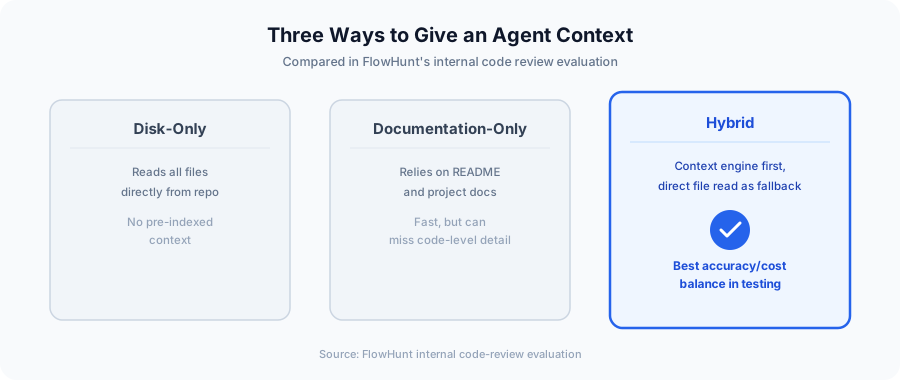
L’évaluation a comparé trois approches distinctes pour fournir du contexte à l’agent de revue de code :
- Approche disque uniquement : l’agent lit tous les fichiers pertinents directement depuis le dépôt, sans aucun contexte pré-indexé.
- Approche documentation uniquement : l’agent s’appuie uniquement sur la documentation du projet et les fichiers README.
- Approche hybride : l’agent utilise le moteur de contexte pour le contexte indexé tout en conservant la possibilité de lire les fichiers directement depuis le dépôt lorsque cela est nécessaire.
Les résultats ont été frappants. L’approche hybride, qui combine le moteur de contexte avec un accès sélectif aux fichiers, a atteint le meilleur équilibre entre précision et efficacité des coûts. Plus précisément, cette méthode a réduit la consommation de tokens de 23 % par rapport aux approches traditionnelles tout en maintenant ou en améliorant les indicateurs de précision. Cela représente une réduction significative des coûts pour les organisations qui exécutent plusieurs agents en continu.
Les données démontrent que la voie la plus efficace n’est pas de choisir entre moteurs de contexte et accès traditionnel aux fichiers : il s’agit de combiner intelligemment les deux approches. Le moteur de contexte sert de source principale pour les informations fréquemment nécessaires, tandis que l’accès direct aux fichiers offre une solution de repli pour les cas particuliers ou les requêtes spécialisées.
Mettre en œuvre les moteurs de contexte sur différentes plateformes d’IA
L’un des aspects les plus puissants d’un moteur de contexte bien conçu est sa nature agnostique vis-à-vis des plateformes. Plutôt que de construire des systèmes de contexte distincts pour chaque type d’agent IA, un moteur de contexte unifié peut servir simultanément plusieurs frameworks d’agents.
Le moteur de contexte FlowHunt illustre ce principe en prenant en charge l’intégration avec :
- Harx (l’agent de codage interne de FlowHunt)
- Claude Code (l’assistant de codage d’Anthropic)
- Codeex (agent spécialisé dans l’exécution de code)
- Pi.dev (agent de développement orienté Python)
- Harness (plateforme de déploiement et de tests)
Cette approche multiplateforme offre des avantages significatifs. Les organisations peuvent standardiser leur infrastructure de contexte tout en conservant la flexibilité de choisir différentes implémentations d’agents selon les tâches. Le moteur de contexte devient la colonne vertébrale fiable qui garantit que tous les agents, quelle que soit leur architecture spécifique, ont accès à un contexte cohérent et de haute qualité.
L’économie de l’optimisation des tokens
Comprendre les implications financières de la mise en œuvre d’un moteur de contexte est crucial pour la prise de décision. La consommation de tokens se traduit directement par des coûts opérationnels lorsqu’on utilise des modèles d’IA commerciaux. Une réduction de 23 % de la consommation de tokens représente une économie substantielle, en particulier pour les organisations qui exécutent des agents en continu.
Prenons un scénario : une organisation exécutant des agents de revue de code sur 100 pull requests par jour, chaque revue consommant en moyenne 10 000 tokens. Une réduction de 23 % grâce à la mise en œuvre d’un moteur de contexte permettrait d’économiser environ 230 000 tokens par jour. Sur un mois, cela représente près de 7 millions de tokens — soit plusieurs milliers de dollars d’économie sur les coûts d’API. Pour les organisations plus grandes, ces économies évoluent proportionnellement.
Au-delà de la réduction directe des coûts, l’optimisation des tokens permet des temps de réponse plus rapides des agents. Des fenêtres de contexte plus petites signifient un traitement plus rapide, ce qui permet aux agents d’accomplir leurs tâches plus rapidement et de fournir des retours aux développeurs plus vite. Cela crée un effet multiplicateur où les économies de coûts se combinent à une productivité accrue.
Bonnes pratiques pour le déploiement d’un moteur de contexte
La mise en œuvre réussie d’un moteur de contexte exige une planification et une exécution minutieuses. Plusieurs bonnes pratiques ont émergé des déploiements réels :
Commencez par vos cas d’usage à plus forte valeur : plutôt que de tenter d’indexer immédiatement toutes les données de l’organisation, commencez par les tâches où la consommation de tokens est la plus élevée et où l’efficacité du contexte compte le plus. La revue de code, la génération de documentation et le triage des bugs sont d’excellents points de départ.
Mettez en œuvre une intégration progressive des sources : ne tentez pas de connecter toutes les sources de données simultanément. Construisez les intégrations de manière incrémentale, en vérifiant que chaque nouvelle source améliore réellement les performances des agents avant d’ajouter la suivante.
Surveillez et mesurez en continu : établissez des indicateurs de référence avant de mettre en œuvre votre moteur de contexte, puis suivez les changements attentivement. La consommation de tokens, les taux de précision, les temps de réponse et les indicateurs de coûts doivent tous être surveillés de manière constante.
Utilisez des approches hybrides : les données suggèrent fortement que les approches reposant uniquement sur un moteur de contexte ne sont pas optimales. Combinez plutôt le contexte indexé avec la possibilité d’accéder directement aux fichiers sources, permettant aux agents de choisir la méthode de récupération la plus efficace pour chaque requête.
Planifiez la montée en charge : concevez votre moteur de contexte en gardant la croissance à l’esprit. À mesure que vous ajoutez davantage d’agents et de sources de données, le système doit continuer à fonctionner efficacement sans dégradation.
L’avenir de l’architecture des agents IA
L’émergence des moteurs de contexte comme composant critique de l’architecture des agents IA représente une maturation du domaine. Les premières implémentations d’agents IA traitaient le contexte comme une préoccupation secondaire : les agents recevaient les données disponibles et faisaient de leur mieux pour les exploiter. Les approches modernes reconnaissent que la gestion du contexte est fondamentale pour la performance des agents.
À l’avenir, les moteurs de contexte deviendront probablement de plus en plus sophistiqués. Des modèles d’apprentissage automatique qui prédisent quel contexte sera le plus pertinent pour des types de tâches spécifiques pourraient optimiser davantage la consommation de tokens. L’intégration de sources de données plus spécialisées et de bases de connaissances métier permettra aux agents de travailler plus efficacement dans des domaines spécialisés. Des systèmes d’apprentissage en temps réel pourraient ajuster les stratégies de fourniture du contexte en fonction des retours sur les performances des agents.
Le principe qui sous-tend tous ces développements reste constant : les agents IA les plus puissants ne sont pas ceux qui disposent des plus grands modèles ou de la puissance de calcul brute la plus élevée, mais ceux qui ont accès précisément au bon contexte au bon moment.
Conclusion
Construire un moteur de contexte efficace pour les agents IA n’est plus optionnel pour les organisations qui prennent au sérieux l’automatisation pilotée par l’IA. Les preuves sont claires : un moteur de contexte bien implémenté réduit la consommation de tokens de 23 % tout en améliorant la précision, ce qui se traduit directement par des coûts plus faibles et de meilleures performances des agents. La technologie est suffisamment mature pour un déploiement en production, avec des implémentations open source disponibles et des résultats éprouvés issus de cas d’usage réels.
La voie à suivre consiste à mettre en œuvre des moteurs de contexte comme composant central de votre infrastructure d’IA, en commençant par des cas d’usage à forte valeur et en élargissant progressivement. En combinant contexte indexé et accès direct sélectif, les organisations peuvent atteindre une efficacité optimale. Les organisations qui adoptent les moteurs de contexte tôt bénéficieront d’avantages concurrentiels significatifs grâce à des coûts opérationnels réduits, des temps de réponse plus rapides des agents et une meilleure précision dans les tâches pilotées par l’IA.
Boostez votre workflow avec FlowHunt
Découvrez comment FlowHunt automatise vos workflows de contenu IA et de SEO — de la recherche et la génération de contenu jusqu'à la publication et l'analyse — le tout au même endroit.
