


Introduzione
L’efficienza degli agenti AI dipende in modo critico da un fattore fondamentale: avere accesso alle informazioni giuste al momento giusto. Man mano che le organizzazioni distribuiscono internamente agenti AI sempre più sofisticati, è emerso un modello chiaro: quando gli agenti ricevono un contesto adeguatamente curato e indicizzato, la loro precisione migliora drasticamente mentre il loro consumo di token diminuisce in modo significativo. Questo cambiamento rappresenta una trasformazione fondamentale nel modo in cui pensiamo all’architettura degli agenti AI. Invece di fornire agli agenti un accesso grezzo e non filtrato a tutti i dati disponibili, gli approcci moderni si concentrano sulla costruzione di context engine intelligenti che fungono da cervello dei sistemi AI. In questo articolo esploreremo come costruire e implementare un context engine, perché è importante per la tua organizzazione e come può ridurre i costi operativi migliorando al contempo le prestazioni degli agenti.
Cos’è un Context Engine?
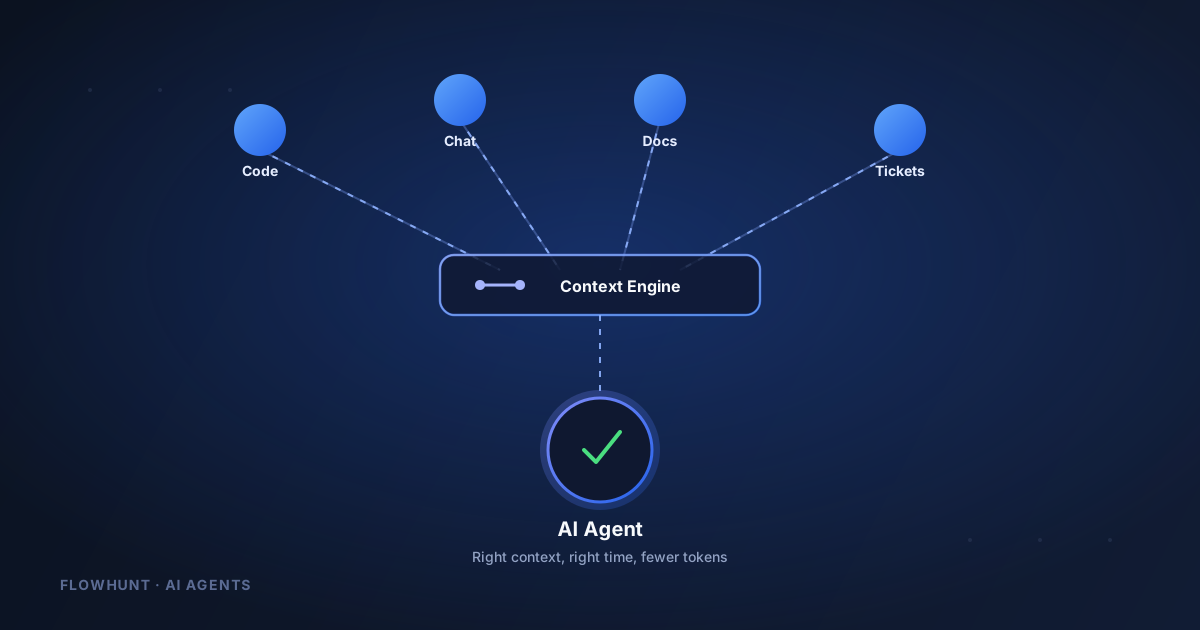
Un context engine è fondamentalmente un sistema sofisticato progettato per aggregare, indicizzare e fornire informazioni contestuali agli agenti AI nel modo più efficiente possibile. Invece di costringere gli agenti a cercare manualmente attraverso interi repository, documentazione o archivi dati, un context engine agisce come un intermediario intelligente che comprende di quale contesto ha bisogno un agente e lo fornisce esattamente quando serve.
Il principio fondamentale alla base di un context engine è l’ottimizzazione. Le architetture tradizionali degli agenti AI spesso soffrono di quello che si potrebbe definire “gonfiore del contesto”: gli agenti ricevono troppe informazioni, il che porta a tempi di elaborazione più lunghi, a un maggiore consumo di token e talvolta persino a una riduzione della precisione a causa del rumore nella finestra di contesto. Un context engine risolve questo problema implementando meccanismi intelligenti di filtraggio e indicizzazione che garantiscono che gli agenti ricevano solo i dati più rilevanti per il loro compito specifico.

Pronto a far crescere il tuo business?
Inizia oggi la tua prova gratuita e vedi i risultati in pochi giorni.
Perché la Gestione del Contesto è Importante per le Prestazioni degli Agenti AI
Nel panorama in rapida evoluzione dello sviluppo basato sull’AI, la capacità di gestire il contesto in modo efficiente è diventata un vantaggio competitivo. Man mano che le organizzazioni scalano il loro utilizzo di agenti AI per la code review, la correzione di bug, la generazione di documentazione e altre attività complesse, le implicazioni di costo di una gestione inefficiente del contesto diventano sempre più significative.
Considera le implicazioni pratiche:
- Efficienza dei token: Ogni token consumato da un modello AI rappresenta un costo diretto. Un contesto non necessario aumenta il consumo di token in modo esponenziale, portando a spese operative più elevate e a tempi di risposta più lenti.
- Miglioramento della precisione: Quando gli agenti hanno accesso esattamente al contesto giusto, senza rumore o informazioni irrilevanti, il loro processo decisionale migliora. Possono concentrarsi sulla risoluzione del problema reale invece di analizzare dati superflui.
- Scalabilità: Man mano che il numero di agenti e la complessità delle attività aumentano, la gestione manuale del contesto diventa impossibile. Un context engine automatizzato consente alle organizzazioni di scalare le proprie operazioni AI senza aumenti proporzionali dei costi.
- Reattività in tempo reale: Un context engine ben progettato può fornire agli agenti informazioni fresche e aggiornate, garantendo che lavorino sempre con dati correnti invece che con istantanee obsolete.
Come FlowHunt Integra i Principi dei Context Engine
FlowHunt riconosce che i moderni flussi di lavoro AI richiedono una gestione intelligente del contesto al loro centro. In quanto piattaforma per agenti AI, il suo compito è assicurarsi che i tuoi agenti intelligenti lavorino sempre dalla giusta porzione dei tuoi dati, non dall’intero magazzino. La piattaforma incorpora i principi dei context engine nel suo framework di automazione, consentendo agli utenti di costruire flussi di lavoro basati sull’AI che mantengono l’efficienza anche su larga scala. Integrandosi con più fonti di dati e implementando un’indicizzazione intelligente, FlowHunt garantisce che i tuoi agenti AI — che stiano generando contenuti, facendo code review o analizzando dati — abbiano sempre accesso al contesto più rilevante senza il sovraccarico di elaborare informazioni irrilevanti.
Iscriviti alla nostra newsletter
Ricevi gratuitamente gli ultimi consigli, tendenze e offerte.
Costruire un Context Engine Efficace: Architettura e Componenti
Un context engine di livello produttivo richiede un’attenta pianificazione architetturale. Il sistema deve gestire più fonti di dati contemporaneamente, indicizzare le informazioni in modo efficiente e fornire quel contesto a vari agenti AI tramite un protocollo standardizzato.
| Componente | Scopo | Punti di Integrazione |
|---|---|---|
| Livello di Aggregazione Dati | Raccoglie eventi e dati da più fonti | GitHub, Slack, Discord, Stripe, Siti Web |
| Motore di Indicizzazione | Organizza e ottimizza i dati per un recupero rapido | Ricerca full-text, indicizzazione semantica, tagging dei metadati |
| Interfaccia di Query | Fornisce accesso standardizzato per gli agenti AI | Server MCP (Model Context Protocol) |
| Livello di Cache | Riduce la latenza per il contesto a cui si accede frequentemente | Caching in memoria con policy TTL |
| Framework di Integrazione | Consente la connessione a nuove fonti di dati | Ricevitori webhook, connettori API, listener di eventi |
I context engine più efficaci impiegano un approccio ibrido, combinando più strategie di recupero. Invece di affidarsi esclusivamente a un solo metodo, utilizzano un routing intelligente per determinare se il contesto debba provenire dal motore indicizzato, dall’accesso diretto ai file o dalle ricerche nella documentazione in base alla query specifica e ai requisiti dell’agente. In pratica, quell’interfaccia di query è solitamente esposta come un server MCP, così qualsiasi agente compatibile può connettersi ad essa nello stesso modo in cui si connetterebbe a qualsiasi altro strumento.
Il Context Engine di FlowHunt: Implementazione Pratica
FlowHunt ha sviluppato un context engine open source specificamente progettato per i flussi di lavoro degli agenti AI. Accessibile tramite harx.dev, questo context engine dimostra come implementare concretamente la gestione del contesto in ambienti di produzione. Il sistema è costruito sopra il Model Context Protocol (MCP), un’interfaccia standardizzata che consente a più agenti AI di interrogare il context engine indipendentemente dalla loro architettura sottostante.
L’implementazione include diverse funzionalità chiave:
- Integrazione multi-fonte: Il context engine aggrega dati da repository GitHub, canali Slack, server Discord, informazioni di fatturazione Stripe, contenuti YouTube, siti web e sistemi di ticketing. Questa integrazione completa significa che gli agenti hanno accesso alla conoscenza organizzativa da ogni sistema critico.
- Gestione intelligente del file system: Il motore organizza automaticamente i dati indicizzati in entità logiche — bug report, richieste di funzionalità, fatture utente, informazioni sui clienti — rendendo facile per gli agenti navigare e recuperare informazioni specifiche.
- Aggiornamenti in tempo reale: Man mano che si verificano nuovi eventi all’interno delle piattaforme collegate, il context engine li elabora e li indicizza automaticamente, garantendo che gli agenti lavorino sempre con informazioni correnti.
- Design consapevole dei costi: L’intero sistema è costruito pensando all’efficienza dei token, utilizzando algoritmi sofisticati per determinare quale contesto sia realmente necessario per ogni data query.
Misurare l’Impatto: Risultati Reali dalle Attività di Code Review
I benefici teorici di un context engine sono convincenti, ma la validazione nel mondo reale è essenziale. FlowHunt ha condotto una valutazione completa del proprio context engine utilizzando attività reali di code review eseguite dal loro agente di coding interno. I risultati forniscono prove concrete dell’efficacia dell’approccio.
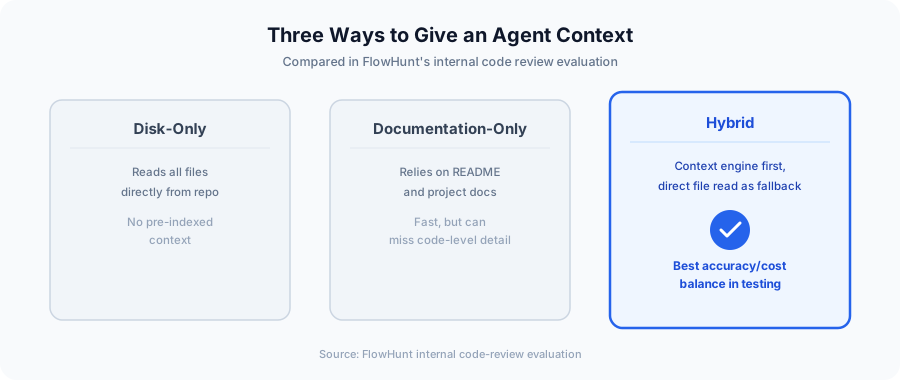
La valutazione ha confrontato tre approcci distinti per fornire contesto all’agente di code review:
- Approccio solo su disco: L’agente legge tutti i file rilevanti direttamente dal repository senza alcun contesto pre-indicizzato.
- Approccio solo su documentazione: L’agente si affida esclusivamente alla documentazione del progetto e ai file README.
- Approccio ibrido: L’agente utilizza il context engine per il contesto indicizzato, mantenendo al contempo la capacità di leggere i file direttamente dal repository quando necessario.
I risultati sono stati sorprendenti. L’approccio ibrido, che combina il context engine con l’accesso selettivo ai file, ha raggiunto il miglior equilibrio tra precisione ed efficienza dei costi. Nello specifico, questo metodo ha ridotto il consumo di token del 23% rispetto agli approcci tradizionali, mantenendo o migliorando le metriche di precisione. Ciò rappresenta una riduzione significativa dei costi per le organizzazioni che eseguono più agenti in modo continuo.
I dati dimostrano che il percorso più efficiente da seguire non è scegliere tra context engine e accesso tradizionale ai file, ma combinare intelligentemente entrambi gli approcci. Il context engine funge da fonte primaria per le informazioni necessarie frequentemente, mentre l’accesso diretto ai file fornisce un fallback per casi limite o query specializzate.
Implementare i Context Engine su Diverse Piattaforme AI
Uno degli aspetti più potenti di un context engine ben progettato è la sua natura indipendente dalla piattaforma. Invece di costruire sistemi di contesto separati per ogni tipo di agente AI, un context engine unificato può servire più framework di agenti contemporaneamente.
Il context engine di FlowHunt dimostra questo principio supportando l’integrazione con:
- Harx (l’agente di coding interno di FlowHunt)
- Claude Code (l’assistente di coding di Anthropic)
- Codeex (agente specializzato nell’esecuzione di codice)
- Pi.dev (agente di sviluppo focalizzato su Python)
- Harness (piattaforma di deployment e testing)
Questo approccio multi-piattaforma offre vantaggi significativi. Le organizzazioni possono standardizzare la propria infrastruttura di contesto mantenendo al contempo la flessibilità di scegliere diverse implementazioni di agenti per attività diverse. Il context engine diventa la spina dorsale affidabile che garantisce che tutti gli agenti, indipendentemente dalla loro architettura specifica, abbiano accesso a un contesto coerente e di alta qualità.
L’Economia dell’Ottimizzazione dei Token
Comprendere le implicazioni finanziarie dell’implementazione di un context engine è cruciale per il processo decisionale. Il consumo di token si traduce direttamente in costi operativi quando si utilizzano modelli AI commerciali. Una riduzione del 23% del consumo di token rappresenta un notevole risparmio sui costi, in particolare per le organizzazioni che eseguono agenti in modo continuo.
Considera uno scenario: un’organizzazione che esegue agenti di code review su 100 pull request al giorno, con ogni revisione che consuma in media 10.000 token. Una riduzione del 23% tramite l’implementazione di un context engine farebbe risparmiare circa 230.000 token al giorno. Nell’arco di un mese, sono quasi 7 milioni di token, che rappresentano migliaia di dollari di costi API ridotti. Per le organizzazioni più grandi, questi risparmi scalano proporzionalmente.
Oltre alla riduzione diretta dei costi, l’ottimizzazione dei token consente tempi di risposta degli agenti più rapidi. Finestre di contesto più piccole significano elaborazione più veloce, consentendo agli agenti di completare le attività più rapidamente e di fornire feedback agli sviluppatori più in fretta. Questo crea un effetto moltiplicatore in cui i risparmi sui costi si combinano con una maggiore produttività.
Best Practice per il Deployment di un Context Engine
Un’implementazione di successo di un context engine richiede un’attenta pianificazione ed esecuzione. Diverse best practice sono emerse dai deployment nel mondo reale:
Inizia dai tuoi casi d’uso di maggior valore: Invece di tentare di indicizzare immediatamente tutti i dati organizzativi, inizia con le attività specifiche in cui il consumo di token è più alto e l’efficienza del contesto conta di più. Code review, generazione di documentazione e triage dei bug sono ottimi punti di partenza.
Implementa un’integrazione incrementale delle fonti: Non tentare di connettere tutte le fonti di dati contemporaneamente. Costruisci le integrazioni in modo incrementale, verificando che ogni nuova fonte migliori effettivamente le prestazioni degli agenti prima di aggiungere la successiva.
Monitora e misura continuamente: Stabilisci metriche di riferimento prima di implementare il tuo context engine, poi monitora attentamente i cambiamenti. Consumo di token, tassi di precisione, tempi di risposta e metriche di costo dovrebbero essere tutti monitorati costantemente.
Usa approcci ibridi: I dati suggeriscono fortemente che gli approcci basati puramente su context engine non siano ottimali. Combina invece il contesto indicizzato con la capacità di accedere direttamente ai file sorgente, consentendo agli agenti di scegliere il metodo di recupero più efficiente per ogni query.
Pianifica la scalabilità: Progetta il tuo context engine pensando alla crescita. Man mano che aggiungi più agenti e più fonti di dati, il sistema deve continuare a funzionare in modo efficiente senza degradarsi.
Il Futuro dell’Architettura degli Agenti AI
L’emergere dei context engine come componente critico dell’architettura degli agenti AI rappresenta una maturazione del settore. Le prime implementazioni degli agenti AI trattavano il contesto come un ripensamento: gli agenti ricevevano tutti i dati disponibili e facevano del loro meglio per lavorarci. Gli approcci moderni riconoscono che la gestione del contesto è fondamentale per le prestazioni degli agenti.
Guardando al futuro, è probabile che i context engine diventino sempre più sofisticati. Modelli di machine learning che prevedono quale contesto sarà più rilevante per specifici tipi di attività potrebbero ottimizzare ulteriormente il consumo di token. L’integrazione con fonti di dati più specializzate e basi di conoscenza specifiche per dominio consentirà agli agenti di lavorare in modo più efficace in domini specializzati. Sistemi di apprendimento in tempo reale potrebbero adattare le strategie di erogazione del contesto in base al feedback sulle prestazioni degli agenti.
Il principio alla base di tutti questi sviluppi rimane costante: gli agenti AI più potenti non sono quelli con i modelli più grandi o la maggior potenza di calcolo grezza, ma quelli con accesso esattamente al contesto giusto al momento giusto.
Conclusione
Costruire un context engine efficace per gli agenti AI non è più opzionale per le organizzazioni che prendono sul serio l’automazione guidata dall’AI. Le prove sono chiare: un context engine ben implementato riduce il consumo di token del 23% migliorando al contempo la precisione, traducendosi direttamente in costi inferiori e migliori prestazioni degli agenti. La tecnologia è abbastanza matura per il deployment in produzione, con implementazioni open source disponibili e risultati comprovati da casi d’uso reali.
Il percorso da seguire prevede l’implementazione dei context engine come componente centrale della tua infrastruttura AI, partendo da casi d’uso di alto valore e espandendosi in modo incrementale. Combinando il contesto indicizzato con l’accesso diretto selettivo, le organizzazioni possono raggiungere l’efficienza ottimale. Le organizzazioni che adottano i context engine in anticipo otterranno vantaggi competitivi significativi grazie a costi operativi inferiori, tempi di risposta degli agenti più rapidi e una maggiore precisione nelle attività guidate dall’AI.
Potenzia il Tuo Flusso di Lavoro con FlowHunt
Sperimenta come FlowHunt automatizza i tuoi flussi di lavoro di contenuti AI e SEO — dalla ricerca e generazione di contenuti alla pubblicazione e analisi — tutto in un unico posto.
