


はじめに
AIエージェントの効率性は、たった一つの根本的な要素に決定的に依存しています。それは、適切なタイミングで適切な情報にアクセスできることです。組織がより高度なAIエージェントを社内で導入するにつれて、明確なパターンが浮かび上がってきました。エージェントが適切に整理・インデックス化されたコンテキストを受け取ると、精度は劇的に向上し、同時にトークン消費は大幅に減少するのです。この変化は、AIエージェントのアーキテクチャに対する私たちの考え方における根本的な転換を意味します。エージェントに利用可能なすべてのデータへの生の未加工のアクセスを提供するのではなく、現代のアプローチは、AIシステムの頭脳として機能するインテリジェントなコンテキストエンジンの構築に焦点を当てています。本記事では、コンテキストエンジンを構築・実装する方法、それが組織にとってなぜ重要なのか、そしてエージェントのパフォーマンスを向上させながら運用コストをどのように削減できるかを探ります。
コンテキストエンジンとは何か?
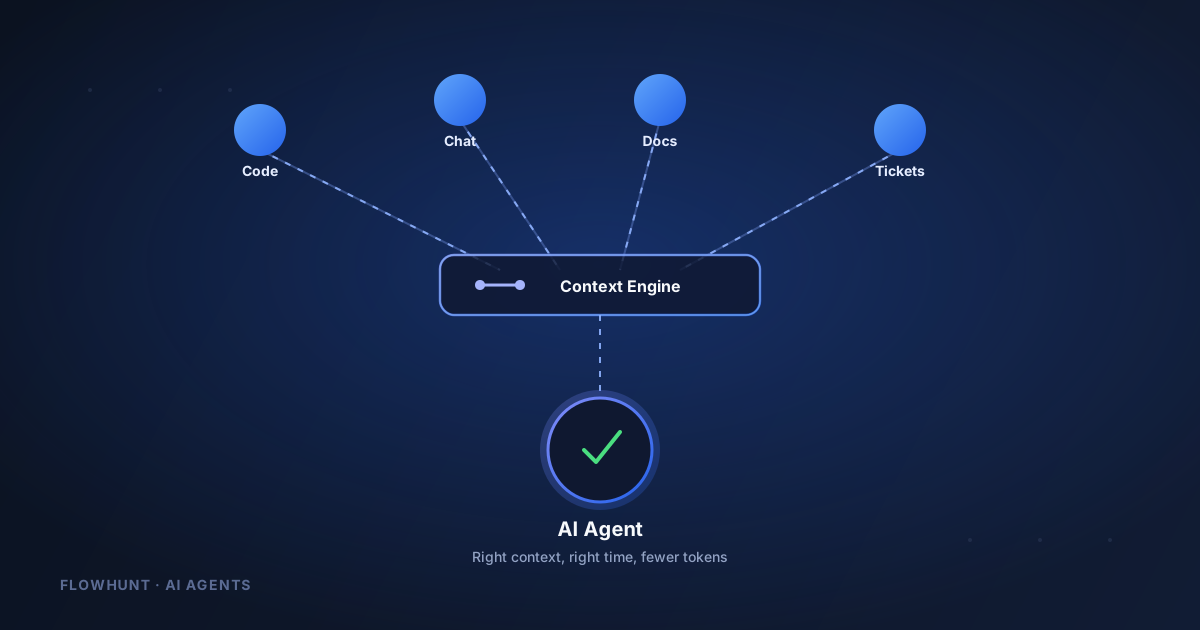
コンテキストエンジンは、根本的には、可能な限り効率的な方法でAIエージェントにコンテキスト情報を集約、インデックス化、提供するために設計された高度なシステムです。エージェントにリポジトリ、ドキュメント、データストア全体を手動で検索させるのではなく、コンテキストエンジンは、エージェントが必要とするコンテキストを理解し、必要なときに正確にそれを届けるインテリジェントな仲介役として機能します。
コンテキストエンジンの背後にある核心的な原則は最適化です。従来のAIエージェントアーキテクチャは、「コンテキスト肥大化」と呼べる問題にしばしば悩まされます。つまり、エージェントが過剰な情報を受け取り、処理時間の長期化、トークン消費の増大、時にはコンテキストウィンドウ内のノイズによる精度の低下を引き起こすのです。コンテキストエンジンは、インテリジェントなフィルタリングとインデックス化のメカニズムを実装することでこれを解決し、エージェントが特定のタスクにとって最も関連性の高いデータだけを受け取ることを保証します。
AIエージェントのパフォーマンスにとってコンテキスト管理が重要な理由
AIを活用した開発が急速に進化する状況において、コンテキストを効率的に管理する能力は競争優位性となっています。組織がコードレビュー、バグ修正、ドキュメント生成、その他の複雑なタスクにAIエージェントの利用を拡大するにつれて、非効率なコンテキスト管理によるコストへの影響はますます重要になっています。
実際的な意味を考えてみましょう。
- トークン効率: AIモデルが消費するすべてのトークンは直接的なコストを表します。不必要なコンテキストはトークン消費を指数関数的に増やし、運用費用の増大と応答時間の遅延を招きます。
- 精度の向上: エージェントがノイズや無関係な情報なしに、まさに適切なコンテキストにアクセスできるとき、その意思決定は向上します。エージェントは余計なデータを解析するのではなく、実際の問題の解決に集中できます。
- スケーラビリティ: エージェントの数とタスクの複雑さが増すにつれて、手動でのコンテキスト管理は不可能になります。自動化されたコンテキストエンジンにより、組織はコストを比例的に増やすことなくAI運用を拡大できます。
- リアルタイム応答性: 適切に設計されたコンテキストエンジンは、新鮮で最新の情報をエージェントに提供でき、古いスナップショットではなく常に最新のデータで作業できることを保証します。
FlowHuntがコンテキストエンジンの原則を統合する方法
FlowHuntは、現代のAIワークフローがその中核にインテリジェントなコンテキスト管理を必要とすることを認識しています。AIエージェントプラットフォームとして、その役割は、あなたのインテリジェントエージェントが倉庫全体ではなく、データの適切な部分から常に作業できるようにすることです。このプラットフォームはコンテキストエンジンの原則を自動化フレームワークに組み込み、ユーザーが規模が大きくなっても効率を維持するAI駆動のワークフローを構築できるようにします。複数のデータソースとの統合とスマートなインデックス化の実装により、FlowHuntは、コンテンツ生成、コードレビュー、データ分析のいずれを行っていても、あなたのAIエージェントが無関係な情報を処理するオーバーヘッドなしに、常に最も関連性の高いコンテキストにアクセスできることを保証します。

ニュースレターに登録
最新のヒント、トレンド、お得な情報を無料で入手。
効果的なコンテキストエンジンの構築:アーキテクチャとコンポーネント
本番環境グレードのコンテキストエンジンには、慎重なアーキテクチャ設計が必要です。システムは複数のデータソースを同時に処理し、情報を効率的にインデックス化し、標準化されたプロトコルを通じてさまざまなAIエージェントにそのコンテキストを提供する必要があります。
| コンポーネント | 目的 | 統合ポイント |
|---|---|---|
| データ集約レイヤー | 複数のソースからイベントとデータを収集 | GitHub、Slack、Discord、Stripe、ウェブサイト |
| インデックスエンジン | 迅速な取得のためにデータを整理・最適化 | 全文検索、セマンティックインデックス、メタデータタグ付け |
| クエリインターフェース | AIエージェントに標準化されたアクセスを提供 | MCP(Model Context Protocol)サーバー |
| キャッシュレイヤー | 頻繁にアクセスされるコンテキストのレイテンシを削減 | TTLポリシー付きのインメモリキャッシュ |
| 統合フレームワーク | 新しいデータソースへの接続を可能にする | Webhookレシーバー、APIコネクター、イベントリスナー |
最も効果的なコンテキストエンジンは、複数の取得戦略を組み合わせたハイブリッドアプローチを採用しています。単一の方法だけに頼るのではなく、特定のクエリとエージェントの要件に基づいて、コンテキストをインデックス化されたエンジン、直接のファイルアクセス、ドキュメント参照のいずれから取得すべきかを判断するインテリジェントなルーティングを使用します。実際には、そのクエリインターフェースは通常MCPサーバーとして公開されるため、互換性のあるエージェントは他のツールに接続するのと同じ方法で接続できます。
FlowHuntのコンテキストエンジン:実践的な実装
FlowHuntは、AIエージェントのワークフロー向けに特別に設計されたオープンソースのコンテキストエンジンを開発しました。harx.devを通じてアクセスできるこのコンテキストエンジンは、本番環境でコンテキスト管理を実際にどのように実装するかを示しています。このシステムはModel Context Protocol(MCP)の上に構築されており、これは基盤となるアーキテクチャに関係なく複数のAIエージェントがコンテキストエンジンにクエリできる標準化されたインターフェースです。
この実装には、いくつかの主要な機能が含まれています。
- マルチソース統合: コンテキストエンジンは、GitHubリポジトリ、Slackチャンネル、Discordサーバー、Stripeの請求情報、YouTubeコンテンツ、ウェブサイト、チケットシステムからデータを集約します。この包括的な統合により、エージェントはあらゆる重要なシステムから組織の知識にアクセスできます。
- インテリジェントなファイルシステム管理: エンジンはインデックス化されたデータをバグレポート、機能リクエスト、ユーザー請求書、顧客情報といった論理的なエンティティに自動的に整理し、エージェントが特定の情報を簡単にナビゲートして取得できるようにします。
- リアルタイム更新: 接続されたプラットフォーム内で新しいイベントが発生すると、コンテキストエンジンは自動的にそれらを処理してインデックス化し、エージェントが常に最新の情報で作業できるようにします。
- コストを意識した設計: システム全体がトークン効率を念頭に置いて構築されており、高度なアルゴリズムを使って、特定のクエリにとってどのコンテキストが本当に必要かを判断します。
影響の測定:コードレビュータスクにおける実運用の結果
コンテキストエンジンの理論上の利点は説得力がありますが、実運用での検証が不可欠です。FlowHuntは、社内のコーディングエージェントが実行した実際のコードレビュータスクを用いて、自社のコンテキストエンジンの包括的な評価を実施しました。その結果は、このアプローチの有効性を示す具体的な証拠を提供しています。
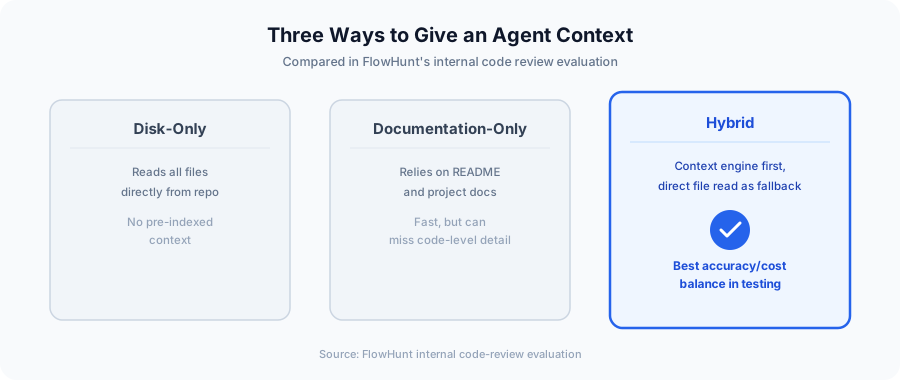
この評価では、コードレビューエージェントにコンテキストを提供する3つの異なるアプローチを比較しました。
- ディスクのみのアプローチ: エージェントは、事前にインデックス化されたコンテキストなしで、リポジトリから関連するすべてのファイルを直接読み取ります。
- ドキュメントのみのアプローチ: エージェントはプロジェクトのドキュメントとREADMEファイルだけに依存します。
- ハイブリッドアプローチ: エージェントはインデックス化されたコンテキストにコンテキストエンジンを使用しつつ、必要に応じてリポジトリからファイルを直接読み取る能力も維持します。
結果は驚くべきものでした。コンテキストエンジンと選択的なファイルアクセスを組み合わせたハイブリッドアプローチは、精度とコスト効率の最良のバランスを達成しました。具体的には、この方法は従来のアプローチと比較して精度指標を維持または向上させながら、トークン消費を23%削減しました。これは、複数のエージェントを継続的に稼働させる組織にとって、大幅なコスト削減を意味します。
データは、最も効率的な前進の道がコンテキストエンジンと従来のファイルアクセスのどちらかを選ぶことではなく、両方のアプローチをインテリジェントに組み合わせることであることを示しています。コンテキストエンジンは頻繁に必要とされる情報の主要なソースとして機能し、直接のファイルアクセスはエッジケースや特殊なクエリに対するフォールバックを提供します。
さまざまなAIプラットフォームへのコンテキストエンジンの実装
適切に設計されたコンテキストエンジンの最も強力な側面の一つは、そのプラットフォーム非依存性です。AIエージェントの種類ごとに個別のコンテキストシステムを構築するのではなく、統一されたコンテキストエンジンが複数のエージェントフレームワークに同時に対応できます。
FlowHuntのコンテキストエンジンは、以下との統合をサポートすることでこの原則を実証しています。
- Harx(FlowHuntの社内コーディングエージェント)
- Claude Code(Anthropicのコーディングアシスタント)
- Codeex(特化型コード実行エージェント)
- Pi.dev(Pythonに特化した開発エージェント)
- Harness(デプロイとテストのプラットフォーム)
このマルチプラットフォームアプローチは、大きな利点をもたらします。組織はコンテキストインフラを標準化しながら、タスクごとに異なるエージェント実装を選択する柔軟性も維持できます。コンテキストエンジンは、特定のアーキテクチャに関係なく、すべてのエージェントが一貫した高品質のコンテキストにアクセスできることを保証する信頼できるバックボーンとなります。
トークン最適化の経済学
コンテキストエンジン導入の財務的な意味を理解することは、意思決定にとって極めて重要です。商用AIモデルを使用する場合、トークン消費は直接的に運用コストに直結します。トークン消費の23%削減は、特にエージェントを継続的に稼働させる組織にとって、相当なコスト削減を意味します。
あるシナリオを考えてみましょう。1日100件のプルリクエストに対してコードレビューエージェントを稼働させ、各レビューが平均10,000トークンを消費する組織です。コンテキストエンジンの実装による23%の削減で、1日あたり約230,000トークンを節約できます。1か月では、それはほぼ700万トークンに達し、APIコストの数千ドル相当の削減となります。より大規模な組織では、これらの節約は比例して拡大します。
直接的なコスト削減に加えて、トークン最適化はエージェントの応答時間を高速化します。より小さなコンテキストウィンドウは処理を高速化し、エージェントがタスクをより迅速に完了し、開発者により早くフィードバックを提供できるようにします。これにより、コスト削減と生産性向上が組み合わさる乗数効果が生まれます。
コンテキストエンジン導入のベストプラクティス
コンテキストエンジンの導入を成功させるには、慎重な計画と実行が必要です。実運用での導入からいくつかのベストプラクティスが浮かび上がってきました。
最も価値の高いユースケースから始める: 組織のすべてのデータをすぐにインデックス化しようとするのではなく、トークン消費が最も多く、コンテキスト効率が最も重要となる特定のタスクから始めましょう。コードレビュー、ドキュメント生成、バグのトリアージは優れた出発点です。
段階的なソース統合を実装する: すべてのデータソースを同時に接続しようとしないでください。統合を段階的に構築し、次のソースを追加する前に、各新しいソースが実際にエージェントのパフォーマンスを向上させることを検証しましょう。
継続的に監視・測定する: コンテキストエンジンを実装する前にベースライン指標を確立し、その後変更を注意深く追跡しましょう。トークン消費、精度、応答時間、コスト指標はすべて一貫して監視すべきです。
ハイブリッドアプローチを使用する: データは、純粋なコンテキストエンジンのアプローチが最適ではないことを強く示唆しています。代わりに、インデックス化されたコンテキストとソースファイルへの直接アクセス能力を組み合わせ、エージェントが各クエリに最も効率的な取得方法を選択できるようにしましょう。
スケールを計画する: 成長を念頭に置いてコンテキストエンジンを設計しましょう。エージェントとデータソースを追加するにつれて、システムは劣化することなく効率的に動作し続ける必要があります。
AIエージェントアーキテクチャの未来
AIエージェントアーキテクチャの重要なコンポーネントとしてコンテキストエンジンが登場したことは、この分野の成熟を表しています。初期のAIエージェントの実装では、コンテキストは後回しにされていました。エージェントは利用可能なデータを受け取り、それをうまく活用するよう最善を尽くしていました。現代のアプローチは、コンテキスト管理がエージェントのパフォーマンスにとって根本的であることを認識しています。
今後を見据えると、コンテキストエンジンはますます高度化していくでしょう。特定のタスクタイプにとってどのコンテキストが最も関連性が高いかを予測する機械学習モデルは、トークン消費をさらに最適化できる可能性があります。より専門的なデータソースやドメイン固有のナレッジベースとの統合により、エージェントは専門領域でより効果的に作業できるようになります。リアルタイム学習システムは、エージェントのパフォーマンスフィードバックに基づいてコンテキスト提供戦略を調整できるでしょう。
これらすべての発展の根底にある原則は変わりません。最も強力なAIエージェントとは、最大のモデルや最も生の計算能力を持つものではなく、適切なタイミングでまさに適切なコンテキストにアクセスできるものです。
結論
AIエージェントのための効果的なコンテキストエンジンの構築は、AI駆動の自動化に真剣に取り組む組織にとって、もはや選択肢ではありません。証拠は明らかです。適切に実装されたコンテキストエンジンは精度を向上させながらトークン消費を23%削減し、それが直接的にコストの低下とエージェントのパフォーマンス向上につながります。この技術は本番環境への導入に十分に成熟しており、オープンソースの実装が利用可能で、実際のユースケースから証明された結果があります。
今後の道筋は、コンテキストエンジンをAIインフラの中核コンポーネントとして実装し、価値の高いユースケースから始めて段階的に拡大していくことです。インデックス化されたコンテキストと選択的な直接アクセスを組み合わせることで、組織は最適な効率を達成できます。コンテキストエンジンを早期に導入する組織は、運用コストの低下、エージェントの応答時間の短縮、AI駆動タスクにおける精度の向上を通じて、大きな競争優位性を得るでしょう。
FlowHuntでワークフローを飛躍的に向上
FlowHuntがAIコンテンツとSEOのワークフローを自動化する方法を体験してください — リサーチとコンテンツ生成から公開、分析まで、すべてを一か所で。
