


Inleiding
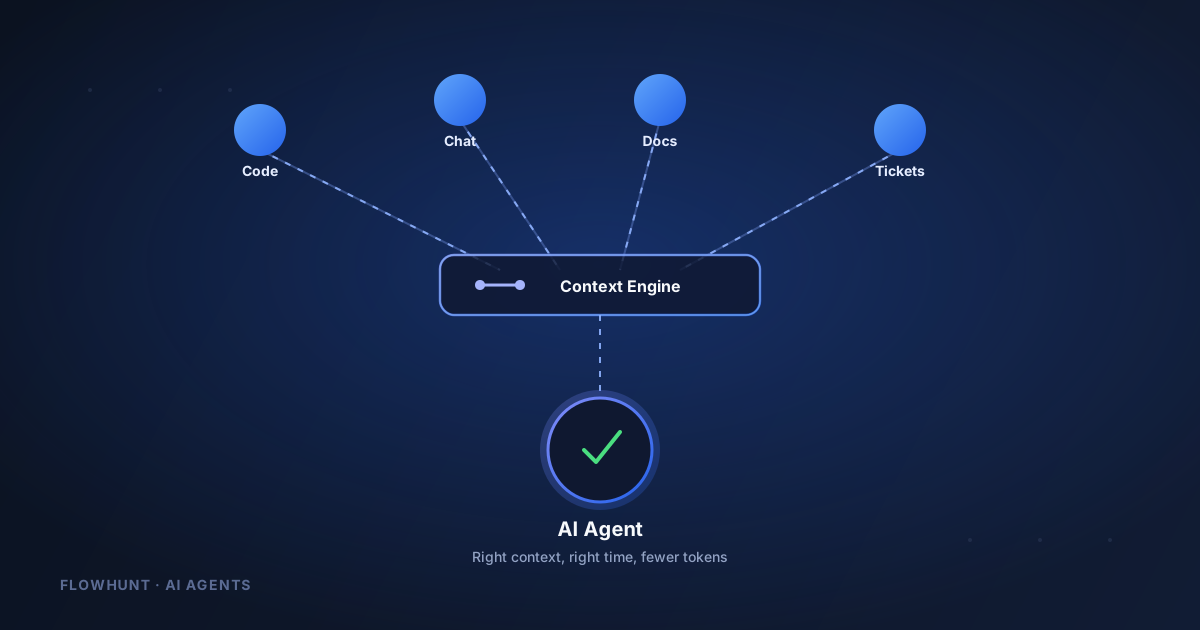
De efficiëntie van AI-agenten hangt in hoge mate af van één fundamentele factor: toegang hebben tot de juiste informatie op het juiste moment. Naarmate organisaties intern meer geavanceerde AI-agenten inzetten, is een duidelijk patroon zichtbaar geworden: wanneer agenten goed samengestelde en geïndexeerde context ontvangen, verbetert hun nauwkeurigheid aanzienlijk terwijl hun tokenverbruik fors daalt. Deze verschuiving betekent een fundamentele verandering in hoe we over de architectuur van AI-agenten denken. In plaats van agenten ongefilterde toegang te geven tot alle beschikbare data, richten moderne benaderingen zich op het bouwen van intelligente context-engines die fungeren als het brein van AI-systemen. In dit artikel onderzoeken we hoe je een context-engine bouwt en implementeert, waarom dit belangrijk is voor je organisatie, en hoe het operationele kosten kan verlagen terwijl de prestaties van agenten verbeteren.
Wat is een context-engine?
Een context-engine is in essentie een geavanceerd systeem dat is ontworpen om contextuele informatie op de meest efficiënte manier samen te brengen, te indexeren en aan AI-agenten te leveren. In plaats van agenten handmatig door volledige repositories, documentatie of datastores te laten zoeken, fungeert een context-engine als een intelligente tussenlaag die begrijpt welke context een agent nodig heeft en die precies levert wanneer dat nodig is.
Het kernprincipe achter een context-engine is optimalisatie. Traditionele architecturen voor AI-agenten hebben vaak last van wat je “contextbloat” kunt noemen: agenten ontvangen te veel informatie, wat leidt tot langere verwerkingstijden, hoger tokenverbruik en soms zelfs verminderde nauwkeurigheid door ruis in het contextvenster. Een context-engine lost dit op met intelligente filter- en indexeringsmechanismen die ervoor zorgen dat agenten alleen de meest relevante data voor hun specifieke taak ontvangen.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
Waarom contextbeheer belangrijk is voor de prestaties van AI-agenten
In het snel evoluerende landschap van AI-gedreven ontwikkeling is het vermogen om context efficiënt te beheren een concurrentievoordeel geworden. Naarmate organisaties hun gebruik van AI-agenten voor code review, bugfixing, het genereren van documentatie en andere complexe taken opschalen, worden de kostenconsequenties van inefficiënt contextbeheer steeds groter.
Denk aan de praktische gevolgen:
- Tokenefficiëntie: Elke token die een AI-model verbruikt, vertegenwoordigt een directe kost. Onnodige context verhoogt het tokenverbruik exponentieel, wat leidt tot hogere operationele kosten en tragere responstijden.
- Verbeterde nauwkeurigheid: Wanneer agenten toegang hebben tot precies de juiste context zonder ruis of irrelevante informatie, verbetert hun besluitvorming. Ze kunnen zich richten op het oplossen van het werkelijke probleem in plaats van het doorworstelen van overbodige data.
- Schaalbaarheid: Naarmate het aantal agenten en de complexiteit van taken toenemen, wordt handmatig contextbeheer onmogelijk. Een geautomatiseerde context-engine stelt organisaties in staat hun AI-activiteiten op te schalen zonder evenredige kostenstijgingen.
- Realtime responsiviteit: Een goed ontworpen context-engine kan agenten van frisse, actuele informatie voorzien, zodat ze altijd met actuele data werken in plaats van met verouderde momentopnamen.
Hoe FlowHunt de principes van context-engines integreert
FlowHunt erkent dat moderne AI-workflows in de kern intelligent contextbeheer vereisen. Als AI-agentplatform is het de taak om ervoor te zorgen dat je intelligente agenten altijd werken met het juiste deel van je data, niet met het hele magazijn. Het platform verwerkt de principes van context-engines in zijn automatiseringsframework, zodat gebruikers AI-gedreven workflows kunnen bouwen die ook op schaal efficiënt blijven. Door integratie met meerdere databronnen en slimme indexering zorgt FlowHunt ervoor dat je AI-agenten – of ze nu content genereren, code reviewen of data analyseren – altijd toegang hebben tot de meest relevante context zonder de overhead van het verwerken van irrelevante informatie.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
Een effectieve context-engine bouwen: architectuur en componenten
Een context-engine van productiekwaliteit vereist zorgvuldige architectonische planning. Het systeem moet meerdere databronnen tegelijk aankunnen, informatie efficiënt indexeren en die context via een gestandaardiseerd protocol aan verschillende AI-agenten leveren.
| Component | Doel | Integratiepunten |
|---|---|---|
| Data-aggregatielaag | Verzamelt events en data uit meerdere bronnen | GitHub, Slack, Discord, Stripe, websites |
| Indexeringsengine | Organiseert en optimaliseert data voor snelle opzoeking | Volledige-tekstzoekopdracht, semantische indexering, metadatatagging |
| Query-interface | Biedt gestandaardiseerde toegang voor AI-agenten | MCP-server (Model Context Protocol) |
| Cache-laag | Verlaagt latentie voor vaak opgevraagde context | In-memory caching met TTL-beleid |
| Integratieframework | Maakt verbinding met nieuwe databronnen mogelijk | Webhook-ontvangers, API-connectors, event listeners |
De meest effectieve context-engines gebruiken een hybride aanpak, waarbij meerdere ophaalstrategieën worden gecombineerd. In plaats van uitsluitend op één methode te vertrouwen, gebruiken ze intelligente routering om te bepalen of context afkomstig moet zijn uit de geïndexeerde engine, directe bestandstoegang of documentatieopzoekingen, op basis van de specifieke query en de vereisten van de agent. In de praktijk wordt die query-interface meestal beschikbaar gesteld als een MCP-server, zodat elke compatibele agent er verbinding mee kan maken op dezelfde manier als met elke andere tool.
De FlowHunt context-engine: praktische implementatie
FlowHunt heeft een open-source context-engine ontwikkeld die specifiek is ontworpen voor AI-agentworkflows. Deze context-engine, toegankelijk via harx.dev, laat zien hoe je contextbeheer in productieomgevingen praktisch implementeert. Het systeem is gebouwd bovenop het Model Context Protocol (MCP), een gestandaardiseerde interface waarmee meerdere AI-agenten de context-engine kunnen bevragen, ongeacht hun onderliggende architectuur.
De implementatie bevat verschillende kernfuncties:
- Integratie van meerdere bronnen: De context-engine brengt data samen uit GitHub-repositories, Slack-kanalen, Discord-servers, Stripe-facturatiegegevens, YouTube-content, websites en ticketsystemen. Deze uitgebreide integratie betekent dat agenten toegang hebben tot organisatiekennis uit elk kritiek systeem.
- Intelligent bestandssysteembeheer: De engine organiseert geïndexeerde data automatisch in logische entiteiten – bugrapporten, feature requests, gebruikersfacturen, klantinformatie – waardoor agenten gemakkelijk kunnen navigeren en specifieke informatie kunnen ophalen.
- Realtime updates: Zodra zich nieuwe events voordoen binnen verbonden platformen, verwerkt en indexeert de context-engine ze automatisch, zodat agenten altijd met actuele informatie werken.
- Kostenbewust ontwerp: Het hele systeem is gebouwd met tokenefficiëntie in gedachten, met geavanceerde algoritmen om te bepalen welke context echt noodzakelijk is voor een bepaalde query.
Impact meten: resultaten uit de praktijk bij code review-taken
De theoretische voordelen van een context-engine zijn overtuigend, maar validatie in de praktijk is essentieel. FlowHunt heeft een uitgebreide evaluatie van zijn context-engine uitgevoerd met daadwerkelijke code review-taken die door hun interne codeeragent werden uitgevoerd. De resultaten leveren concreet bewijs van de effectiviteit van de aanpak.
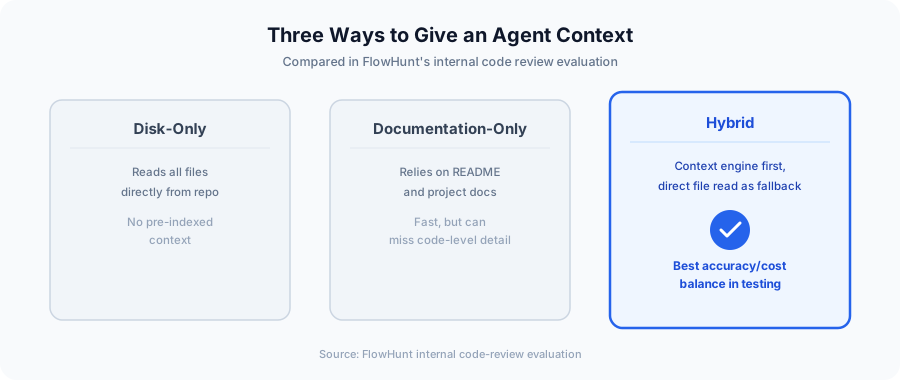
De evaluatie vergeleek drie verschillende manieren om de code review-agent van context te voorzien:
- Alleen-schijf-aanpak: De agent leest alle relevante bestanden rechtstreeks uit de repository, zonder enige vooraf geïndexeerde context.
- Alleen-documentatie-aanpak: De agent vertrouwt uitsluitend op projectdocumentatie en README-bestanden.
- Hybride aanpak: De agent gebruikt de context-engine voor geïndexeerde context en behoudt tegelijk de mogelijkheid om bestanden rechtstreeks uit de repository te lezen wanneer dat nodig is.
De resultaten waren opvallend. De hybride aanpak, die de context-engine combineert met selectieve bestandstoegang, bereikte de beste balans tussen nauwkeurigheid en kostenefficiëntie. Concreet verlaagde deze methode het tokenverbruik met 23% in vergelijking met traditionele aanpakken, terwijl de nauwkeurigheidscijfers gelijk bleven of verbeterden. Dit betekent een aanzienlijke kostenbesparing voor organisaties die continu meerdere agenten draaien.
De data tonen aan dat het meest efficiënte pad vooruit niet een keuze is tussen context-engines en traditionele bestandstoegang, maar een slimme combinatie van beide aanpakken. De context-engine dient als primaire bron voor vaak benodigde informatie, terwijl directe bestandstoegang een terugvaloptie biedt voor randgevallen of gespecialiseerde queries.
Context-engines implementeren op verschillende AI-platformen
Een van de krachtigste aspecten van een goed ontworpen context-engine is de platformonafhankelijke aard ervan. In plaats van aparte contextsystemen te bouwen voor elk type AI-agent, kan één uniforme context-engine meerdere agentframeworks tegelijk bedienen.
De FlowHunt context-engine demonstreert dit principe door integratie te ondersteunen met:
- Harx (de interne codeeragent van FlowHunt)
- Claude Code (de codeerassistent van Anthropic)
- Codeex (gespecialiseerde agent voor code-uitvoering)
- Pi.dev (op Python gerichte ontwikkelingsagent)
- Harness (platform voor deployment en testing)
Deze multiplatformaanpak biedt aanzienlijke voordelen. Organisaties kunnen hun contextinfrastructuur standaardiseren en tegelijk flexibel blijven om voor verschillende taken verschillende agentimplementaties te kiezen. De context-engine wordt de betrouwbare ruggengraat die ervoor zorgt dat alle agenten, ongeacht hun specifieke architectuur, toegang hebben tot consistente, hoogwaardige context.
De economie van tokenoptimalisatie
Inzicht in de financiële gevolgen van de implementatie van een context-engine is cruciaal voor besluitvorming. Tokenverbruik vertaalt zich direct in operationele kosten bij het gebruik van commerciële AI-modellen. Een verlaging van het tokenverbruik met 23% betekent een substantiële kostenbesparing, vooral voor organisaties die agenten continu laten draaien.
Stel je een scenario voor: een organisatie laat code review-agenten draaien op 100 pull requests per dag, waarbij elke review gemiddeld 10.000 tokens verbruikt. Een verlaging van 23% door de implementatie van een context-engine zou dagelijks ongeveer 230.000 tokens besparen. Over een maand is dat bijna 7 miljoen tokens – wat neerkomt op duizenden dollars aan lagere API-kosten. Voor grotere organisaties schalen deze besparingen evenredig mee.
Naast directe kostenverlaging maakt tokenoptimalisatie ook snellere responstijden van agenten mogelijk. Kleinere contextvensters betekenen snellere verwerking, waardoor agenten taken sneller kunnen afronden en ontwikkelaars sneller feedback kunnen geven. Dit creëert een multiplicatoreffect waarbij kostenbesparingen samengaan met hogere productiviteit.
Best practices voor het inzetten van een context-engine
Een succesvolle implementatie van een context-engine vereist zorgvuldige planning en uitvoering. Uit implementaties in de praktijk zijn verschillende best practices naar voren gekomen:
Begin met je meest waardevolle use cases: Probeer niet meteen alle organisatiedata te indexeren, maar start met de specifieke taken waar het tokenverbruik het hoogst is en contextefficiëntie het belangrijkst is. Code review, het genereren van documentatie en bugtriage zijn uitstekende startpunten.
Integreer databronnen stapsgewijs: Probeer niet alle databronnen tegelijk te verbinden. Bouw integraties stapsgewijs op en valideer dat elke nieuwe bron de prestaties van agenten daadwerkelijk verbetert voordat je de volgende toevoegt.
Monitor en meet continu: Stel baseline-metrics vast voordat je je context-engine implementeert en volg veranderingen daarna nauwkeurig. Tokenverbruik, nauwkeurigheidspercentages, responstijden en kostenmetrics moeten consistent worden gemonitord.
Gebruik hybride aanpakken: De data suggereren sterk dat zuivere context-engine-aanpakken niet optimaal zijn. Combineer in plaats daarvan geïndexeerde context met de mogelijkheid om rechtstreeks toegang te krijgen tot bronbestanden, zodat agenten voor elke query de meest efficiënte ophaalmethode kunnen kiezen.
Plan voor schaal: Ontwerp je context-engine met groei in gedachten. Naarmate je meer agenten en meer databronnen toevoegt, moet het systeem efficiënt blijven presteren zonder achteruitgang.
De toekomst van de architectuur van AI-agenten
De opkomst van context-engines als een cruciaal onderdeel van de architectuur van AI-agenten betekent een volwassenwording van het vakgebied. Vroege implementaties van AI-agenten behandelden context als bijzaak: agenten kregen welke data dan ook beschikbaar was en deden hun best daarmee te werken. Moderne benaderingen erkennen dat contextbeheer fundamenteel is voor de prestaties van agenten.
Vooruitkijkend zullen context-engines waarschijnlijk steeds geavanceerder worden. Machine learning-modellen die voorspellen welke context het meest relevant is voor specifieke taaktypen zouden het tokenverbruik verder kunnen optimaliseren. Integratie met meer gespecialiseerde databronnen en domeinspecifieke kennisbanken stelt agenten in staat effectiever te werken in gespecialiseerde domeinen. Realtime leersystemen zouden strategieën voor het leveren van context kunnen aanpassen op basis van feedback over de prestaties van agenten.
Het principe dat aan al deze ontwikkelingen ten grondslag ligt, blijft constant: de krachtigste AI-agenten zijn niet die met de grootste modellen of de meeste ruwe rekenkracht, maar die met toegang tot precies de juiste context op het juiste moment.
Conclusie
Het bouwen van een effectieve context-engine voor AI-agenten is niet langer optioneel voor organisaties die serieus werk maken van AI-gedreven automatisering. Het bewijs is duidelijk: een goed geïmplementeerde context-engine verlaagt het tokenverbruik met 23% en verbetert tegelijk de nauwkeurigheid, wat zich direct vertaalt in lagere kosten en betere prestaties van agenten. De technologie is volwassen genoeg voor productie-implementatie, met beschikbare open-source-implementaties en bewezen resultaten uit praktijkcases.
Het pad vooruit bestaat uit het implementeren van context-engines als kernonderdeel van je AI-infrastructuur, te beginnen met waardevolle use cases en stapsgewijze uitbreiding. Door geïndexeerde context te combineren met selectieve directe toegang kunnen organisaties optimale efficiëntie bereiken. Organisaties die context-engines vroeg invoeren, behalen aanzienlijke concurrentievoordelen door lagere operationele kosten, snellere responstijden van agenten en verbeterde nauwkeurigheid bij AI-gedreven taken.
Geef je workflow een boost met FlowHunt
Ervaar hoe FlowHunt je AI-content- en SEO-workflows automatiseert — van onderzoek en contentgeneratie tot publicatie en analytics — allemaal op één plek.
