


Introduktion
Effektiviteten hos AI-agenter beror avgörande på en grundläggande faktor: att ha tillgång till rätt information vid rätt tidpunkt. När organisationer driftsätter allt mer sofistikerade AI-agenter internt har ett tydligt mönster framträtt – när agenter får korrekt kurerad och indexerad kontext förbättras deras noggrannhet dramatiskt samtidigt som deras tokenförbrukning minskar betydligt. Denna förändring innebär en grundläggande förändring av hur vi tänker kring arkitekturen för AI-agenter. I stället för att ge agenter rå, ofiltrerad tillgång till all tillgänglig data fokuserar moderna metoder på att bygga intelligenta kontextmotorer som fungerar som hjärnan i AI-system. I den här artikeln utforskar vi hur man bygger och implementerar en kontextmotor, varför den är viktig för din organisation och hur den kan minska driftkostnaderna samtidigt som agenternas prestanda förbättras.
Vad är en kontextmotor?
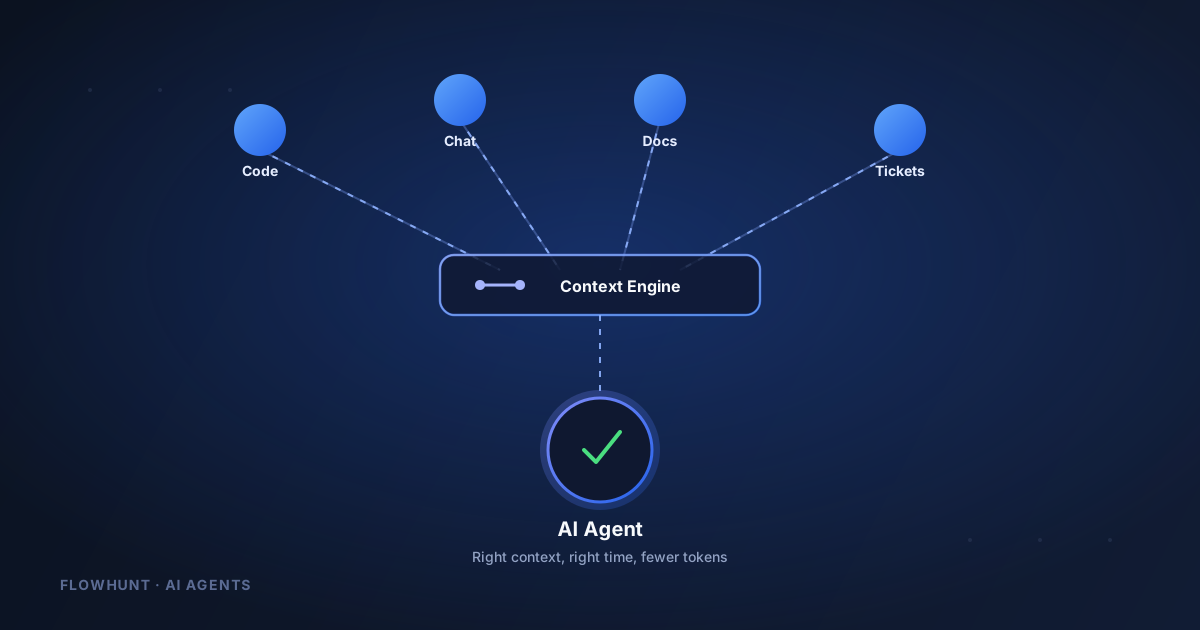
En kontextmotor är i grunden ett sofistikerat system utformat för att samla in, indexera och leverera kontextuell information till AI-agenter på det mest effektiva sättet möjligt. I stället för att tvinga agenter att manuellt söka igenom hela repositorier, dokumentation eller datalager fungerar en kontextmotor som en intelligent mellanhand som förstår vilken kontext en agent behöver och levererar den exakt när den behövs.
Grundprincipen bakom en kontextmotor är optimering. Traditionella arkitekturer för AI-agenter lider ofta av vad man kan kalla “kontextsvällning” – agenter får för mycket information, vilket leder till längre bearbetningstider, högre tokenförbrukning och ibland till och med sämre noggrannhet på grund av brus i kontextfönstret. En kontextmotor löser detta genom att implementera intelligenta filtrerings- och indexeringsmekanismer som säkerställer att agenter bara får den mest relevanta datan för sin specifika uppgift.

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Varför kontexthantering är viktigt för AI-agenters prestanda
I det snabbt föränderliga landskapet för AI-driven utveckling har förmågan att hantera kontext effektivt blivit en konkurrensfördel. När organisationer skalar upp sin användning av AI-agenter för kodgranskning, buggfixning, dokumentationsgenerering och andra komplexa uppgifter blir kostnadskonsekvenserna av ineffektiv kontexthantering allt mer betydande.
Tänk på de praktiska konsekvenserna:
- Tokeneffektivitet: Varje token som förbrukas av en AI-modell innebär en direkt kostnad. Onödig kontext ökar tokenförbrukningen exponentiellt, vilket leder till högre driftskostnader och långsammare svarstider.
- Förbättrad noggrannhet: När agenter har tillgång till exakt rätt kontext utan brus eller irrelevant information förbättras deras beslutsfattande. De kan fokusera på att lösa det faktiska problemet i stället för att tolka överflödig data.
- Skalbarhet: När antalet agenter och uppgifternas komplexitet ökar blir manuell kontexthantering omöjlig. En automatiserad kontextmotor gör det möjligt för organisationer att skala sin AI-verksamhet utan proportionellt ökade kostnader.
- Realtidsrespons: En välutformad kontextmotor kan leverera färsk, uppdaterad information till agenter, så att de alltid arbetar med aktuell data i stället för inaktuella ögonblicksbilder.
Hur FlowHunt integrerar principerna för kontextmotorer
FlowHunt inser att moderna AI-arbetsflöden kräver intelligent kontexthantering i sin kärna. Som en AI-agentplattform är dess uppgift att se till att dina intelligenta agenter alltid arbetar utifrån rätt del av din data, inte hela lagret. Plattformen införlivar principerna för kontextmotorer i sitt automatiseringsramverk, vilket gör det möjligt för användare att bygga AI-drivna arbetsflöden som behåller effektiviteten även i stor skala. Genom att integrera med flera datakällor och implementera smart indexering säkerställer FlowHunt att dina AI-agenter – oavsett om de genererar innehåll, granskar kod eller analyserar data – alltid har tillgång till den mest relevanta kontexten utan att behöva bearbeta irrelevant information.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Att bygga en effektiv kontextmotor: arkitektur och komponenter
En produktionsklar kontextmotor kräver noggrann arkitekturplanering. Systemet måste hantera flera datakällor samtidigt, indexera information effektivt och leverera den kontexten till olika AI-agenter via ett standardiserat protokoll.
| Komponent | Syfte | Integrationspunkter |
|---|---|---|
| Lager för dataaggregering | Samlar in händelser och data från flera källor | GitHub, Slack, Discord, Stripe, webbplatser |
| Indexeringsmotor | Organiserar och optimerar data för snabb hämtning | Fulltextsökning, semantisk indexering, metadatataggning |
| Frågegränssnitt | Ger standardiserad åtkomst för AI-agenter | MCP-server (Model Context Protocol) |
| Cachelager | Minskar latensen för kontext som hämtas ofta | Cache i minnet med TTL-principer |
| Integrationsramverk | Möjliggör anslutning till nya datakällor | Webhook-mottagare, API-anslutningar, händelselyssnare |
De mest effektiva kontextmotorerna använder en hybridmetod som kombinerar flera hämtningsstrategier. I stället för att förlita sig på en enda metod använder de intelligent routning för att avgöra om kontexten ska komma från den indexerade motorn, direkt filåtkomst eller dokumentationsuppslag, baserat på den specifika frågan och agentens krav. I praktiken exponeras det frågegränssnittet vanligtvis som en MCP-server, så att alla kompatibla agenter kan ansluta till den på samma sätt som de skulle ansluta till vilket annat verktyg som helst.
FlowHunts kontextmotor: praktisk implementering
FlowHunt har utvecklat en kontextmotor med öppen källkod som är särskilt utformad för AI-agenters arbetsflöden. Denna kontextmotor, som är tillgänglig via harx.dev, visar hur man praktiskt implementerar kontexthantering i produktionsmiljöer. Systemet är byggt ovanpå Model Context Protocol (MCP), ett standardiserat gränssnitt som gör att flera AI-agenter kan fråga kontextmotorn oavsett sin underliggande arkitektur.
Implementeringen innehåller flera nyckelfunktioner:
- Integration av flera källor: Kontextmotorn samlar in data från GitHub-repositorier, Slack-kanaler, Discord-servrar, Stripe-faktureringsinformation, YouTube-innehåll, webbplatser och ärendesystem. Denna heltäckande integration innebär att agenterna har tillgång till organisatorisk kunskap från alla kritiska system.
- Intelligent filsystemshantering: Motorn organiserar automatiskt indexerad data i logiska entiteter – buggrapporter, funktionsförfrågningar, användarfakturor, kundinformation – vilket gör det enkelt för agenter att navigera och hämta specifik information.
- Realtidsuppdateringar: När nya händelser inträffar i anslutna plattformar bearbetar och indexerar kontextmotorn dem automatiskt, så att agenterna alltid arbetar med aktuell information.
- Kostnadsmedveten design: Hela systemet är byggt med token-effektivitet i åtanke och använder sofistikerade algoritmer för att avgöra vilken kontext som verkligen är nödvändig för en given fråga.
Att mäta effekten: verkliga resultat från kodgranskningsuppgifter
De teoretiska fördelarna med en kontextmotor är övertygande, men validering i verkligheten är avgörande. FlowHunt genomförde en omfattande utvärdering av sin kontextmotor med hjälp av faktiska kodgranskningsuppgifter som utfördes av deras interna kodningsagent. Resultaten ger konkreta bevis på metodens effektivitet.
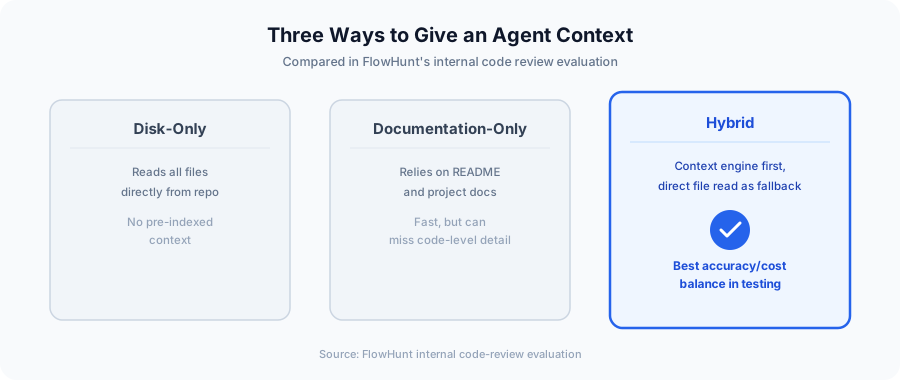
Utvärderingen jämförde tre olika metoder för att ge kontext till kodgranskningsagenten:
- Enbart diskbaserad metod: Agenten läser alla relevanta filer direkt från repositoriet utan någon förindexerad kontext.
- Enbart dokumentationsbaserad metod: Agenten förlitar sig uteslutande på projektdokumentation och README-filer.
- Hybridmetod: Agenten använder kontextmotorn för indexerad kontext samtidigt som den behåller förmågan att läsa filer direkt från repositoriet vid behov.
Resultaten var slående. Hybridmetoden, som kombinerar kontextmotorn med selektiv filåtkomst, uppnådde den bästa balansen mellan noggrannhet och kostnadseffektivitet. Närmare bestämt minskade denna metod tokenförbrukningen med 23 % jämfört med traditionella metoder samtidigt som noggrannhetsmåtten bibehölls eller förbättrades. Detta innebär en betydande kostnadsminskning för organisationer som kör flera agenter kontinuerligt.
Datan visar att den mest effektiva vägen framåt inte är att välja mellan kontextmotorer och traditionell filåtkomst – det är att intelligent kombinera båda metoderna. Kontextmotorn fungerar som den primära källan för information som behövs ofta, medan direkt filåtkomst ger en reservlösning för specialfall eller specialiserade frågor.
Att implementera kontextmotorer på olika AI-plattformar
En av de mest kraftfulla aspekterna hos en välutformad kontextmotor är att den är plattformsoberoende. I stället för att bygga separata kontextsystem för varje typ av AI-agent kan en enhetlig kontextmotor betjäna flera agentramverk samtidigt.
FlowHunts kontextmotor demonstrerar denna princip genom att stödja integration med:
- Harx (FlowHunts interna kodningsagent)
- Claude Code (Anthropics kodningsassistent)
- Codeex (specialiserad agent för kodkörning)
- Pi.dev (Python-fokuserad utvecklingsagent)
- Harness (plattform för driftsättning och testning)
Denna plattformsoberoende metod erbjuder betydande fördelar. Organisationer kan standardisera sin kontextinfrastruktur samtidigt som de behåller flexibiliteten att välja olika agentimplementeringar för olika uppgifter. Kontextmotorn blir den pålitliga ryggraden som säkerställer att alla agenter, oavsett deras specifika arkitektur, har tillgång till konsekvent kontext av hög kvalitet.
Ekonomi i tokenoptimering
Att förstå de ekonomiska konsekvenserna av att implementera en kontextmotor är avgörande för beslutsfattandet. Tokenförbrukning översätts direkt till driftkostnader när kommersiella AI-modeller används. En minskning av tokenförbrukningen med 23 % innebär betydande kostnadsbesparingar, särskilt för organisationer som kör agenter kontinuerligt.
Tänk dig ett scenario: en organisation som kör kodgranskningsagenter på 100 pull requests dagligen, där varje granskning i genomsnitt förbrukar 10 000 token. En minskning med 23 % genom att implementera en kontextmotor skulle spara cirka 230 000 token dagligen. Under en månad blir det nästan 7 miljoner token – vilket motsvarar tusentals dollar i minskade API-kostnader. För större organisationer skalas dessa besparingar proportionellt.
Utöver direkta kostnadsminskningar möjliggör tokenoptimering snabbare svarstider för agenterna. Mindre kontextfönster innebär snabbare bearbetning, vilket gör att agenter kan slutföra uppgifter snabbare och ge utvecklare återkoppling snabbare. Detta skapar en multiplikatoreffekt där kostnadsbesparingar kombineras med förbättrad produktivitet.
Bästa praxis för driftsättning av kontextmotorer
En framgångsrik implementering av en kontextmotor kräver noggrann planering och genomförande. Flera bästa praxis har vuxit fram från driftsättningar i verkligheten:
Börja med dina mest värdefulla användningsfall: Försök inte indexera all organisatorisk data direkt, utan börja med de specifika uppgifter där tokenförbrukningen är högst och kontexteffektiviteten spelar störst roll. Kodgranskning, dokumentationsgenerering och buggtriagering är utmärkta startpunkter.
Inför integrationssteg för källorna: Försök inte ansluta alla datakällor samtidigt. Bygg integrationer stegvis och verifiera att varje ny källa faktiskt förbättrar agenternas prestanda innan du lägger till nästa.
Övervaka och mät kontinuerligt: Fastställ baslinjemått innan du implementerar din kontextmotor och följ sedan förändringar noggrant. Tokenförbrukning, noggrannhetsgrad, svarstider och kostnadsmått bör alla följas upp löpande.
Använd hybridmetoder: Datan tyder starkt på att rena kontextmotorlösningar inte är optimala. Kombinera i stället indexerad kontext med möjligheten att komma åt källfiler direkt, så att agenterna kan välja den mest effektiva hämtningsmetoden för varje fråga.
Planera för skalning: Utforma din kontextmotor med tillväxt i åtanke. När du lägger till fler agenter och fler datakällor måste systemet fortsätta att prestera effektivt utan försämring.
Framtiden för AI-agenters arkitektur
Framväxten av kontextmotorer som en kritisk komponent i AI-agenters arkitektur innebär att området har mognat. Tidiga implementeringar av AI-agenter behandlade kontext som en eftertanke – agenterna fick den data som fanns tillgänglig och gjorde sitt bästa för att arbeta med den. Moderna metoder inser att kontexthantering är grundläggande för agenternas prestanda.
Framöver kommer kontextmotorer sannolikt att bli allt mer sofistikerade. Maskininlärningsmodeller som förutser vilken kontext som är mest relevant för specifika uppgiftstyper skulle kunna optimera tokenförbrukningen ytterligare. Integration med mer specialiserade datakällor och domänspecifika kunskapsbaser gör att agenter kan arbeta mer effektivt inom specialiserade domäner. System för inlärning i realtid skulle kunna justera strategierna för kontextleverans baserat på återkoppling om agenternas prestanda.
Principen som ligger bakom alla dessa utvecklingssteg förblir densamma: de mest kraftfulla AI-agenterna är inte de med de största modellerna eller mest rå beräkningskraft, utan de som har tillgång till exakt rätt kontext vid rätt tidpunkt.
Slutsats
Att bygga en effektiv kontextmotor för AI-agenter är inte längre valfritt för organisationer som satsar seriöst på AI-driven automatisering. Bevisen är tydliga – en väl implementerad kontextmotor minskar tokenförbrukningen med 23 % samtidigt som noggrannheten förbättras, vilket direkt leder till lägre kostnader och bättre agentprestanda. Tekniken är mogen nog för driftsättning i produktion, med tillgängliga implementationer med öppen källkod och bevisade resultat från användningsfall i verkligheten.
Vägen framåt innebär att implementera kontextmotorer som en kärnkomponent i din AI-infrastruktur, med start i användningsfall med högt värde och därefter stegvis utökning. Genom att kombinera indexerad kontext med selektiv direktåtkomst kan organisationer uppnå optimal effektivitet. De organisationer som inför kontextmotorer tidigt får betydande konkurrensfördelar genom lägre driftkostnader, snabbare svarstider för agenterna och förbättrad noggrannhet i AI-drivna uppgifter.
Superladda ditt arbetsflöde med FlowHunt
Upplev hur FlowHunt automatiserar dina AI-arbetsflöden för innehåll och SEO – från research och innehållsgenerering till publicering och analys – allt på ett ställe.
