


引言
AI 智能体的效率关键取决于一个基本因素:在恰当的时间获取恰当的信息。随着组织在内部部署越来越复杂的 AI 智能体,一个清晰的模式已经显现——当智能体获得经过精心整理和索引的上下文时,其准确性会大幅提升,而 Token 消耗则显著下降。这一转变代表了我们对 AI 智能体架构思考方式的根本变化。现代方案不再为智能体提供对所有可用数据的原始、未经过滤的访问权限,而是专注于构建智能上下文引擎,使其成为 AI 系统的大脑。在本文中,我们将探讨如何构建和实施上下文引擎、它为何对你的组织至关重要,以及它如何在提升智能体性能的同时降低运营成本。
什么是上下文引擎?
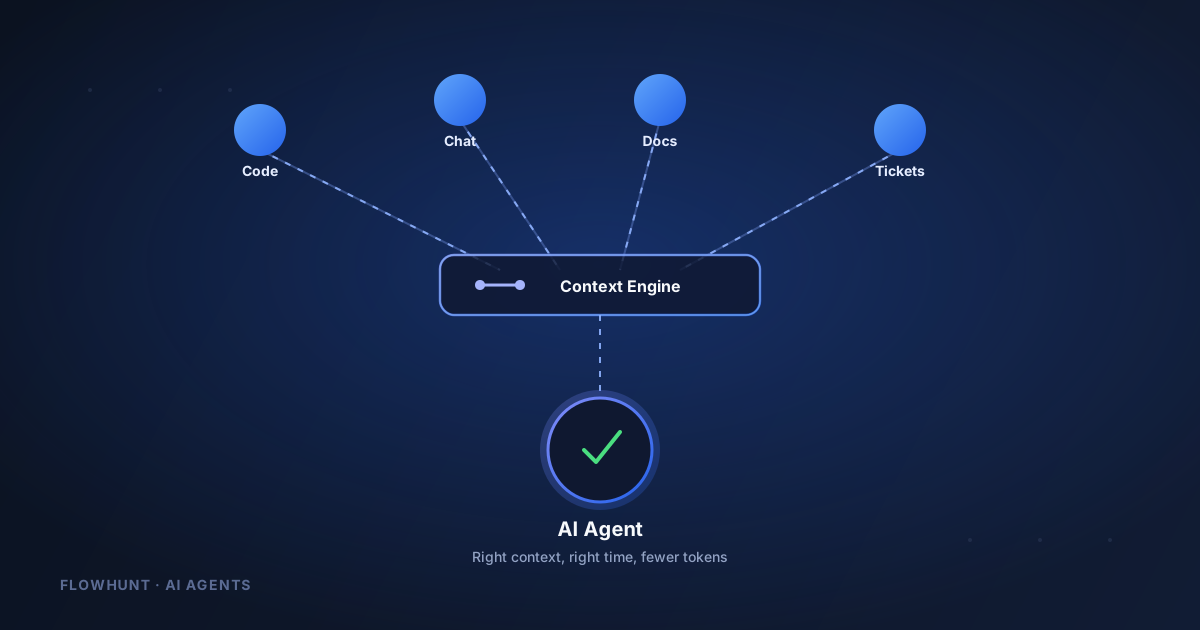
上下文引擎本质上是一个复杂的系统,旨在以尽可能高效的方式聚合、索引并向 AI 智能体提供上下文信息。上下文引擎不会强迫智能体手动搜索整个仓库、文档或数据存储,而是充当一个智能中介,理解智能体需要什么上下文,并在需要时精确地提供它。
上下文引擎背后的核心原则是优化。传统的 AI 智能体架构常常受困于所谓的“上下文膨胀”——智能体接收到过多信息,导致处理时间更长、Token 消耗更高,有时甚至会因为上下文窗口中的噪声而降低准确性。上下文引擎通过实施智能过滤和索引机制来解决这一问题,确保智能体只接收到与其特定任务最相关的数据。
为什么上下文管理对 AI 智能体性能至关重要
在 AI 驱动开发快速演进的格局中,高效管理上下文的能力已成为一种竞争优势。随着组织在代码审查、缺陷修复、文档生成和其他复杂任务中扩大 AI 智能体的使用规模,低效上下文管理带来的成本影响变得越来越显著。
考虑以下实际影响:
- Token 效率:AI 模型消耗的每个 Token 都代表着直接成本。不必要的上下文会以指数级增加 Token 消耗,导致更高的运营费用和更慢的响应时间。
- 准确性提升:当智能体能够获取到恰好正确、没有噪声或无关信息的上下文时,其决策能力会得到改善。它们可以专注于解决实际问题,而不是解析无关数据。
- 可扩展性:随着智能体数量和任务复杂度的增加,手动管理上下文变得不可能。自动化的上下文引擎使组织能够扩展其 AI 运营,而成本不会成比例增加。
- 实时响应能力:设计良好的上下文引擎可以向智能体提供新鲜、最新的信息,确保它们始终基于当前数据而非过时的快照工作。
FlowHunt 如何集成上下文引擎原则
FlowHunt 认识到,现代 AI 工作流的核心需要智能上下文管理。作为一个 AI 智能体平台,它的职责是确保你的 智能体 始终基于数据的正确切片工作,而不是整个数据仓库。该平台将上下文引擎原则融入其自动化框架,使用户能够构建即使在大规模下也能保持效率的 AI 驱动工作流。通过与多个数据源集成并实施智能索引,FlowHunt 确保你的 AI 智能体——无论是生成内容、审查代码还是分析数据——始终能够访问最相关的上下文,而无需承担处理无关信息的开销。

加入我们的新闻通讯
免费获取最新提示、趋势和优惠。
构建高效的上下文引擎:架构与组件
生产级上下文引擎需要周密的架构规划。系统必须同时处理多个数据源、高效索引信息,并通过标准化协议将这些上下文提供给各种 AI 智能体。
| 组件 | 用途 | 集成点 |
|---|---|---|
| 数据聚合层 | 从多个来源收集事件和数据 | GitHub、Slack、Discord、Stripe、网站 |
| 索引引擎 | 组织并优化数据以实现快速检索 | 全文搜索、语义索引、元数据标记 |
| 查询接口 | 为 AI 智能体提供标准化访问 | MCP(模型上下文协议)服务器 |
| 缓存层 | 降低频繁访问上下文的延迟 | 带 TTL 策略的内存缓存 |
| 集成框架 | 支持连接到新的数据源 | Webhook 接收器、API 连接器、事件监听器 |
最高效的上下文引擎采用混合方案,结合多种检索策略。它们不是单纯依赖某一种方法,而是使用智能路由,根据具体查询和智能体的需求来决定上下文应来自索引引擎、直接文件访问还是文档查询。在实践中,该查询接口通常以 MCP 服务器 的形式暴露,这样任何兼容的智能体都能像连接其他任何工具一样连接到它。
FlowHunt 上下文引擎:实践实现
FlowHunt 开发了一个专为 AI 智能体工作流设计的开源上下文引擎。该上下文引擎可通过 harx.dev 访问,展示了如何在生产环境中实际实施上下文管理。该系统构建在模型上下文协议(MCP)之上,这是一个标准化接口,允许多个 AI 智能体查询上下文引擎,而不论其底层架构如何。
该实现包含几个关键特性:
- 多源集成:上下文引擎聚合来自 GitHub 仓库、Slack 频道、Discord 服务器、Stripe 账单信息、YouTube 内容、网站和工单系统的数据。这种全面的集成意味着智能体可以访问来自每个关键系统的组织知识。
- 智能文件系统管理:该引擎自动将索引数据组织为逻辑实体——缺陷报告、功能请求、用户发票、客户信息——使智能体能够轻松导航并检索特定信息。
- 实时更新:当连接的平台中发生新事件时,上下文引擎会自动处理并索引它们,确保智能体始终基于最新信息工作。
- 成本感知设计:整个系统在构建时以 Token 效率为核心,使用复杂的算法来确定对于任何给定查询来说真正必要的上下文是什么。
衡量影响:代码审查任务的真实结果
上下文引擎的理论收益很有说服力,但真实世界的验证必不可少。FlowHunt 使用其内部编码智能体执行的实际代码审查任务,对其上下文引擎进行了全面评估。结果为该方法的有效性提供了具体证据。
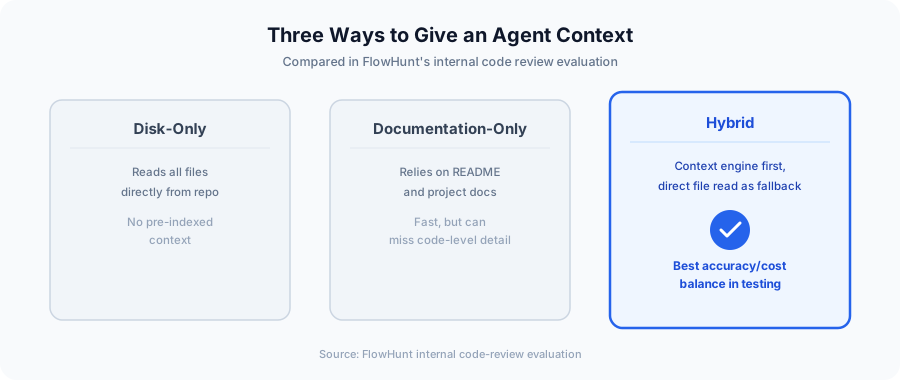
该评估比较了三种为代码审查智能体提供上下文的不同方法:
- 纯磁盘方法:智能体直接从仓库读取所有相关文件,没有任何预先索引的上下文。
- 纯文档方法:智能体仅依赖项目文档和 README 文件。
- 混合方法:智能体使用上下文引擎获取索引上下文,同时在需要时保留直接从仓库读取文件的能力。
结果令人瞩目。混合方法将上下文引擎与选择性文件访问相结合,实现了准确性与成本效率的最佳平衡。具体而言,与传统方法相比,该方法在保持甚至提升准确性指标的同时,将 Token 消耗降低了 23%。对于持续运行多个智能体的组织来说,这意味着显著的成本降低。
数据表明,最高效的前进道路并不是在上下文引擎和传统文件访问之间做选择——而是智能地将两者结合起来。上下文引擎作为频繁需要的信息的主要来源,而直接文件访问则为边缘情况或特殊查询提供后备方案。
在不同 AI 平台上实施上下文引擎
设计良好的上下文引擎最强大的方面之一,在于其平台无关性。统一的上下文引擎可以同时服务于多个智能体框架,而无需为每种 AI 智能体类型构建单独的上下文系统。
FlowHunt 上下文引擎通过支持与以下平台的集成展示了这一原则:
- Harx(FlowHunt 的内部编码智能体)
- Claude Code(Anthropic 的编码助手)
- Codeex(专用代码执行智能体)
- Pi.dev(专注于 Python 的开发智能体)
- Harness(部署与测试平台)
这种多平台方案带来了显著优势。组织可以标准化其上下文基础设施,同时仍保持为不同任务选择不同智能体实现的灵活性。上下文引擎成为可靠的中枢,确保所有智能体——无论其具体架构如何——都能访问一致、高质量的上下文。
Token 优化的经济学
理解上下文引擎实施在财务方面的影响对于决策至关重要。在使用商业 AI 模型时,Token 消耗直接转化为运营成本。Token 消耗降低 23% 意味着可观的成本节约,对于持续运行智能体的组织尤其如此。
设想一个场景:某组织每天对 100 个拉取请求运行代码审查智能体,每次审查平均消耗 10,000 个 Token。通过实施上下文引擎减少 23%,每天可节省约 230,000 个 Token。一个月下来,这接近 700 万个 Token——意味着数千美元的 API 成本削减。对于更大的组织,这些节省会按比例扩大。
除了直接的成本削减之外,Token 优化还能实现更快的智能体响应时间。更小的上下文窗口意味着更快的处理速度,使智能体能够更快完成任务,并更快地向开发者提供反馈。这形成了一种乘数效应,成本节约与生产力提升相互叠加。
上下文引擎部署的最佳实践
成功的上下文引擎实施需要周密的规划与执行。从真实部署中总结出了若干最佳实践:
从最高价值的用例开始:不要试图立即索引所有组织数据,而应从 Token 消耗最高、上下文效率最重要的具体任务入手。代码审查、文档生成和缺陷分诊是极佳的起点。
实施渐进式数据源集成:不要试图同时连接所有数据源。逐步构建集成,在添加下一个数据源之前,先验证每个新数据源确实提升了智能体性能。
持续监控与衡量:在实施上下文引擎之前建立基线指标,然后仔细跟踪变化。Token 消耗、准确性、响应时间和成本指标都应持续监控。
使用混合方案:数据强烈表明,纯上下文引擎方案并非最优。相反,应将索引上下文与直接访问源文件的能力结合起来,让智能体为每个查询选择最高效的检索方式。
为规模化做规划:在设计上下文引擎时就要考虑增长。随着你添加更多智能体和更多数据源,系统必须继续高效运行而不出现性能退化。
AI 智能体架构的未来
上下文引擎作为 AI 智能体架构关键组件的出现,代表着该领域的成熟。早期的 AI 智能体实现将上下文视为事后考虑——智能体接收任何可用的数据,并尽力加以利用。现代方案则认识到,上下文管理是智能体性能的根本所在。
展望未来,上下文引擎可能会变得越来越复杂。能够预测哪些上下文对特定任务类型最相关的机器学习模型,可以进一步优化 Token 消耗。与更多专用数据源和领域特定知识库的集成,将使智能体能够在专业领域中更高效地工作。实时学习系统可以根据智能体性能反馈来调整上下文提供策略。
贯穿所有这些发展的原则始终不变:最强大的 AI 智能体并不是那些拥有最大模型或最强原始算力的智能体,而是那些能够在恰当的时间访问到恰好正确上下文的智能体。
结论
对于认真对待 AI 驱动自动化的组织而言,为 AI 智能体构建高效的上下文引擎已不再是可选项。证据非常明确——实施良好的上下文引擎可将 Token 消耗降低 23%,同时提升准确性,直接转化为更低的成本和更好的智能体性能。该技术已足够成熟,可以投入生产部署,既有开源实现可用,也有来自真实用例的验证结果。
前进的道路在于将上下文引擎作为 AI 基础设施的核心组件来实施,从高价值用例开始并逐步扩展。通过将索引上下文与选择性直接访问相结合,组织可以实现最优效率。尽早采用上下文引擎的组织,将通过更低的运营成本、更快的智能体响应时间以及 AI 驱动任务中更高的准确性,获得显著的竞争优势。
用 FlowHunt 为你的工作流加速
体验 FlowHunt 如何自动化你的 AI 内容与 SEO 工作流——从调研和内容生成到发布和分析——全部集中在一处。
