


Úvod
Efektivita AI agentů kriticky závisí na jednom zásadním faktoru: přístupu ke správným informacím ve správný čas. Jak organizace nasazují stále sofistikovanější AI agenty interně, objevil se jasný vzorec – když agenti dostávají řádně kurátorovaný a indexovaný kontext, jejich přesnost dramaticky roste a spotřeba tokenů výrazně klesá. Tento posun představuje zásadní změnu v tom, jak uvažujeme o architektuře AI agentů. Namísto poskytování surového, nefiltrovaného přístupu ke všem dostupným datům se moderní přístupy zaměřují na budování inteligentních kontextových enginů, které slouží jako mozek AI systémů. V tomto článku prozkoumáme, jak kontextový engine vytvořit a implementovat, proč je pro vaši organizaci důležitý a jak může snížit provozní náklady a zároveň zlepšit výkon agentů.
Co je kontextový engine?
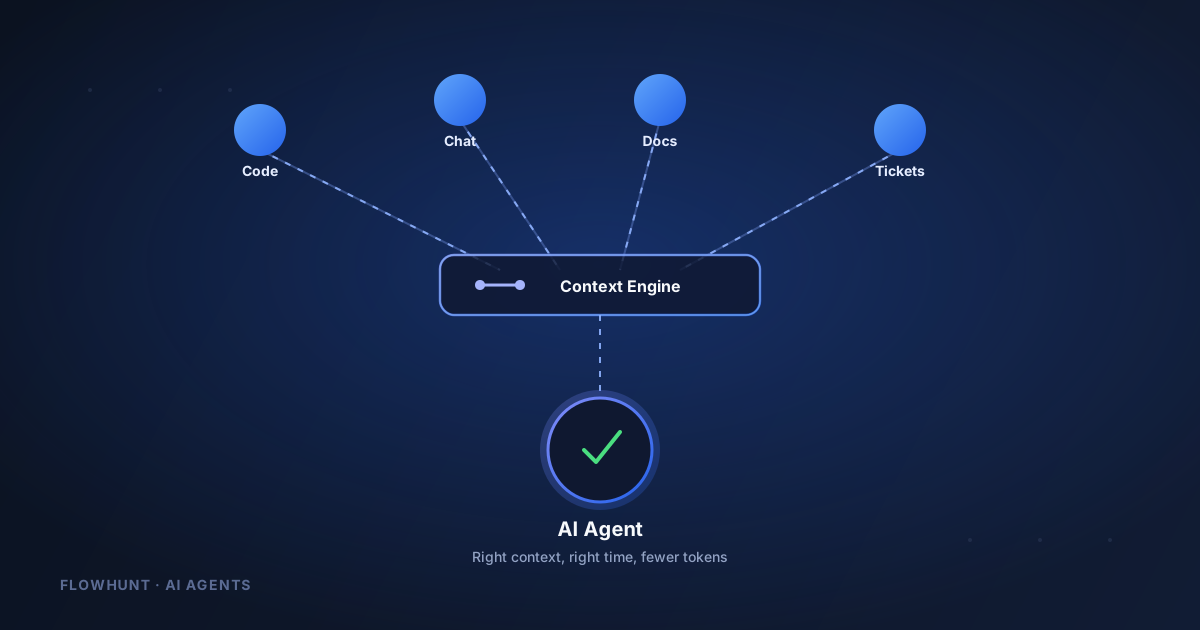
Kontextový engine je v podstatě sofistikovaný systém navržený tak, aby agregoval, indexoval a poskytoval kontextové informace AI agentům co nejefektivnějším možným způsobem. Místo toho, aby agenti museli ručně prohledávat celé repozitáře, dokumentaci nebo datová úložiště, funguje kontextový engine jako inteligentní prostředník, který rozumí tomu, jaký kontext agent potřebuje, a dodává jej přesně ve chvíli, kdy je potřeba.
Základním principem kontextového enginu je optimalizace. Tradiční architektury AI agentů často trpí tím, co bychom mohli nazvat “context bloat” – nabobtnáním kontextu. Agenti dostávají příliš mnoho informací, což vede k delší době zpracování, vyšší spotřebě tokenů a někdy i ke snížení přesnosti kvůli šumu v kontextovém okně. Kontextový engine to řeší implementací inteligentních filtračních a indexačních mechanismů, které zajišťují, že agenti dostávají pouze ta nejrelevantnější data pro svůj konkrétní úkol.

Připraveni rozšířit své podnikání?
Začněte svou bezplatnou zkušební verzi ještě dnes a viďte výsledky během několika dní.
Proč je správa kontextu důležitá pro výkon AI agentů
V rychle se vyvíjejícím prostředí vývoje poháněného AI se schopnost efektivně spravovat kontext stala konkurenční výhodou. Jak organizace rozšiřují využití AI agentů pro revizi kódu, opravu chyb, generování dokumentace a další složité úkoly, dopady neefektivní správy kontextu na náklady jsou stále významnější.
Zvažte praktické důsledky:
- Efektivita tokenů: Každý token spotřebovaný AI modelem představuje přímé náklady. Zbytečný kontext zvyšuje spotřebu tokenů exponenciálně, což vede k vyšším provozním nákladům a pomalejším reakcím.
- Zlepšení přesnosti: Když mají agenti přístup přesně ke správnému kontextu bez šumu nebo irelevantních informací, jejich rozhodování se zlepšuje. Mohou se soustředit na řešení skutečného problému místo procházení nadbytečných dat.
- Škálovatelnost: S rostoucím počtem agentů a rostoucí složitostí úkolů se ruční správa kontextu stává nemožnou. Automatizovaný kontextový engine umožňuje organizacím škálovat AI operace bez úměrného nárůstu nákladů.
- Reakce v reálném čase: Dobře navržený kontextový engine dokáže agentům poskytovat čerstvé, aktuální informace, takže vždy pracují s aktuálními daty místo zastaralých snímků.
Jak FlowHunt integruje principy kontextového enginu
FlowHunt si uvědomuje, že moderní AI pracovní postupy vyžadují inteligentní správu kontextu ve svém jádru. Jako platforma pro AI agenty má za úkol zajistit, aby vaši inteligentní agenti vždy pracovali se správným výsekem vašich dat, nikoli s celým skladem. Platforma začleňuje principy kontextového enginu do svého automatizačního rámce, což uživatelům umožňuje vytvářet AI pracovní postupy, které si udržují efektivitu i při velkém rozsahu. Díky integraci s více datovými zdroji a implementaci chytrého indexování FlowHunt zajišťuje, že vaši AI agenti – ať už generují obsah, revidují kód nebo analyzují data – mají vždy přístup k nejrelevantnějšímu kontextu bez režijních nákladů na zpracování irelevantních informací.
Přihlaste se k odběru newsletteru
Získejte nejnovější tipy, trendy a nabídky zdarma.
Vytváření efektivního kontextového enginu: Architektura a komponenty
Produkčně zralý kontextový engine vyžaduje pečlivé architektonické plánování. Systém musí zvládat více datových zdrojů současně, efektivně indexovat informace a poskytovat tento kontext různým AI agentům prostřednictvím standardizovaného protokolu.
| Komponenta | Účel | Integrační body |
|---|---|---|
| Vrstva agregace dat | Shromažďuje události a data z více zdrojů | GitHub, Slack, Discord, Stripe, webové stránky |
| Indexovací engine | Organizuje a optimalizuje data pro rychlé vyhledávání | Fulltextové vyhledávání, sémantické indexování, tagování metadat |
| Dotazovací rozhraní | Poskytuje standardizovaný přístup pro AI agenty | Server MCP (Model Context Protocol) |
| Cache vrstva | Snižuje latenci u často přistupovaného kontextu | Cachování v paměti s politikami TTL |
| Integrační rámec | Umožňuje připojení k novým datovým zdrojům | Příjemci webhooků, API konektory, posluchače událostí |
Nejefektivnější kontextové enginy používají hybridní přístup, který kombinuje více strategií vyhledávání. Místo spoléhání se pouze na jednu metodu používají inteligentní směrování k určení, zda má kontext pocházet z indexovaného enginu, přímého přístupu k souborům nebo vyhledávání v dokumentaci – na základě konkrétního dotazu a požadavků agenta. V praxi je toto dotazovací rozhraní obvykle vystaveno jako MCP server, takže se k němu může připojit jakýkoli kompatibilní agent stejně, jako by se připojoval k jakémukoli jinému nástroji.
Kontextový engine FlowHunt: Praktická implementace
FlowHunt vyvinul open-source kontextový engine speciálně navržený pro pracovní postupy AI agentů. Tento kontextový engine, dostupný prostřednictvím harx.dev, ukazuje, jak prakticky implementovat správu kontextu v produkčním prostředí. Systém je postaven na Model Context Protocol (MCP), standardizovaném rozhraní, které umožňuje více AI agentům dotazovat se kontextového enginu bez ohledu na jejich základní architekturu.
Implementace zahrnuje několik klíčových vlastností:
- Integrace více zdrojů: Kontextový engine agreguje data z repozitářů GitHub, kanálů Slack, serverů Discord, fakturačních informací Stripe, obsahu YouTube, webových stránek a tiketovacích systémů. Tato komplexní integrace znamená, že agenti mají přístup k organizačním znalostem ze všech kritických systémů.
- Inteligentní správa souborového systému: Engine automaticky organizuje indexovaná data do logických entit – hlášení o chybách, požadavky na funkce, uživatelské faktury, informace o zákaznících – což agentům usnadňuje navigaci a vyhledávání konkrétních informací.
- Aktualizace v reálném čase: Jakmile v připojených platformách nastanou nové události, kontextový engine je automaticky zpracuje a zaindexuje, takže agenti vždy pracují s aktuálními informacemi.
- Design s ohledem na náklady: Celý systém je navržen s ohledem na efektivitu tokenů a používá sofistikované algoritmy k určení, který kontext je pro daný dotaz skutečně nezbytný.
Měření dopadu: Výsledky z reálného světa u úloh revize kódu
Teoretické přínosy kontextového enginu jsou přesvědčivé, ale ověření v reálném světě je nezbytné. FlowHunt provedl komplexní vyhodnocení svého kontextového enginu pomocí skutečných úloh revize kódu, které prováděl jejich interní kódovací agent. Výsledky poskytují konkrétní důkaz o efektivitě tohoto přístupu.
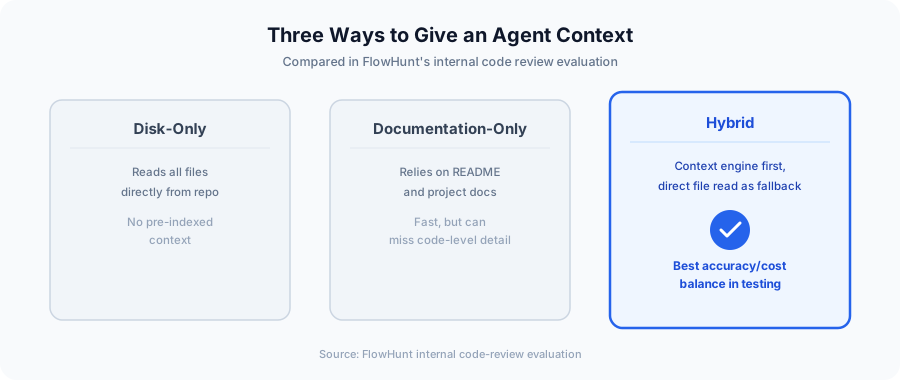
Hodnocení porovnávalo tři odlišné přístupy k poskytování kontextu agentovi pro revizi kódu:
- Přístup pouze z disku: Agent čte všechny relevantní soubory přímo z repozitáře bez předem indexovaného kontextu.
- Přístup pouze z dokumentace: Agent se spoléhá výhradně na projektovou dokumentaci a soubory README.
- Hybridní přístup: Agent používá kontextový engine pro indexovaný kontext a zároveň si zachovává možnost číst soubory přímo z repozitáře, když je to potřeba.
Výsledky byly pozoruhodné. Hybridní přístup, který kombinuje kontextový engine se selektivním přístupem k souborům, dosáhl nejlepší rovnováhy mezi přesností a nákladovou efektivitou. Konkrétně tato metoda snížila spotřebu tokenů o 23 % ve srovnání s tradičními přístupy a zároveň zachovala nebo zlepšila metriky přesnosti. To představuje výrazné snížení nákladů pro organizace, které provozují více agentů nepřetržitě.
Data ukazují, že nejefektivnější cesta vpřed nespočívá ve volbě mezi kontextovými enginy a tradičním přístupem k souborům – jde o inteligentní kombinaci obou přístupů. Kontextový engine slouží jako primární zdroj často potřebných informací, zatímco přímý přístup k souborům poskytuje záložní řešení pro okrajové případy nebo specializované dotazy.
Implementace kontextových enginů napříč různými AI platformami
Jedním z nejmocnějších aspektů dobře navrženého kontextového enginu je jeho nezávislost na platformě. Místo budování samostatných kontextových systémů pro každý typ AI agenta může jednotný kontextový engine obsluhovat více agentních frameworků současně.
Kontextový engine FlowHunt tento princip demonstruje podporou integrace s:
- Harx (interní kódovací agent FlowHunt)
- Claude Code (kódovací asistent společnosti Anthropic)
- Codeex (specializovaný agent pro spouštění kódu)
- Pi.dev (vývojový agent zaměřený na Python)
- Harness (platforma pro nasazení a testování)
Tento multi-platformní přístup nabízí významné výhody. Organizace mohou standardizovat svou kontextovou infrastrukturu a zároveň si zachovat flexibilitu vybrat různé implementace agentů pro různé úkoly. Kontextový engine se stává spolehlivou páteří, která zajišťuje, že všichni agenti, bez ohledu na svou konkrétní architekturu, mají přístup ke konzistentnímu, vysoce kvalitnímu kontextu.
Ekonomika optimalizace tokenů
Pochopení finančních dopadů implementace kontextového enginu je klíčové pro rozhodování. Spotřeba tokenů se při používání komerčních AI modelů přímo promítá do provozních nákladů. Snížení spotřeby tokenů o 23 % představuje značnou úsporu nákladů, zejména pro organizace provozující agenty nepřetržitě.
Představte si scénář: organizace provozuje agenty pro revizi kódu na 100 pull requestech denně, přičemž každá revize spotřebuje v průměru 10 000 tokenů. Snížení o 23 % díky implementaci kontextového enginu by ušetřilo přibližně 230 000 tokenů denně. Za měsíc je to téměř 7 milionů tokenů – což představuje tisíce dolarů ušetřených nákladů na API. U větších organizací se tyto úspory úměrně zvyšují.
Kromě přímého snižování nákladů umožňuje optimalizace tokenů rychlejší reakce agentů. Menší kontextová okna znamenají rychlejší zpracování, takže agenti mohou dokončovat úkoly rychleji a poskytovat vývojářům zpětnou vazbu dříve. Vzniká tak multiplikační efekt, kdy se úspora nákladů kombinuje se zvýšenou produktivitou.
Osvědčené postupy pro nasazení kontextového enginu
Úspěšná implementace kontextového enginu vyžaduje pečlivé plánování a provedení. Z nasazení v reálném světě vyplynulo několik osvědčených postupů:
Začněte s případy použití s nejvyšší hodnotou: Místo snahy o okamžité indexování všech organizačních dat začněte s konkrétními úkoly, kde je spotřeba tokenů nejvyšší a efektivita kontextu nejdůležitější. Revize kódu, generování dokumentace a třídění chyb jsou vynikajícími výchozími body.
Zavádějte integraci zdrojů postupně: Nepokoušejte se připojit všechny datové zdroje současně. Budujte integrace postupně a ověřujte, že každý nový zdroj skutečně zlepšuje výkon agenta, než přidáte další.
Nepřetržitě monitorujte a měřte: Před implementací kontextového enginu stanovte výchozí metriky a poté pečlivě sledujte změny. Spotřeba tokenů, míra přesnosti, doby odezvy a nákladové metriky by měly být sledovány průběžně.
Používejte hybridní přístupy: Data silně naznačují, že čistě kontextové přístupy nejsou optimální. Kombinujte místo toho indexovaný kontext se schopností přistupovat přímo ke zdrojovým souborům, což agentům umožní zvolit pro každý dotaz nejefektivnější metodu vyhledávání.
Plánujte škálování: Navrhněte svůj kontextový engine s ohledem na růst. Jak přidáváte další agenty a další datové zdroje, systém musí nadále fungovat efektivně bez zhoršení.
Budoucnost architektury AI agentů
Vznik kontextových enginů jako kritické součásti architektury AI agentů představuje dozrání tohoto oboru. Rané implementace AI agentů považovaly kontext za něco okrajového – agenti dostávali, co bylo k dispozici, a snažili se s tím pracovat co nejlépe. Moderní přístupy uznávají, že správa kontextu je pro výkon agenta zásadní.
Do budoucna budou kontextové enginy pravděpodobně stále sofistikovanější. Modely strojového učení, které předpovídají, který kontext bude pro konkrétní typy úkolů nejrelevantnější, by mohly dále optimalizovat spotřebu tokenů. Integrace se specializovanějšími datovými zdroji a doménově specifickými znalostními bázemi umožní agentům pracovat efektivněji ve specializovaných doménách. Systémy učení v reálném čase by mohly přizpůsobovat strategie poskytování kontextu na základě zpětné vazby o výkonu agentů.
Princip, který je základem všech těchto vývojových směrů, zůstává neměnný: nejvýkonnější AI agenti nejsou ti s největšími modely nebo největším hrubým výpočetním výkonem, ale ti s přístupem přesně ke správnému kontextu ve správný čas.
Závěr
Vytvoření efektivního kontextového enginu pro AI agenty už není volitelné pro organizace, které to s automatizací řízenou AI myslí vážně. Důkazy jsou jasné – dobře implementovaný kontextový engine snižuje spotřebu tokenů o 23 % a zároveň zvyšuje přesnost, což se přímo promítá do nižších nákladů a lepšího výkonu agentů. Technologie je dostatečně vyspělá pro produkční nasazení, k dispozici jsou open-source implementace a osvědčené výsledky z reálných případů použití.
Cesta vpřed zahrnuje implementaci kontextových enginů jako klíčové součásti vaší AI infrastruktury, počínaje případy použití s vysokou hodnotou a postupným rozšiřováním. Kombinací indexovaného kontextu se selektivním přímým přístupem mohou organizace dosáhnout optimální efektivity. Organizace, které kontextové enginy přijmou včas, získají významné konkurenční výhody díky nižším provozním nákladům, rychlejším reakcím agentů a vyšší přesnosti v úlohách řízených AI.
Nakopněte své pracovní postupy s FlowHunt
Zažijte, jak FlowHunt automatizuje vaše AI obsahové a SEO pracovní postupy – od výzkumu a generování obsahu až po publikování a analytiku – vše na jednom místě.
