


Introduksjon
Effektiviteten til AI-agenter avhenger kritisk av én grunnleggende faktor: å ha tilgang til riktig informasjon til riktig tid. Etter hvert som organisasjoner tar i bruk stadig mer sofistikerte AI-agenter internt, har et tydelig mønster vokst fram – når agenter mottar riktig kuratert og indeksert kontekst, forbedres nøyaktigheten dramatisk samtidig som tokenforbruket synker betydelig. Dette skiftet representerer en grunnleggende endring i måten vi tenker på arkitekturen til AI-agenter. I stedet for å gi agenter rå, ufiltrert tilgang til alle tilgjengelige data, fokuserer moderne tilnærminger på å bygge intelligente kontekstmotorer som fungerer som hjernen i AI-systemer. I denne artikkelen utforsker vi hvordan du bygger og implementerer en kontekstmotor, hvorfor den er viktig for organisasjonen din, og hvordan den kan redusere driftskostnadene samtidig som agentytelsen forbedres.
Hva er en kontekstmotor?
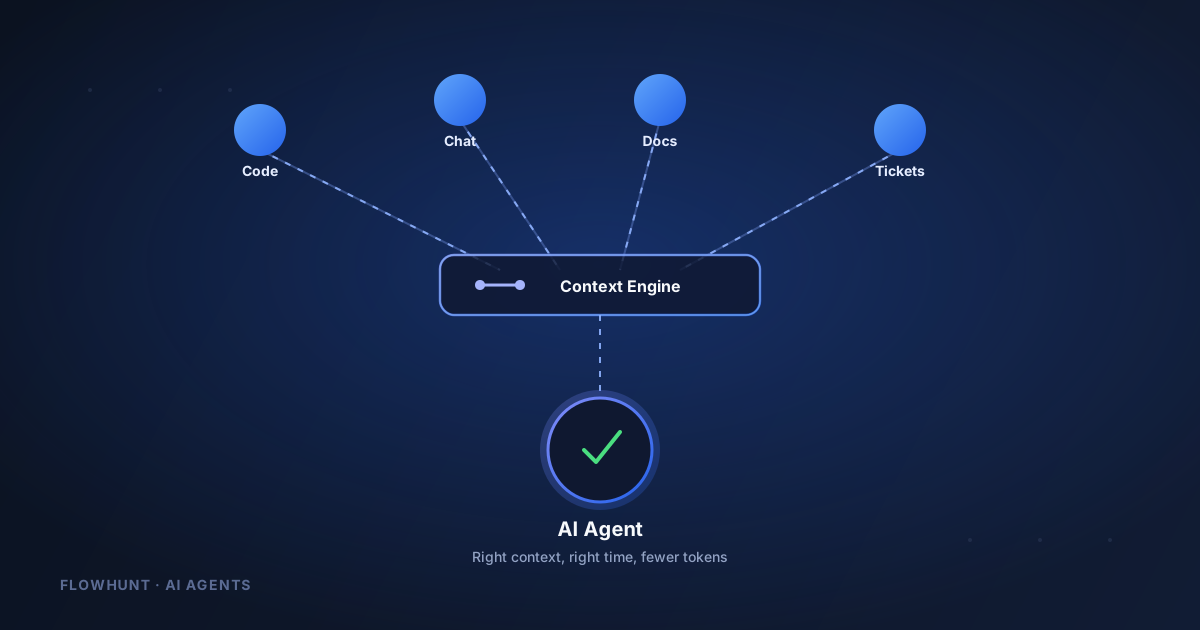
En kontekstmotor er i bunn og grunn et sofistikert system utformet for å samle, indeksere og levere kontekstuell informasjon til AI-agenter på den mest effektive måten som er mulig. I stedet for å tvinge agenter til å lete manuelt gjennom hele repositorier, dokumentasjon eller datalagre, fungerer en kontekstmotor som en intelligent mellomledd som forstår hvilken kontekst en agent trenger, og leverer den presist når den trengs.
Kjerneprinsippet bak en kontekstmotor er optimalisering. Tradisjonelle arkitekturer for AI-agenter lider ofte av det man kan kalle «kontekstoppblåsthet» – agentene mottar for mye informasjon, noe som fører til lengre behandlingstid, høyere tokenforbruk og noen ganger til og med redusert nøyaktighet på grunn av støy i kontekstvinduet. En kontekstmotor løser dette ved å implementere intelligente filtrerings- og indekseringsmekanismer som sikrer at agentene bare mottar de mest relevante dataene for sin spesifikke oppgave.

Klar til å vokse bedriften din?
Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
Hvorfor kontekststyring er viktig for AI-agenters ytelse
I det raskt utviklende landskapet for AI-drevet utvikling har evnen til å håndtere kontekst effektivt blitt et konkurransefortrinn. Etter hvert som organisasjoner skalerer bruken av AI-agenter til kodegjennomgang, feilretting, dokumentasjonsgenerering og andre komplekse oppgaver, blir kostnadskonsekvensene av ineffektiv kontekststyring stadig mer betydningsfulle.
Tenk på de praktiske konsekvensene:
- Tokeneffektivitet: Hvert token som forbrukes av en AI-modell, representerer en direkte kostnad. Unødvendig kontekst øker tokenforbruket eksponentielt, noe som fører til høyere driftsutgifter og langsommere responstider.
- Bedre nøyaktighet: Når agenter har tilgang til nøyaktig riktig kontekst uten støy eller irrelevant informasjon, forbedres beslutningstakingen. De kan fokusere på å løse det faktiske problemet i stedet for å tolke overflødige data.
- Skalerbarhet: Etter hvert som antallet agenter og kompleksiteten i oppgavene øker, blir manuell kontekststyring umulig. En automatisert kontekstmotor gjør det mulig for organisasjoner å skalere AI-driften uten tilsvarende kostnadsøkninger.
- Sanntidsrespons: En godt utformet kontekstmotor kan levere fersk og oppdatert informasjon til agentene, slik at de alltid arbeider med gjeldende data i stedet for foreldede øyeblikksbilder.
Hvordan FlowHunt integrerer prinsippene for kontekstmotorer
FlowHunt erkjenner at moderne AI-arbeidsflyter krever intelligent kontekststyring i kjernen. Som en AI-agentplattform er jobben dens å sikre at dine intelligente agenter alltid arbeider med riktig del av dataene dine, ikke hele lageret. Plattformen inkorporerer prinsippene for kontekstmotorer i sitt automatiseringsrammeverk, slik at brukere kan bygge AI-drevne arbeidsflyter som holder seg effektive også i stor skala. Gjennom integrasjon med flere datakilder og smart indeksering sikrer FlowHunt at AI-agentene dine – enten de genererer innhold, gjennomgår kode eller analyserer data – alltid har tilgang til den mest relevante konteksten uten kostnaden ved å behandle irrelevant informasjon.
Bli med i vårt nyhetsbrev
Få de siste tipsene, trendene og tilbudene gratis.
Bygge en effektiv kontekstmotor: Arkitektur og komponenter
En produksjonsklar kontekstmotor krever nøye arkitekturplanlegging. Systemet må håndtere flere datakilder samtidig, indeksere informasjon effektivt og levere denne konteksten til ulike AI-agenter gjennom en standardisert protokoll.
| Komponent | Formål | Integrasjonspunkter |
|---|---|---|
| Datalag for aggregering | Samler hendelser og data fra flere kilder | GitHub, Slack, Discord, Stripe, nettsteder |
| Indekseringsmotor | Organiserer og optimaliserer data for rask gjenfinning | Fulltekstsøk, semantisk indeksering, metadatamerking |
| Spørregrensesnitt | Gir standardisert tilgang for AI-agenter | MCP-server (Model Context Protocol) |
| Hurtiglager | Reduserer latenstid for kontekst som brukes ofte | Minnebasert hurtiglagring med TTL-policyer |
| Integrasjonsrammeverk | Muliggjør tilkobling til nye datakilder | Webhook-mottakere, API-koblinger, hendelseslyttere |
De mest effektive kontekstmotorene bruker en hybrid tilnærming som kombinerer flere gjenfinningsstrategier. I stedet for å stole på bare én metode, bruker de intelligent ruting for å avgjøre om konteksten skal hentes fra den indekserte motoren, direkte filtigang eller oppslag i dokumentasjon, basert på den spesifikke spørringen og agentens behov. I praksis eksponeres dette spørregrensesnittet vanligvis som en MCP-server, slik at enhver kompatibel agent kan koble seg til den på samme måte som den ville koblet til et hvilket som helst annet verktøy.
FlowHunt-kontekstmotoren: Praktisk implementering
FlowHunt har utviklet en kontekstmotor med åpen kildekode som er spesielt utformet for AI-agenters arbeidsflyter. Denne kontekstmotoren, som er tilgjengelig via harx.dev, viser hvordan kontekststyring kan implementeres i praksis i produksjonsmiljøer. Systemet er bygget på Model Context Protocol (MCP), et standardisert grensesnitt som gjør det mulig for flere AI-agenter å spørre kontekstmotoren uavhengig av underliggende arkitektur.
Implementeringen inneholder flere sentrale funksjoner:
- Integrasjon av flere kilder: Kontekstmotoren samler data fra GitHub-repositorier, Slack-kanaler, Discord-servere, Stripe-faktureringsinformasjon, YouTube-innhold, nettsteder og sakssystemer. Denne omfattende integrasjonen betyr at agentene har tilgang til organisasjonskunnskap fra alle kritiske systemer.
- Intelligent filsystemhåndtering: Motoren organiserer automatisk indekserte data i logiske enheter – feilrapporter, funksjonsønsker, brukerfakturaer, kundeinformasjon – noe som gjør det enkelt for agenter å navigere og hente spesifikk informasjon.
- Sanntidsoppdateringer: Etter hvert som nye hendelser inntreffer i tilkoblede plattformer, behandler og indekserer kontekstmotoren dem automatisk, slik at agentene alltid arbeider med oppdatert informasjon.
- Kostnadsbevisst design: Hele systemet er bygget med token-effektivitet for øye, og bruker sofistikerte algoritmer for å avgjøre hvilken kontekst som faktisk er nødvendig for en gitt spørring.
Måle effekten: Resultater fra virkelige kodegjennomgåingsoppgaver
De teoretiske fordelene med en kontekstmotor er overbevisende, men validering i virkelige settinger er avgjørende. FlowHunt gjennomførte en omfattende evaluering av sin kontekstmotor ved hjelp av faktiske kodegjennomgåingsoppgaver utført av deres interne kodeagent. Resultatene gir konkrete bevis på tilnærmingens effektivitet.
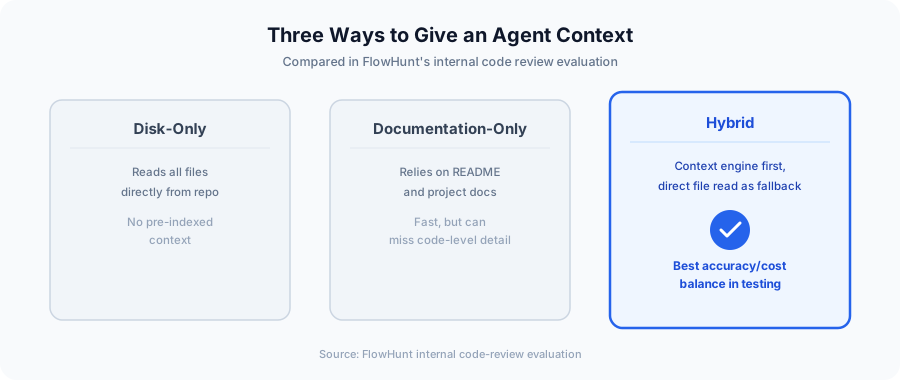
Evalueringen sammenlignet tre ulike tilnærminger til å gi kontekst til kodegjennomgangsagenten:
- Kun disk: Agenten leser alle relevante filer direkte fra repositoriet uten forhåndsindeksert kontekst.
- Kun dokumentasjon: Agenten støtter seg utelukkende på prosjektdokumentasjon og README-filer.
- Hybrid tilnærming: Agenten bruker kontekstmotoren for indeksert kontekst, men beholder muligheten til å lese filer direkte fra repositoriet ved behov.
Resultatene var slående. Hybridtilnærmingen, som kombinerer kontekstmotoren med selektiv filtigang, oppnådde den beste balansen mellom nøyaktighet og kostnadseffektivitet. Denne metoden reduserte tokenforbruket med 23 % sammenlignet med tradisjonelle tilnærminger, samtidig som nøyaktighetsmålene ble opprettholdt eller forbedret. Dette representerer en betydelig kostnadsreduksjon for organisasjoner som kjører flere agenter kontinuerlig.
Dataene viser at den mest effektive veien videre ikke er å velge mellom kontekstmotorer og tradisjonell filtigang – det er å kombinere begge tilnærmingene intelligent. Kontekstmotoren fungerer som hovedkilde for informasjon som trengs ofte, mens direkte filtigang gir en fallback for spesialtilfeller eller spesialiserte spørringer.
Implementere kontekstmotorer på tvers av ulike AI-plattformer
En av de kraftigste sidene ved en godt utformet kontekstmotor er at den er plattformuavhengig. I stedet for å bygge separate kontekstsystemer for hver type AI-agent, kan én enhetlig kontekstmotor betjene flere agentrammeverk samtidig.
FlowHunt-kontekstmotoren demonstrerer dette prinsippet ved å støtte integrasjon med:
- Harx (FlowHunts interne kodeagent)
- Claude Code (Anthronics kodeassistent)
- Codeex (spesialisert agent for kodekjøring)
- Pi.dev (Python-fokusert utvikleragent)
- Harness (plattform for distribusjon og testing)
Denne plattformuavhengige tilnærmingen gir betydelige fordeler. Organisasjoner kan standardisere kontekstinfrastrukturen sin og samtidig beholde fleksibiliteten til å velge ulike agentimplementeringer for ulike oppgaver. Kontekstmotoren blir den pålitelige ryggraden som sikrer at alle agenter, uavhengig av sin spesifikke arkitektur, har tilgang til konsistent kontekst av høy kvalitet.
Økonomien i tokenoptimalisering
Å forstå de økonomiske konsekvensene av å implementere en kontekstmotor er avgjørende for beslutningstaking. Tokenforbruk oversettes direkte til driftskostnader når man bruker kommersielle AI-modeller. En reduksjon på 23 % i tokenforbruket representerer betydelige kostnadsbesparelser, særlig for organisasjoner som kjører agenter kontinuerlig.
Tenk på et scenario: en organisasjon som kjører kodegjennomgangsagenter på 100 pull requests daglig, der hver gjennomgang i gjennomsnitt forbruker 10 000 tokens. En reduksjon på 23 % gjennom implementering av kontekstmotor vil spare omtrent 230 000 tokens daglig. Over en måned er det nesten 7 millioner tokens – noe som tilsvarer tusenvis av dollar i reduserte API-kostnader. For større organisasjoner skalerer disse besparelsene proporsjonalt.
I tillegg til direkte kostnadsreduksjon muliggjør tokenoptimalisering raskere responstider for agentene. Mindre kontekstvinduer betyr raskere behandling, slik at agentene kan fullføre oppgaver raskere og gi utviklerne tilbakemelding raskere. Dette skaper en multiplikatoreffekt der kostnadsbesparelser kombineres med bedre produktivitet.
Beste praksis for utrulling av kontekstmotorer
Vellykket implementering av en kontekstmotor krever nøye planlegging og gjennomføring. Flere beste praksiser har vokst fram fra utrullinger i virkelige miljøer:
Start med brukstilfellene som gir størst verdi: I stedet for å forsøke å indeksere alle organisasjonsdata med en gang, begynn med de spesifikke oppgavene der tokenforbruket er høyest og konteksteffektiviteten betyr mest. Kodegjennomgang, dokumentasjonsgenerering og feiltriage er utmerkede utgangspunkt.
Innfør kildeintegrasjon trinnvis: Ikke forsøk å koble til alle datakilder samtidig. Bygg integrasjoner trinnvis, og verifiser at hver nye kilde faktisk forbedrer agentytelsen før du legger til den neste.
Overvåk og mål kontinuerlig: Etabler basismålinger før du implementerer kontekstmotoren, og følg deretter endringene nøye. Tokenforbruk, nøyaktighetsrater, responstider og kostnadsmålinger bør alle overvåkes konsekvent.
Bruk hybride tilnærminger: Dataene tyder sterkt på at rene kontekstmotor-tilnærminger ikke er optimale. Kombiner i stedet indeksert kontekst med muligheten til å få direkte tilgang til kildefiler, slik at agentene kan velge den mest effektive gjenfinningsmetoden for hver spørring.
Planlegg for skalering: Design kontekstmotoren med vekst for øye. Etter hvert som du legger til flere agenter og flere datakilder, må systemet fortsette å yte effektivt uten forringelse.
Fremtiden for AI-agenters arkitektur
Framveksten av kontekstmotorer som en kritisk komponent i AI-agenters arkitektur representerer en modning av feltet. Tidlige implementeringer av AI-agenter behandlet kontekst som en ettertanke – agentene fikk de dataene som var tilgjengelige og gjorde sitt beste for å arbeide med dem. Moderne tilnærminger anerkjenner at kontekststyring er grunnleggende for agentenes ytelse.
Framover vil kontekstmotorer sannsynligvis bli stadig mer sofistikerte. Maskinlæringsmodeller som forutsier hvilken kontekst som vil være mest relevant for bestemte oppgavetyper, kan optimalisere tokenforbruket ytterligere. Integrasjon med mer spesialiserte datakilder og domenespesifikke kunnskapsbaser vil gjøre agentene i stand til å arbeide mer effektivt i spesialiserte domener. Sanntidslæringssystemer kan justere strategiene for kontekstlevering basert på tilbakemelding om agentytelse.
Prinsippet som ligger bak alle disse utviklingene, forblir konstant: de kraftigste AI-agentene er ikke de med de største modellene eller mest rå datakraft, men de som har tilgang til nøyaktig riktig kontekst til riktig tid.
Konklusjon
Å bygge en effektiv kontekstmotor for AI-agenter er ikke lenger valgfritt for organisasjoner som er seriøse med AI-drevet automatisering. Bevisene er tydelige – en godt implementert kontekstmotor reduserer tokenforbruket med 23 % samtidig som nøyaktigheten forbedres, noe som direkte oversettes til lavere kostnader og bedre agentytelse. Teknologien er moden nok for produksjonsutrulling, med tilgjengelige implementeringer med åpen kildekode og dokumenterte resultater fra virkelige brukstilfeller.
Veien videre innebærer å implementere kontekstmotorer som en kjernekomponent i AI-infrastrukturen din, med start i brukstilfeller med høy verdi og gradvis utvidelse. Ved å kombinere indeksert kontekst med selektiv direkte tilgang kan organisasjoner oppnå optimal effektivitet. Organisasjonene som tar i bruk kontekstmotorer tidlig, vil oppnå betydelige konkurransefortrinn gjennom lavere driftskostnader, raskere responstider fra agentene og bedre nøyaktighet i AI-drevne oppgaver.
Superlad arbeidsflyten din med FlowHunt
Opplev hvordan FlowHunt automatiserer AI- og SEO-arbeidsflytene dine – fra research og innholdsgenerering til publisering og analyse – alt på ett sted.
