


Escrever documentação manualmente significa ler o código ou o processo você mesmo, decidir o que importa e depois escrevê-lo no tempo livre que sobra depois de entregar.
Os casos de uso de IA para redação técnica eliminam a etapa intermediária. Em vez de descrever de memória o que um sistema faz, você aponta a IA para o código-fonte real e ela gera a explicação diretamente a partir da lógica. Tudo o que resta para você fazer é verificar se tudo se encaixa.
Mas nem todo tipo de documentação se beneficia igualmente. Alguns são quase puramente código-para-explicação, onde a IA tem uma clara vantagem de velocidade. Outros precisam de mais enquadramento humano em torno do núcleo gerado pela IA. Aqui estão cinco tipos específicos de documentação em que o Redator de Documentação com IA da FlowHunt supera consistentemente a escrita manual.
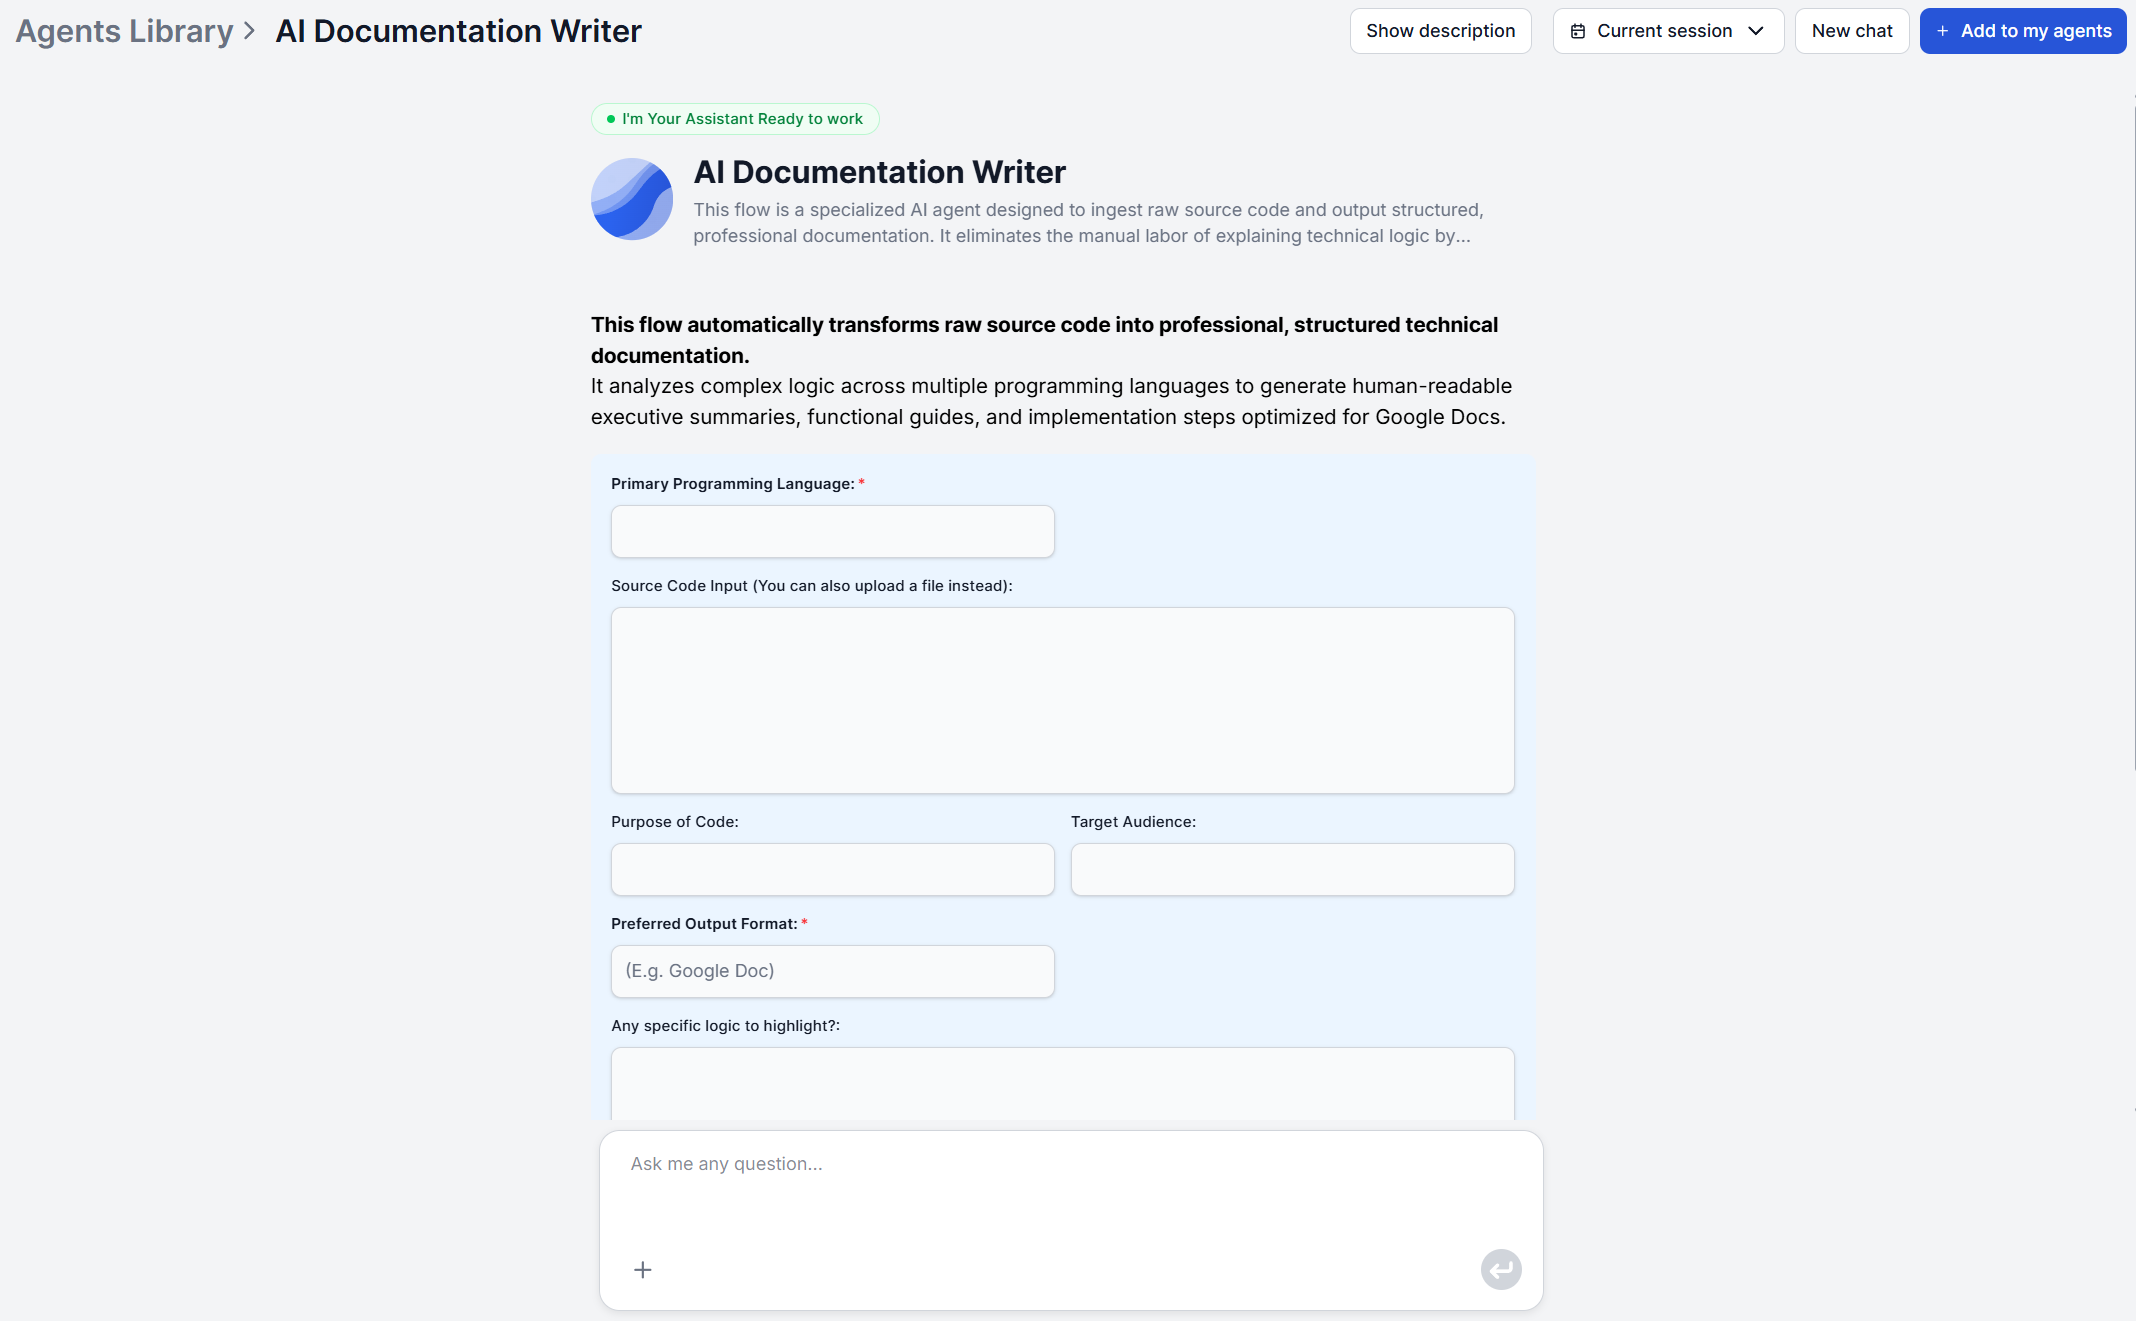
Para um passo a passo do próprio processo, veja como escrever documentação técnica automaticamente com IA .
Para entender por que esse problema existe, veja por que a documentação para desenvolvedores está sempre incompleta .
Caso de Uso 1: Documentação de Referência de API
Referências de API são o mais próximo de um cenário ideal para um gerador de documentação de API com IA, porque a fonte da verdade (os handlers de endpoints, os métodos do SDK, os formatos de requisição e resposta) já existe no código. Não há nada para perguntar a um desenvolvedor que já não esteja nas assinaturas das funções.
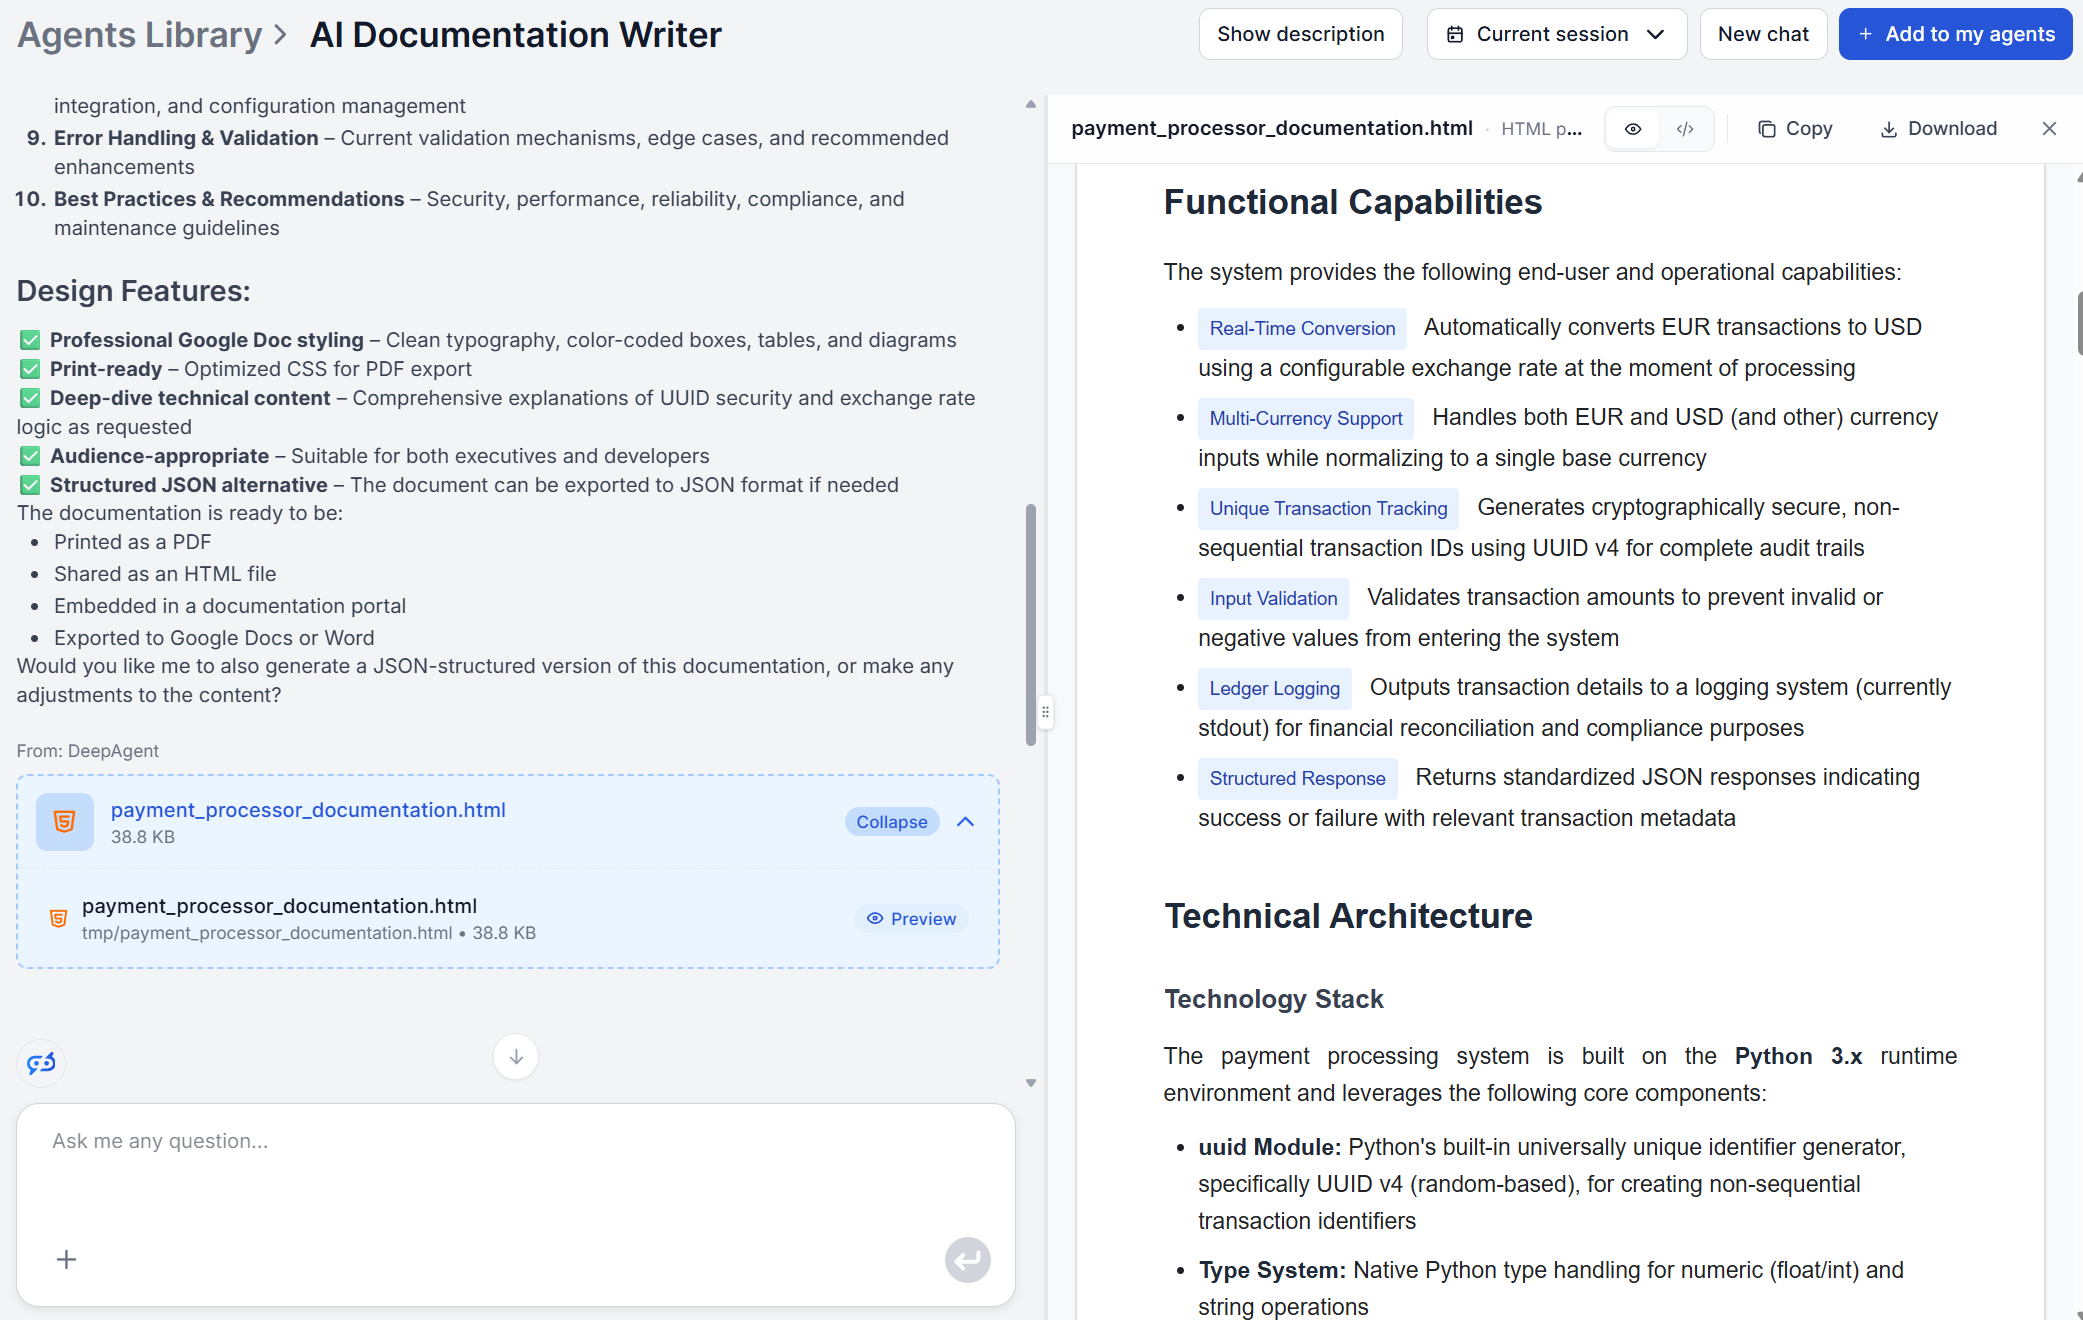
Aponte o Redator de Documentação com IA para o código da sua API ou simplesmente cole-o no chat, defina o público como “desenvolvedores” ou “consumidores da API” e use o campo “lógica específica a destacar” para sinalizar qualquer coisa fácil de passar despercebida que mereça atenção. A seção de principais funções e componentes do resultado se torna uma referência funcional, e a seção de arquitetura técnica cobre como as peças se encaixam.
A vantagem de velocidade se acumula com o tempo. As superfícies de API mudam em quase toda versão, um parâmetro é adicionado, um endpoint é descontinuado, e a documentação manual tende a ficar para trás exatamente nessas edições pequenas e frequentes.
Escrever uma referência para vinte endpoints à mão é uma tarefa de vários dias, mesmo para um desenvolvedor que conhece bem a base de código. Regerar a partir do código atual leva apenas alguns minutos, não importa quantas vezes a API tenha mudado desde a última versão, nem se são vinte ou duzentos endpoints.
Caso de Uso 2: Notas de Versão do Produto
As notas de versão precisam responder o que mudou e por que isso importa. Isso se mapeia de perto com duas seções que o redator de documentação já produz: o resumo executivo e a lista de capacidades funcionais.
Defina o objetivo como “notas de versão desta atualização”, o público como “clientes” ou “usuários finais” e insira o código do recurso ou correção específicos. A etapa de tradução em linguagem simples faz o trabalho de transformar um diff em uma descrição que um cliente não técnico consegue realmente entender, sem que um redator precise entrevistar o engenheiro que a construiu.
Ainda vale a pena uma leve passada de edição depois. Notas de versão normalmente precisam de uma voz consistente e de uma ordem específica (primeiro mudanças que quebram compatibilidade, depois novos recursos, depois correções) e, embora o resultado da IA forneça material bruto preciso para cada item, organizá-los e priorizá-los para um changelog voltado ao cliente é uma decisão de julgamento que uma pessoa deve tomar.

Pronto para expandir seu negócio?
Comece seu teste gratuito hoje e veja resultados em dias.
Caso de Uso 3: Guias de Integração de Usuários
A IA para documentação de produto justifica seu valor em guias de integração que são, na verdade, apenas descrições de etapas reais de configuração, comandos disponíveis ou requisitos de instalação que já vivem no código. Uma ferramenta de linha de comando, um SDK ou um aplicativo interno são todos bons candidatos.
Passe o mesmo código-fonte pelo redator de documentação, mas defina o público-alvo como “novos usuários” ou “partes interessadas não técnicas”. A etapa de tradução da lógica troca a terminologia de desenvolvedor por linguagem simples com fluxo natural, e a seção de instruções de implementação e uso se torna as próprias etapas de integração, cobrindo instalação, configuração e primeiro uso.
O trade-off que é bom conhecer desde o início é que essa abordagem documenta o que o produto faz e como configurá-lo, não por que um recurso existe sob a ótica de marketing de produto. Para conteúdo de integração mais narrativo do que instrucional, trate o resultado da IA como a espinha dorsal técnica precisa e adicione enquadramento em torno dele, em vez de esperar uma sequência de boas-vindas finalizada e alinhada à marca.
Isso importa mais para ferramentas de desenvolvedor, onde a primeira hora de um novo usuário geralmente é gasta em instalação, autenticação e execução de um primeiro comando bem-sucedido. Gerar essa seção diretamente do código real de instalação, em vez da memória de um desenvolvedor sobre como a instalação deveria funcionar, captura as pequenas inconsistências (uma flag renomeada, uma opção de configuração que mudou de lugar) que tornam os guias de integração silenciosamente errados em poucas versões.
Caso de Uso 4: SOPs Internos e Documentação de Processos
A automação de documentação interna importa mais aqui porque a documentação de processos internos se deteriora mais rápido. Ela geralmente existe como memória institucional. Um engenheiro sênior explicando um script de implantação ou uma automação de integração em voz alta, sem ninguém anotando antes que essa pessoa mude de equipe ou deixe a empresa.
Se essa explicação aconteceu em uma reunião gravada, passe-a primeiro pelo gerador de relatórios de reunião com IA para capturar o contexto como ata estruturada antes que ele se perca. Depois, insira o script real junto com o código de automação no redator de documentação, com o público definido como novos engenheiros contratados, para produzir o documento de referência que sobrevive à saída da pessoa.
Essa combinação resolve dois problemas diferentes de uma só vez. O relatório de reunião captura o contexto informal e o raciocínio que não está no código (por que o processo funciona assim), enquanto o redator de documentação captura o detalhe técnico preciso do que o código realmente faz.
Juntos, esses dois agents produzem o tipo de referência de integração que um novo contratado consegue realmente seguir sem arrastar um engenheiro sênior para outra reunião a fim de explicar o mesmo script uma segunda vez.
Junte-se à nossa newsletter
Receba gratuitamente as últimas dicas, tendências e ofertas.
Caso de Uso 5: Artigos de Base de Conhecimento
Artigos de base de conhecimento voltados ao cliente precisam de uma explicação precisa de como um recurso realmente se comporta e de uma formulação que corresponda a como os clientes já falam sobre o problema. O redator de documentação cuida da primeira parte diretamente: insira o código por trás do recurso, defina o público como “clientes” ou “equipe de suporte”, e as seções de capacidades funcionais e instruções de uso se tornam a espinha dorsal do artigo.
Esse último ponto é a parte com mais chance de ser ignorada, e é ele que determina se o artigo é realmente utilizável. Um artigo da base de conhecimento é lido por alguém no meio de um problema, não por alguém pesquisando, e o resultado em seis seções do redator de documentação é feito para completude, não para brevidade. Colar tudo isso em um artigo de suporte enterra a única frase de que um cliente frustrado precisa sob uma explicação de arquitetura que ninguém pediu.
Antes de publicar, comece com uma resposta de uma ou duas frases, mantenha as seções de capacidades funcionais e instruções de uso e descarte arquitetura técnica e principais funções e componentes, a menos que sua equipe de suporte realmente precise de detalhes de implementação.
Como Manter um Sistema de Documentação Vivo com IA
Nos cinco casos de uso, o processo subjacente nunca muda. Análise de código, tradução da lógica e estruturação do documento. O que muda é apenas o público, o objetivo e a lógica específica que você define para cada execução. Vale a pena tratar isso de forma deliberada, em vez de reinventar a entrada toda vez.
Compensa manter um modelo curto e salvo de entrada por tipo de documentação: um para referências de API (público: desenvolvedores), um para notas de versão (público: clientes), um para guias de integração (público: novos usuários), um para SOPs internos (público: novos contratados) e um para artigos de base de conhecimento (público: equipe de suporte). Reutilizar a mesma formulação toda vez mantém o tom consistente em dezenas de documentos gerados, mesmo que cada um seja produzido de forma independente.
Para equipes que administram mais de um produto, separe cada produto em seu próprio workspace da FlowHunt, conecte as ferramentas relevantes e construa uma base de conhecimento com escopo específico para esse produto. Manter o contexto de cada produto separado produz resultados mais focados em cada execução e evita que a terminologia ou as convenções de um produto vazem para a documentação de outro. E, como a regeração é rápida, vincule-a a um gatilho real — uma versão, um pull request mesclado que toca um módulo documentado — em vez de a uma sprint de documentação agendada que compete com todo o resto do roadmap e geralmente perde.
Experimente o Redator de Documentação com IA com o teste gratuito de 7 dias (5 créditos incluídos) antes de se comprometer com um plano pago, e descubra qual destes cinco casos de uso economiza mais tempo para sua equipe primeiro.
