


Escribir documentación a mano significa leer tú mismo el código o el proceso, decidir qué importa y luego escribirlo en el tiempo libre que quede después de publicar.
La IA aplicada a la redacción técnica elimina el paso intermedio. En lugar de describir de memoria lo que hace un sistema, apuntas la IA a la fuente real y esta genera la explicación directamente a partir de la lógica. Lo único que te queda por hacer es comprobar que todo encaja.
Pero no todos los tipos de documentación se benefician por igual. Algunos son casi pura conversión de código en explicación, donde la IA tiene una ventaja de velocidad clara. Otros necesitan más encuadre humano alrededor del núcleo generado por IA. Estos son cinco tipos concretos de documentación en los que el Redactor de Documentación con IA de FlowHunt supera sistemáticamente a la escritura manual.
Para ver un recorrido por el proceso en sí, consulta cómo escribir documentación técnica automáticamente con IA .
Para entender por qué existe este problema en primer lugar, consulta por qué la documentación para desarrolladores siempre está incompleta .
Caso de uso 1: Documentación de referencia de API
Las referencias de API son lo más parecido a un escenario ideal para un generador de documentación de API con IA, porque la fuente de la verdad (los controladores de endpoints, los métodos del SDK, las formas de las solicitudes y las respuestas) ya existe en el código. No hay nada que preguntar a un desarrollador que no esté ya en las firmas de las funciones.
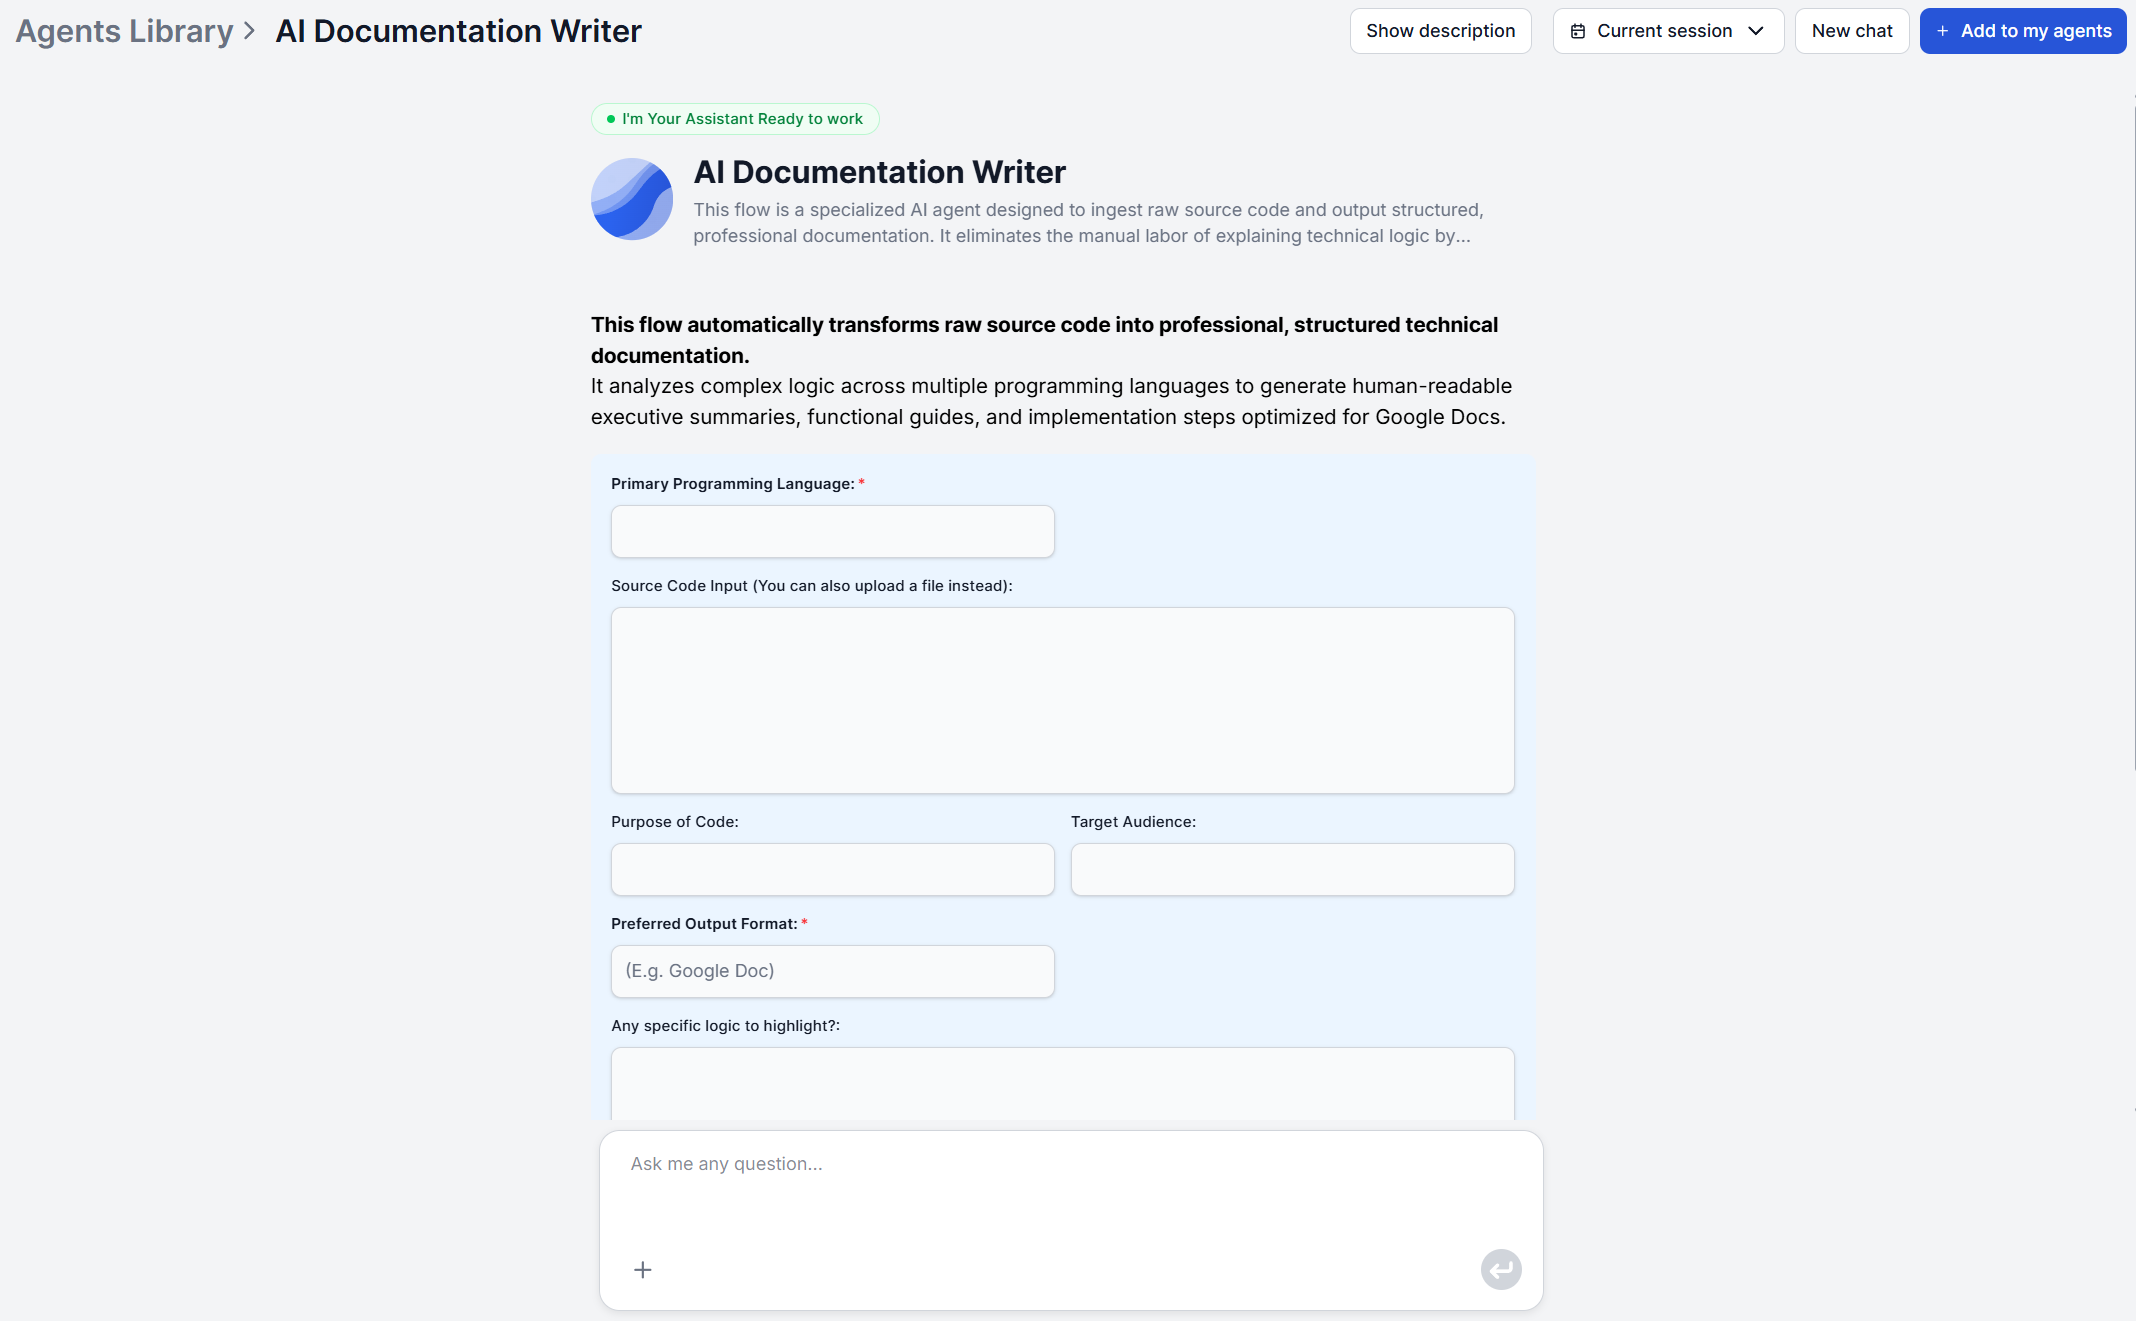
Apunta el Redactor de Documentación con IA a tu código de API o simplemente pégalo en el chat, establece la audiencia como “developers” o “API consumers” y usa la entrada “specific logic to highlight” para señalar cualquier cosa fácil de pasar por alto que merezca una revisión cuidadosa. La sección de funciones y componentes clave del resultado se convierte en una referencia útil, y la sección de arquitectura técnica cubre cómo encajan las piezas entre sí.
La ventaja de velocidad se acumula con el tiempo. Las superficies de API cambian con casi cada versión: se añade un parámetro, se deprecia un endpoint, y la documentación manual tiende a quedarse atrás justo en esas ediciones pequeñas y frecuentes.
Escribir a mano una referencia para veinte endpoints es una tarea de varios días incluso para un desarrollador que conoce bien la base de código. Regenerarla a partir del código actual lleva solo unos minutos, sin importar cuántas veces haya cambiado la API desde la última versión ni si son veinte endpoints o doscientos.
Caso de uso 2: Notas de versión de producto
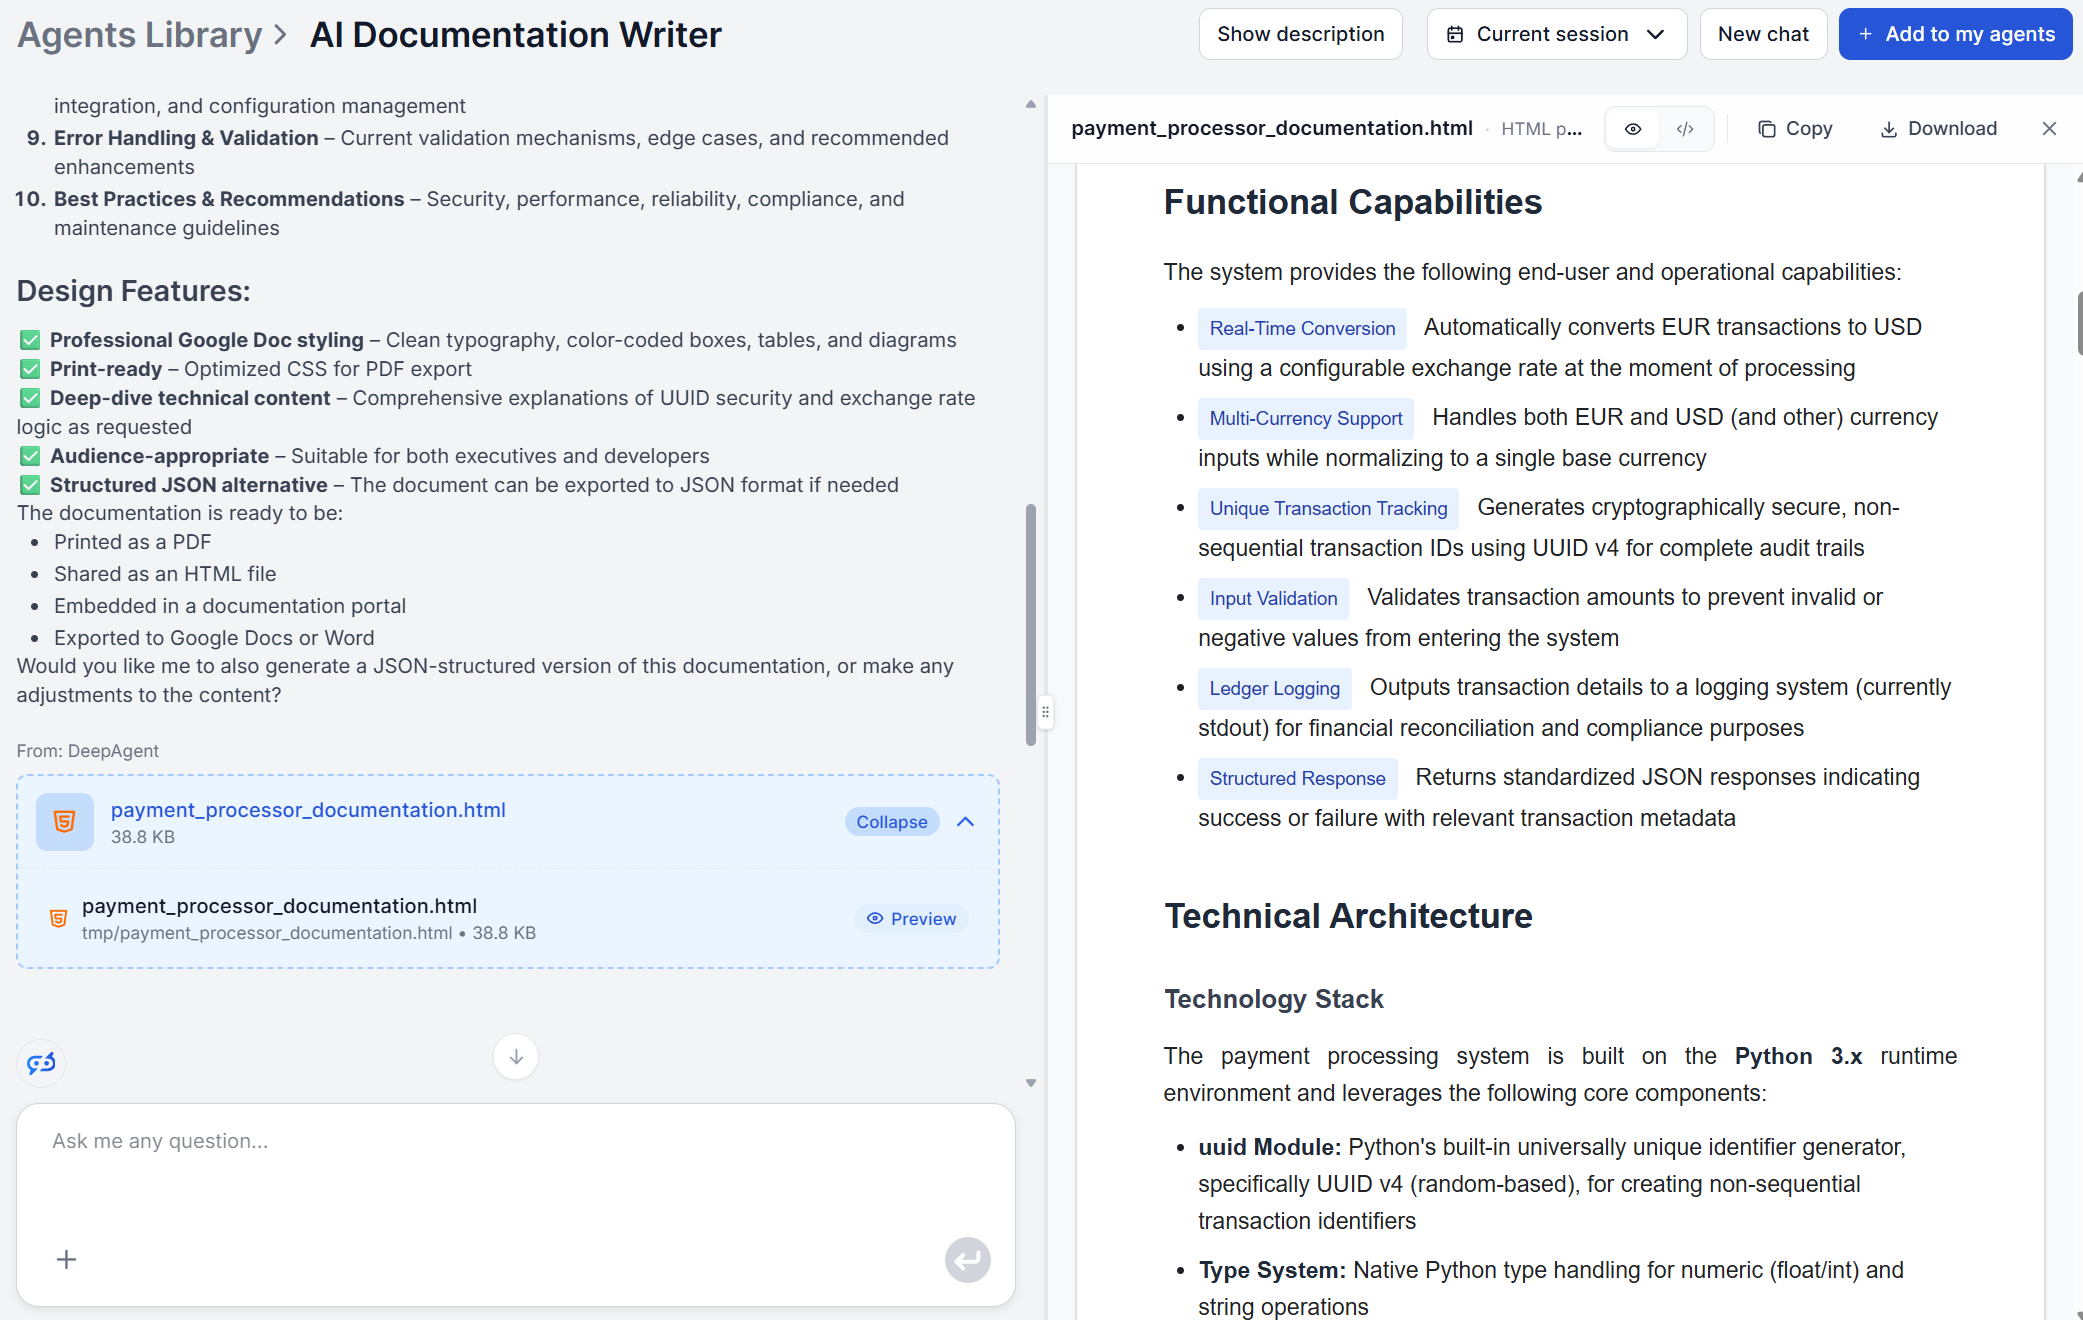
Las notas de versión deben responder qué ha cambiado y por qué importa. Eso se corresponde estrechamente con dos secciones que el redactor de documentación ya produce: el resumen ejecutivo y la lista de capacidades funcionales.
Establece el propósito como “release notes for this update”, la audiencia como “customers” o “end users”, y proporciona el código de la función o la corrección concreta. La fase de traducción a lenguaje sencillo se encarga de convertir un diff en una descripción que un cliente no técnico pueda entender de verdad, sin que un redactor tenga que entrevistar al ingeniero que lo construyó.
Aun así, merece la pena hacer después una ligera pasada de edición. Las notas de versión suelen necesitar una voz coherente y un orden concreto (primero los cambios disruptivos, luego las funciones nuevas y después las correcciones), y aunque la salida de la IA te da material preciso para cada elemento, organizarlos y priorizarlos para un changelog dirigido a clientes es una decisión de criterio que debería tomar una persona.

¿Listo para hacer crecer tu negocio?
Comienza tu prueba gratuita hoy y ve resultados en días.
Caso de uso 3: Guías de incorporación de usuarios
La IA para documentación de producto se gana su sitio en las guías de incorporación que en realidad no son más que descripciones de pasos de configuración reales, comandos disponibles o requisitos de instalación que ya viven en el código. Una herramienta de CLI, un SDK o una aplicación interna son todos buenos candidatos.
Pasa el mismo código fuente por el redactor de documentación, pero establece la audiencia objetivo como “new users” o “non-technical stakeholders”. La fase de traducción de la lógica sustituye la terminología de desarrollador por un lenguaje sencillo con una fluidez natural, y la sección de instrucciones de implementación y uso se convierte en los propios pasos de incorporación, cubriendo la instalación, la configuración y el primer uso.
El compromiso que conviene conocer de antemano es que este enfoque documenta lo que hace el producto y cómo configurarlo, no por qué existe una función desde una perspectiva de marketing de producto. Para contenido de incorporación más narrativo que instructivo, trata la salida de la IA como la columna vertebral técnica precisa y añade el encuadre alrededor en lugar de esperar una secuencia de bienvenida terminada y alineada con tu marca.
Esto importa sobre todo en las herramientas para desarrolladores, donde la primera hora de un usuario nuevo suele transcurrir en la instalación, la autenticación y la ejecución de un primer comando exitoso. Generar esa sección directamente a partir del código de configuración real, en lugar de a partir del recuerdo de un desarrollador sobre cómo se supone que funciona la instalación, detecta las pequeñas inconsistencias (un flag renombrado, una opción de configuración que se movió) que hacen que las guías de incorporación estén silenciosamente equivocadas en unas pocas versiones.
Caso de uso 4: Documentación interna de SOP y procesos
La automatización de documentación interna importa más aquí porque la documentación de procesos internos es la que se degrada más rápido. Normalmente existe como memoria institucional. Un ingeniero sénior explicando en voz alta un script de despliegue o una automatización de incorporación, sin que nadie lo escriba antes de que esa persona cambie de equipo o deje la empresa.
Si esa explicación tuvo lugar en una reunión grabada, pásala primero por el generador de informes de reunión con IA para capturar el contexto como acta estructurada antes de que se pierda. Después introduce el script real junto con el código de automatización en el redactor de documentación, con la audiencia configurada para nuevas incorporaciones de ingeniería, y producirás el documento de referencia que sobrevive a la marcha de la persona.
Esta combinación resuelve dos problemas distintos a la vez. El informe de reunión captura el contexto informal y el razonamiento que no está en el código (por qué el proceso funciona así), mientras que el redactor de documentación captura el detalle técnico preciso de lo que el código hace realmente.
Juntos, estos dos agentes producen el tipo de referencia de incorporación que una persona nueva puede seguir de verdad sin arrastrar a un ingeniero sénior a otra reunión para explicar el mismo script por segunda vez.
Únete a nuestro boletín
Obtén los últimos consejos, tendencias y ofertas gratis.
Caso de uso 5: Artículos de base de conocimiento
Los artículos de base de conocimiento dirigidos a clientes necesitan una explicación precisa de cómo se comporta realmente una función y una redacción que coincida con cómo los clientes ya hablan del problema. El redactor de documentación se encarga de la primera parte directamente: pásale el código que hay detrás de la función, establece la audiencia como “customers” o “support team”, y las secciones de capacidades funcionales e instrucciones de uso se convierten en la columna vertebral del artículo.
Ese último punto es la pieza que más probablemente se omite, y es la que determina si el artículo es realmente utilizable. Un artículo de KB lo lee alguien en mitad de un problema, no alguien que está investigando, y la salida de seis secciones del redactor de documentación está pensada para la exhaustividad, no para la brevedad. Pegarla entera en un artículo de soporte entierra la única frase que necesita un cliente frustrado bajo una explicación de arquitectura que nadie pidió.
Antes de publicar, empieza con una respuesta de una o dos frases, conserva las secciones de capacidades funcionales e instrucciones de uso, y elimina arquitectura técnica y funciones y componentes clave a menos que tu equipo de soporte necesite de verdad detalles de implementación.
Cómo mantener un sistema de documentación vivo con IA
En los cinco casos de uso, el proceso subyacente nunca cambia. Análisis del código, traducción de la lógica y estructuración del documento. Lo único que cambia es la audiencia, el propósito y la lógica específica que especificas en cada ejecución. Merece la pena tratarlo de forma deliberada en lugar de reinventar la entrada cada vez.
Conviene mantener una plantilla de entrada breve y guardada por cada tipo de documentación: una para referencias de API (audiencia: developers), una para notas de versión (audiencia: customers), una para guías de incorporación (audiencia: new users), una para SOP internos (audiencia: new hires) y una para artículos de base de conocimiento (audiencia: support team). Reutilizar la misma redacción cada vez mantiene el tono coherente en docenas de documentos generados, aunque cada uno se produzca de forma independiente.
Para los equipos que gestionan más de un producto, divide cada producto en su propio espacio de trabajo de FlowHunt, conecta las herramientas relevantes y crea una base de conocimiento acotada específicamente a ese producto. Mantener el contexto de cada producto separado produce resultados más centrados en cada ejecución y evita que la terminología o las convenciones de un producto se filtren en la documentación de otro. Y como la regeneración es rápida, vincúlala a un desencadenante real, una publicación, un pull request fusionado que toque un módulo documentado, en lugar de a un sprint de documentación programado que compite con todo lo demás en la hoja de ruta y normalmente pierde.
Prueba el Redactor de Documentación con IA con la prueba gratuita de 7 días (5 créditos incluidos) antes de comprometerte con un plan de pago, y descubre cuál de estos cinco casos de uso ahorra más tiempo a tu equipo para empezar.
