


ドキュメントを手作業で書くということは、コードやプロセスを自分で読み、何が重要かを判断し、リリース後のわずかな空き時間にそれを書き留めるということです。
テクニカルライティングにおけるAIのユースケースは、その中間のステップを取り除きます。システムの動作を記憶から説明する代わりに、AIを実際のソースに向ければ、ロジックから直接説明を生成します。あとはすべてが整合しているかを確認するだけです。
しかし、すべてのドキュメントタイプが等しく恩恵を受けるわけではありません。ほぼ純粋にコードから説明への変換であり、AIに明確なスピード上の優位があるものもあれば、AIが生成した中核の周りにより多くの人間による枠組みを必要とするものもあります。ここでは、FlowHuntのAIドキュメントライター が手作業のライティングを一貫して上回る、5つの具体的なドキュメントタイプを紹介します。
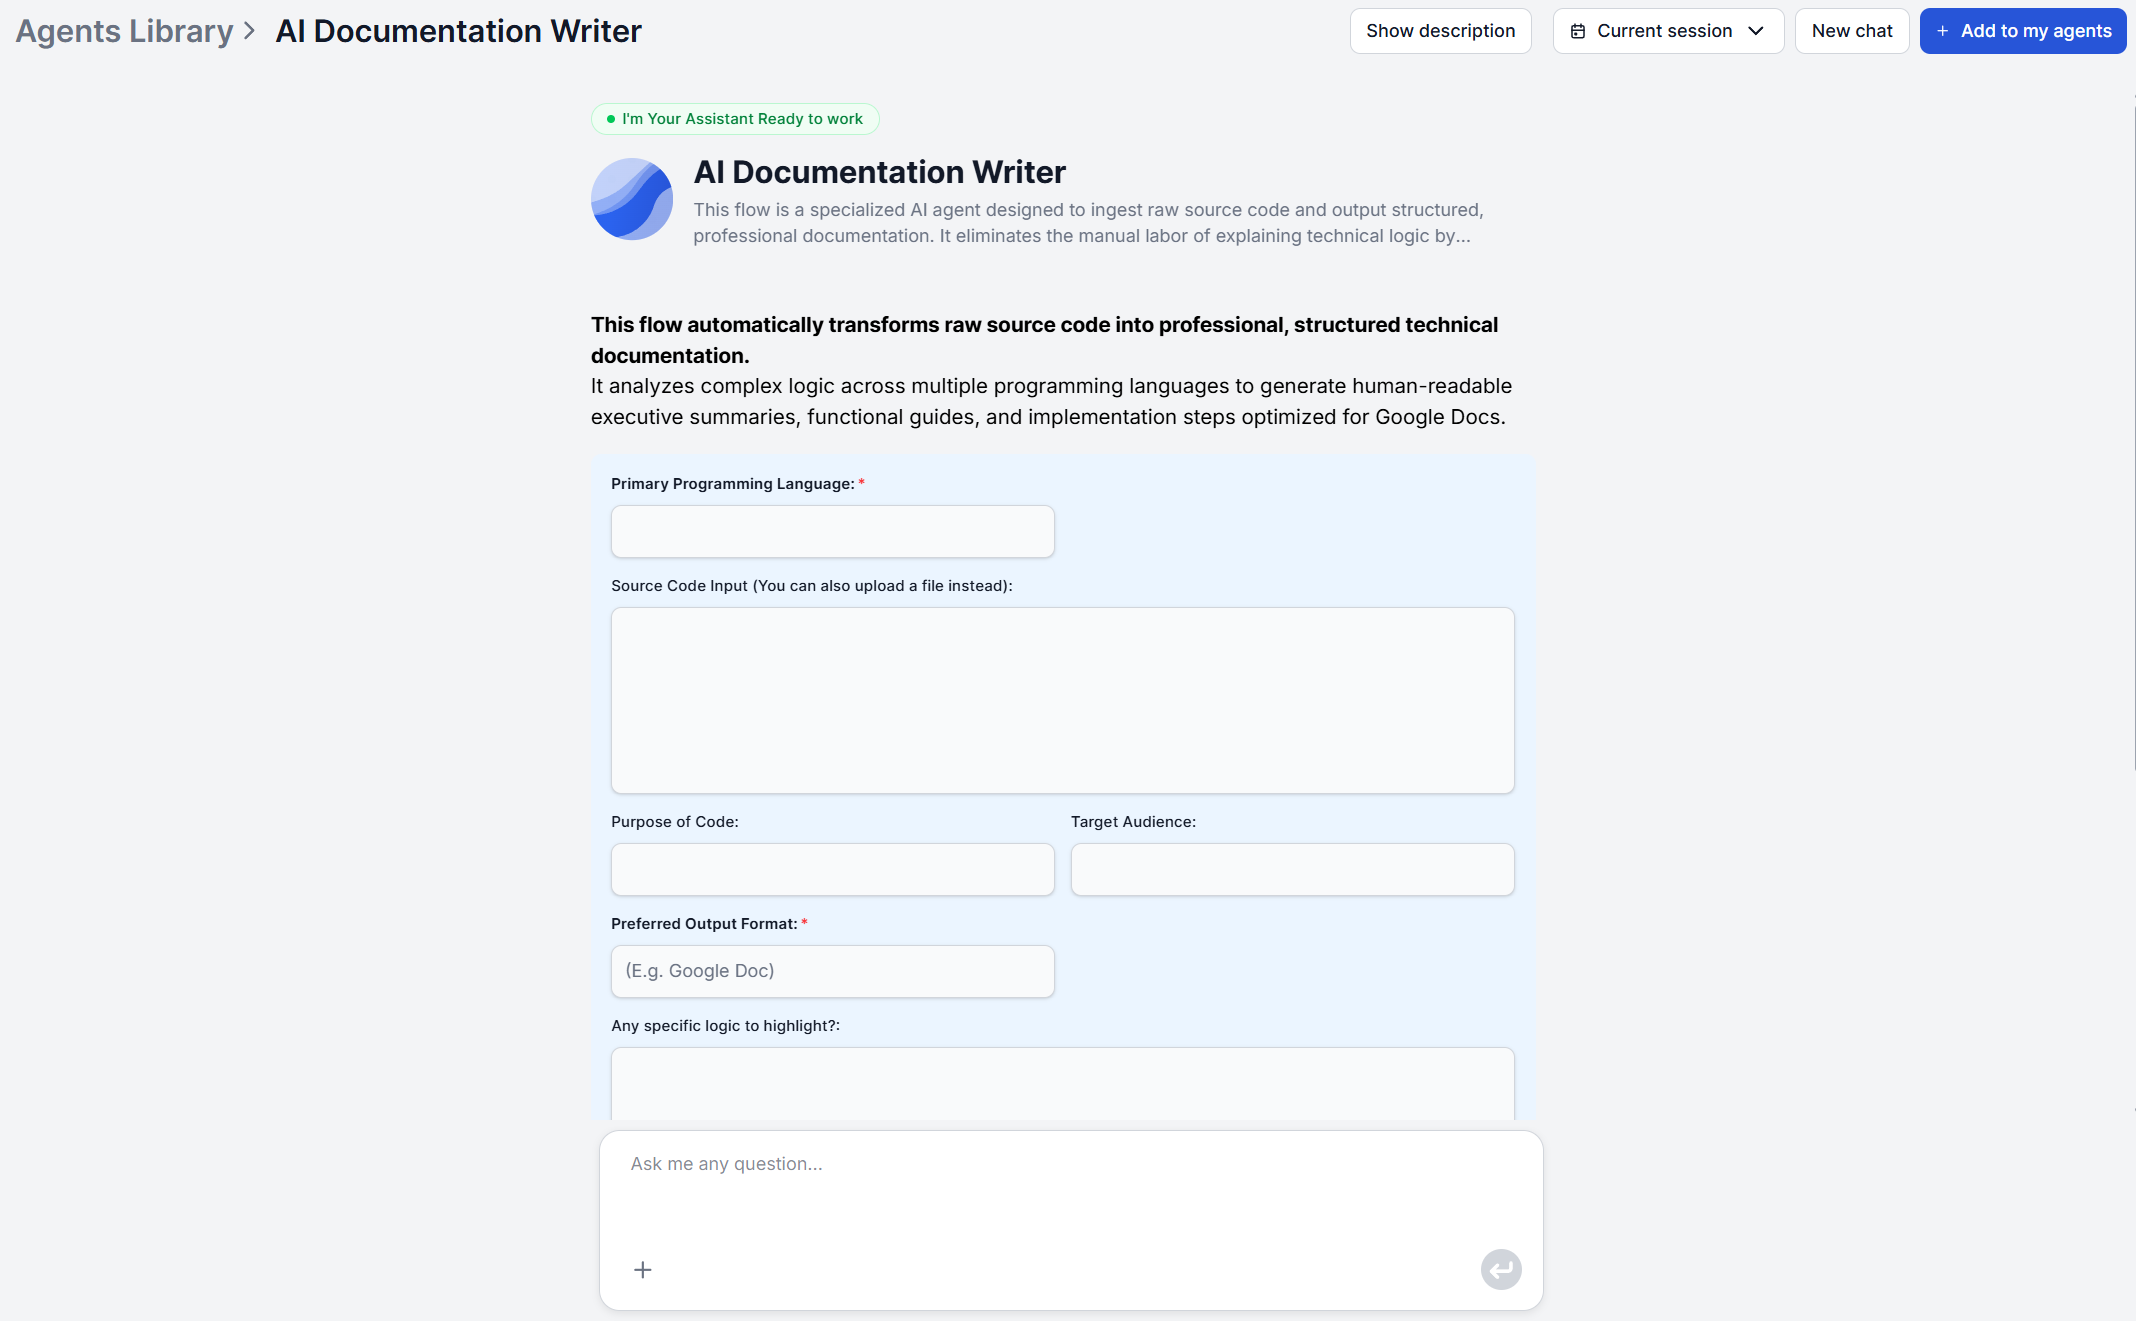
プロセス自体の解説については、AIでテクニカルドキュメントを自動的に書く方法 をご覧ください。
そもそもなぜこの問題が存在するのかについては、開発者ドキュメントが常に不完全である理由 をご覧ください。
ユースケース1:APIリファレンスドキュメント
APIリファレンスは、AI APIドキュメントジェネレーターにとって最も理想に近いシナリオです。なぜなら、信頼できる唯一の情報源(エンドポイントハンドラー、SDKメソッド、リクエストとレスポンスの形状)がすでにコードの中に存在するからです。関数シグネチャにすでに存在しないもので、開発者にインタビューすべきことは何もありません。
AIドキュメントライター をAPIコードに向けるか、単にチャットに貼り付け、読者層を「開発者」または「API利用者」に設定し、「強調すべき特定のロジック」入力を使って、見落としやすく十分な検討が必要なものを指定します。出力の主要な関数とコンポーネントのセクションが実用的なリファレンスとなり、技術アーキテクチャのセクションが各部分の関係を説明します。
スピード上の優位は時間とともに積み重なります。APIの表面はほぼすべてのリリースで変わり、パラメータが追加され、エンドポイントが非推奨になり、手作業のドキュメントはまさにこうした小さく頻繁な編集で遅れがちです。
20個のエンドポイントのリファレンスを手作業で書くのは、コードベースをよく知る開発者にとっても数日がかりの作業です。現在のコードから再生成するのは、前回のバージョン以降にAPIが何回変わっていても、エンドポイントが20個でも200個でも、ほんの数分で済みます。
ユースケース2:製品リリースノート
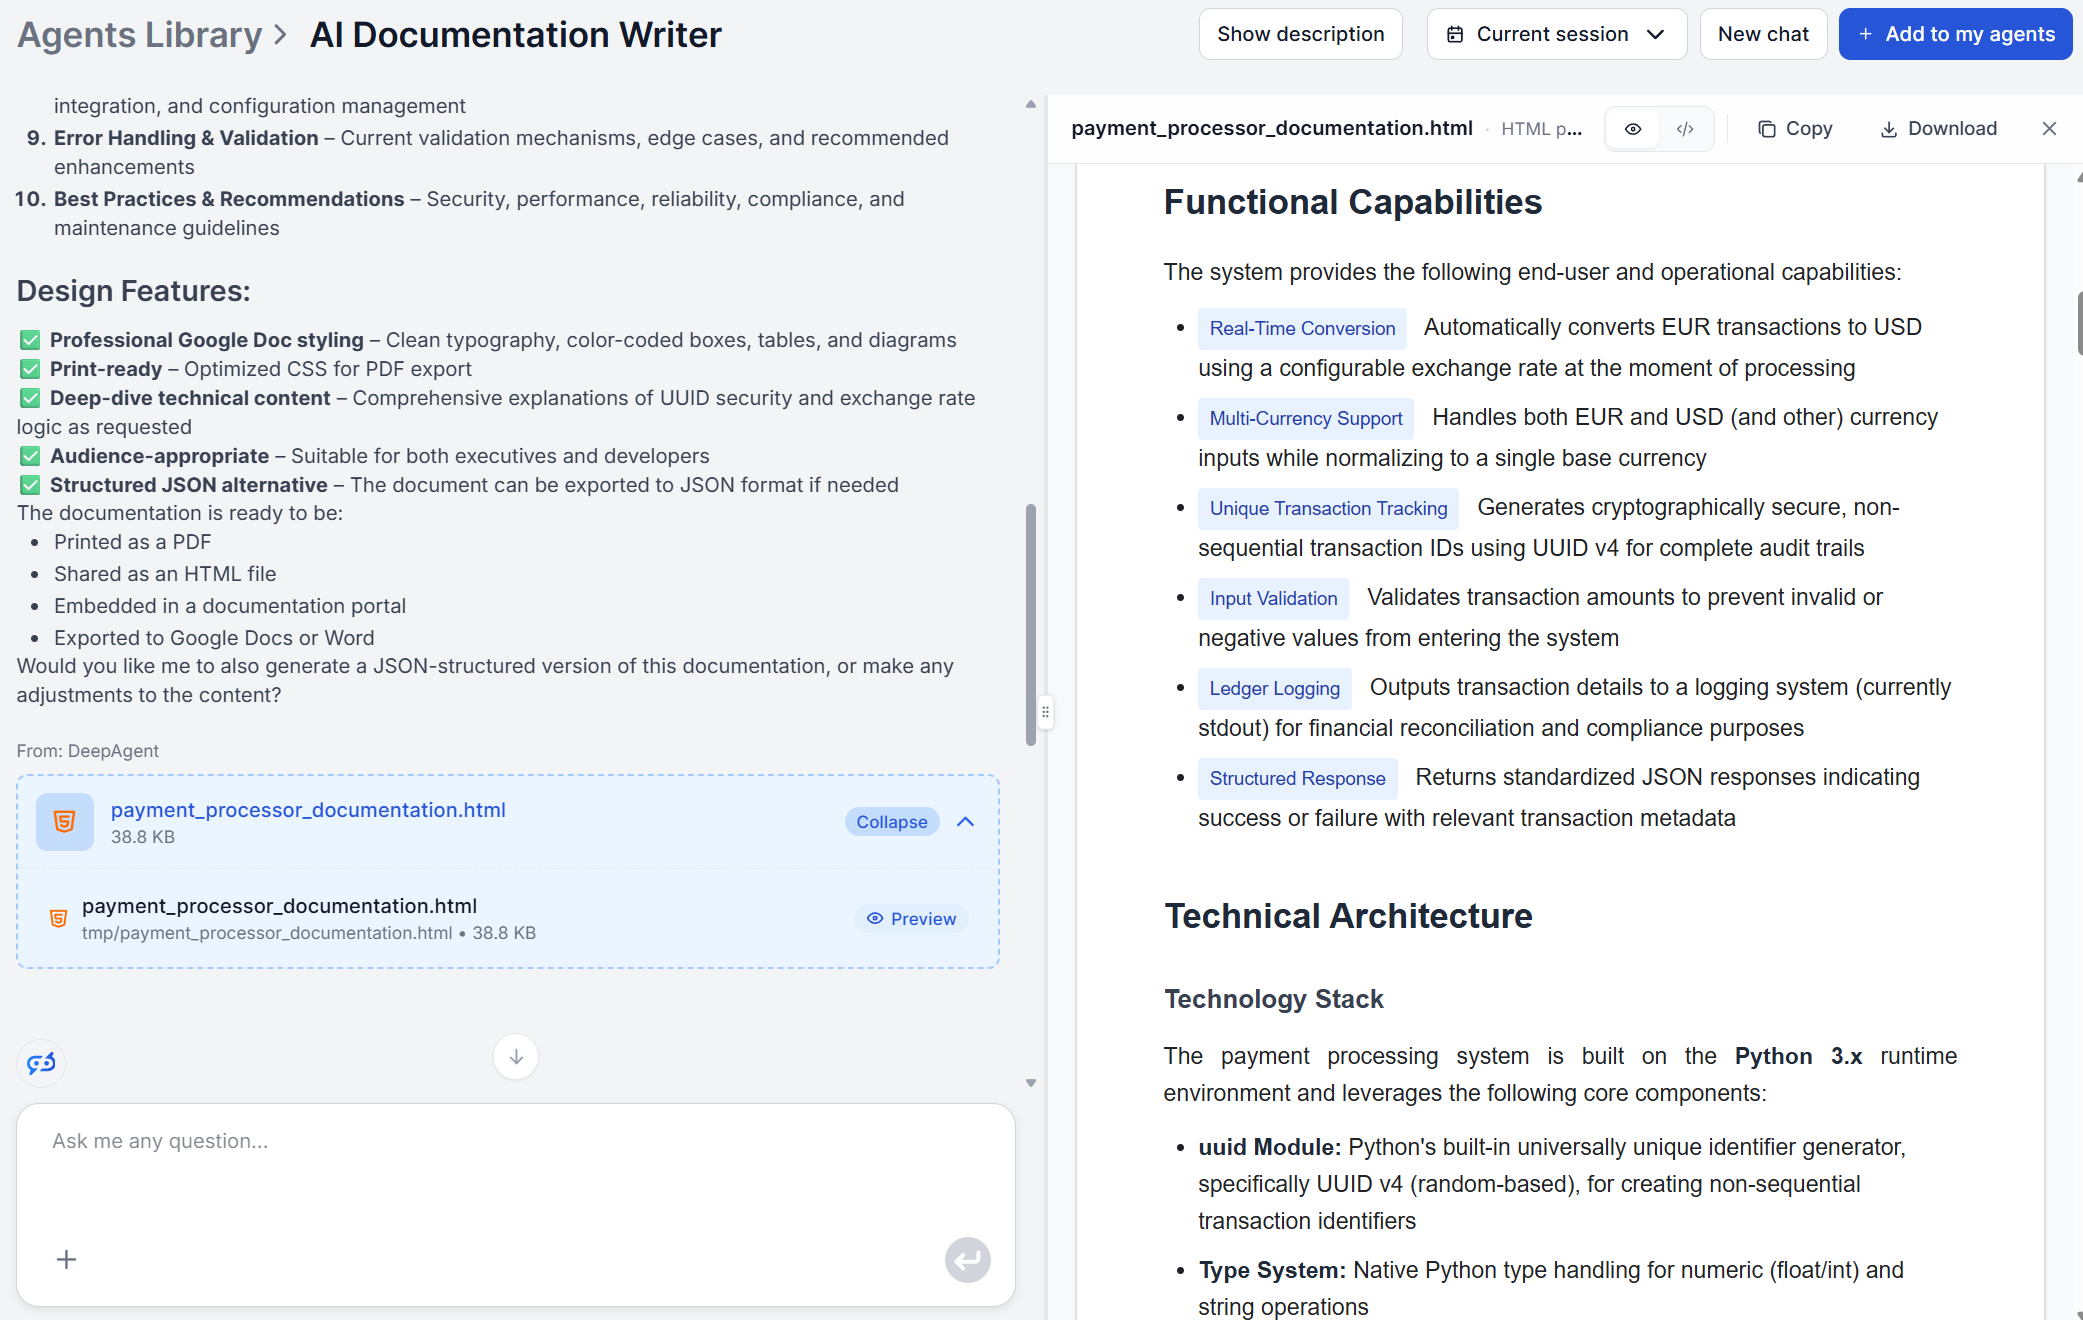
リリースノートは「何が変わったか」と「なぜそれが重要か」に答える必要があります。これはドキュメントライターがすでに生成する2つのセクション、つまりエグゼクティブサマリーと機能一覧にぴったり対応します。
目的を「このアップデートのリリースノート」、読者層を「顧客」または「エンドユーザー」に設定し、特定の機能や修正のコードを投入します。平易な言葉への翻訳ステージが、diffを非技術的な顧客が実際に理解できる説明に変える作業を行い、ライターがそれを開発したエンジニアにインタビューする必要はありません。
それでも後から軽い編集パスをかける価値はあります。リリースノートは通常、一貫した声と特定の順序(まず破壊的変更、次に新機能、そして修正)を必要とし、AIの出力は各項目について正確な素材を提供しますが、顧客向けの変更履歴としてそれらを並べ優先順位をつけるのは人が下すべき判断です。
ユースケース3:ユーザーオンボーディングガイド
製品ドキュメントAIがその価値を発揮するのは、実質的にはすでにコードの中にある実際の設定手順、利用可能なコマンド、セットアップ要件の説明にすぎないオンボーディングガイドです。CLIツール、SDK、社内アプリケーションはすべて良い候補です。
同じソースコードをドキュメントライターに通しますが、対象読者を「新規ユーザー」または「非技術系の関係者」に設定します。ロジック翻訳ステージが開発者用語を自然な流れの平易な言葉に置き換え、実装と使用方法のセクションがオンボーディング手順そのものとなり、セットアップ、設定、初回利用をカバーします。
事前に知っておくべきトレードオフは、このアプローチが製品の機能と設定方法を文書化するものであり、製品マーケティングの観点から機能が存在する理由を文書化するものではないという点です。説明的というより物語的なオンボーディングコンテンツについては、AIの出力を正確な技術的骨格として扱い、その周りに枠組みを追加するべきであり、完成したブランドらしい歓迎シーケンスを期待すべきではありません。
これは開発者ツールで最も重要です。新規ユーザーの最初の1時間は通常、インストール、認証、最初のコマンドを正常に実行することに費やされます。そのセクションを、インストールがどう動作するはずかという開発者の記憶からではなく、実際のセットアップコードから直接生成することで、数回のリリースのうちにオンボーディングガイドを静かに誤らせる小さな不整合(名前が変わったフラグ、移動した設定オプション)を捉えられます。
ユースケース4:社内SOPとプロセスドキュメント
社内ドキュメントの自動化が最も重要になるのはここです。社内プロセスドキュメントは最も早く劣化するからです。それは通常、組織の記憶として存在します。シニアエンジニアがデプロイスクリプトやオンボーディング自動化について口頭で説明し、その人がチームを移るか会社を去る前に誰も書き留めない、という形です。
その説明が録画された会議で行われたなら、まずAI議事録レポートジェネレーター に通して、失われる前にコンテキストを構造化された議事録として記録します。その後、実際のスクリプトと自動化コードをドキュメントライターに投入し、読者層を新入りのエンジニアに設定して、その人が去っても残るリファレンス文書を生成します。
この組み合わせは2つの異なる問題を同時に解決します。議事録レポートはコードにはない非公式なコンテキストと理由(なぜこのプロセスがこう動くのか)を捉え、ドキュメントライターはコードが実際に何をするかの正確な技術的詳細を捉えます。
この2つのエージェントを合わせることで、新入社員が同じスクリプトの説明のためにもう一度シニアエンジニアを会議に引き込むことなく、実際に従えるオンボーディングリファレンスが生まれます。

ニュースレターに登録
最新のヒント、トレンド、お得な情報を無料で入手。
ユースケース5:ナレッジベース記事
顧客向けのナレッジベース記事には、機能が実際にどう動作するかの正確な説明と、顧客がすでにその問題について話す言葉づかいが一致した表現が必要です。ドキュメントライターは最初の部分を直接扱います。機能の背後にあるコードを投入し、読者層を「顧客」または「サポートチーム」に設定すると、機能一覧と使用方法のセクションが記事の骨格になります。
この最後の点は最も省略されがちな部分であり、記事が実際に使えるかどうかを決める部分でもあります。KB記事は調査中の人ではなく、問題の渦中にいる人が読むもので、ドキュメントライターの6セクションの出力は簡潔さではなく完全性のために作られています。そのすべてをサポート記事に貼り付けると、イライラした顧客が必要としている一文が、誰も求めていないアーキテクチャの説明の下に埋もれてしまいます。
公開前に、1~2文の回答を先頭に置き、機能一覧と使用方法のセクションを残し、サポートチームが実装の詳細を本当に必要としていない限り、技術アーキテクチャと主要な関数とコンポーネントは削除しましょう。
AIで生きたドキュメントシステムを維持する方法
5つのユースケースすべてに共通して、根底にあるプロセスは決して変わりません。コード分析、ロジック翻訳、ドキュメントの構造化です。変わるのは、各実行で指定する読者層、目的、特定のロジックだけです。これは毎回入力を再発明するのではなく、意識的に扱う価値があります。
ドキュメントタイプごとに短い保存済みの入力テンプレートを用意しておくと役立ちます。APIリファレンス用(読者層:開発者)、リリースノート用(読者層:顧客)、オンボーディングガイド用(読者層:新規ユーザー)、社内SOP用(読者層:新入社員)、ナレッジベース記事用(読者層:サポートチーム)の5つです。毎回同じ文言を再利用することで、それぞれが独立して生成されても、何十もの生成ドキュメント間でトーンが一貫します。
複数の製品を運営するチームは、各製品をそれぞれ独自のFlowHuntワークスペースに分割し、関連するツールを接続し、その製品に特化したナレッジベースを構築しましょう。各製品のコンテキストを分けておくことで、毎回の実行でより焦点の絞られた出力が得られ、ある製品の用語や慣習が別の製品のドキュメントに漏れ出すのを防げます。また、再生成は高速なので、ロードマップ上の他のすべてと競合してたいてい負けてしまう定期的なドキュメントスプリントではなく、実際のトリガー(リリース、文書化されたモジュールに触れるマージ済みプルリクエスト)に結び付けましょう。
有料プランにコミットする前に、7日間の無料トライアル(5クレジット付き)で**AIドキュメントライターを試して **、この5つのユースケースのうちどれがあなたのチームの時間を最も節約できるかを確かめてください。
