


Documentatie handmatig schrijven betekent dat je zelf de code of het proces leest, bepaalt wat belangrijk is en het vervolgens opschrijft in de vrije tijd die overblijft na het opleveren.
AI-use cases voor technisch schrijven halen de tussenstap eruit. In plaats van uit je geheugen te beschrijven wat een systeem doet, wijs je de AI naar de werkelijke bron en genereert die de uitleg rechtstreeks vanuit de logica. Het enige wat jij nog hoeft te doen, is controleren of alles klopt.
Maar niet elk soort documentatie profiteert evenveel. Sommige zijn bijna pure code-naar-uitleg, waar AI een duidelijk snelheidsvoordeel heeft. Andere hebben meer menselijke inkadering nodig rond de door AI gegenereerde kern. Dit zijn vijf specifieke soorten documentatie waarin de AI Documentation Writer van FlowHunt consequent beter presteert dan handmatig schrijven.
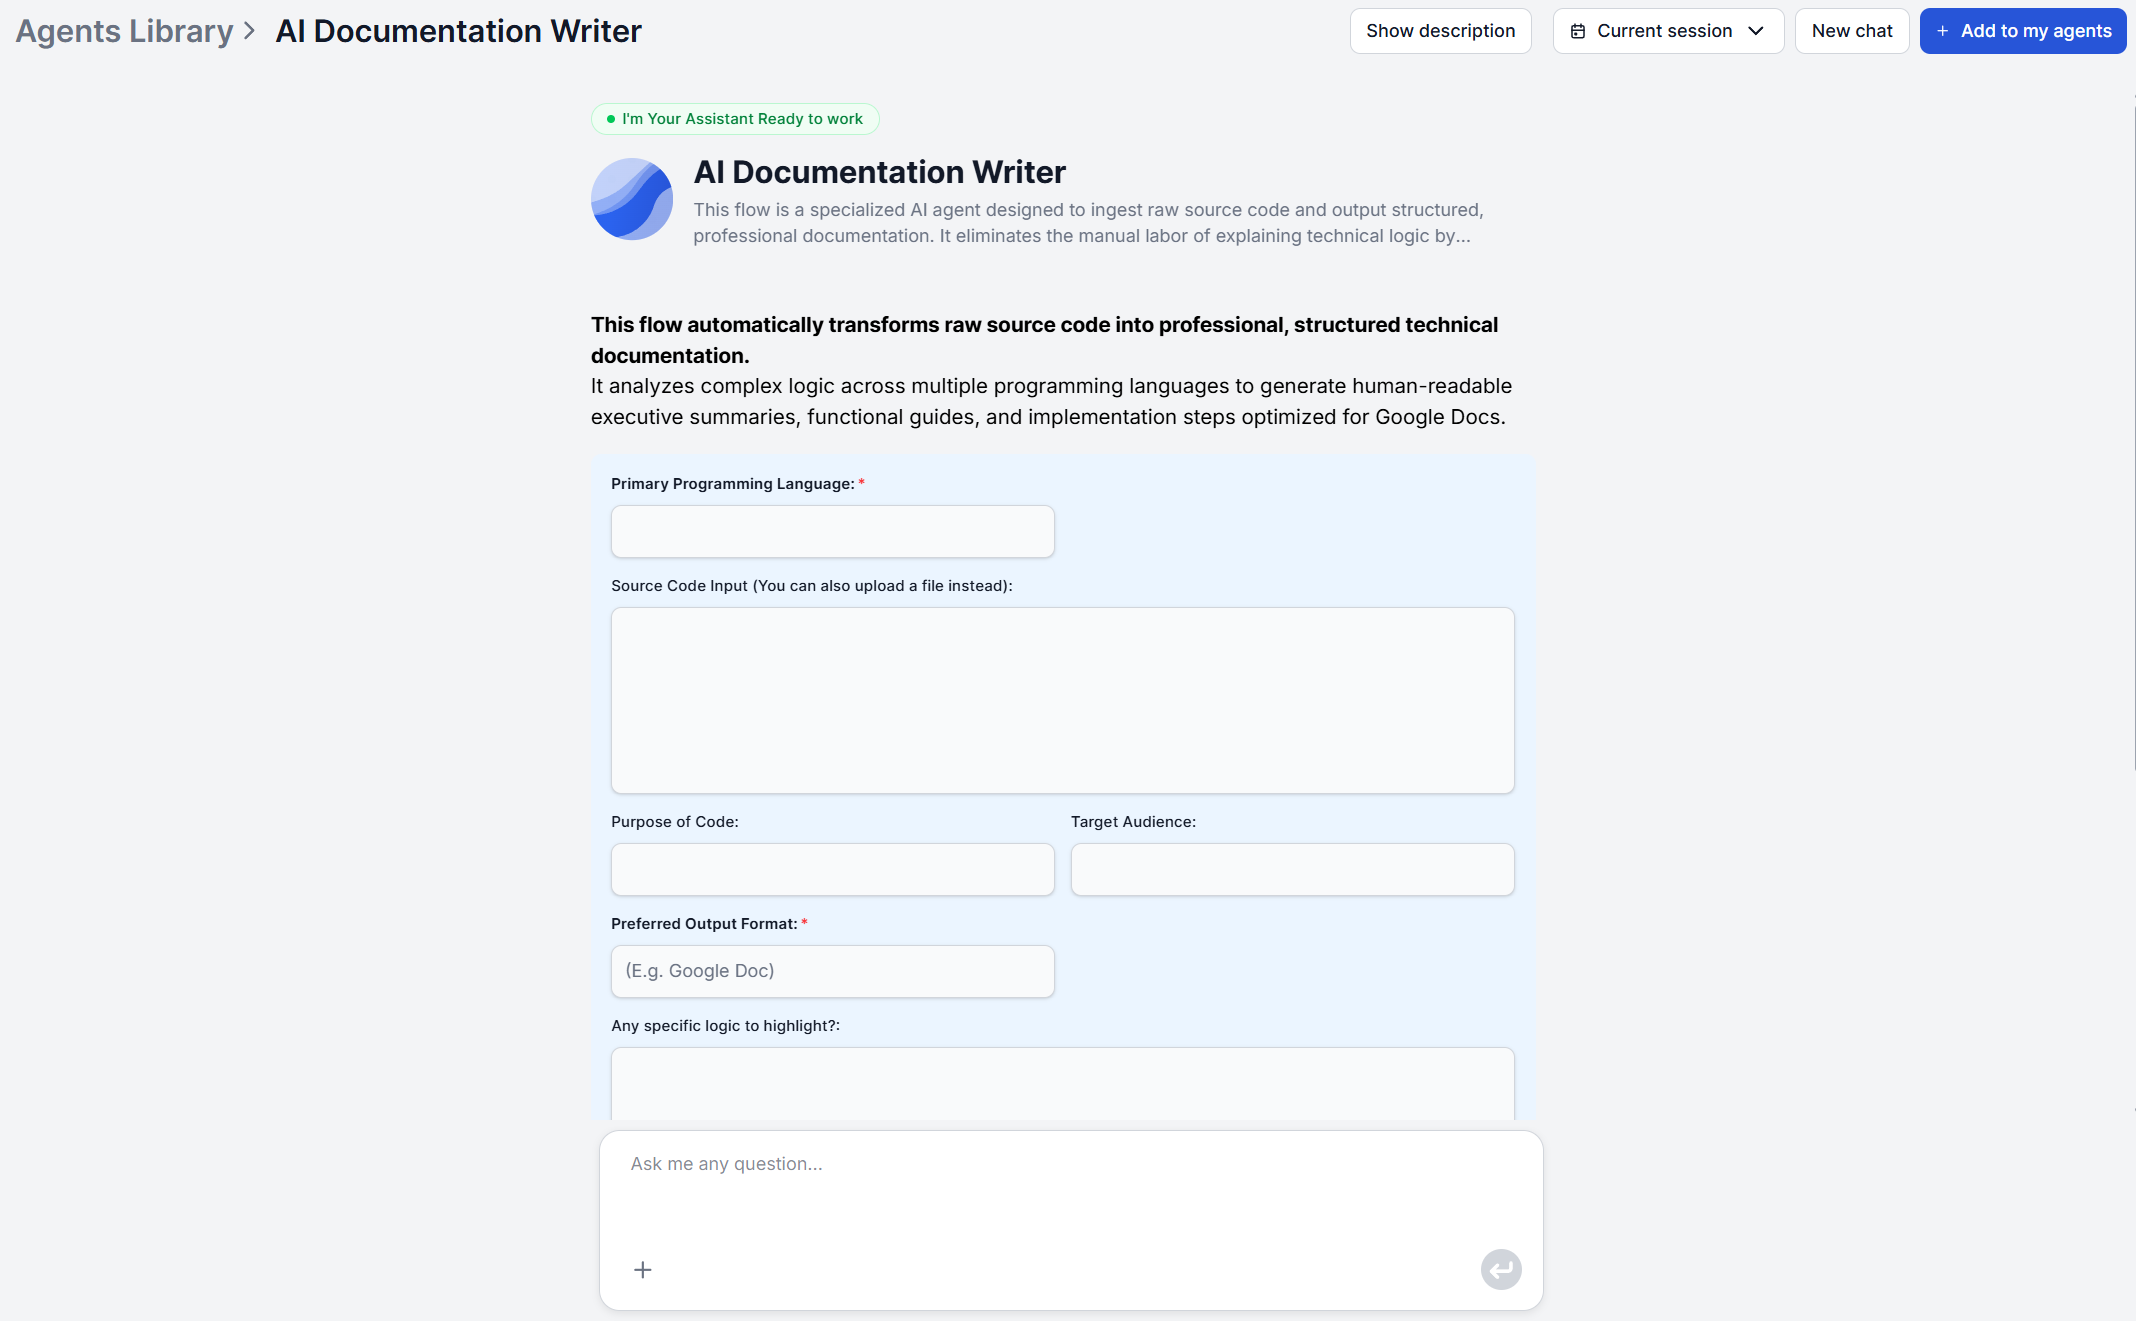
Voor een walkthrough van het proces zelf, zie hoe je technische documentatie automatisch met AI schrijft .
Voor waarom dit probleem überhaupt bestaat, zie waarom developerdocumentatie altijd onvolledig is .
Use case 1: API-referentiedocumentatie
API-referenties komen het dichtst bij een best-case scenario voor een AI API-docs generator, omdat de bron van waarheid (de endpoint-handlers, de SDK-methoden, de request- en responsevormen) al in de code bestaat. Er is niets om een developer over te interviewen wat niet al in de functiesignaturen staat.
Wijs de AI Documentation Writer naar je API-code of plak die simpelweg in de chat, zet het publiek op “developers” of “API-consumenten”, en gebruik het invoerveld “specifieke logica om te benadrukken” om alles te markeren wat makkelijk te missen is en de nodige zorg verdient. De sectie met belangrijkste functies en componenten in de output wordt een werkende referentie, en de sectie technische architectuur behandelt hoe de onderdelen in elkaar passen.
Het snelheidsvoordeel wordt groter naarmate de tijd vordert. API-oppervlakken veranderen bij bijna elke release, er wordt een parameter toegevoegd, een endpoint wordt afgeschaft, en handmatige documentatie loopt precies bij deze kleine, frequente aanpassingen achter.
Een referentie voor twintig endpoints met de hand schrijven is een taak van meerdere dagen, zelfs voor een developer die de codebase goed kent. Opnieuw genereren vanuit de huidige code kost slechts een paar minuten, ongeacht hoe vaak de API sinds de laatste versie is veranderd, en ongeacht of het twintig of tweehonderd endpoints zijn.
Use case 2: Release notes voor producten
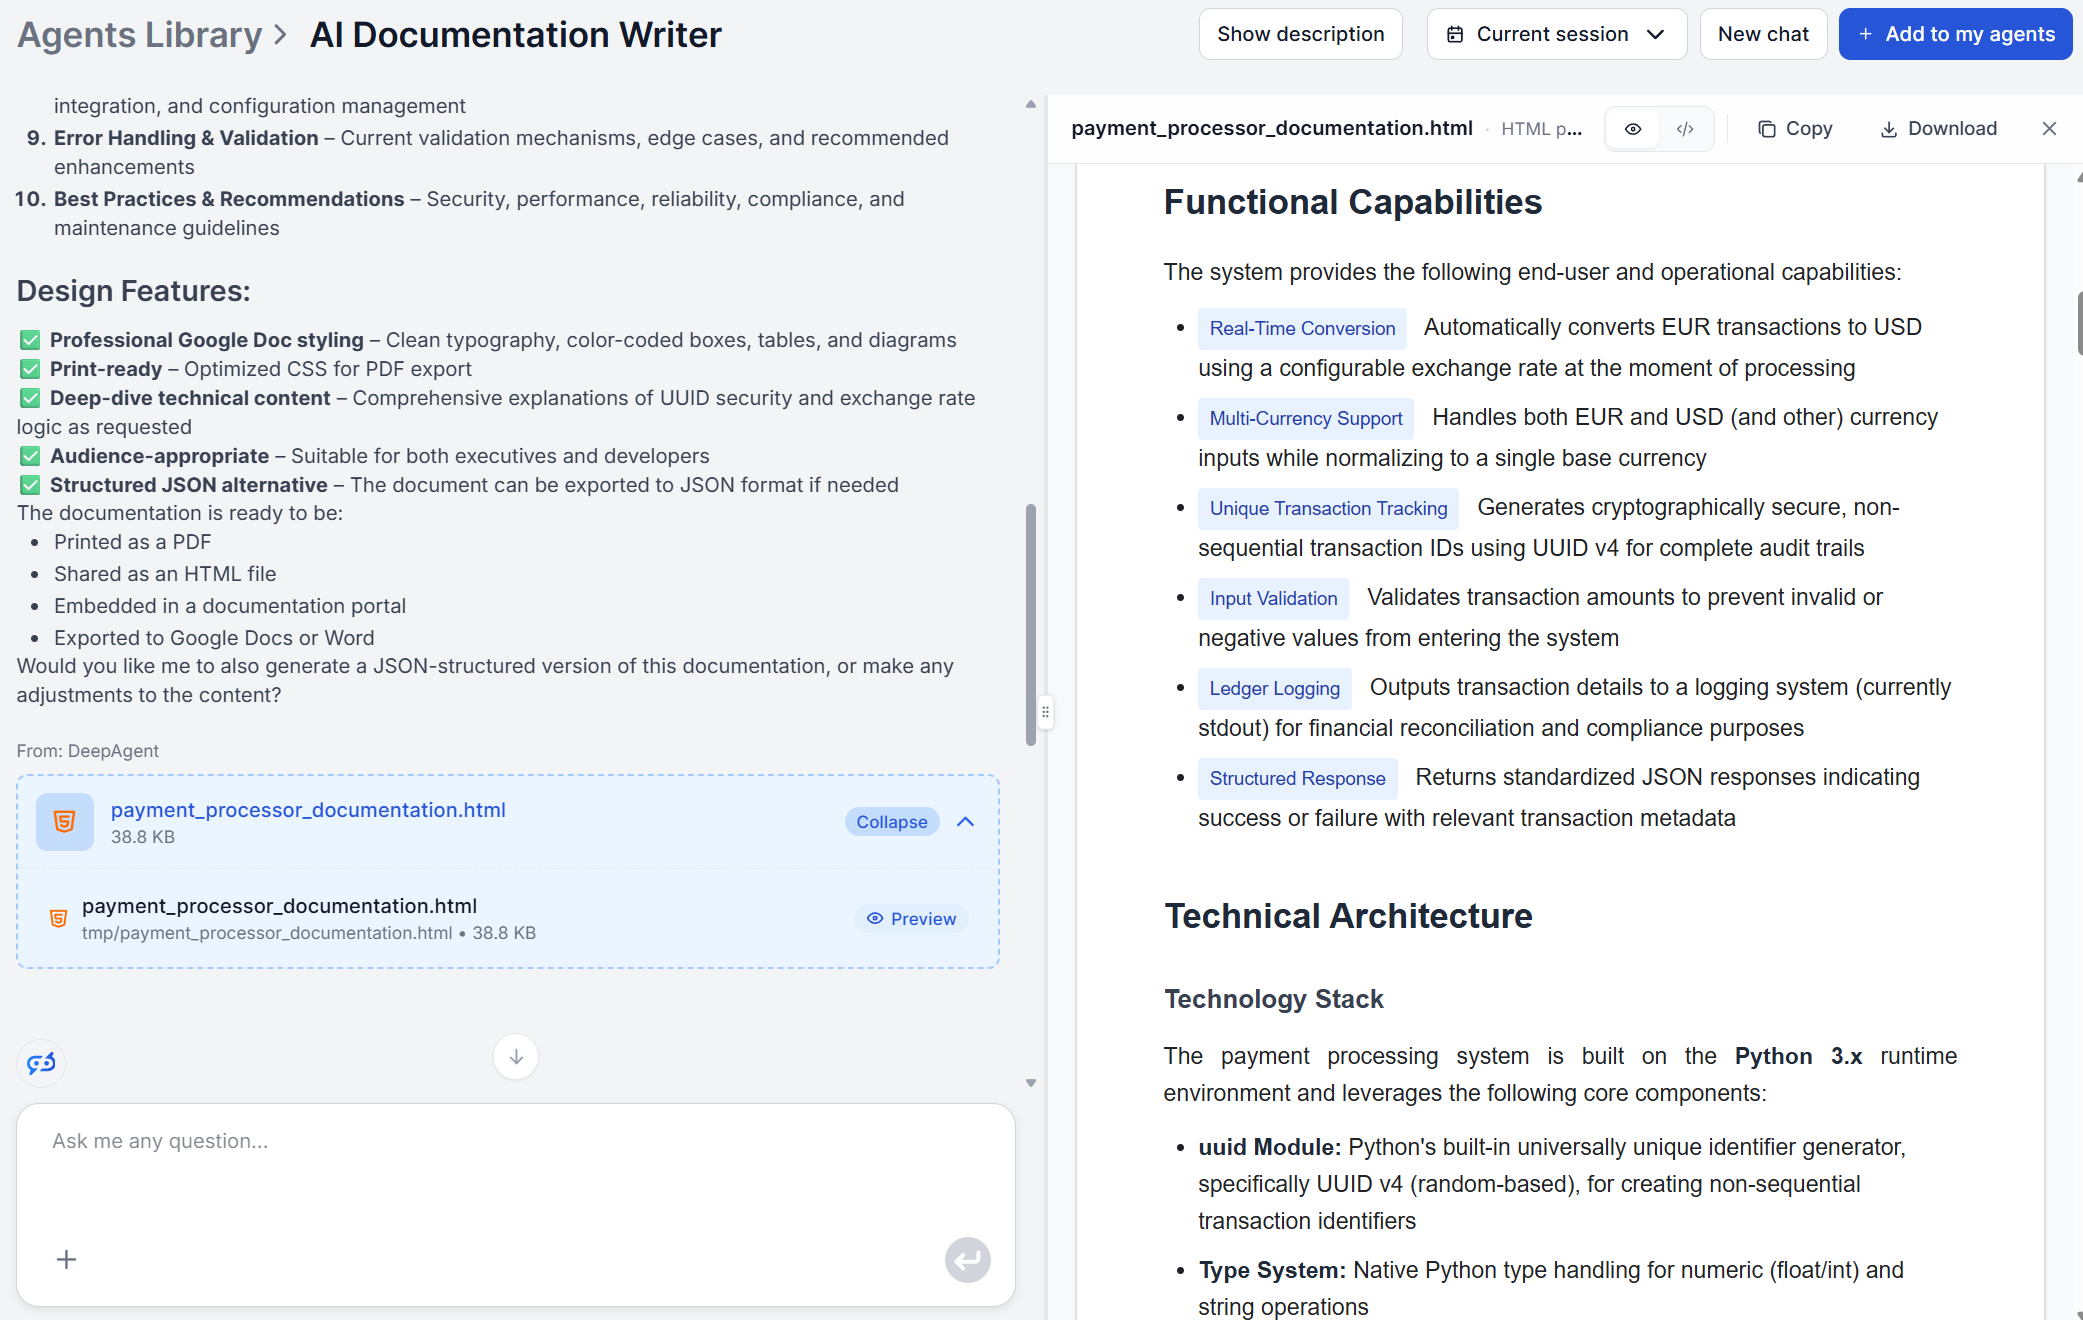
Release notes moeten antwoord geven op wat er is veranderd en waarom dat ertoe doet. Dat sluit nauw aan bij twee secties die de documentation writer al produceert: de managementsamenvatting en de lijst met functionele mogelijkheden.
Zet het doel op “release notes voor deze update”, het publiek op “klanten” of “eindgebruikers”, en voer de code in voor de specifieke feature of fix. De fase van vertaling naar gewone taal doet het werk om een diff om te zetten in een beschrijving die een niet-technische klant daadwerkelijk begrijpt, zonder dat een schrijver de engineer die het heeft gebouwd hoeft te interviewen.
Een lichte redactieronde achteraf is nog steeds de moeite waard. Release notes hebben meestal een consistente stem en een specifieke volgorde nodig (eerst breaking changes, dan nieuwe features, dan fixes). De AI-output levert weliswaar nauwkeurig ruwmateriaal voor elk item, maar het rangschikken en prioriteren ervan voor een klantgerichte changelog is een beoordelingskwestie die een mens moet maken.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
Use case 3: Onboardinggidsen voor gebruikers
Productdocumentatie AI verdient zijn geld met onboardinggidsen die in feite niet meer zijn dan beschrijvingen van echte configuratiestappen, beschikbare commando’s of installatievereisten die al in de code staan. Een CLI-tool, een SDK of een interne applicatie zijn allemaal goede kandidaten.
Laat dezelfde broncode door de documentation writer gaan, maar zet het doelpubliek op “nieuwe gebruikers” of “niet-technische stakeholders”. De fase van logicavertaling vervangt developerterminologie door gewone taal met een natuurlijke flow, en de sectie implementatie- en gebruiksinstructies wordt de onboardingstappen zelf, met installatie, configuratie en eerste gebruik.
De afweging die je vooraf moet kennen, is dat deze aanpak documenteert wat het product doet en hoe je het configureert, niet waarom een feature bestaat vanuit productmarketingperspectief. Behandel de AI-output voor onboardingcontent die meer verhalend dan instructief is als de nauwkeurige technische ruggengraat en voeg er inkadering omheen toe, in plaats van een kant-en-klare, merkconforme welkomstreeks te verwachten.
Dit is het belangrijkst voor developertools, waar het eerste uur van een nieuwe gebruiker meestal opgaat aan installatie, authenticatie en het uitvoeren van een eerste geslaagd commando. Die sectie rechtstreeks genereren uit de werkelijke installatiecode, in plaats van uit het geheugen van een developer over hoe de installatie zou moeten werken, vangt de kleine inconsistenties op (een hernoemde flag, een configuratieoptie die is verplaatst) waardoor onboardinggidsen binnen een paar releases stilletjes onjuist worden.
Use case 4: Interne SOP- en procesdocumentatie
Automatisering van interne documentatie is hier het belangrijkst, omdat interne procesdocumentatie het snelst vervalt. Meestal bestaat die als institutioneel geheugen: een senior engineer die een deploymentscript of een onboardingautomatisering hardop uitlegt, zonder dat iemand het opschrijft voordat die persoon van team wisselt of het bedrijf verlaat.
Als die uitleg plaatsvond in een opgenomen vergadering, laat die dan eerst door de AI meeting report generator gaan om de context vast te leggen als gestructureerd verslag voordat die verloren gaat. Voer daarna het werkelijke script samen met de automatiseringscode in de documentation writer, met het publiek ingesteld op nieuwe engineeringmedewerkers, om het referentiedocument te produceren dat het vertrek van die persoon overleeft.
Deze combinatie lost twee verschillende problemen tegelijk op. Het vergaderverslag legt de informele context en redenering vast die niet in de code staat (waarom het proces zo werkt), terwijl de documentation writer de nauwkeurige technische details vastlegt van wat de code feitelijk doet.
Samen produceren deze twee agents het soort onboardingreferentie dat een nieuwe medewerker daadwerkelijk kan volgen zonder een senior engineer in nog een vergadering te trekken om hetzelfde script een tweede keer uit te leggen.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
Use case 5: Kennisbankartikelen
Klantgerichte kennisbankartikelen hebben een nauwkeurige uitleg nodig van hoe een feature zich feitelijk gedraagt, plus formuleringen die aansluiten bij hoe klanten het probleem al beschrijven. De documentation writer verzorgt het eerste deel rechtstreeks: voer de code achter de feature in, zet het publiek op “klanten” of “supportteam”, en de secties functionele mogelijkheden en gebruiksinstructies worden de ruggengraat van het artikel.
Dat laatste punt is het onderdeel dat het vaakst wordt overgeslagen, en het bepaalt of het artikel daadwerkelijk bruikbaar is. Een KB-artikel wordt gelezen door iemand midden in een probleem, niet door iemand die onderzoek doet, en de output van de documentation writer met zes secties is gebouwd op volledigheid, niet op beknoptheid. Als je alles in een supportartikel plakt, verdwijnt de ene zin die een gefrustreerde klant nodig heeft onder een architectuuruitleg waar niemand om heeft gevraagd.
Begin voor publicatie met een antwoord van een of twee zinnen, houd de secties functionele mogelijkheden en gebruiksinstructies, en laat technische architectuur en belangrijkste functies en componenten weg, tenzij je supportteam echt implementatiedetails nodig heeft.
Hoe je met AI een levend documentatiesysteem onderhoudt
In alle vijf de use cases verandert het onderliggende proces nooit: code-analyse, logicavertaling en documentstructurering. Wat verandert, is alleen het publiek, het doel en de specifieke logica die je per run opgeeft. Dat is het waard om bewust te behandelen in plaats van elke keer de invoer opnieuw te bedenken.
Het loont om per soort documentatie een korte, opgeslagen invoertemplate te bewaren: één voor API-referenties (publiek: developers), één voor release notes (publiek: klanten), één voor onboardinggidsen (publiek: nieuwe gebruikers), één voor interne SOP’s (publiek: nieuwe medewerkers) en één voor kennisbankartikelen (publiek: supportteam). Dezelfde formulering elke keer hergebruiken houdt de toon consistent in tientallen gegenereerde documenten, ook al wordt elk document onafhankelijk geproduceerd.
Voor teams met meer dan één product: splits elk product in een eigen FlowHunt-workspace, verbind de relevante tools en bouw een kennisbank die specifiek op dat product is gericht. De context van elk product apart houden levert bij elke run gerichtere output op en voorkomt dat terminologie of conventies van het ene product in de documentatie van het andere lekken. En omdat regenereren snel gaat, koppel het aan een echte trigger — een release, een samengevoegde pull request die een gedocumenteerde module raakt — in plaats van aan een geplande documentatiesprint die concurreert met alles op de roadmap en meestal verliest.
Probeer de AI Documentation Writer met de gratis proefperiode van 7 dagen (5 credits inbegrepen) voordat je je aan een betaald plan vastlegt, en ontdek welke van deze vijf use cases jouw team het meeste tijd bespaart.
