


Psát dokumentaci ručně znamená číst kód nebo proces sám, rozhodovat, co je důležité, a pak to sepsat v jakémkoli volném čase, který zbude po dodání.
Případy použití AI pro technické psaní odstraňují ten prostřední krok. Místo abyste ze své paměti popisovali, co systém dělá, namíříte AI na skutečný zdroj a ona vygeneruje vysvětlení přímo z logiky. Zbývá vám jen zkontrolovat, jestli všechno sedí.
Ne každý typ dokumentace ale těží stejně. Některé jsou téměř čistým převodem kódu na vysvětlení, kde má AI jasnou rychlostní výhodu. Jiné potřebují více lidského rámování kolem AI generovaného jádra. Zde je pět konkrétních typů dokumentace, u kterých AI Documentation Writer od FlowHunt trvale překonává ruční psaní.
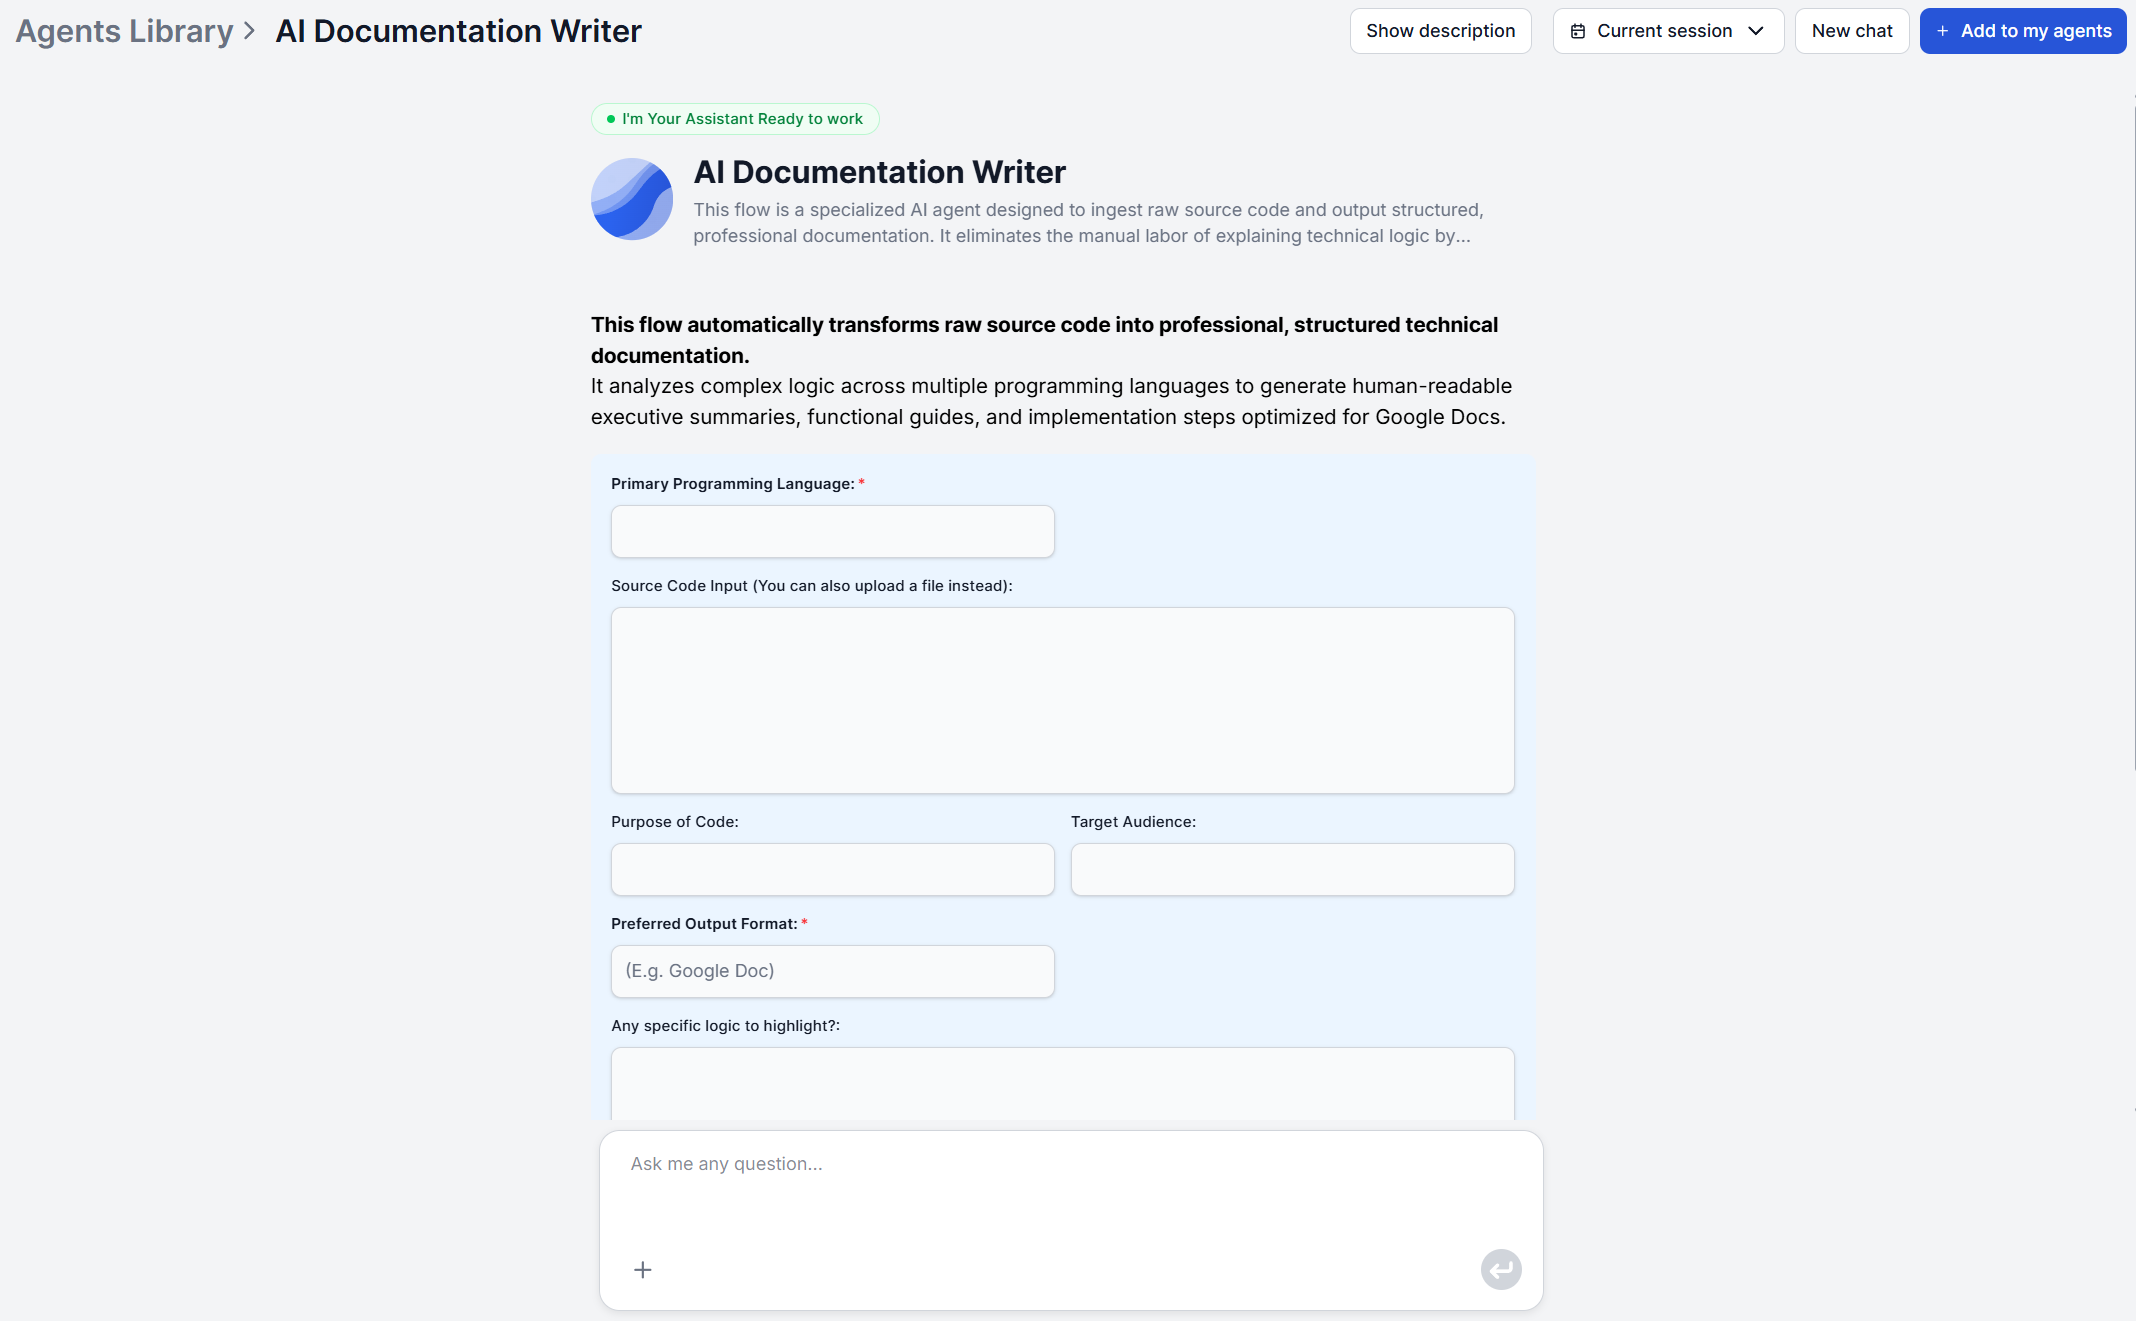
Pro průchod samotným procesem viz jak automaticky psát technickou dokumentaci s AI .
Proč tento problém vůbec existuje, se dozvíte v článku proč je dokumentace pro vývojáře vždy neúplná .
Případ použití 1: Referenční dokumentace API
API reference jsou nejblíže ideálnímu scénáři pro AI generátor API dokumentace, protože zdroj pravdy (obslužné rutiny endpointů, metody SDK, tvary požadavků a odpovědí) už v kódu existuje. Není o čem zpovídat vývojáře, co už nesedí v signaturách funkcí.
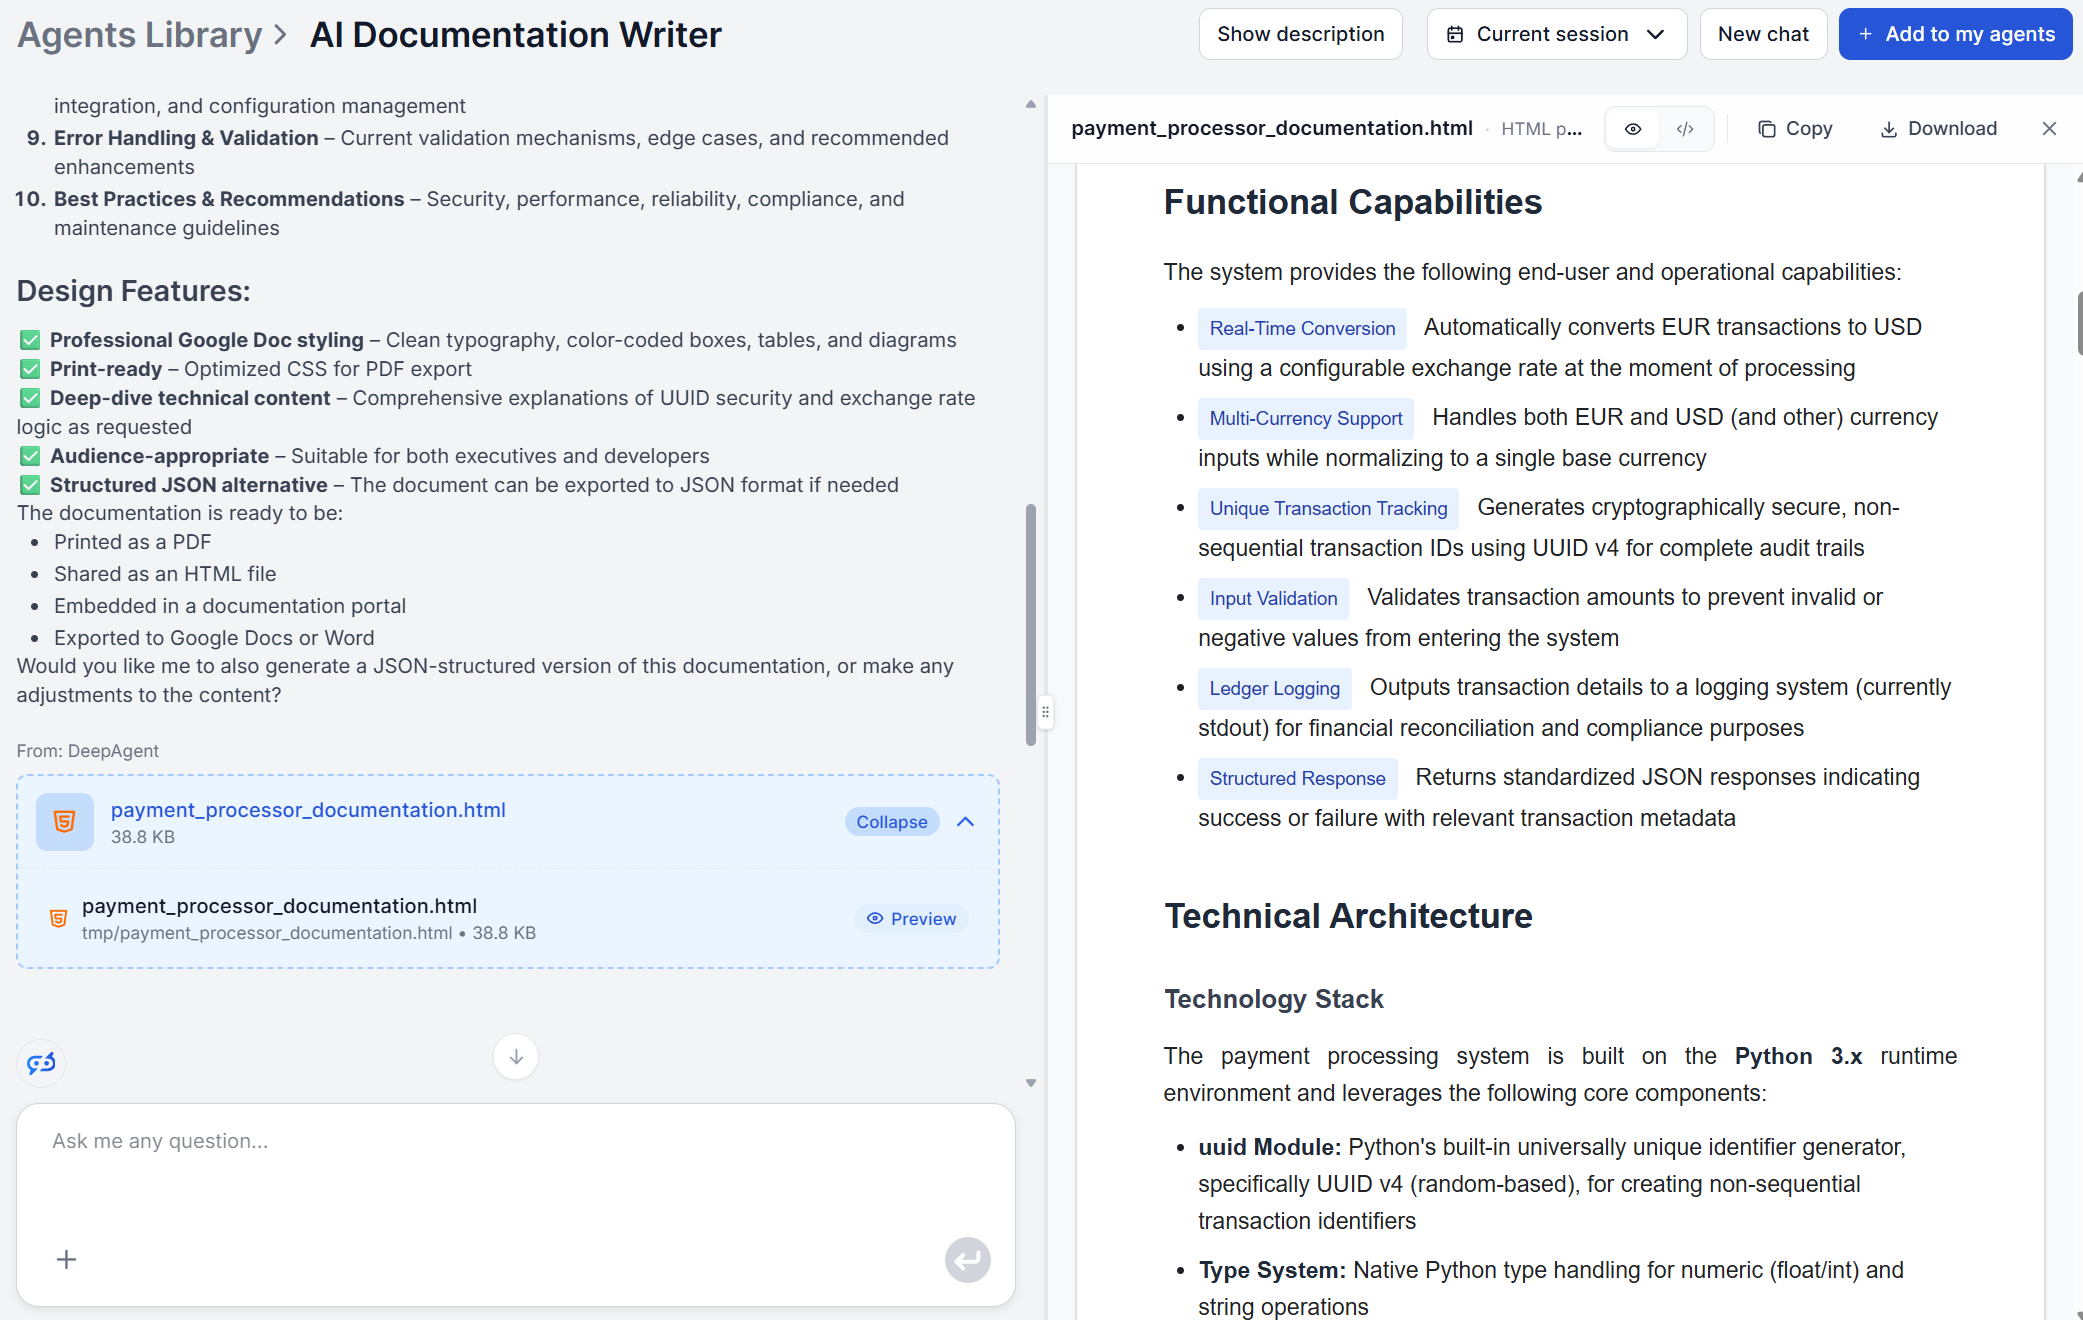
Namířte AI Documentation Writer na svůj API kód nebo ho jednoduše vložte do chatu, nastavte publikum na „vývojáře“ nebo „konzumenty API“ a pomocí vstupu „specific logic to highlight“ označte cokoli snadno přehlédnutelného, co by mělo dostat náležitou pozornost. Sekce klíčových funkcí a komponent se ve výstupu stane funkční referencí a sekce technické architektury pokrývá, jak do sebe jednotlivé díly zapadají.
Rychlostní výhoda se v čase násobí. API povrchy se mění téměř s každým vydáním, přidá se parametr, zruší se endpoint, a ruční dokumentace má tendenci zaostávat právě u těchto malých a častých úprav.
Napsat referenci pro dvacet endpointů ručně je několika denní úkol i pro vývojáře, který codebase dobře zná. Opětovné vygenerování z aktuálního kódu zabere jen několik minut bez ohledu na to, kolikrát se API od poslední verze změnilo, a bez ohledu na to, jestli jde o dvacet nebo dvě stě endpointů.
Případ použití 2: Poznámky k vydání produktu
Poznámky k vydání musí odpovědět na to, co se změnilo a proč na tom záleží. To se úzce kryje se dvěma sekcemi, které documentation writer už produkuje, a to s manažerským shrnutím a se seznamem funkčních schopností.
Nastavte účel na „poznámky k vydání pro tuto aktualizaci“, publikum na „zákazníci“ nebo „koncoví uživatelé“ a vložte kód pro konkrétní funkci nebo opravu. Fáze překladu do srozumitelného jazyka odvede práci spočívající v přeměně diffu na popis, kterému netechnický zákazník skutečně porozumí, aniž by musel redaktor zpovídat inženýra, který to postavil.
Následná lehká redakční úprava se přesto vyplatí. Poznámky k vydání obvykle potřebují konzistentní hlas a konkrétní pořadí (nejprve zásadní změny, pak nové funkce, poté opravy), a přestože výstup AI vám pro každou položku dá přesný surový materiál, uspořádat a upřednostnit je pro changelog určený zákazníkům je úsudek, který by měl udělat člověk.

Připraveni rozšířit své podnikání?
Začněte svou bezplatnou zkušební verzi ještě dnes a viďte výsledky během několika dní.
Případ použití 3: Uživatelské onboardingové příručky
AI pro produktovou dokumentaci si své místo zaslouží u onboardingových příruček, které jsou ve skutečnosti jen popisem skutečných konfiguračních kroků, dostupných příkazů nebo požadavků na nastavení, jež už žijí v kódu. Nástroj pro příkazový řádek (CLI), SDK nebo interní aplikace jsou všichni dobrými kandidáty.
Prožeňte stejný zdrojový kód documentation writerem, ale nastavte cílové publikum na „noví uživatelé“ nebo „netechničtí stakeholdeři“. Fáze překladu logiky vymění vývojářskou terminologii za srozumitelný jazyk s přirozeným plynutím a sekce pokynů k implementaci a použití se stane samotnými onboardingovými kroky pokrývajícími nastavení, konfiguraci a první použití.
Kompromis, který je dobré znát předem, spočívá v tom, že tento přístup dokumentuje, co produkt dělá a jak ho konfigurovat, nikoli proč nějaká funkce existuje z pohledu produktového marketingu. U onboardingového obsahu, který je více vyprávěním než instruktáží, berte výstup AI jako přesnou technickou páteř a přidejte kolem něj rámování, místo abyste očekávali hotovou, značkovou uvítací sekvenci.
To je nejdůležitější u vývojářských nástrojů, kde nový uživatel obvykle stráví první hodinu instalací, autentizací a spuštěním prvního úspěšného příkazu. Vygenerovat tuto sekci přímo ze skutečného instalačního kódu, a ne z paměti vývojáře o tom, jak má instalace fungovat, odhalí drobné nesrovnalosti (přejmenovaný přepínač, konfigurační volba, která se přesunula), kvůli nimž jsou onboardingové příručky během několika vydání tiše nesprávné.
Případ použití 4: Interní SOP a dokumentace procesů
Automatizace interní dokumentace je nejdůležitější právě tady, protože dokumentace interních procesů chátrá nejrychleji. Obvykle existuje jako institucionální paměť. Seniorní inženýr vysvětluje nasazovací skript nebo onboardingovou automatizaci nahlas, a než ten člověk přejde do jiného týmu nebo odejde ze společnosti, nikdo to nezapíše.
Pokud se toto vysvětlení odehrálo na nahrávané schůzce, prožeňte ji nejprve AI generátorem reportů ze schůzek , abyste zachytili kontext jako strukturovaný zápis, než se ztratí. Poté vložte samotný skript spolu s automatizačním kódem do documentation writeru s publikem nastaveným na nové inženýrské posily, abyste vytvořili referenční dokument, který přežije odchod dané osoby.
Tato kombinace řeší dva různé problémy najednou. Report ze schůzky zachycuje neformální kontext a zdůvodnění, které v kódu nejsou (proč proces funguje tímto způsobem), zatímco documentation writer zachycuje přesný technický detail toho, co kód skutečně dělá.
Dohromady tyto dva agenty vytvářejí typ onboardingové reference, kterou nový zaměstnanec skutečně dokáže následovat, aniž by musel seniorního inženýra tahat na další schůzku, aby ten samý skript vysvětlil podruhé.
Přihlaste se k odběru newsletteru
Získejte nejnovější tipy, trendy a nabídky zdarma.
Případ použití 5: Články ve znalostní bázi
Články ve znalostní bázi určené zákazníkům potřebují přesné vysvětlení toho, jak se funkce skutečně chová, a formulace, které odpovídají tomu, jak už o problému mluví sami zákazníci. Documentation writer řeší první část přímo: vložte do něj kód stojící za funkcí, nastavte publikum na „zákazníci“ nebo „tým podpory“ a sekce funkčních schopností a pokynů k použití se stanou páteří článku.
Poslední bod je část, která se nejspíš vynechává, a přitom právě ona určuje, zda je článek skutečně použitelný. Článek ve znalostní bázi čte někdo uprostřed problému, ne někdo, kdo si dělá průzkum, a šestisekční výstup documentation writeru je stavěný na úplnost, ne na stručnost. Vložit celý do článku podpory znamená zahrabat tu jednu větu, kterou frustrovaný zákazník potřebuje, pod vysvětlení architektury, o které nikdo nežádal.
Před publikováním začněte jedno- nebo dvouvětou odpovědí, ponechte sekce funkčních schopností a pokynů k použití a vypusťte technickou architekturu a klíčové funkce a komponenty, pokud váš tým podpory implementační detail skutečně nepotřebuje.
Jak udržovat živý systém dokumentace s AI
Ve všech pěti případech použití se základní proces nikdy nemění. Analýza kódu, překlad logiky a strukturování dokumentu. Mění se jen publikum, účel a konkrétní logika, které pro každé spuštění zadáte. To se vyplatí řešit záměrně, místo abyste vstup pokaždé znovu vynalézali.
Vyplatí se udržovat krátkou uloženou šablonu vstupu pro každý typ dokumentace: jednu pro API reference (publikum: vývojáři), jednu pro poznámky k vydání (publikum: zákazníci), jednu pro onboardingové příručky (publikum: noví uživatelé), jednu pro interní SOP (publikum: noví zaměstnanci) a jednu pro články ve znalostní bázi (publikum: tým podpory). Opětovné používání stejných formulací pokaždé udržuje konzistentní tón napříč desítkami vygenerovaných dokumentů, i když je každý vytvořen samostatně.
Pro týmy, které provozují více než jeden produkt, rozdělte každý produkt do vlastního pracovního prostoru FlowHunt, propojte relevantní nástroje a vytvořte znalostní bázi zaměřenou konkrétně na daný produkt. Udržování kontextu každého produktu odděleně vede při každém spuštění k cílenějšímu výstupu a zabraňuje tomu, aby terminologie nebo konvence jednoho produktu prosakovaly do dokumentace jiného. A protože regenerace je rychlá, navážte ji na skutečný spouštěč – vydání, sloučený pull request, který se dotýká dokumentovaného modulu – a ne na plánovaný dokumentační sprint, který soutěží se vším ostatním v roadmapě a obvykle prohrává.
Vyzkoušejte AI Documentation Writer se 7denní zkušební verzí zdarma (včetně 5 kreditů), než se zavážete k placenému plánu, a zjistěte, který z těchto pěti případů použití ušetří vašemu týmu nejvíce času.
