


Å skrive dokumentasjon manuelt betyr at du selv leser koden eller prosessen, bestemmer hva som er viktig, og deretter skriver det ned i den ledige tiden som er igjen etter at du har levert.
AI for tekniske skriveoppgaver fjerner mellomtrinnet. I stedet for å beskrive hva et system gjør fra hukommelsen, peker du AI-en mot den faktiske kildekoden, og den genererer forklaringen direkte fra logikken. Alt som gjenstår for deg, er å sjekke om alt stemmer.
Men ikke alle dokumentasjonstyper har like stor nytte av det. Noen er nesten ren kode-til-forklaring, der AI har en klar hastighetsfordel. Andre trenger mer menneskelig innramming rundt den AI-genererte kjernen. Her er fem konkrete dokumentasjonstyper der FlowHunts AI Documentation Writer konsekvent slår manuell skriving.
For en gjennomgang av selve prosessen, se hvordan du skriver teknisk dokumentasjon automatisk med AI .
For hvorfor dette problemet i det hele tatt finnes, se hvorfor utviklerdokumentasjon alltid er ufullstendig .
Brukstilfelle 1: API-referansedokumentasjon
API-referanser er det nærmeste du kommer et best-case-scenario for en AI-generator for API-dokumentasjon, fordi sannhetskilden (endepunkthåndtererne, SDK-metodene, formene for forespørsel og svar) allerede finnes i koden. Det er ingenting å intervjue en utvikler om som ikke allerede står i funksjonssignaturene.
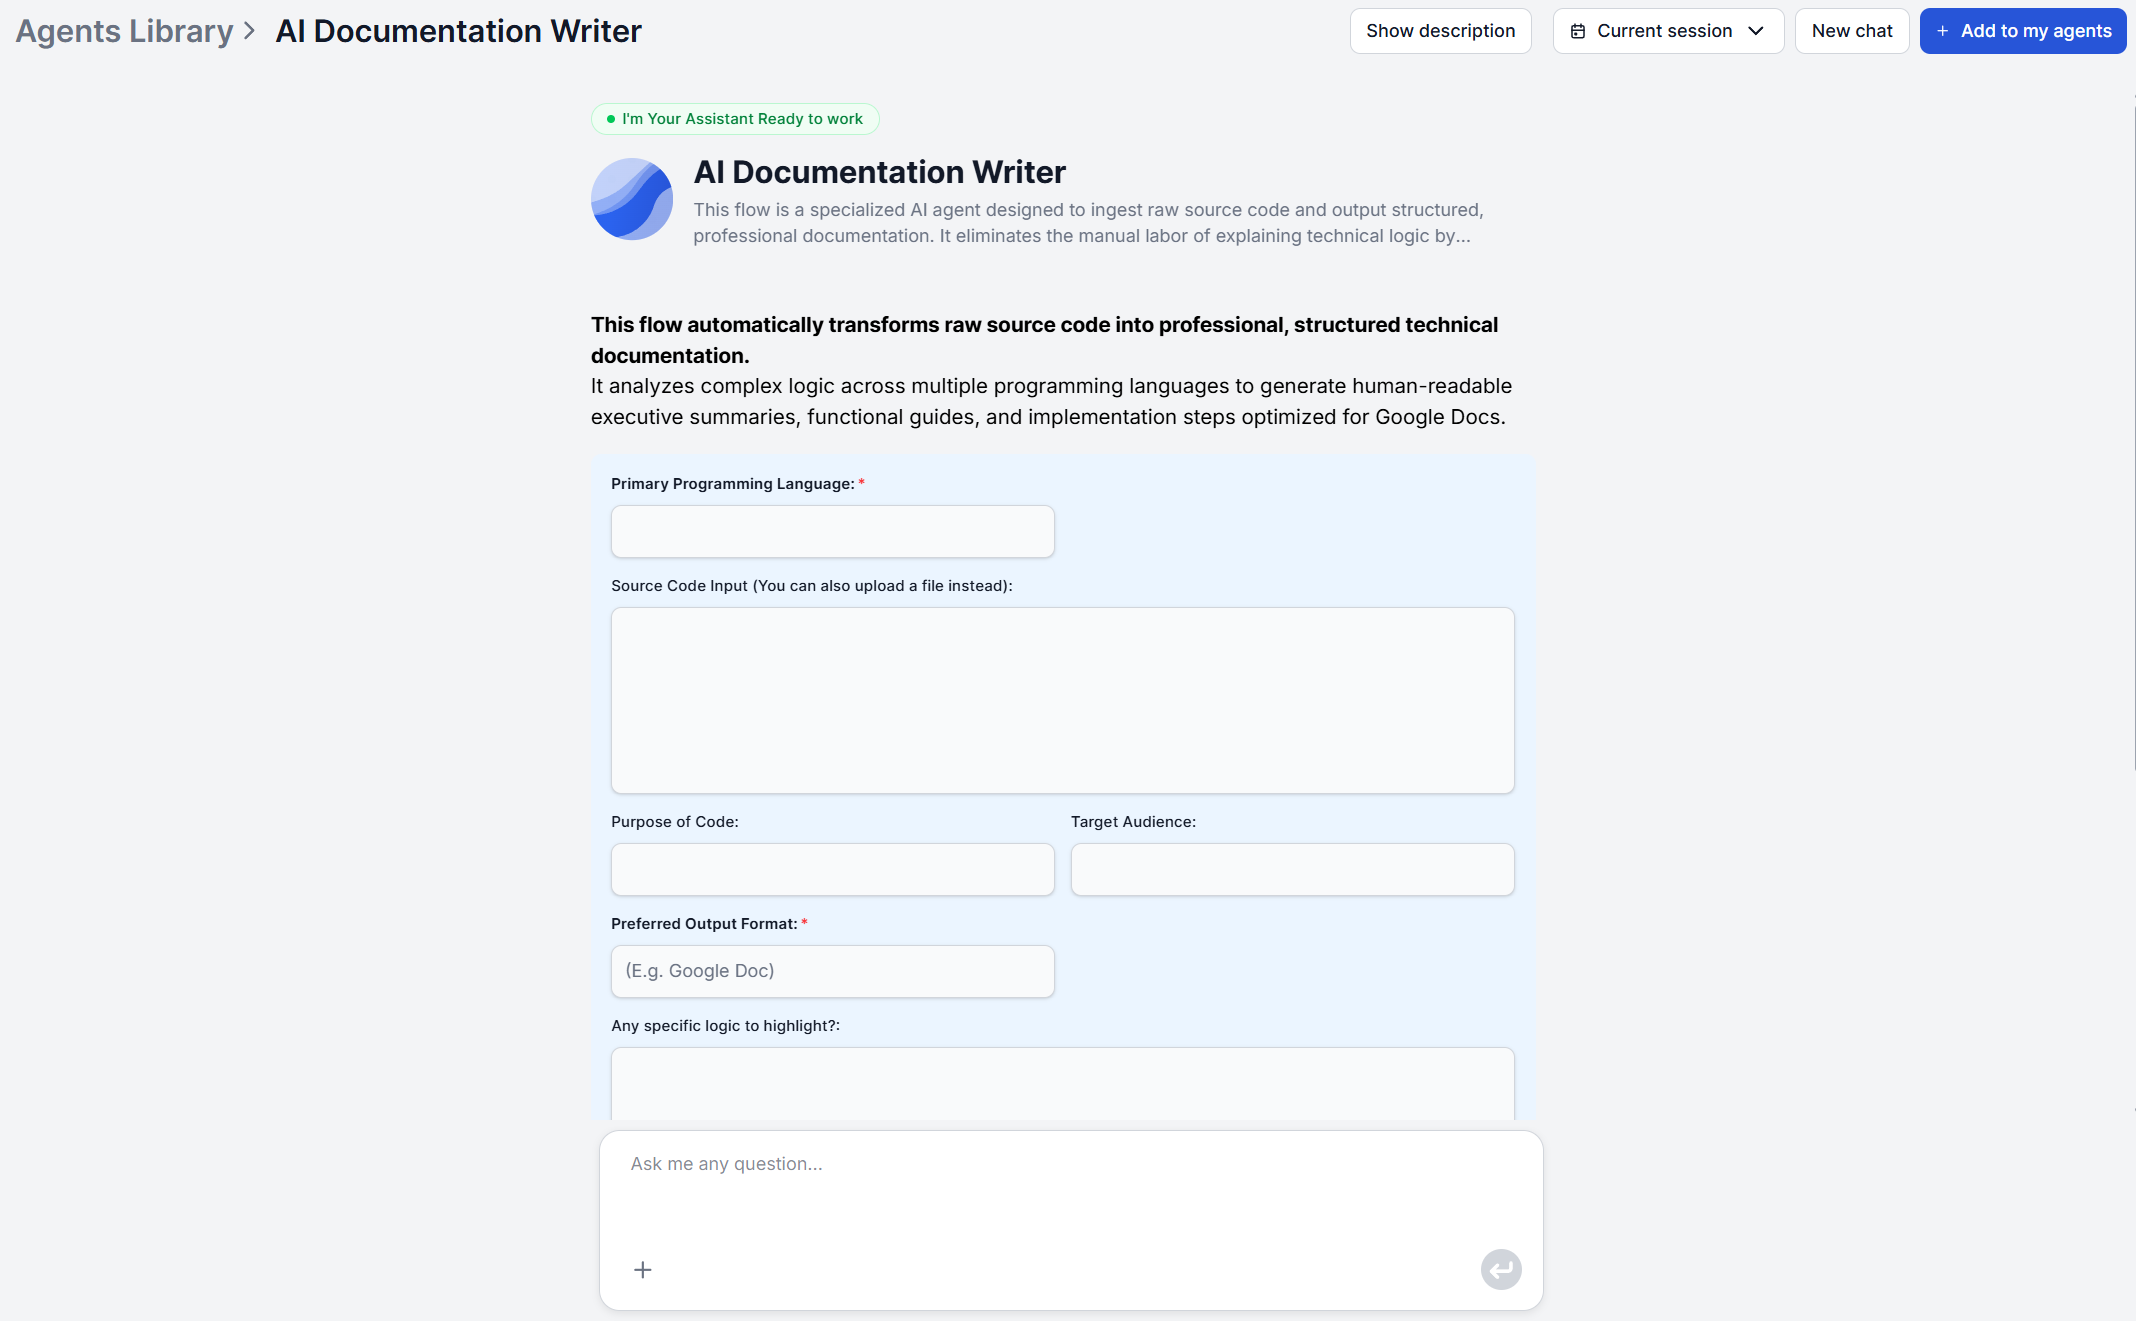
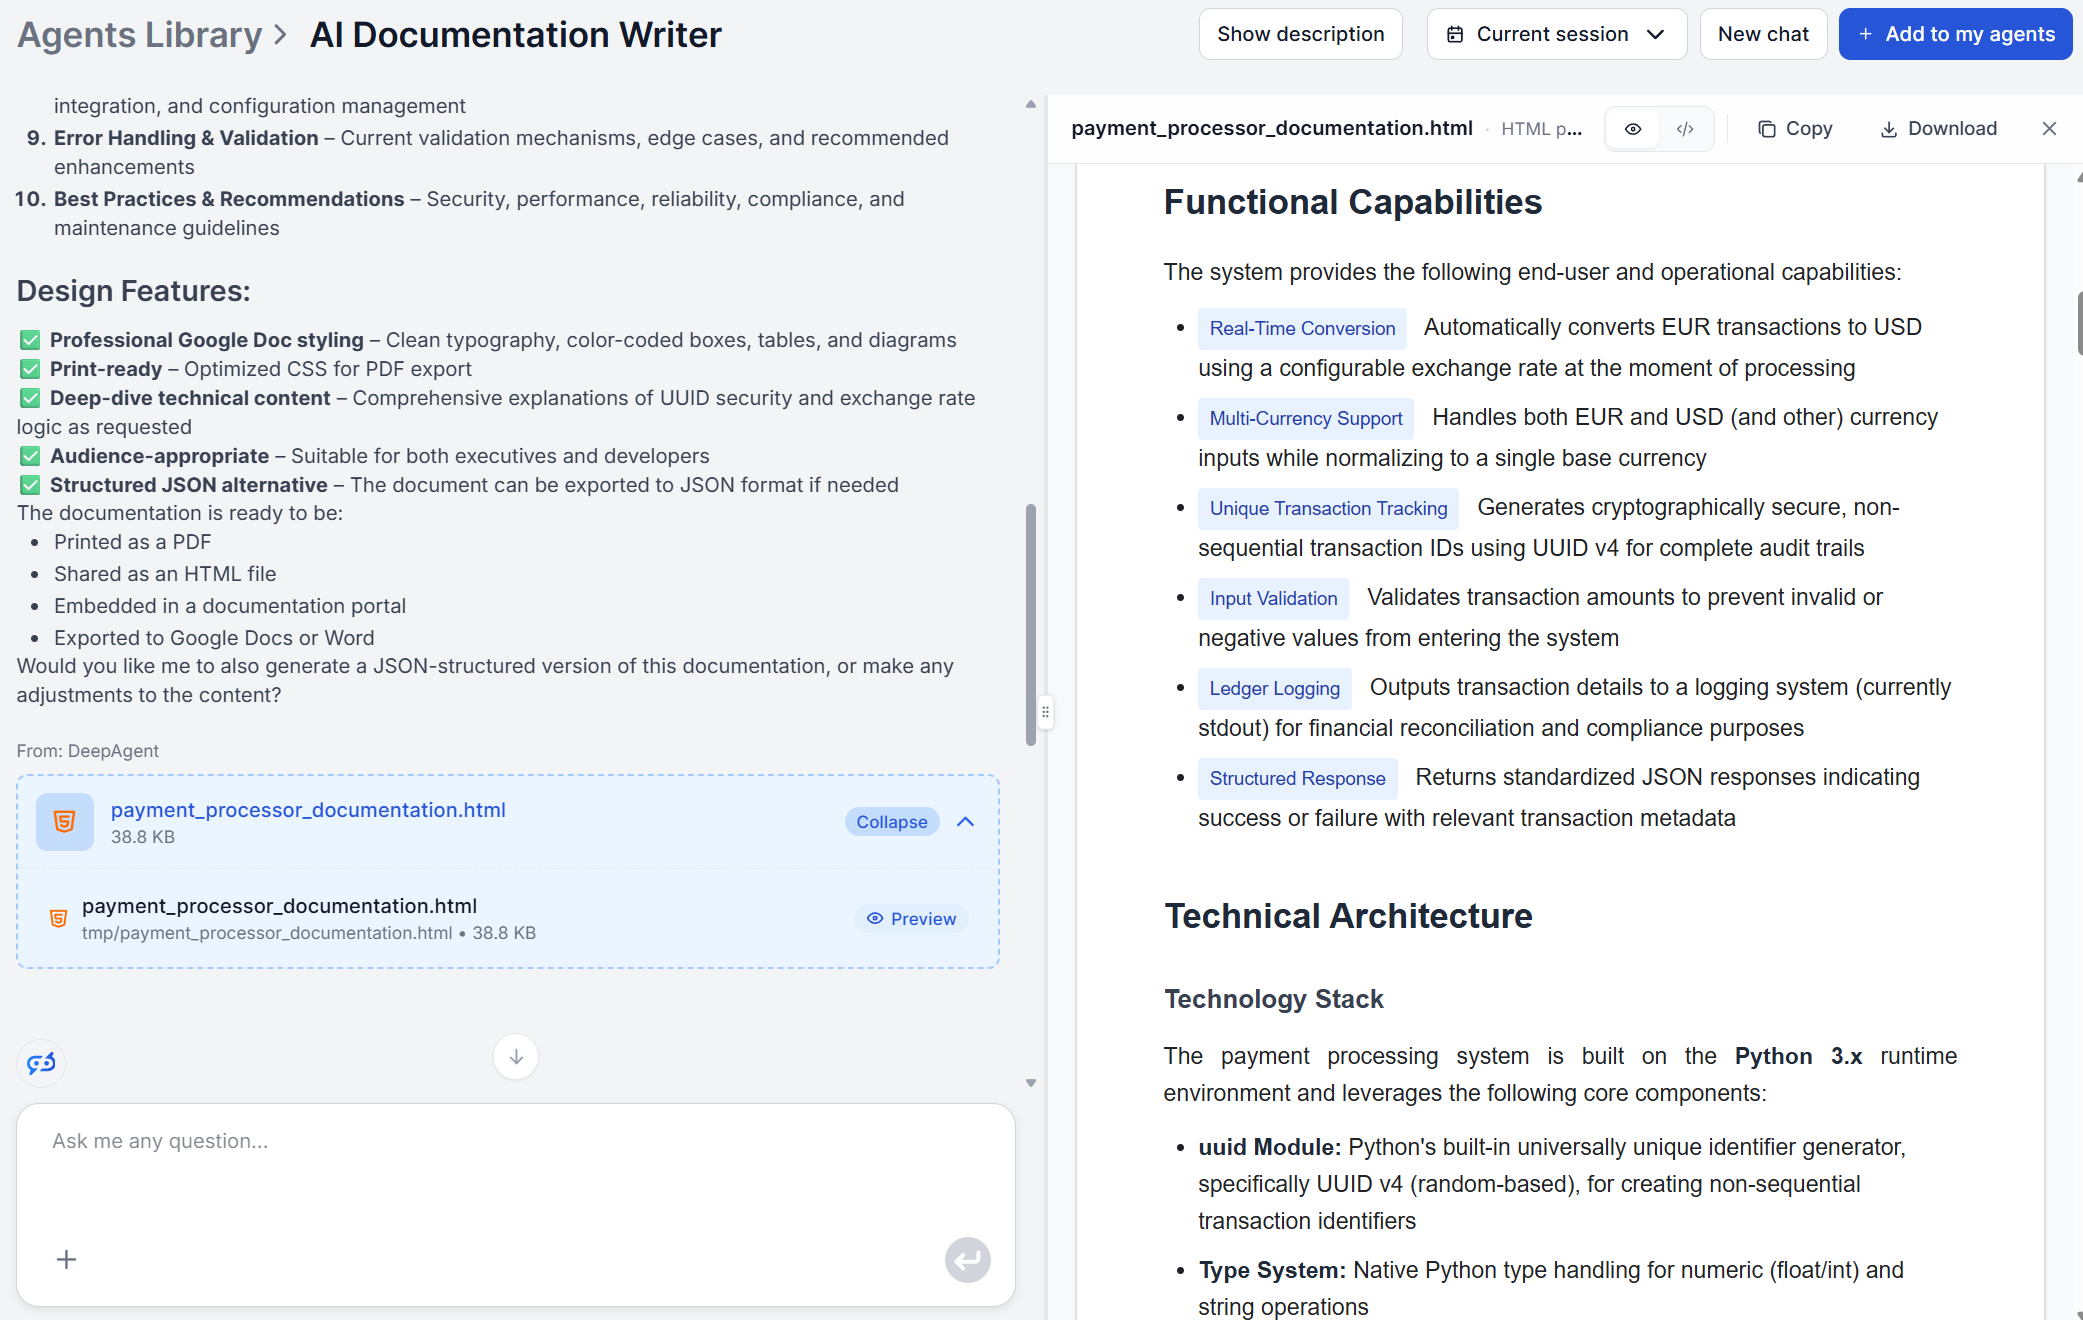
Pek AI Documentation Writer mot API-koden din, eller lim den bare inn i chatten, sett målgruppen til “utviklere” eller “API-brukere”, og bruk feltet “spesifikk logikk å fremheve” til å flagge alt som er lett å overse og som bør ettergås nøye. Utdatas seksjon om nøkkelfunksjoner og komponenter blir en fungerende referanse, og seksjonen om teknisk arkitektur dekker hvordan delene henger sammen.
Hastighetsfordelen vokser over tid. API-flater endres med nesten hver utgivelse, en parameter legges til, et endepunkt avvikles, og manuell dokumentasjon har en tendens til å henge etter nettopp på disse små, hyppige endringene.
Å skrive en referanse for tjue endepunkter for hånd er en oppgave som tar flere dager, selv for en utvikler som kjenner kodebasen godt. Å regenerere fra gjeldende kode tar bare noen få minutter, uansett hvor mange ganger API-et har endret seg siden forrige versjon, og uansett om det er tjue eller to hundre endepunkter.
Brukstilfelle 2: Utgivelsesnotater for produktet
Utgivelsesnotater må svare på hva som er endret, og hvorfor det betyr noe. Det svarer tett til to seksjoner som dokumentasjonsskriveren allerede produserer, nemlig sammendraget og listen over funksjonelle egenskaper.
Sett formålet til “utgivelsesnotater for denne oppdateringen”, målgruppen til “kunder” eller “sluttbrukere”, og legg inn koden for den aktuelle funksjonen eller feilrettingen. Trinnet med oversettelse til klarspråk gjør jobben med å gjøre en diff om til en beskrivelse som en ikke-teknisk kunde faktisk kan forstå, uten at en skribent må intervjue ingeniøren som bygde det.
Det er likevel verdt å ta en lett redigeringsrunde etterpå. Utgivelsesnotater trenger vanligvis en konsistent stemme og en bestemt rekkefølge (brytende endringer først, deretter nye funksjoner, så feilrettinger), og selv om AI-utdataene gir deg nøyaktig råmateriale for hvert punkt, er det å arrangere og prioritere dem for en kundevendt endringslogg en skjønnsvurdering et menneske bør gjøre.

Klar til å vokse bedriften din?
Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
Brukstilfelle 3: Onboardingguider for brukere
AI for produktdokumentasjon gjør nytten sin på onboardingguider som egentlig bare er beskrivelser av reelle konfigurasjonstrinn, tilgjengelige kommandoer eller oppsettkrav som allerede finnes i koden. Et CLI-verktøy, et SDK eller en intern applikasjon er alle gode kandidater.
Kjør den samme kildekoden gjennom dokumentasjonsskriveren, men sett målgruppen til “nye brukere” eller “ikke-tekniske interessenter”. Trinnet med logikkoversettelse bytter ut utviklerterminologi med klarspråk og naturlig flyt, og seksjonen om implementering og bruksanvisning blir selve onboardingtrinnene, som dekker oppsett, konfigurasjon og første gangs bruk.
Avveiningen du bør kjenne til på forhånd, er at denne tilnærmingen dokumenterer hva produktet gjør og hvordan det konfigureres, ikke hvorfor en funksjon finnes fra et produktmarkedsføringsperspektiv. For onboardinginnhold som er mer fortellende enn instruerende, bør du behandle AI-utdataene som den nøyaktige tekniske ryggraden og legge til innramming rundt den, i stedet for å forvente en ferdig, merkevaretilpasset velkomstsekvens.
Dette betyr mest for utviklerverktøy, der en ny brukers første time vanligvis går med til installasjon, autentisering og å kjøre en første vellykket kommando. Å generere den seksjonen direkte fra den faktiske oppsettkoden, i stedet for fra en utviklers minne om hvordan installasjonen skal fungere, fanger opp de små inkonsekvensene (et flagg som har fått nytt navn, et konfigurasjonsalternativ som har flyttet på seg) som gjør onboardingguider stille og rolig feil innen et par utgivelser.
Brukstilfelle 4: Intern SOP- og prosessdokumentasjon
Automatisering av intern dokumentasjon betyr mest her, fordi intern prosessdokumentasjon forfaller raskest. Den finnes vanligvis bare som institusjonell hukommelse. En senioringeniør som forklarer et distribusjonsskript eller en onboardingautomatisering høyt, uten at noen skriver det ned før vedkommende bytter team eller slutter i selskapet.
Hvis den forklaringen skjedde i et innspilt møte, kjør det først gjennom AI-generatoren for møtereferater for å fange konteksten som strukturerte møtenotater før den går tapt. Legg deretter det faktiske skriptet sammen med automatiseringskoden inn i dokumentasjonsskriveren, med målgruppen satt til nye ingeniører, for å produsere referansedokumentet som overlever at personen slutter.
Denne kombinasjonen løser to ulike problemer samtidig. Møtereferatet fanger den uformelle konteksten og resonnementet som ikke finnes i koden (hvorfor prosessen fungerer slik), mens dokumentasjonsskriveren fanger den nøyaktige tekniske detaljen om hva koden faktisk gjør.
Sammen produserer disse to agentene den typen onboardingreferanse som en nyansatt faktisk kan følge, uten å måtte dra en senioringeniør inn i nok et møte for å forklare det samme skriptet en gang til.
Bli med i vårt nyhetsbrev
Få de siste tipsene, trendene og tilbudene gratis.
Brukstilfelle 5: Kunnskapsbaseartikler
Kundevendte kunnskapsbaseartikler trenger en nøyaktig forklaring av hvordan en funksjon faktisk oppfører seg, og en formulering som samsvarer med hvordan kundene allerede snakker om problemet. Dokumentasjonsskriveren håndterer den første delen direkte: legg inn koden bak funksjonen, sett målgruppen til “kunder” eller “supportteam”, og seksjonene om funksjonelle egenskaper og bruksanvisning blir ryggraden i artikkelen.
Det siste poenget er den delen som oftest hoppes over, og det er den som avgjør om artikkelen faktisk er brukbar. En KB-artikkel leses av noen som står midt i et problem, ikke av noen som driver research, og dokumentasjonsskriverens utdata med seks seksjoner er bygget for fullstendighet, ikke for korthet. Å lime alt inn i en supportartikkel begraver den ene setningen en frustrert kunde trenger, under en arkitekturforklaring ingen ba om.
Før publisering: innled med et svar på én eller to setninger, behold seksjonene om funksjonelle egenskaper og bruksanvisning, og dropp teknisk arkitektur samt nøkkelfunksjoner og komponenter med mindre supportteamet ditt faktisk trenger implementeringsdetaljer.
Slik vedlikeholder du et levende dokumentasjonssystem med AI
På tvers av alle fem brukstilfellene endres aldri den underliggende prosessen. Kodeanalyse, logikkoversettelse og dokumentstrukturering. Det som endres, er bare målgruppen, formålet og den spesifikke logikken du angir for hver kjøring. Det er verdt å håndtere bevisst, i stedet for å finne opp innspillet på nytt hver gang.
Det lønner seg å ha en kort, lagret innmatsmal per dokumentasjonstype: én for API-referanser (målgruppe: utviklere), én for utgivelsesnotater (målgruppe: kunder), én for onboardingguider (målgruppe: nye brukere), én for interne SOP-er (målgruppe: nyansatte) og én for kunnskapsbaseartikler (målgruppe: supportteam). Å gjenbruke samme ordlyd hver gang holder tonen konsistent på tvers av dusinvis av genererte dokumenter, selv om hvert enkelt produseres uavhengig.
For team som driver mer enn ett produkt: del hvert produkt inn i sitt eget FlowHunt-arbeidsområde, koble til de relevante verktøyene og bygg en kunnskapsbase som er avgrenset til nettopp det produktet. Å holde hvert produkts kontekst atskilt gir mer fokuserte utdata ved hver kjøring og hindrer at ett produkts terminologi eller konvensjoner lekker inn i et annets dokumentasjon. Og siden regenerering er rask, bør du knytte det til en faktisk utløser – en utgivelse, en sammenslått pull request som berører en dokumentert modul – i stedet for en planlagt dokumentasjonssprint som konkurrerer med alt annet på veikartet og vanligvis taper.
Prøv AI Documentation Writer med den 7 dager lange gratis prøveperioden (5 kreditter inkludert) før du forplikter deg til en betalt plan, og se hvilket av disse fem brukstilfellene som sparer teamet ditt mest tid først.
