


手动撰写文档意味着你得亲自阅读代码或流程,判断哪些内容重要,然后在产品发布后剩下的零碎时间里把它写下来。
AI 技术写作用例省去了中间环节。你不必凭记忆描述系统做了什么,只需把 AI 指向真实的源代码,它就会直接从逻辑中生成说明。剩下要做的,只是检查一切是否对得上。
但并非每种文档类型都能同等受益。有些几乎纯粹是“代码到说明”的转换,AI 在其中拥有明显的速度优势。另一些则需要在 AI 生成的核心内容之外,加入更多人工的框架。以下是五种具体的文档类型,FlowHunt 的 AI 文档撰写器 在这些类型上始终优于人工撰写。
想了解流程本身的逐步演示,请参阅如何用 AI 自动撰写技术文档 。
想了解这个问题为何从一开始就存在,请参阅开发者文档为何总是不完整 。
用例 1:API 参考文档
对 AI API 文档生成器来说,API 参考文档几乎是最理想的场景,因为事实来源(端点处理程序、SDK 方法、请求与响应的结构)本就存在于代码之中。没有任何需要采访开发者才能获得的信息,不是早已写在函数签名里。
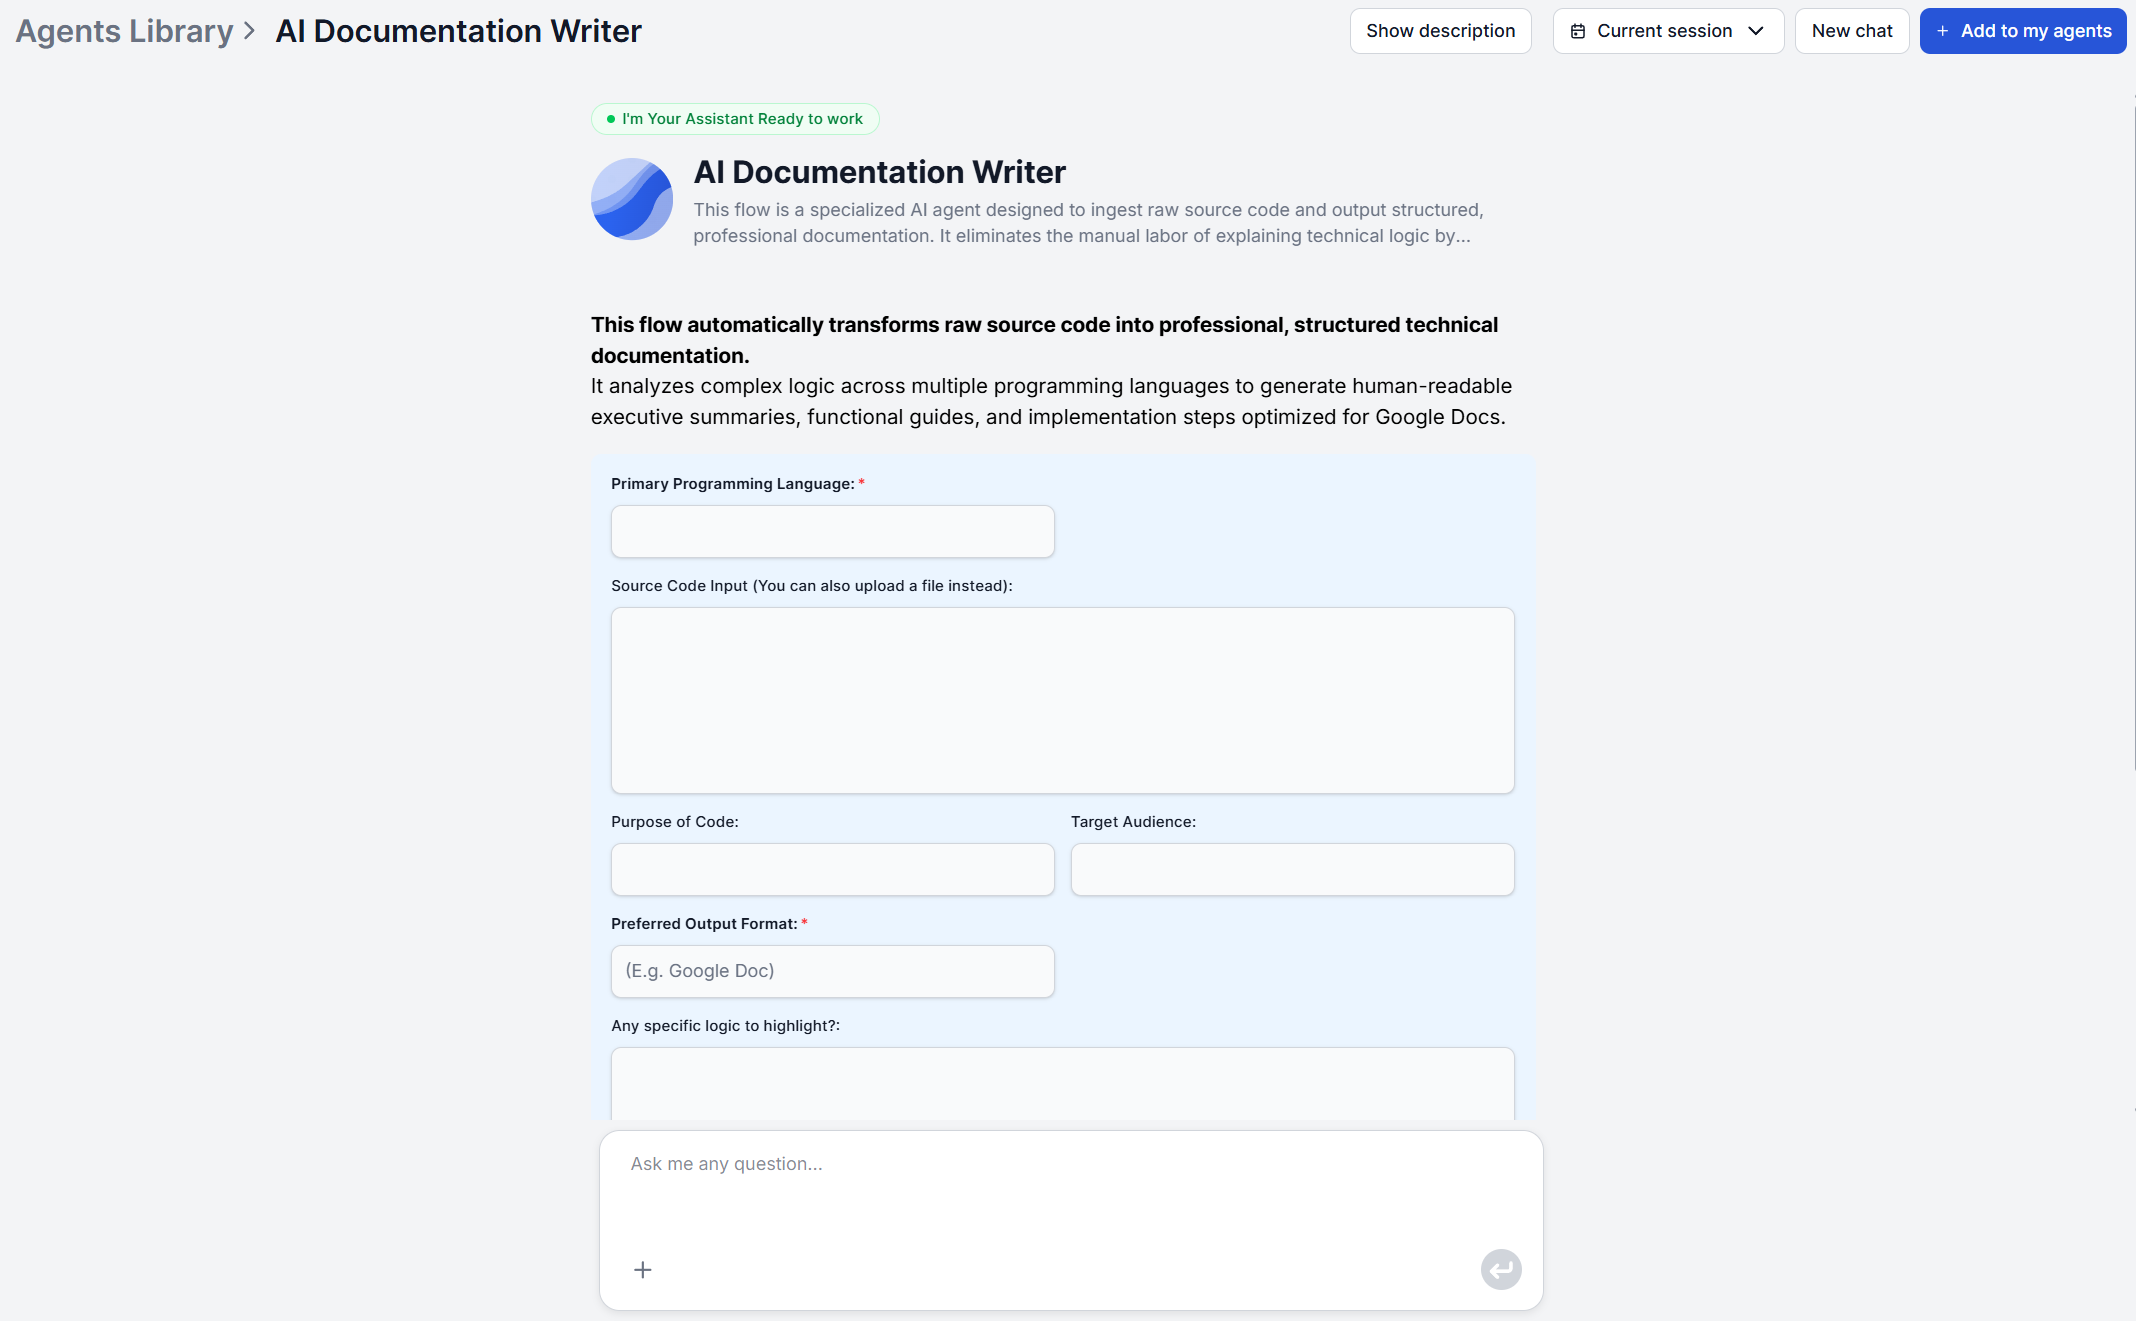
把 AI 文档撰写器 指向你的 API 代码,或者直接粘贴到聊天框里,将受众设为 “developers” 或 “API consumers”,并使用 “specific logic to highlight” 输入项标出任何容易被忽略、需要认真对待的内容。输出中的关键函数与组件部分会成为一份可用的参考,技术架构部分则说明各个部分如何组合在一起。
速度优势会随时间不断累积。API 接口几乎每次发布都会变化:新增一个参数、弃用一个端点,而人工文档恰恰最容易在这些频繁的小改动上落后。
即使是熟悉代码库的开发者,手工为二十个端点编写参考文档也要花上好几天。而从当前代码重新生成只需几分钟,无论 API 自上一版本以来改动了多少次,也无论是二十个端点还是两百个。
用例 2:产品发布说明
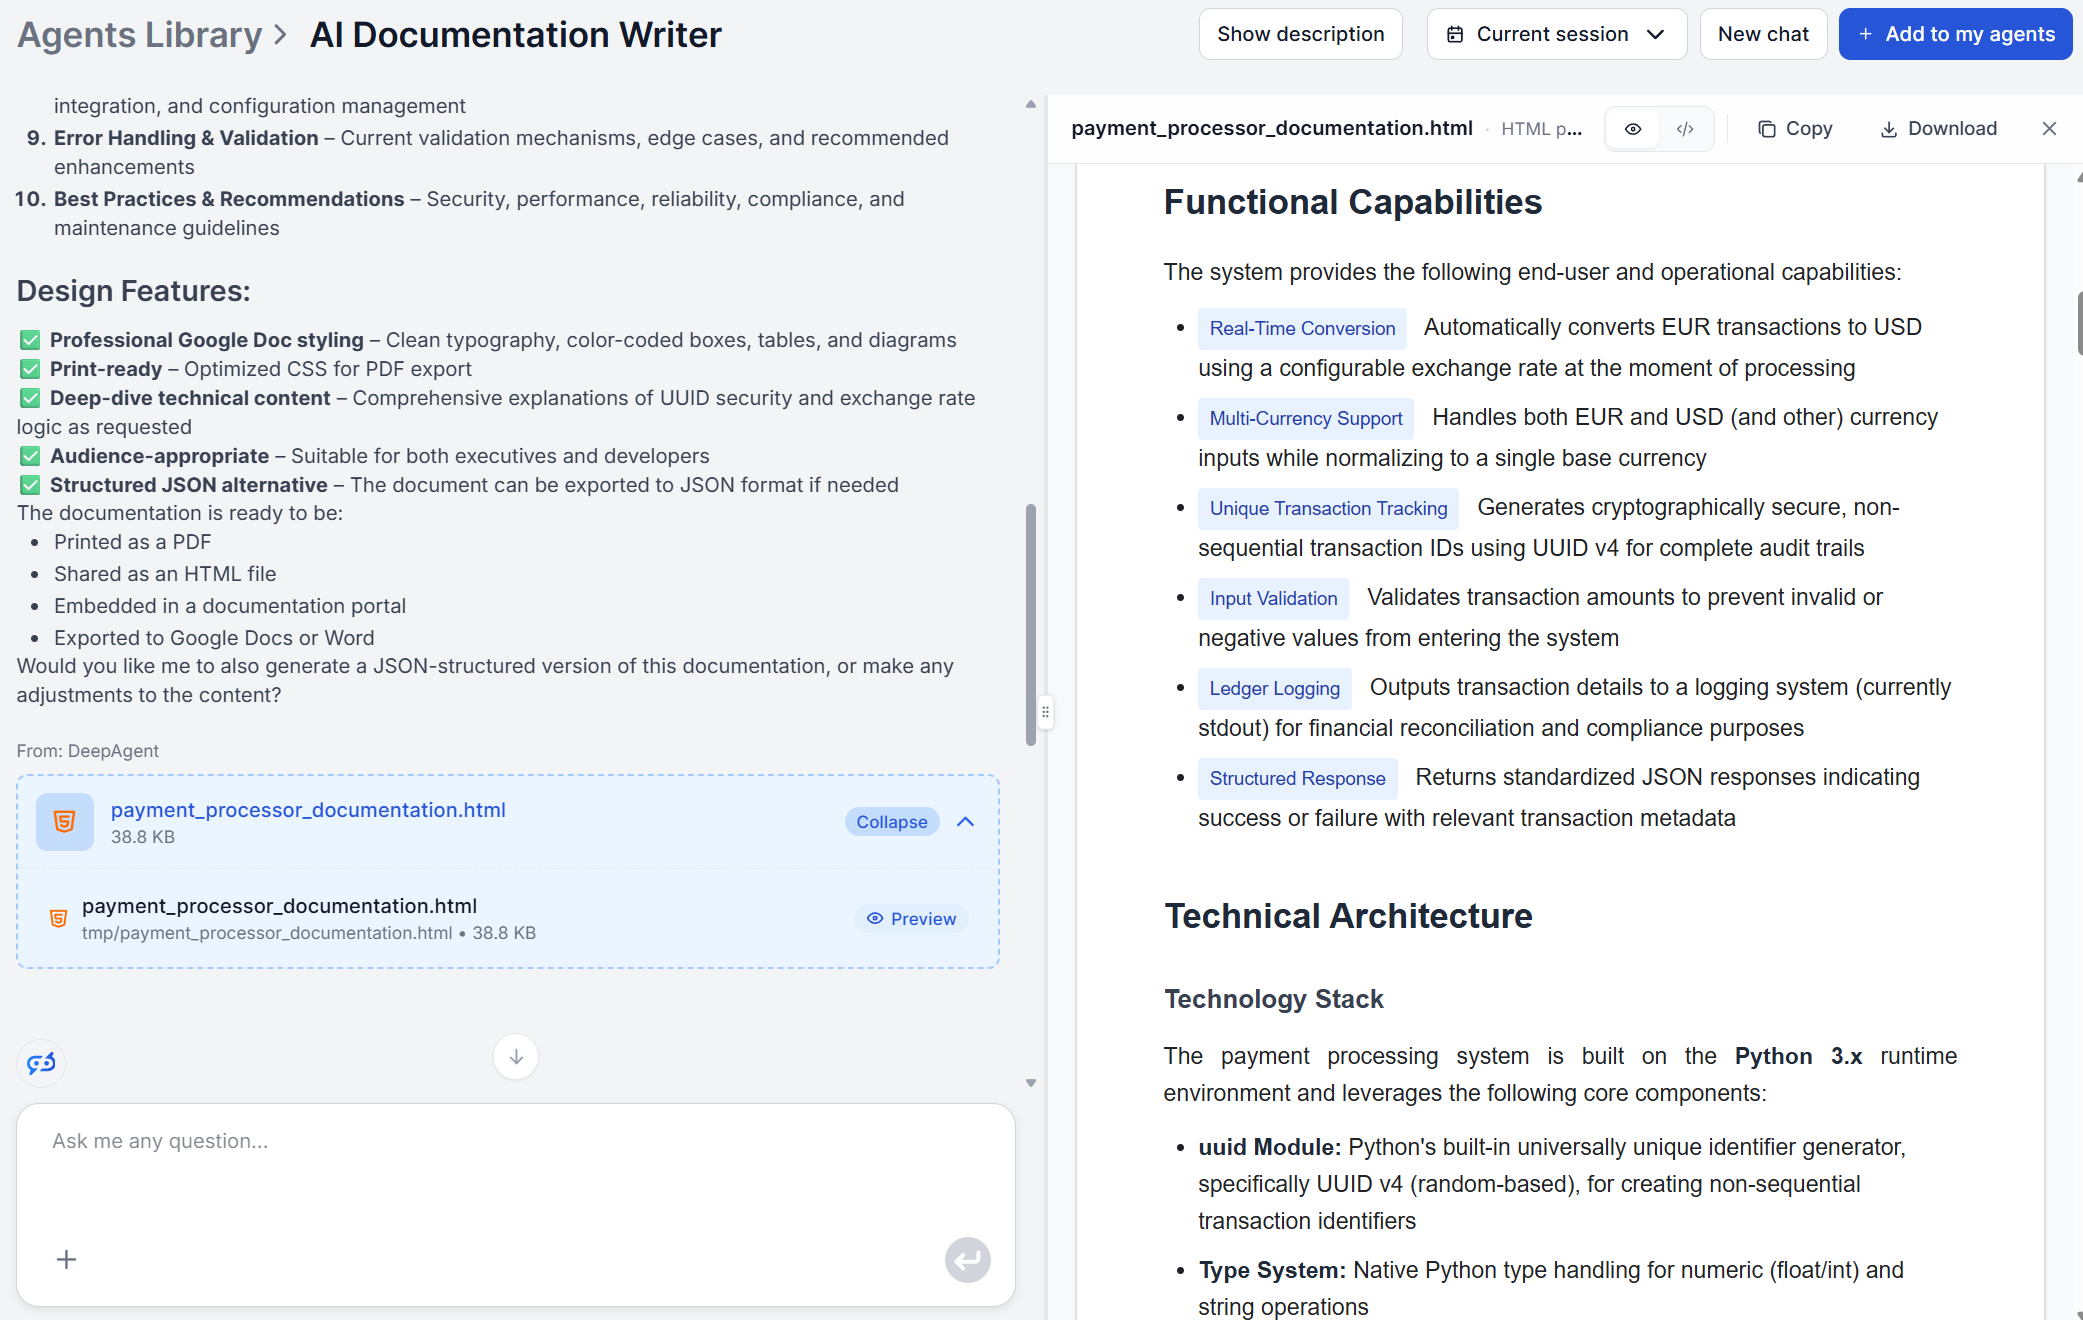
发布说明需要回答改了什么,以及为什么重要。这与文档撰写器已经产出的两个部分高度对应:执行摘要和功能能力清单。
把用途设为 “release notes for this update”,受众设为 “customers” 或 “end users”,然后输入具体功能或修复的代码。通俗语言转换阶段会完成把 diff 转化为非技术客户也能真正理解的描述这一工作,无需撰写者去采访实现该功能的工程师。
之后仍值得做一次轻度编辑。发布说明通常需要一致的语气和特定的顺序(先是破坏性变更,然后是新增功能,最后是修复),而 AI 输出虽然为每个条目提供了准确的原始素材,但如何为面向客户的更新日志安排顺序和排定优先级,仍应由人来判断。
用例 3:用户入职指南
产品文档 AI 在入职指南上最能体现价值——这类指南其实只是对真实配置步骤、可用命令或环境要求的描述,而这些内容本就存在于代码中。CLI 工具、SDK 或内部应用都是很好的适用对象。
把同一份源代码交给文档撰写器,但把目标受众设为 “new users” 或 “non-technical stakeholders”。逻辑转换阶段会把开发者术语替换为行文自然的通俗语言,而实现与使用说明部分就成了入职步骤本身,涵盖安装、配置和首次使用。
需要事先了解的一个取舍是:这种方法记录的是产品做什么以及如何配置,而不是从产品营销角度说明某个功能为何存在。对于叙事性强于指导性的入职内容,应把 AI 输出当作准确的技术骨架,在它周围补充框架,而不要指望得到一套成品式的、符合品牌调性的欢迎流程。
这一点对开发者工具尤其重要,因为新用户的第一小时通常都花在安装、认证和成功运行第一条命令上。直接从真实的安装代码生成这一部分,而不是依据开发者对安装应当如何进行的记忆,能够发现那些细微的不一致(某个被改名的标志、某个被挪位置的配置项)——正是它们让入职指南在几次发布之后就悄悄失效。
用例 4:内部 SOP 与流程文档
内部文档自动化在这里最为关键,因为内部流程文档的衰减速度最快。它通常只以组织记忆的形式存在:一位资深工程师口头讲解部署脚本或入职自动化流程,却没有人在这人调岗或离职之前把它记录下来。
如果那次讲解发生在有录制的会议中,先用 AI 会议纪要生成器 处理,把上下文整理成结构化的会议记录,免得丢失。然后把实际的脚本连同自动化代码一起输入文档撰写器,受众设为新入职的工程师,从而产出那份不会随人离职而消失的参考文档。
这一组合一次解决两个不同的问题。会议纪要捕捉代码中不存在的非正式背景与推理(这个流程为什么这样运作),而文档撰写器则捕捉代码实际所做之事的准确技术细节。
两个智能体合在一起,产出的正是那种新员工真能照着做的入职参考,无需再把资深工程师拉进另一场会议,第二次讲解同一个脚本。

加入我们的新闻通讯
免费获取最新提示、趋势和优惠。
用例 5:知识库文章
面向客户的知识库文章需要准确说明某项功能的实际行为,并使用与客户谈论该问题的方式相符的措辞。文档撰写器直接处理前半部分:把功能背后的代码输入进去,受众设为 “customers” 或 “support team”,功能能力与使用说明部分就成了文章的主干。
最后这一点最容易被跳过,却恰恰决定了文章是否真正可用。阅读知识库文章的人是正卡在问题中的人,而不是在做调研的人,而文档撰写器那六个部分的输出追求的是完整,而非简洁。把全部内容粘贴进一篇支持文章,只会让沮丧的客户真正需要的那一句话,被一段没人要求的架构说明埋没。
发布之前,先用一两句话给出答案,保留功能能力与使用说明部分,并删去技术架构和关键函数与组件——除非你的支持团队确实需要实现细节。
如何用 AI 维护一套持续更新的文档体系
在这五个用例中,底层流程始终不变:代码分析、逻辑转换、文档结构化。变化的只是每次运行时你指定的受众、用途和特定逻辑。这一点值得刻意对待,而不是每次都重新构思输入。
为每种文档类型保留一份简短的输入模板是值得的:一份用于 API 参考文档(受众:developers),一份用于发布说明(受众:customers),一份用于入职指南(受众:new users),一份用于内部 SOP(受众:new hires),一份用于知识库文章(受众:support team)。每次复用相同的措辞,能让几十份生成的文档在语气上保持一致,尽管每一份都是独立生成的。
对于同时运营多个产品的团队,把每个产品拆分成独立的 FlowHunt 工作区,连接相关工具,并建立专门针对该产品的知识库。让每个产品的上下文相互隔离,能让每次运行都产出更聚焦的结果,也避免某个产品的术语或惯例渗入另一个产品的文档。由于重新生成很快,应把它绑定到真实的触发条件上——一次发布、一个触及已文档化模块的已合并拉取请求——而不是安排一场与路线图上其他所有事情争夺资源、且通常总是落败的文档冲刺。
在决定购买付费方案之前,先通过 7 天免费试用(含 5 个积分)试用 AI 文档撰写器 ,看看这五个用例中哪一个最先为你的团队省下最多时间。
