


Chat with PDF 让你可以上传任何基于文本的 PDF,并用自然语言对它提问。你无需从头读到尾,就能获得直接来自文档的准确答案,同时完整的对话上下文会被保留,因此追问可以自然进行。
本指南将带你走完从上传到输出的完整设置流程,包括那些始终能带来最佳效果的提问模式、大多数用户早期常犯的错误,以及你可以做出的调整,从而最大限度地发挥工作流的价值。
第 1 步:上传你的 PDF
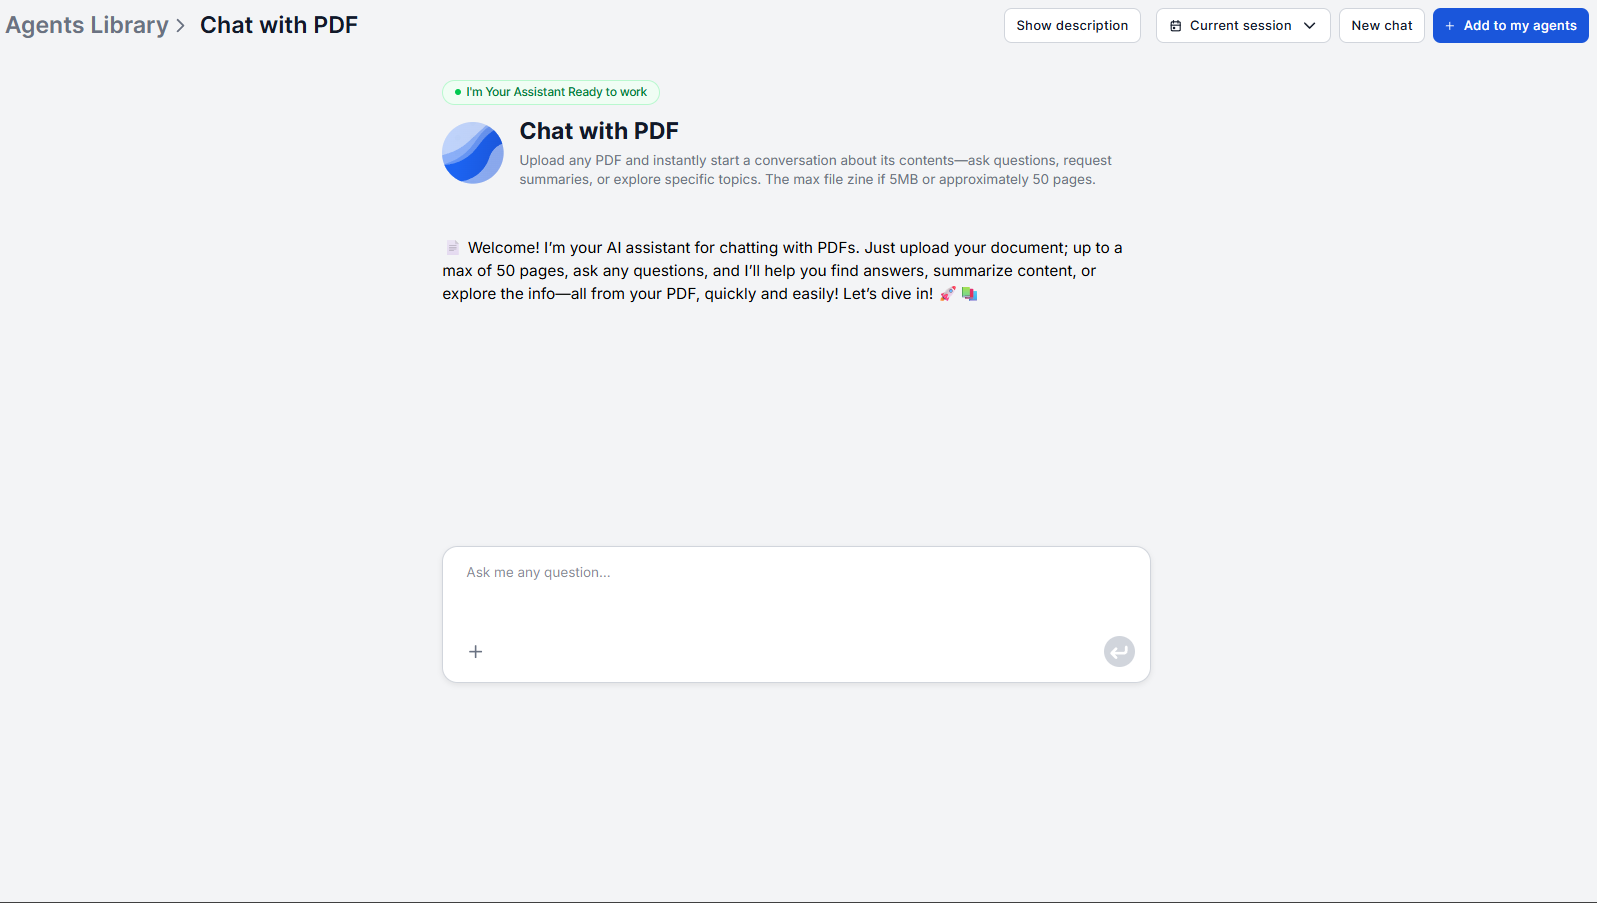
打开 Chat with PDF ,通过文件上传界面上传你的文档。该工具适用于任何基于文本的 PDF,也支持其他文本格式。
一个重要限制是,该工具直接从文档中提取文本,因此只适用于文本可被选中的 PDF。扫描版 PDF(页面是图像而非内嵌文本的文档)不会产生结果。不过,你可以在工作流中启用 OCR 处理 ,让 FlowHunt 也能读取这些文件。
文件上传后,会话即准备就绪。无需配置步骤、无需给文档打标签,也不必在提出第一个问题前预先通读文档。
第 2 步:如何写出能获得准确答案的提问
在提出第一个问题之前,值得先了解提交查询时会发生什么。助手不会先总结整份文档再基于总结作答,而是执行一次文件检索,在文档中搜索与你的具体查询最相关的段落。
这意味着答案的精确度直接取决于问题的精确度。由此得出两条准则:
要具体,不要宽泛。 “这份合同对责任限额是怎么规定的?”会检索到责任相关章节。“跟我说说这份合同”则是要求检索器搜索所有内容,结果只会得到笼统的高层概括,而不是你需要的条款原文。
用名称指明你要找的内容。 章节标题、条款类型、定义术语和主题关键词都能给检索器一个精确的目标。“这份文件中‘保密信息’的定义是什么?”比“都有哪些定义?”更有针对性。
答案完全基于所上传 PDF 的内容。助手不会引入外部信息,这意味着答案准确反映你文档的实际内容,而不是这类文档的标准版本通常包含的内容。
第 3 步:提出你的第一批问题
上传完成后,先问一些能勾勒文档结构的问题,然后再深入具体细节。对大多数文档类型而言,一个有用的开场顺序如下:
合同类: “本协议下各方的主要义务是什么?”这能让你在询问具体条款之前先获得结构图。
报告类: “这份文件涵盖什么内容,主要章节有哪些?”接着问:“关键发现或结论是什么?”
研究论文类: “研究问题和研究方法是什么?”接着问:“主要结果是什么?”
技术文档类: “这本手册涵盖什么内容,适用于哪些系统或组件?”
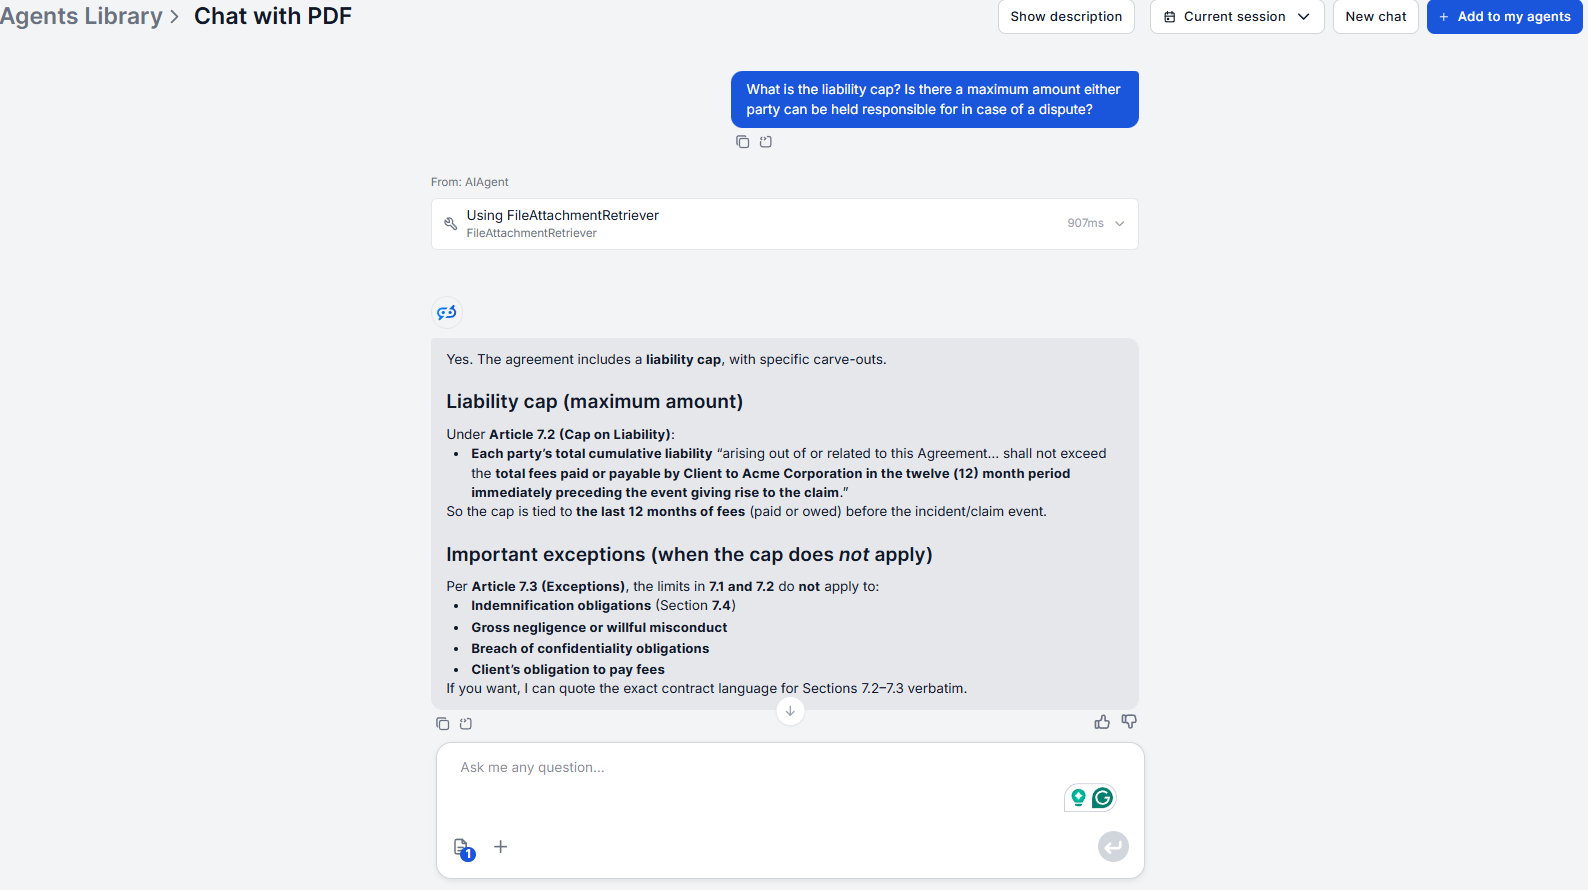
在最初的定位性问题之后,转向具体内容。由于助手在整个会话中保留完整的对话历史,每个追问都建立在前一轮交流之上。你无需重新解释上下文。“那条条款的例外情况有哪些?”能正确工作,因为助手知道你刚刚在讨论哪条条款。
如果问题存在歧义——在一份有三个独立定价章节的文档中询问“定价”——助手会提出澄清问题,而不是猜测。直接回答该澄清提示即可。
第 4 步:对照文档核验答案
助手在给出答案时会附上文档中的相关摘录和上下文,以帮助理解。请利用这些摘录对照原始文件核验回答。
对于任何将用于决策的答案——你依据的合同条款、你写进报告的某个数字、你据以行动的技术规格——请将返回的摘录直接与 PDF 中对应章节交叉比对。摘录会告诉你该检查哪个章节。交叉比对只需几秒钟,却能让你完全放心。
这一步很重要,因为该工具对格式良好、表述清晰的 PDF 表现精准,并且忠实于文档所述内容。无论检索执行得多好,专业标准都是:在依据一手来源的说法行动之前,先加以核验。

加入我们的新闻通讯
免费获取最新提示、趋势和优惠。
第 5 步:导出并使用你的发现
答案会显示在聊天界面中。你可以从对话中复制回答,粘贴到外部文档、客户笔记、修订稿或报告中。如果你需要结构化输出或格式化摘要,可以在 FlowHunt 内修改底层流程,把响应格式改成符合你文档工作流的形式。
对于需要经常从大量文档中提取同类信息的团队——例如法务团队对每一份收到的合同都跑同一份条款检查清单——把流程配置为返回结构化输出而非对话式回答,可以显著减少下游的格式整理工作。
对于多文档工作流,知识源 允许你把多个文档上传到 AI 知识库,并在单次会话中跨所有文档进行查询。
效果最好的提问模式(附示例)
基于检索系统的工作方式(在每次回答前检索相关段落),以下提问结构能稳定地产生更好的结果:
定向条款检索: “第[编号或名称]节对[主题]是怎么规定的?”示例:“第 12 节对适用法律是怎么规定的?”
定义查询: “这份文件如何定义该术语?”示例:“这份文件如何定义‘重大违约’?”
范围问题: “X 可能发生的所有条件是什么?”示例:“双方可以终止本协议的所有条件是什么?”
文档内比较: “这份文件在不同章节中对概念 A 的处理是否不同?”示例:“这份合同在不同情境下适用不同的通知期吗?”
特定章节摘要: “用通俗语言总结第[名称或编号]节。”助手会依据该章节的实际内容进行总结,而不是自行生成。
明确追问: “你刚才描述的情况有哪些例外?”或“如果该条件未满足,文件有说明会怎样吗?”
常见错误及解决方法
上传没有内嵌文本的扫描版 PDF。 检索器没有任何内容可搜。请先用我们的 OCR 工具 处理该文档。
一开始就提过于宽泛的问题。 “把这份合同中所有重要内容都告诉我”是在没有足够指引的情况下要求检索器自行判断优先级。先从结构性问题入手,再具体深入。
忽略澄清提示。 当助手请求澄清时,说明你的问题匹配到了多个章节。回答该提示能把检索引导到文档的正确部分。
把长篇回答当作完整覆盖。 该工具检索的是与你的查询最相关的段落,并不保证已找到整份文档中该主题的每一处出现。如果完整性很重要,请追问:“这份文件中还有其他章节涉及[主题]吗?”
在本可以追问时却开启新会话。 利用对话历史。重新上传同一份文档、重新提问那些建立在此前答案之上的问题,会浪费会话已经保留的上下文。
关于专业用例的详细讲解——法律合同审查、财务分析、RFP 文档等——请参阅 Chat with PDF:7 个专业用例 。如果你正在评估哪款工具适合你的工作流,PDF 聊天工具对比 对 FlowHunt、ChatPDF、Adobe 和 Humata 做了正面比较。