


Chat with PDF を使えば、テキストベースのPDFをアップロードし、自然な言葉で質問できます。最初から最後まで読み通す代わりに、ドキュメントから直接引き出した正確な回答が得られ、会話のコンテキスト全体が保持されるため、追加の質問も自然に機能します。
このガイドでは、アップロードから出力までの完全なセットアップを順を追って説明します。常に最良の結果を生むクエリパターン、多くのユーザーが初期に犯しがちなミス、ワークフローを最大限に活用するための調整方法も取り上げます。
ステップ1:PDFをアップロードする
Chat with PDF を開き、ファイルアップロードインターフェースからドキュメントをアップロードします。このツールはテキストベースのPDFだけでなく、他のテキスト形式にも対応しています。
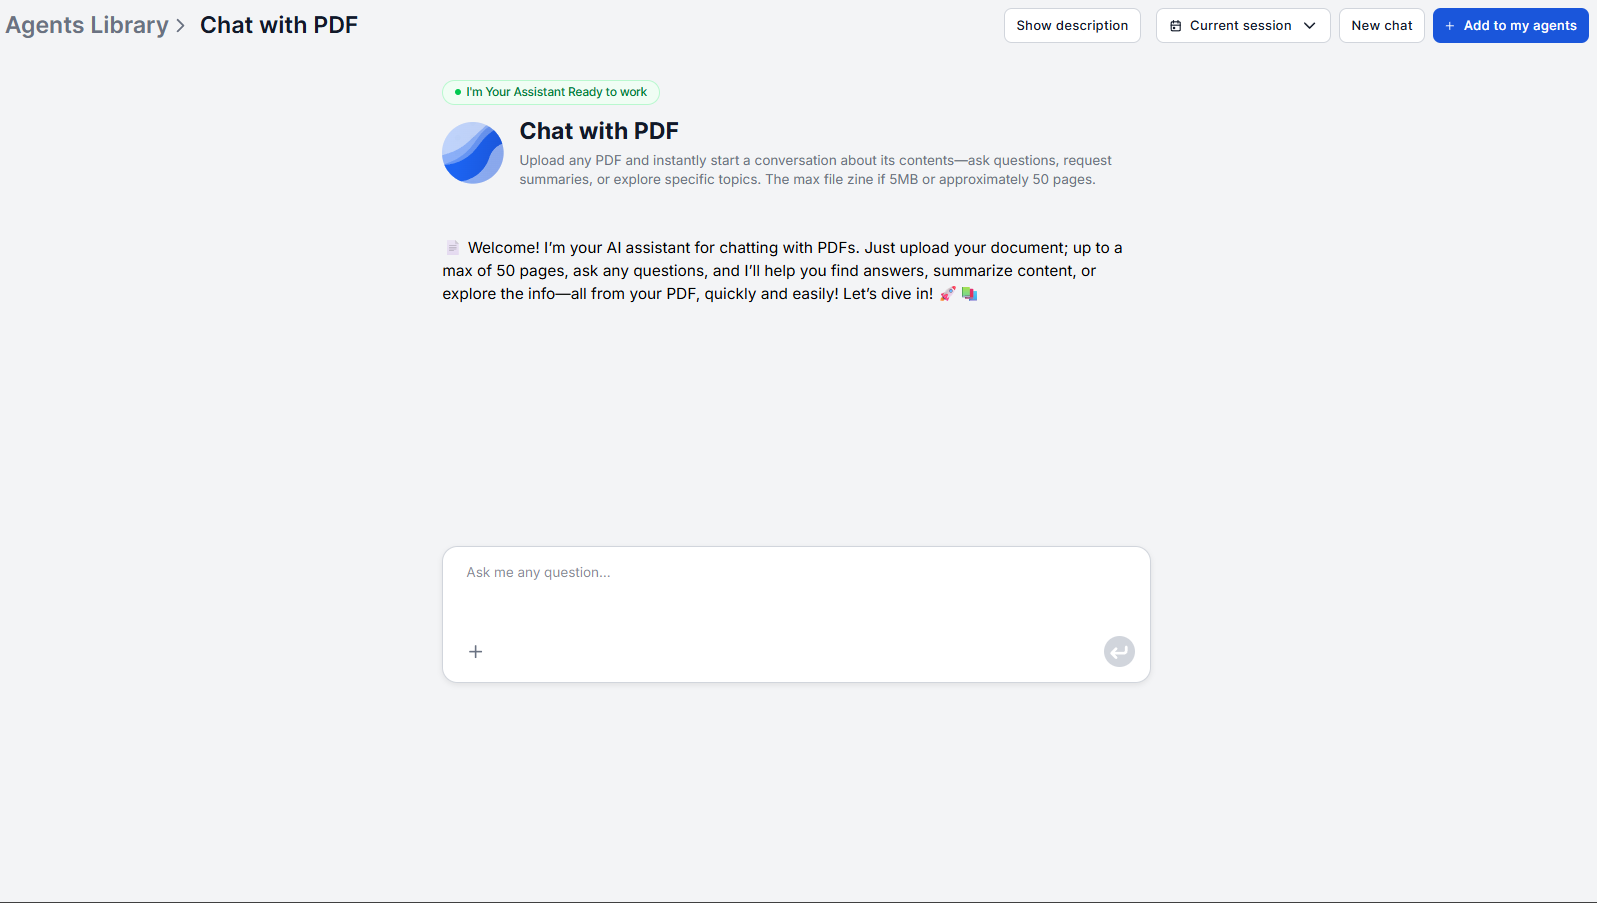
重要な制約が1つあります。このツールはドキュメントから直接テキストを抽出するため、テキストを選択できるPDFでのみ機能します。テキストが埋め込まれたドキュメントではなくページの画像であるスキャンPDFでは、結果は得られません。ただし、フロー内でOCR処理 を有効にすれば、FlowHuntがこれらも読み取れるようになります。
ファイルをアップロードすれば、セッションの準備は完了です。設定の手順も、ドキュメントのタグ付けも、最初の質問をする前にドキュメントを事前に読んでおく必要もありません。
ステップ2:正確な回答を得るクエリの書き方
最初の質問をする前に、クエリを送信したときに何が起こるかを理解しておく価値があります。アシスタントはドキュメント全体を要約してその要約から回答するのではありません。代わりにファイル検索パスを実行し、あなたの具体的なクエリに最も関連する箇所をドキュメント内から探します。
つまり、回答の精度は質問の精度に直接左右されます。ここから2つの指針が導かれます。
広くではなく、具体的に。“この契約は責任限度について何と述べていますか?“は責任に関するセクションを取得します。“契約について教えてください"は検索にすべてを探すよう求めることになり、必要な条項の文言ではなく、一般的で概要的な回答が生成されます。
**探しているものを名前で指定する。**セクション名、条項の種類、定義された用語、トピックのキーワードは、いずれも検索に正確なターゲットを与えます。“このドキュメントにおける’confidential information’の定義は何ですか?“は"定義は何ですか?“よりも的を射ています。
回答は、アップロードされたPDFの内容のみに基づきます。アシスタントは外部の情報を取り込まないため、回答は、その種のドキュメントの標準的な内容ではなく、あなたのドキュメントに実際に書かれている内容を正確に反映します。
ステップ3:最初の質問をする
アップロードしたら、細部に入る前に、ドキュメントの構造を把握する質問から始めましょう。ほとんどのドキュメント種別で役立つ最初の質問の流れは次のとおりです。
契約書の場合:“この契約に基づく各当事者の主な義務は何ですか?“これにより、特定の条項について尋ねる前に構造の全体像が得られます。
レポートの場合:“このドキュメントは何を扱っており、主なセクションは何ですか?“続けて:“主な調査結果や結論は何でしたか?”
研究論文の場合:“研究課題と方法論は何でしたか?“続けて:“主な結果は何でしたか?”
技術文書の場合:“このマニュアルは何を扱っており、どのシステムやコンポーネントに適用されますか?”
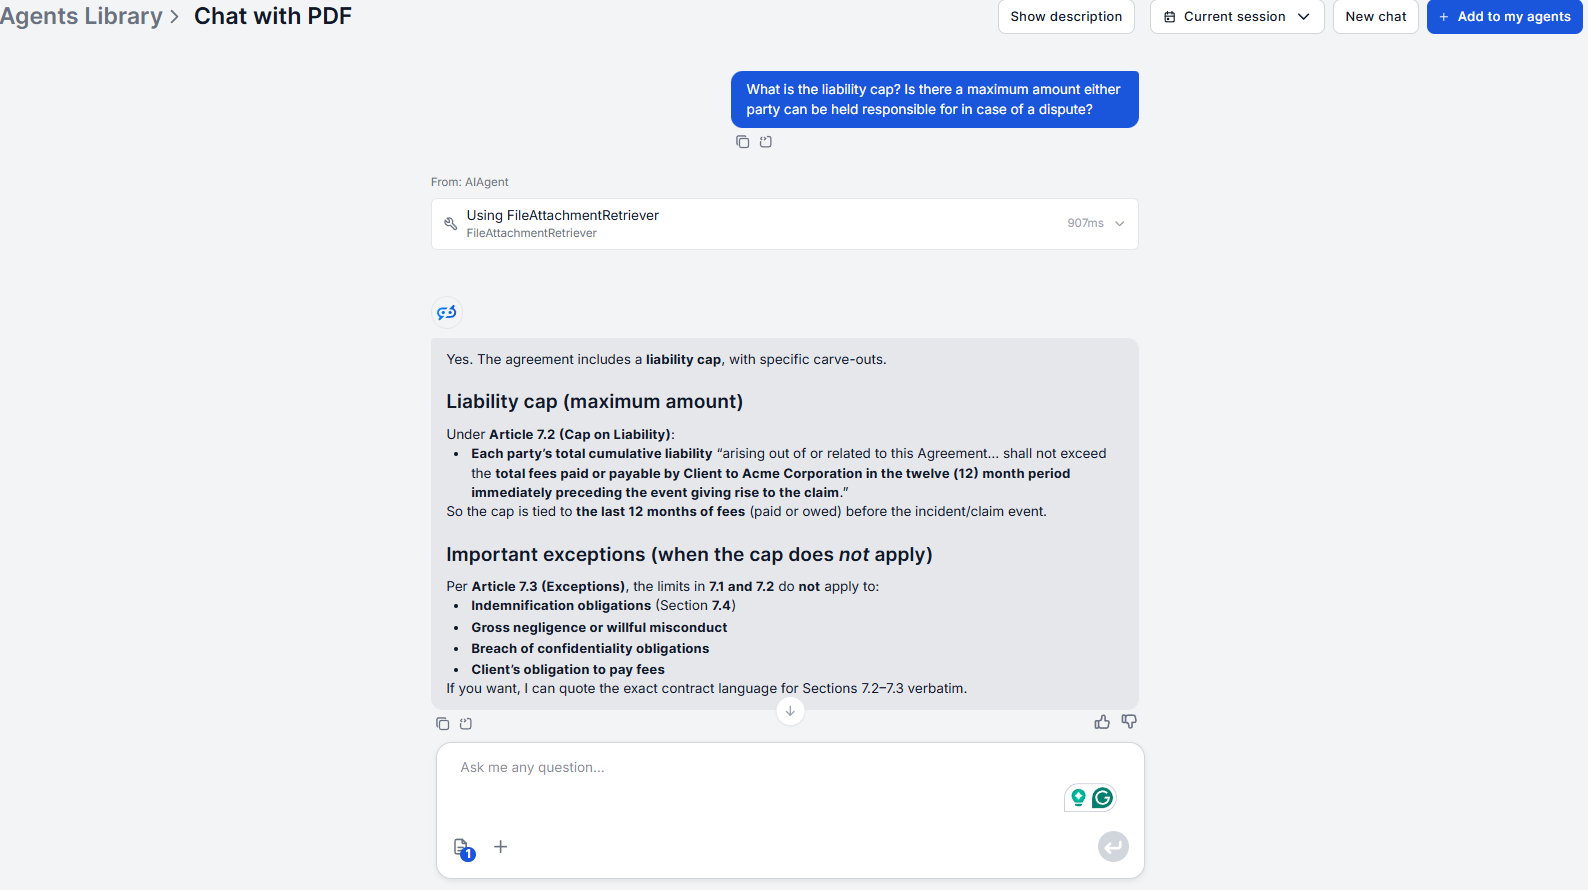
最初の全体像を把握する質問の後は、具体的な内容に移ります。アシスタントはセッション全体を通じて会話履歴を完全に保持しているため、各追加質問は前のやり取りを踏まえたものになります。コンテキストを説明し直す必要はありません。“その条項の例外は何ですか?“は、直前にどの条項について話していたかをアシスタントが把握しているため、正しく機能します。
質問が曖昧な場合、たとえば3つの別々の価格セクションがあるドキュメントで"価格"について尋ねた場合、アシスタントは推測せずに確認の質問をします。その確認のプロンプトに答えるだけでかまいません。
ステップ4:ドキュメントに照らして回答を検証する
アシスタントは、理解の助けになる場合はドキュメントからの関連する抜粋とコンテキストを添えて回答します。これらの抜粋を使って、回答を元のファイルに照らして検証してください。
意思決定の根拠となる回答、たとえば依拠しようとしている契約条項、レポートに記載する数値、対応しようとしている技術仕様については、返された抜粋をPDFの該当セクションと直接照合してください。抜粋は、どのセクションを確認すべきかを示してくれます。照合は数秒ででき、完全な安心が得られます。
このステップが重要なのは、このツールは整形が整い、明確に書かれたPDFに対しては正確で、ドキュメントに書かれている内容に対して忠実だからです。プロフェッショナルとしての標準は、検索がどれほど適切に行われたかに関わらず、一次情報に基づく主張は行動する前に検証することです。

ニュースレターに登録
最新のヒント、トレンド、お得な情報を無料で入手。
ステップ5:結果をエクスポートして活用する
回答はチャットに表示されます。会話から回答をコピーして、外部ドキュメントやクライアント向けメモ、修正案、レポートに貼り付けられます。構造化された出力や整形された要約が必要な場合は、FlowHunt内で基盤となるフローを変更し、ドキュメントワークフローに合わせて回答形式を変えられます。
法務チームが受領するすべての契約書に対して同じ条項チェックリストを実行する場合のように、多くのドキュメントから同じ種類の情報を定期的に抽出するチームでは、会話形式の回答ではなく構造化された出力を返すようにフローを設定すると、後工程の整形作業が大幅に減ります。
複数ドキュメントのワークフローでは、ナレッジソース を使って複数のドキュメントをAIナレッジベースにアップロードし、1回のセッションですべてを横断して検索できます。
最も効果的なクエリパターン(例付き)
検索システムの仕組み(回答のたびに関連する箇所を検索する)に基づくと、以下のクエリ構造が常により良い結果を生みます。
特定の条項の取得:“第[番号または名称]条はそのトピックについて何と述べていますか?“例:“第12条は準拠法について何と述べていますか?”
定義の検索:“このドキュメントはその用語をどのように定義していますか?“例:“このドキュメントは’material breach’をどのように定義していますか?”
範囲に関する質問:“Xが起こり得るすべての条件は何ですか?“例:“いずれかの当事者がこの契約を解除できるすべての条件は何ですか?”
ドキュメント内での比較:“このドキュメントは概念Aをセクションによって異なる扱いをしていますか?“例:“この契約は状況によって異なる通知期間を適用していますか?”
特定のセクションの要約:“セクション名または番号を平易な言葉で要約してください。“アシスタントは独自に生成するのではなく、実際のセクション内容から要約します。
明示的な追加質問:“今説明した内容の例外は何ですか?“または"その条件が満たされなかった場合にどうなるかをドキュメントは扱っていますか?”
よくある間違いとその修正方法
**埋め込みテキストのないスキャンPDFをアップロードする。**検索対象が何もありません。まずOCRツール でドキュメントを処理してください。
最初から範囲が広すぎる質問をする。“この契約について重要なことをすべて教えてください"は、十分な方向性を与えずに優先順位を付けるよう検索に求めることになります。構造に関する質問から始め、その後で具体的な内容に進みましょう。
**確認のプロンプトを無視する。**アシスタントが確認を求めるのは、あなたの質問が複数のセクションに一致したことを意味します。プロンプトに答えることで、検索がドキュメントの適切な部分に振り分けられます。
**長い回答を完全な網羅とみなす。**このツールはあなたのクエリに最も関連する箇所を取得します。ドキュメント全体でそのトピックのすべての該当箇所を見つけたことを保証するものではありません。網羅性が重要な場合は、“このドキュメントにそのトピックを扱っている他のセクションはありますか?“と追加で尋ねてください。
**追加質問で済むのに新しいセッションを始める。**会話履歴を活用しましょう。同じドキュメントを再アップロードし、以前の回答を踏まえた質問を再び尋ねるのは、セッションがすでに保持しているコンテキストを無駄にします。
プロフェッショナル向けのユースケース解説(法務契約レビュー、財務分析、RFPドキュメントなど)については、Chat with PDF:7つのプロフェッショナルユースケース をご覧ください。どのツールがワークフローに合うか検討している場合は、PDFチャットツール比較 でFlowHunt、ChatPDF、Adobe、Humataを直接比較しています。