


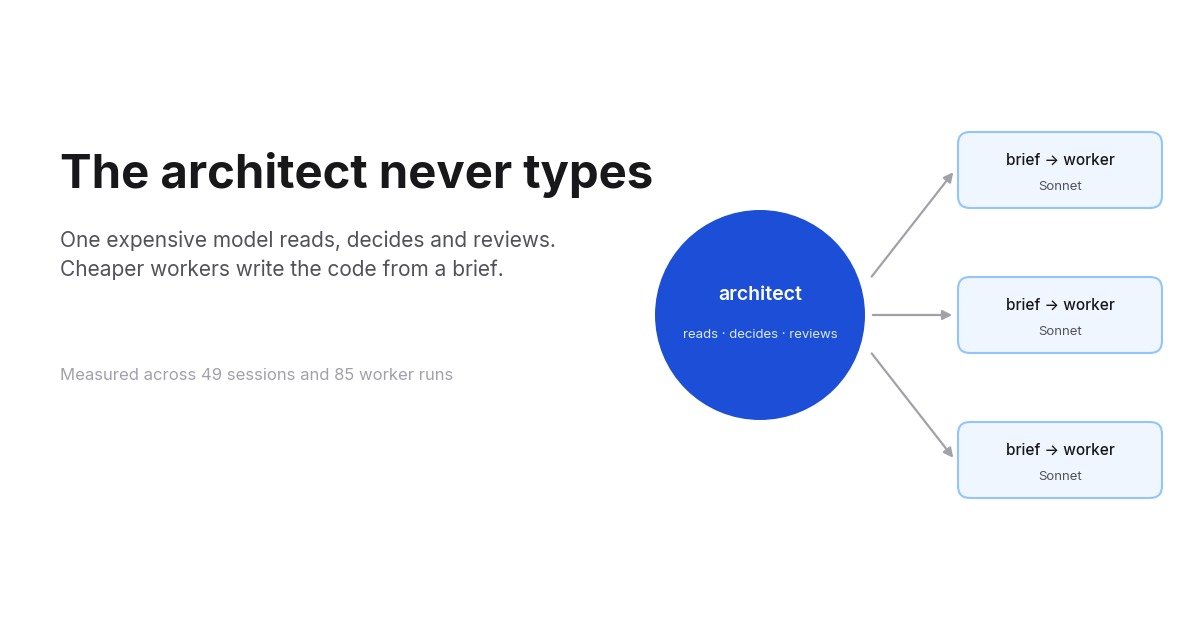
Die Kurzfassung
- Fünf Wochen lang habe ich meinen Coding-Agenten geteilt betrieben: Das Hauptmodell, Opus und später Fable, liest, entscheidet und prüft, und ein Worker-Agent schreibt den Code nach einem schriftlichen Briefing. Ich nenne es das Architekten-Muster, und es ist inzwischen ein öffentlicher Skill: architect-skill auf GitHub , MIT-lizenziert.
- Das Hauptmodell hörte auf zu tippen. Über 49 Architekten-Sessions bearbeitete es eine Quelldatei 6 Mal in 1.467 Prompts. In 275 normalen Sessions über dieselben Wochen bearbeitete es 244 Dateien in 3.081 Prompts. Das sind 0,4 gegenüber 7,9 pro 100 Prompts.
- Die Gesamt-Token pro Prompt sanken nicht. Sie stiegen, deutlich, zwei Wochen lang, und kamen dann dorthin zurück, wo normale Sessions liegen. Was sich änderte, ist, wer sie ausgab: Der Opus-Anteil an den Worker-Token ging von 100 % auf etwa 4 %, und seit dem 14. September kostet ein Prompt in einer Architekten-Session 364k gewichtete Token im Hauptmodell, 205k bei Sonnet-Workern und 80k bei Opus-Workern.
- Genau diese Aufteilung ist es, auf die es bei einem Abo ankommt. Claude Max rechnet sein wöchentliches Alle-Modelle-Limit mit dem Satz des jeweiligen Modells ab, ein Sonnet-Token zieht es also mit 40 % dessen, was ein Opus-Token zieht, und Fable hat ein eigenes, engeres Wochenlimit, das kein Worker berührt.
- Ich habe außerdem versucht, die Worker über ein headless Claude Code an DeepSeek zu routen. Zu Listenpreisen kostete derselbe Verkehr 10 $ statt 202 $ bei Sonnet oder 505 $ bei Opus. Bei einem Abo existiert diese Ersparnis nicht, weil das Abo schon bezahlt ist. Ich habe es gelassen. Wenn du pro Token zahlst, lies diesen Abschnitt trotzdem, denn die Zahlen sind der Punkt.
Dies ist der dritte Beitrag einer Serie. Der erste hat gemessen, was eine einzige Einstellung mit einem Kontextfenster gemacht hat, 17 % weniger Token , und der zweite erklärt, was ein Kontextfenster kostet und warum. Dieser hier handelt vom anderen Hebel: nicht davon, wie groß der Kontext ist, sondern davon, welches Modell ihn hält.
Was das Muster ist
Eine Coding-Agent-Session erledigt zwei Arten von Arbeit. Sie denkt: liest die Codebasis, arbeitet heraus, was zu ändern ist, entscheidet über Namen und Signaturen und Randfälle, prüft den Diff. Und sie tippt: schreibt den Code, führt die Testdatei aus, behebt den Lint. Das Denken ist der Teil, in dem ein Frontier-Modell seinen Preis verdient. Das Tippen nicht. Das meiste davon ist durch die Entscheidung davor festgelegt, und ein kleineres Modell führt einen entschiedenen Plan etwa so gut aus wie ein großes.
Der Skill teilt die Session also auf. Das Hauptmodell ist der Architekt. Es erledigt alles in der Hauptschleife, außer eine Quelldatei zu bearbeiten:
- Die Anforderung hinterfragen und die Codebasis erkunden.
- Die Design-Entscheidungen treffen: Vorgehen, Datenfluss, Namen, Signaturen, Randfälle. Das nächstgelegene existierende Muster, das zu spiegeln ist. Die kleinste Änderung, die die Grundursache behebt.
- In Slices zerlegen, die disjunkte Dateimengen besitzen.
- Pro Slice ein Implementierungs-Briefing schreiben.
- Den zurückkommenden Diff prüfen, die Gates laufen lassen, committen.
Der Worker ist ein Subagent mit einem frischen Kontextfenster. Er bekommt das Briefing und sonst nichts, schreibt den Code, führt die im Briefing genannten Testdateien aus und liefert einen kurzen strukturierten Bericht zurück. Danach wird sein Kontext weggeworfen. Er wird nie Teil der Historie der Hauptsession, was wichtiger ist, als es klingt: Alles, was die Hauptsession liest, wird bei jedem späteren Aufruf erneut gesendet, ein Worker, der zwölf Dateien und ein Test-Log in seinem eigenen Kontext liest, hält das also alles von der Rechnung des Architekten fern.
Das Briefing ist der ganze Vertrag. Meines hat sieben Felder, und der Skill dreht sich vor allem darum, sie gut auszufüllen:
## Implementation brief: <slice>
Goal: one sentence, observable outcome
Context: what exploration found: excerpts, the pattern to mirror, line anchors, gotchas
Files: paths to create/modify, exclusive ownership for this slice
Design: the decided approach: data flow, names, signatures, edge cases
Constraints: project rules that apply: style, layers, security
Out of scope: what not to touch, including files owned by other slices
Verify: exact commands and expected outcome
Ein Briefing enthält Entscheidungen, keine Optionen. Wenn ich noch zwischen zwei Vorgehensweisen abwäge, bin ich nicht bereit zu delegieren.
Es gibt eine Ausnahme. Delegation hat einen festen Overhead: das Briefing schreiben, den Worker starten, den Bericht lesen, den Diff prüfen. Ein Tippfehler-Fix, ein Konfigurationswert, ein Versions-Bump, das Löschen eines toten Schlüssels, ein Einzeiler-Fix und sein Regressionstest: Bei solchen Dingen bearbeitet der Architekt direkt, weil das Briefing mehr kosten würde als die Änderung. Der Maßstab sind die Kosten, nicht die Zeilenzahl. Sobald die Änderung ein Design-Urteil erfordert oder einen Pfad berührt, den das Repo als kritisch markiert, geht sie an einen Worker.

Bereit, Ihr Geschäft zu erweitern?
Starten Sie heute Ihre kostenlose Testversion und sehen Sie innerhalb weniger Tage Ergebnisse.
Warum ein Abo die Rechnung verändert
Wenn du pro Token zahlst, ist der Fall einfach. Opus 5 liegt laut Liste bei 5 $ pro Million Input-Token und 25 $ pro Million Output; Sonnet 5 bei 2 $ und 10 $. Jeder Token Implementierung, der von Opus zu Sonnet wandert, kostet 40 % dessen, was er vorher kostete.
Ich zahle ein Abo, und dort ist der Fall anders und, wie ich finde, stärker. Claude Max hat zwei Wochenlimits, nicht eines: ein Limit über alle Modelle, das jeder Token mit dem Satz seines Modells zieht, und ein separates, engeres Limit, das nur Fable zieht. Opus hat kein eigenes Limit. Das gibt der Aufteilung zwei Effekte. Arbeit, die ein Sonnet-Worker erledigt, zieht das geteilte Limit mit 40 % des Satzes, den ein Opus-Worker hätte, zwei Drittel der Token einer Session auf Sonnet zu verlagern lässt die Woche also länger halten, selbst wenn die Gesamttokenzahl unverändert bleibt. Und wenn der Architekt Fable ist, ist jeder Token, den er nicht mit Tippen verbringt, ein Token, das auf dem Limit bleibt, das zuerst ausgeht. Selbst wenn das Architekten-Muster also exakt dieselbe Anzahl Token verbrauchte wie eine normale Session, würde immer noch entscheiden, wer sie ausgibt, wann die Woche endet.
Dieses „selbst wenn“ hat sich als ziemlich belastbar erwiesen.
Was die Transkripte sagen
Claude Code schreibt jede Session in ein JSONL-Transkript und jeden Worker-Lauf in eine Nachbardatei im Verzeichnis der Session. Ich habe alle seit dem 19. August: 324 interaktive Sessions mit drei oder mehr Prompts, von denen 49 das Muster nutzten, das heißt, sie starteten einen Implementer-Agenten oder sandten ein Briefing an einen. Die Token werden so gewichtet, wie die Rechnung es tut: frischer Input mit 1, Cache-Writes mit 1,25 oder 2, Cache-Reads mit 0,1. CI-Läufe sind ausgeschlossen.
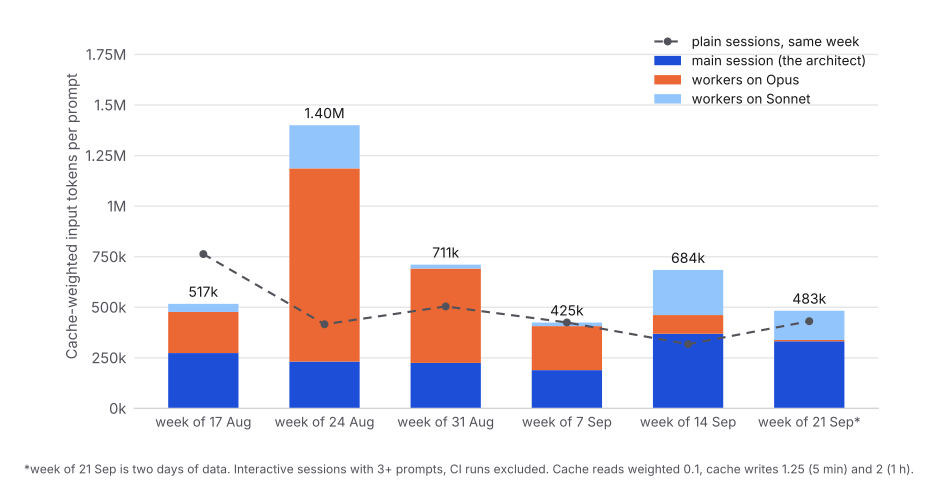
Lies es von links nach rechts, und in den ersten zwei Wochen ist es keine Erfolgsgeschichte.
In der Woche des 24. August kostete eine Architekten-Session 1,40 Mio. gewichtete Token pro Prompt. Normale Sessions kosteten in derselben Woche 0,42 Mio. Dreieinhalb Mal mehr, und fast der ganze Überschuss war orange: Opus-Worker. Ich hatte den Workern ein gutes Modell und keine Regeln gegeben, und sie verhielten sich wie ein gutes Modell ohne Regeln. Der mediane Opus-Worker-Lauf in dieser Woche waren 176 Turns. Mehrere fuhren die vollständige Backend-Test-Suite, was etwa 100 KB Ausgabe in einen Kontext legt, der bei jedem Turn danach erneut gesendet wird. Eine Session mit sechs Workern am 14. September, nachdem ich bereits begonnen hatte, die Dinge zu straffen, verbrannte immer noch 245 Mio. Input-Token über 1.585 Turns, um etwa sechstausend Zeilen Diff zu erzeugen. Prompt-Caching funktionierte die ganze Zeit mit einer Trefferquote von 91,6 %. Die Rechnung war das Volumen, nicht der Preis.
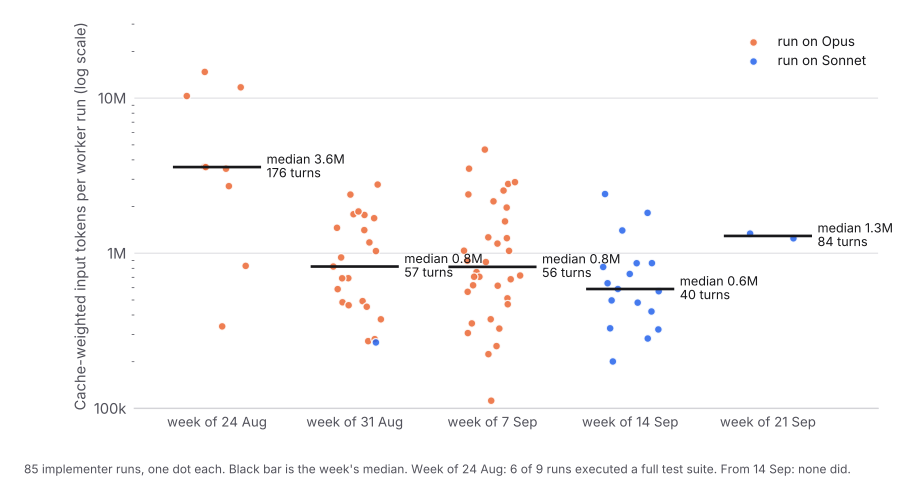
Der Worker-Streifen zeigt, wo die Regeln gelandet sind. Drei von ihnen haben den Großteil der Arbeit getan, und ich habe sie in die Agenten-Definitionen statt ins Briefing geschrieben, damit sie gelten, ob ich mich daran erinnere oder nicht:
- Ein Worker führt nie eine vollständige Test-Suite aus. Er führt die Testdateien aus, die sein Briefing nennt. Der Architekt fährt die Gates.
maxTurnsist in der Agenten-Definition begrenzt, 140 für Sonnet und 160 für Opus. Ein Slice, der 250 Turns braucht, wurde falsch gebrieft.- Ein Slice bleibt unter etwa zwölf Dateien und das Briefing unter etwa 8 KB. Das Briefing wird in jedem Turn erneut gesendet.
In der Woche des 31. August lag der mediane Worker-Lauf bei 57 Turns und 0,8 Mio. gewichteten Token. Ab dem 14. September, als ich die Standardroute auf Sonnet umstellte, waren es 40 Turns und 0,6 Mio., und seitdem hat kein Worker mehr eine vollständige Suite gefahren.
Die Summe pro Prompt folgte: 711k, 425k, 684k, 483k über die letzten vier Wochen, gegenüber normalen Sessions mit 505k, 425k, 318k, 431k. Architekten-Sessions kosten inzwischen etwa das, was normale Sessions kosten. In zwei der vier Wochen etwas mehr, in einer etwas weniger. Was sie dafür liefern, zeigen die nächsten beiden Charts.
Abonnieren Sie unseren Newsletter
Erhalten Sie die neuesten Tipps, Trends und Angebote kostenlos.
Das Hauptmodell hörte auf zu tippen
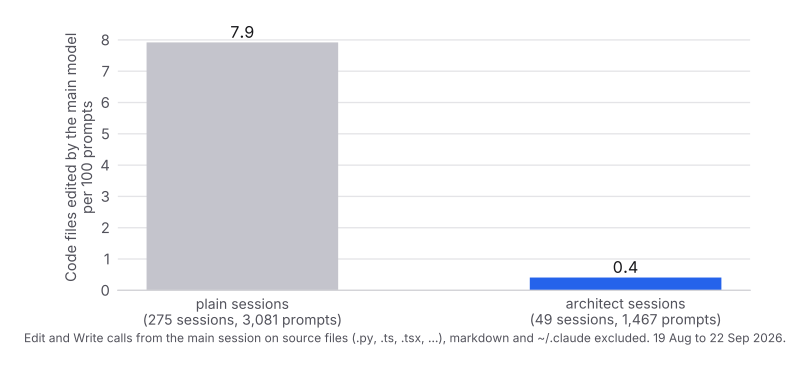
Das ist die Zahl, die ich ändern wollte, und sie hat sich geändert. In normalen Sessions machte das Hauptmodell 244 Edit- oder Write-Aufrufe auf Quelldateien über 3.081 Prompts. In Architekten-Sessions waren es 6 über 1.467. Die 6 sind alles Ausnahmen für kleine Änderungen, die ich erklären kann.
In der Zwischenzeit waren die Worker produktiv. Die 85 Worker-Läufe machten 2.510 Bearbeitungen an Quelldateien. Zählt man Hauptschleife und Worker zusammen, erzeugte eine Architekten-Session 2.516 Code-Änderungen aus 1.467 Prompts; normale Sessions erzeugten 943 aus 3.081. Pro Code-Änderung gab eine Architekten-Session insgesamt 403k gewichtete Token aus und 330k auf dem Modell der Opus-Familie. Eine normale Session gab 1.410k und 1.324k aus. Bei diesem Vergleich möchte ich vorsichtig sein, denn die beiden Populationen sind nicht dieselbe Arbeit: Eine Session wird als Architekt klassifiziert, weil sie Code delegiert, Architekten-Sessions sind also konstruktionsbedingt coding-lastig, und normale Sessions enthalten Recherche, Reviews und Debugging, die nie etwas bearbeiten. Lies es als „das Muster bekommt viel Code pro Token geschrieben“, nicht als Effizienzbehauptung um den Faktor vier.
Die sauberere Aussage ist die Modell-Aufteilung. Seit dem 14. September kostet ein Prompt in einer Architekten-Session 364k gewichtete Token in der Hauptschleife, 205k bei Sonnet-Workern und 80k bei Opus-Workern. Der Anteil der Opus-Worker an allen Worker-Token lag im August bei 100 % und in der Woche des 21. September bei etwa 4 %. Auf einem Max-Plan bedeutet das, dass das geteilte Wochenlimit für fast die gesamte Implementierungsarbeit mit Sonnets Satz statt mit Opus’ Satz gezogen wird und nichts davon das Fable-Limit berührt.
Zwei Dinge wurden nicht besser, und das sage ich lieber, als die Charts etwas anderes implizieren zu lassen. Der eigene Kontext der Hauptsession schrumpfte nicht: Architekten-Sessions komprimierten 8,7 Mal pro 100 Prompts gegenüber 4,7 bei normalen Sessions, weil der Architekt viel liest, bevor er briefed. Und das Muster ist bei kleinen Aufgaben in Wanduhr-Zeit langsamer, weil der Start und der Bericht eines Workers Minuten sind, die du nicht zahlst, wenn du die Änderung einfach selbst machst. Die Ausnahme für kleine Änderungen existiert, weil die erste Version des Skills keine hatte, und ich habe mir dabei zugesehen, wie ich ein 3-KB-Briefing für eine Änderung über zwei Zeilen schrieb.
Der DeepSeek-Umweg
Als die Worker Sonnet waren, lautete die naheliegende nächste Frage, ob sie überhaupt ein Claude-Modell sein mussten. Vom 13. bis 18. September richtete ich den Worker auf DeepSeek V4.1 Flash über ein headless Claude Code mit ANTHROPIC_BASE_URL auf einen kompatiblen Endpoint, erst über OpenRouter und dann nativ. Gleiches Briefing-Format, gleiches Berichtsformat, gleicher Architekt. 2.732 Aufrufe, 431 Mio. Input-Token, von denen 88 % Cache-Reads waren, 1,7 Mio. Output-Token.
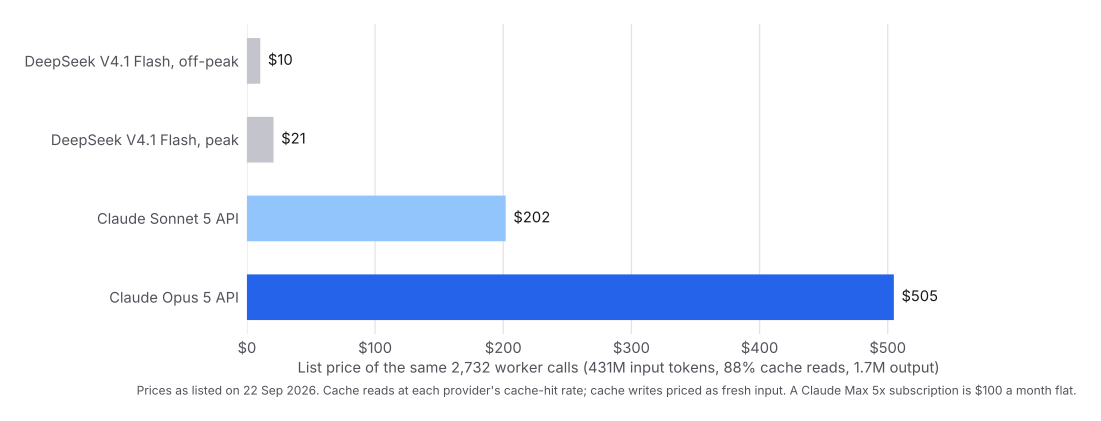
Zu den Listenpreisen vom 22. September kostet dieser Verkehr etwa 10 $ bei DeepSeek außerhalb der Spitzenzeit, 21 $ in der Spitzenzeit, 202 $ über die Sonnet-API und 505 $ über die Opus-API. Wenn ich pro Token zahlte, wäre das die Schlagzeile des Beitrags und ich hätte es behalten.
Ich zahle nicht pro Token, und das ist das ganze Argument. Ein Max-Abo kostet 100 $ pro Monat, egal ob ich 30 % des Wochenlimits oder 100 % nutze. Den Worker-Verkehr auf DeepSeek zu verlagern, hat diese Rechnung um keinen Cent gesenkt. Es fügte eine zweite Rechnung von 10 $ bis 21 $ pro Woche obendrauf hinzu, um Kapazität in einem Plan zu sparen, dessen Kapazität ich bereits bezahlt hatte. Ich hatte „günstiger als die API“ mit „günstiger als das, was ich zahle“ verwechselt, und das ist nicht dasselbe, wenn das, was du zahlst, pauschal ist. Der richtige Vergleich für einen Abonnenten ist DeepSeek gegen ein zweites Abo, und dort kostet ein zweiter Claude-Plan oder ein ChatGPT-Plan mit Codex etwa so viel wie ein Monat moderater DeepSeek-Nutzung und bringt sein eigenes Wochenlimit, sein eigenes Modell und keine Abrechnung, auf die man achten muss.
Die Qualität war die andere Hälfte. Fünf Backend-Slices kamen sauber zurück und wurden unverändert committet. Ein Frontend-Slice entfernte ein exportiertes Symbol und ließ jeden seiner Konsumenten unangetastet, sodass der Baum nicht kompilierte und ein späterer Slice es aufräumen musste. Genau das ist der Fehler, den ein Modell hat, das eine Spezifikation ausführt, und den ein Modell nicht hat, das die Form einer Komponente aus ihren Geschwistern ableitet, und der Skill sagt das inzwischen auch: Änderungen an gemeinsam genutzten API-Oberflächen gehen an Sonnet, und die Worker-Regel lautet „niemals ein exportiertes Symbol entfernen oder umbenennen, ohne im selben Lauf jeden Konsumenten zu migrieren“. DeepSeek Flash ist ein guter Ausführender. Das Architekten-Muster braucht einen Worker, der bemerkt, wenn das Briefing die Konsumenten zu niedrig gezählt hat, und das ist das eine, was ein Briefing nicht liefern kann.
Die Routing-Tabelle hat heute also zwei Zeilen. Routinearbeit, Backend-Arbeit gegen ein detailliertes Briefing mit Tests, die erfüllt werden müssen, Frontend-Arbeit, die einer bestehenden Design-Grammatik folgt, und jede Änderung an einer gemeinsam genutzten API-Oberfläche gehen an sonnet-implementer. Arbeit, deren Schwierigkeit im Denken liegt, geht an opus-implementer: ein Async-Race, ein Multi-Site-Refactoring, dessen Korrektheit von Stellen abhängt, die das Briefing nicht aufzählen kann, eine Backfill-Migration, die kein einzelner Test beweist. Route nach Form, nie nach Risiko. Risiko verändert, wie hart der Diff geprüft wird und ob ein Mensch ihn unterschreibt. Es verändert nie, wer ihn schreibt.
Die Review-Schleife, in der das Muster gewinnt oder verliert
Der Bericht eines Workers ist eine Behauptung. Die Review-Schleife des Skills ist kurz, und jede Zeile stammt daher, dass ich verbrannt wurde:
- Lies den Bericht und den tatsächlichen
git diff. Gleiche den Diffstat, den der Worker zitiert, mit dem ab, den du siehst. - Führe die entscheidende Verifikation selbst erneut aus, wenn die Behauptung zählt.
- Ein Problem gefunden? Schicke die Korrektur an denselben Worker. Er hat seinen Kontext noch und macht dort weiter, wo er aufgehört hat. Repariere es nicht von Hand, starte ihn nicht neu.
- Zwei fehlgeschlagene Korrekturen bedeuten, dass das Briefing zu ungenau war, nicht dass das Modell zu klein ist. Zerlege, pack den fehlenden Auszug in Context, starte erneut. Steige nicht auf ein größeres Modell um, denn es wird dasselbe Missverständnis flüssiger umsetzen.
- Führe die abgegrenzten Gates aus, bevor du irgendetwas annimmst: die berührten Tests, den Linter auf den berührten Dateien, welches Konventionsskript das Repo auch führt.
In den Transkripten habe ich etwa eine Korrektur pro Worker-Lauf gesendet, 52 über 85 Läufe, und 7 Opus-Läufe erreichten ihr Limit von 160 Turns, jeder einzelne bei einem Slice, den ich heute aufteilen würde. Das sind die zwei Zahlen, die ich beobachte. Wenn die Korrekturen pro Lauf steigen, werden meine Briefings nachlässig. Wenn Worker das Limit erreichen, sind meine Slices zu groß.
Was man daraus mitnehmen sollte
Wenn du pro Token zahlst: Setze das teure Modell auf Entscheidungen und Review, setze ein günstiges auf die Implementierung, und berechne deinen Worker-Verkehr zu Listenpreisen, bevor du entscheidest, welches günstige. Das Balkendiagramm mit den vier Werten ist das Argument.
Wenn du ein Abo zahlst: Das Muster senkt deine Tokenzahl nicht. Es verschiebt die Implementierungs-Token auf das Modell, das das geteilte Wochenlimit am langsamsten zieht, behält das Fable-Limit für die Arbeit, die nur Fable machen sollte, und hindert dein teuerstes Modell daran, seine Turns mit Tippen zu verbringen. Füge nicht nebenbei eine abgerechnete API hinzu, um Kapazität zu „sparen“, die du bereits gekauft hast. Wenn dir die Worker-Kapazität ausgeht, kaufe ein zweites Abo.
So oder so waren die Regeln, die es zum Funktionieren brachten, die langweiligen. Keine vollständigen Test-Suites in einem Worker. Turns begrenzen. Kleine Slices, kurze Briefings. Denselben Worker einmal korrigieren, dann das Briefing reparieren.
Der Skill, die drei Agenten-Definitionen und der Guard-Hook liegen unter github.com/LivinTribunal/architect-skill unter MIT. Der begleitende Skill, der dem Worker sagt, wie er Code schreibt, der zu dem Repo passt, in dem er landet, ist grain-skill , und der Beitrag dazu ist Code mit der Maserung .
Methode
Alles, was der Beitrag beschreibt, liegt in github.com/LivinTribunal/architect-skill : der Skill selbst, die Briefing-Vorlage, die Routing-Tabelle, die drei Implementer-Agenten-Definitionen mit ihren Turn-Limits und Kontextregeln und der Guard-Hook. Installiere ihn, und du hast das Setup, aus dem die folgenden Zahlen stammen.
Die Sessions sind Claude-Code-JSONL-Transkripte vom 19. August bis zum 22. September 2026, entrypoint cli, drei oder mehr Nutzer-Prompts. Eine Session wird als Architekt klassifiziert, wenn sie opus-implementer, opus-implementer-xhigh oder sonnet-implementer startete, einen ds-slice-Worker laufen ließ, den Architekten-Skill aufrief oder eine Nachricht mit einem Implementierungs-Briefing an einen General-Purpose-Agenten sandte, was in den frühen Wochen funktionierte, bevor die benannten Agenten existierten. Worker-Läufe sind die Subagenten-Transkripte im Verzeichnis jeder Session. Die Nutzung wird nach Request-ID dedupliziert und gewichtet: frischer Input 1, Fünf-Minuten-Cache-Write 1,25, Ein-Stunden-Cache-Write 2, Cache-Read 0,1. Eine „Code-Änderung“ ist ein Edit- oder Write-Aufruf auf eine Quelldatei wie .py, .ts, .tsx, .js, .sql oder ähnlich, ausgenommen Markdown und alles unter ~/.claude. Die DeepSeek-Preise sind native Listenpreise vom 22. September 2026, außerhalb der Spitzenzeit und in der Spitzenzeit, mit Cache-Reads zum Cache-Treffer-Satz und Cache-Writes als frischer Input bepreist; die Claude-API-Preise sind die veröffentlichten Listenpreise von Opus 5 und Sonnet 5 mit Cache-Reads zu einem Zehntel des Inputs. Die Woche des 21. September umfasst zwei Tage an Daten.
