


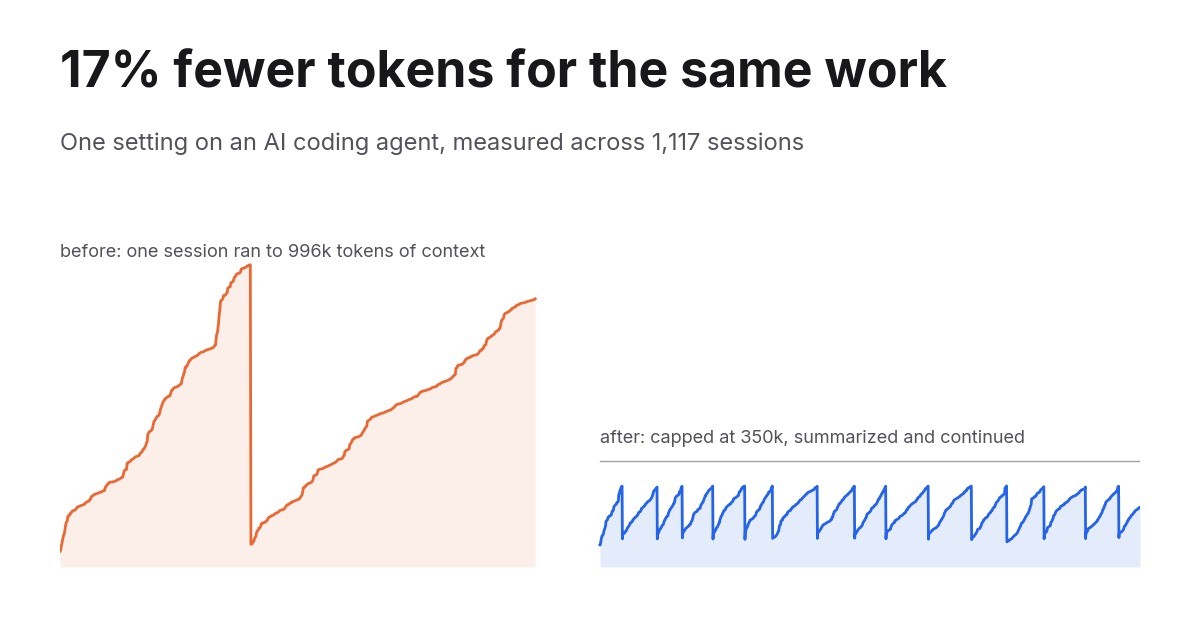
Die Kurzfassung
- Ich betreibe den ganzen Tag einen KI-Coding-Agent auf einem Modell mit einem Kontextfenster von 1M Tokens. Früher wuchsen die Sessions, bis sie es fast gefüllt hatten.
- Ich habe eine Zeile zur Konfiguration hinzugefügt, die eine Session auf 350.000 Tokens Kontext begrenzt, bevor sie sich selbst zusammenfasst und weitermacht.
- Gemessen über 1.117 Session-Transkripte: 17 % weniger Tokens bei gleicher Anzahl Prompts, und in den langen Sessions, in denen die Obergrenze tatsächlich greift, 55 % weniger.
Unten folgen die Methode, jedes Diagramm und das, was du dafür bezahlst – damit du entscheiden kannst, ob es auf dein Setup passt.
Warum ein 1M-Fenster teurer ist, als es aussieht
Eine Unterhaltung mit einem Modell ist zustandslos. Jede Anfrage trägt die gesamte Historie mit: den System-Prompt, jede Tool-Definition, jede Datei, die der Agent gelesen hat, jedes Tool-Ergebnis, jede Nachricht. Kein Delta. Alles, jedes Mal.
Eine Session, die auf 900.000 Tokens angewachsen ist, zahlt also beim nächsten Aufruf für 900.000 Tokens Input – und beim übernächsten wieder. Zug 400 leistet nicht mehr Arbeit als Zug 4. Er kostet nur ein Vielfaches.
Prompt-Caching mildert das. Tokens, die das Modell schon gesehen hat, werden mit etwa einem Zehntel des normalen Input-Preises berechnet. Dieser Rabatt ist real, er macht lange Sessions überhaupt erst tragfähig – und er ist auch der Grund, warum niemand das Problem anschaut. In meinen Daten waren 98 % aller Input-Tokens Cache-Reads. Ein Zehntel einer sehr großen Zahl war immer noch die größte Position auf der Rechnung.
Die Frage ist nicht, ob deine Historie gecacht wird. Die Frage ist, wie groß sie werden darf, bevor etwas sie zurücksetzt.

Bereit, Ihr Geschäft zu erweitern?
Starten Sie heute Ihre kostenlose Testversion und sehen Sie innerhalb weniger Tage Ergebnisse.
Was ich geändert habe
Der Agent ist Claude Code mit Opus im 1M-Kontextfenster. Die Einstellung heißt autoCompactWindow in ~/.claude/settings.json. Wenn eine Session diese Tokenzahl erreicht, fasst der Agent die Unterhaltung zusammen und macht mit der Zusammenfassung weiter.
{
  "autoCompactWindow": 350000
}
Ich hatte sie nie gesetzt, also liefen die Sessions, bis sie sich dem vollen Fenster näherten. Über vier Tage habe ich drei Werte ausprobiert:
| Datum | Einstellung |
|---|---|
| 14. September | 250.000 |
| 15. September | 300.000 |
| 18. September | 350.000 |
Wie ich gemessen habe
Claude Code schreibt jede Session als JSONL-Transkript unter ~/.claude/projects/, inklusive des Token-Verbrauchs jedes API-Aufrufs. Ich habe alle 1.117 davon geparst, über fünf Wochen vom 19. August bis zum 22. September, nach Request-ID dedupliziert und nur interaktive Sessions behalten. Läufe in GitHub Actions nutzen dasselbe Konto, können aber nicht von einer Einstellung auf meinem Laptop beeinflusst werden, also sind sie ausgeschlossen.
Rohe Token-Summen sind für sich genommen irreführend. Eine geschäftige Woche schlägt eine ruhige Woche, egal was du änderst. Deshalb ist jede Zahl unten cache-gewichtet, also so, wie der Zähler tatsächlich abliest: frischer Input mit 1x, Cache-Writes mit 1,25x (5-Minuten-Cache) oder 2x (1-Stunden-Cache), Cache-Reads mit 0,1x. Und jeder Vergleich ist auf die geleistete Arbeit normalisiert, entweder auf die Prompts, die ich getippt habe, oder auf die API-Aufrufe des Agents.
Abonnieren Sie unseren Newsletter
Erhalten Sie die neuesten Tipps, Trends und Angebote kostenlos.
Zwei Sessions, derselbe Agent
Das ist der Mechanismus in einem Bild. Links eine echte Session vom 3. September, vor der Obergrenze. Rechts eine echte Session vom 15. September, danach.
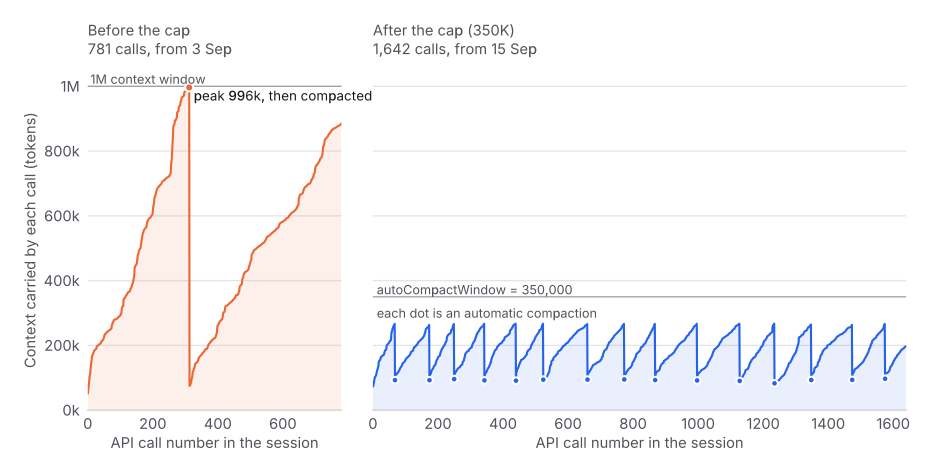
Die Session links lief über 781 Aufrufe. Sie stieg auf 996.000 Tokens Kontext, stieß an die Wand des 1M-Fensters, komprimierte einmal und stieg dann direkt wieder auf 880.000. In der zweiten Hälfte dieser Session las jeder einzelne Aufruf mehr als eine halbe Million Tokens erneut.
Die Session rechts lief über 1.642 Aufrufe, mehr als doppelt so lang, und trug nie mehr als 270.000. Sie komprimierte fünfzehn Mal. Jede Komprimierung ist ein Punkt.
Die Wochenzahlen
Nur interaktive Sessions. Die Balken zeigen cache-gewichtete Input-Tokens pro API-Aufruf, die fairste einzelne Zahl, weil es keine Rolle spielt, wie viel ich in einer bestimmten Woche gearbeitet habe.
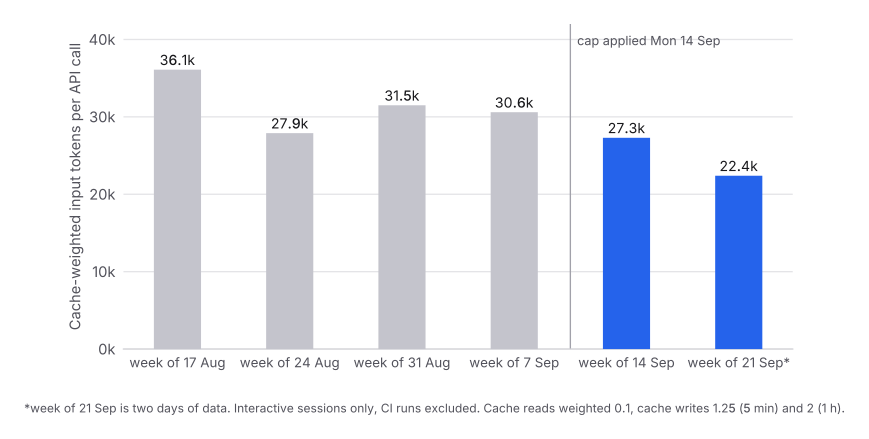
Der sauberste Vergleich im Datensatz ist die Woche vom 7. September gegen die Woche vom 14. September, weil ich sie nicht ausgewählt habe. Sie lagen einfach auf beiden Seiten der Änderung, und ich habe in beiden fast genau gleich viele Prompts getippt.
| Woche vom | Prompts | API-Aufrufe | Cache-gewichteter Input | Pro Aufruf |
|---|---|---|---|---|
| 7. Sep | 971 | 11.364 | 348,1M | 30,6k |
| 14. Sep | 968 | 10.555 | 288,5M | 27,3k |
971 Prompts gegen 968. Effektiver Input runter von 348,1M auf 288,5M. Das sind 17 % weniger bei derselben Menge an Prompting. Die zwei Tage der folgenden Woche lagen bei 22,4k pro Aufruf, noch niedriger.
Wohin das Geld floss
Teilt man jeden API-Aufruf danach auf, wie viel Kontext er trug, ist der Mechanismus direkt sichtbar.
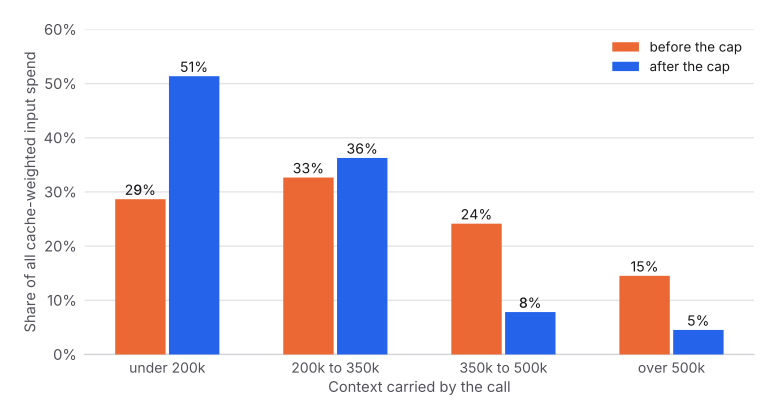
Vor der Obergrenze gingen 39 % von allem, was ich ausgegeben habe, in Aufrufe, die mehr als 350.000 Tokens Historie hinter sich herzogen. Diese Aufrufe leisteten nicht mehr Arbeit als die anderen. Es war dieselbe Arbeit mit mehr Gepäck. Nach der Obergrenze liegt dieser Anteil bei 12 %.
Hat die Obergrenze gehalten
Ein Punkt pro Session, platziert beim größten Kontext, den diese Session je trug.
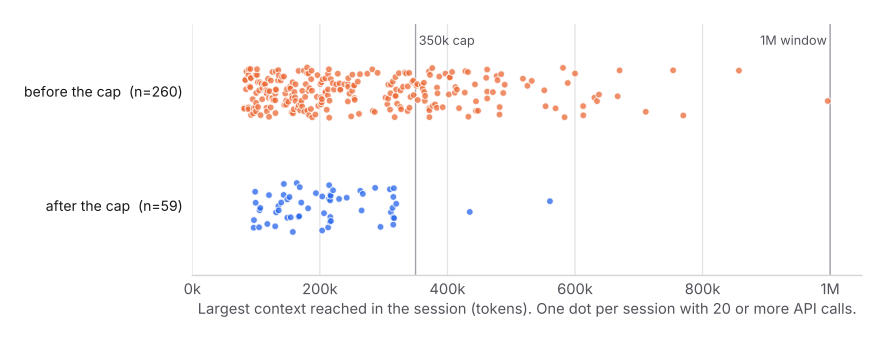
Zwei Sessions in den ersten zwei Tagen liefen trotzdem über die Obergrenze hinaus, auf 434.000 und 561.000, und ich habe nicht herausgefunden, warum. Seit die Einstellung 350.000 am 18. September gesetzt wurde, hat keine Session sie überschritten. Der Schwanz von Sessions zwischen 500k und 1M, wo der meiste Verschleiß lag, ist verschwunden.
Was es ohne die Obergrenze gekostet hätte
Um eine Gesamtsumme zu bekommen, habe ich jede Session, die nach der Änderung startete, so nachgespielt, als wäre der weggefallene Kontext nie zusammengefasst worden und würde bei jedem späteren Aufruf weiter erneut gelesen, begrenzt auf das 1M-Fenster.
| Cache-gewichteter Input | |
|---|---|
| Tatsächlich, 73 Sessions, 9.675 Aufrufe, 55 Komprimierungen | 216,8M |
| Dieselben Sessions ohne die Obergrenze | 479,2M |
| Vermieden | 262,5M oder 55 % |
Die Session rechts im ersten Diagramm macht davon allein 118,5M aus. Ein langes Refactoring, das sonst seine letzten paar hundert Aufrufe damit verbracht hätte, jeweils fast eine Million Tokens erneut zu lesen.
Behandle die 55 % als das optimistische Ende. Ohne die Obergrenze hätte ich eine Session nicht wirklich stundenlang bei 900k mahlen lassen; irgendwann hätte ich sie von Hand geleert, was die Kosten ebenfalls zurücksetzt. Das konservative Ende ist die beobachtete Pro-Aufruf-Zahl, 30,6k runter auf 22,4k, also grob 20 % bis 27 %. Die Wahrheit liegt irgendwo dazwischen.
Was es dich kostet
Das ist nicht kostenlos, und wer es empfiehlt, sollte das auch sagen.
Warten. 67 Komprimierungen seit der Änderung, im Median etwa drei Minuten jede. Rund 3,4 Stunden, in denen man zusieht, wie eine Zusammenfassung geschrieben wird, verteilt über acht Tage.
Etwas Nacharbeit. Die Komprimierung lässt viel fallen. Bei der Einstellung 350K brachte die mediane Komprimierung eine 318.000-Token-Session auf 24.000. Der Agent verliert Details und baut sie manchmal neu auf: Dateien, die innerhalb derselben Session erneut gelesen wurden, gingen von 11,5 % der Reads vor der ersten Komprimierung auf 20,5 % danach. Die Stichprobe hinter der zweiten Zahl ist klein, lies sie also als Richtung, nicht als Messung.
Die Wahl des Schwellenwerts zählt. Bei 250K erreichten 36 % meiner langen Sessions eine Komprimierung. Bei 350K waren es 12 %, während die Obergrenze weiter hielt. Setzt du sie zu niedrig, zahlst du die drei Minuten und die Nacharbeit immer wieder für eine Ersparnis, die du längst eingefahren hattest.
So richtest du es ein
Claude Code. Füge autoCompactWindow in ~/.claude/settings.json hinzu. Bei einem 1M-Kontextmodell war 350.000 der beste der drei Werte, die ich ausprobiert habe. Bei einem 200K-Modell skaliere herunter und starte bei etwa 120.000 bis 140.000. Neue Sessions übernehmen den Wert; eine bereits laufende Session behält den alten.
Andere Agents. Suche nach derselben Idee unter anderem Namen: ein Komprimierungs-Trigger, ein Kontextlimit, ein Schwellenwert für Zusammenfassen-und-Weitermachen. Gibt es keinen, ist die manuelle Variante, die Session öfter zu leeren, als es sich natürlich anfühlt. Der Instinkt, eine lange Session den ganzen Tag am Leben zu halten, weil sie “das Projekt kennt”, ist der teure.
Was auch immer du nutzt: zwei Gewohnheiten bringen mehr als jede Einstellung. Halte dauerhaften State in Dateien statt in der Unterhaltung, damit der Agent eine Datei günstig erneut lesen kann, statt für immer jede frühere Antwort mitzuschleppen. Und schiebe leseintensive Arbeit an Subagents mit ihrem eigenen kurzlebigen Kontext, damit die zwanzig Dateien, die sie lesen, gar nicht erst in die Hauptsession gelangen.
Wenn du ein wöchentliches Limit hast
Wenn du ein Abo mit wöchentlichem Nutzungslimit statt einer Abrechnung pro Token bezahlst, ist das der Hebel mit dem besten Verhältnis von Aufwand zu Wirkung, den ich gefunden habe. Eine Zeile JSON, keine Änderung an deiner Arbeitsweise, und dasselbe Limit reicht messbar weiter. In meinem Fall kostete dasselbe wöchentliche Prompting-Volumen 17 % weniger, und die langen Sessions kosteten etwa die Hälfte.
Weiterlesen
Kontextfenster werden als Kapazität verkauft. Sie verhalten sich wie ein laufender Zähler, der bei jedem Turn für alles berechnet, was du je hineingegeben hast. Wenn du die Mechanik dahinter willst und nicht nur die Einstellung, geht der Begleitartikel durch, was ein Kontextfenster tatsächlich füllt, warum eine lange Session weit mehr kostet als die Arbeit, die sie leistet, und wie Caching, Leeren und Komprimierung jeweils die Rechnung verändern.
