


Die Kurzfassung
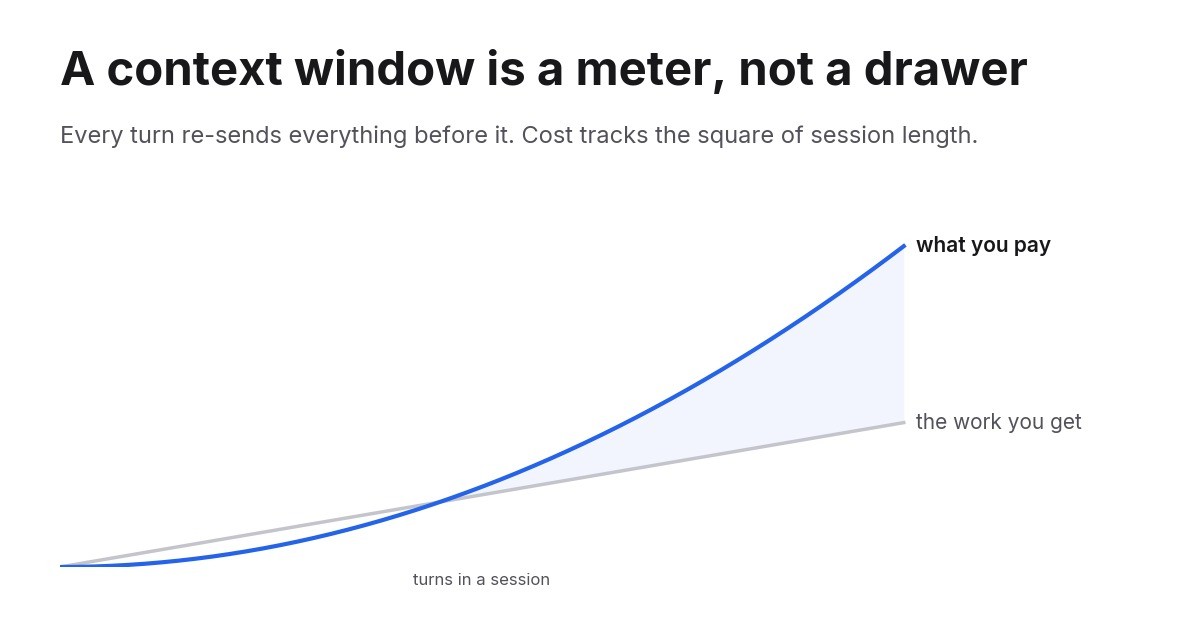
- Ein Modell hat kein Gedächtnis zwischen Requests. Jeder Zug sendet die gesamte Unterhaltung erneut, das Kontextfenster ist also ein Kostenfaktor, der bei jedem Aufruf berechnet wird, kein Ort, den man einmal füllt.
- Dadurch wachsen die Kosten einer Sitzung mit dem Quadrat ihrer Länge. Prompt-Caching senkt den Satz auf etwa ein Zehntel, ändert aber nicht die Form der Kurve.
- Die Lösung ist ein kleineres Fenster, das bewusst zurückgesetzt wird: Begrenzen Sie sein Wachstum, löschen Sie häufiger, entfernen Sie verbrauchte Tool-Ausgaben und halten Sie umfangreiches Lesen in Dateien und Subagenten, wo es nie zurückkommt.
Ein Fenster ist ein Zähler, keine Schublade
Die meisten Menschen stellen sich ein Kontextfenster als Speicher vor. Man legt Dinge hinein, das Modell kann sie sehen, ein größeres Fenster fasst mehr. Dieses Bild ist in genau einer Hinsicht falsch, und der Fehler ist teuer.
Modelle sind zustandslos. Am anderen Ende gibt es keine Sitzung, die Ihre Unterhaltung hält. Jeder Request sendet den gesamten Verlauf erneut: den System-Prompt, jede Tool-Definition, jede Datei, die der Agent gelesen hat, jedes Tool-Ergebnis, jede Nachricht, die einer von Ihnen geschrieben hat. Das Modell liest alles, antwortet und vergisst. Ihre nächste Nachricht sendet alles erneut, plus den neuen Teil.
Das Fenster ist also keine Schublade. Es ist ein Zähler, und sein Stand bei jedem Zug ist die Größe von allem, was Sie bis dahin angesammelt haben.

Bereit, Ihr Geschäft zu erweitern?
Starten Sie heute Ihre kostenlose Testversion und sehen Sie innerhalb weniger Tage Ergebnisse.
Die Rechnung, die niemand vorab macht
Nehmen Sie eine Sitzung, die pro Zug um etwa 1.000 Tokens wächst und 300 Züge läuft. Ihr Kontext steigt von nahe null auf 300.000 Tokens, im Durchschnitt 150.000. Insgesamt gesendete Eingabe: 300 mal 150.000, also 45 Millionen Tokens, um 300 Züge Arbeit zu erhalten.
Lassen Sie nun dieselbe Sitzung dreimal schneller wachsen, auf 900.000. Der Durchschnitt liegt bei 450.000, die Summe bei 135 Millionen – dreimal die Rechnung für genau dieselben 300 Züge.
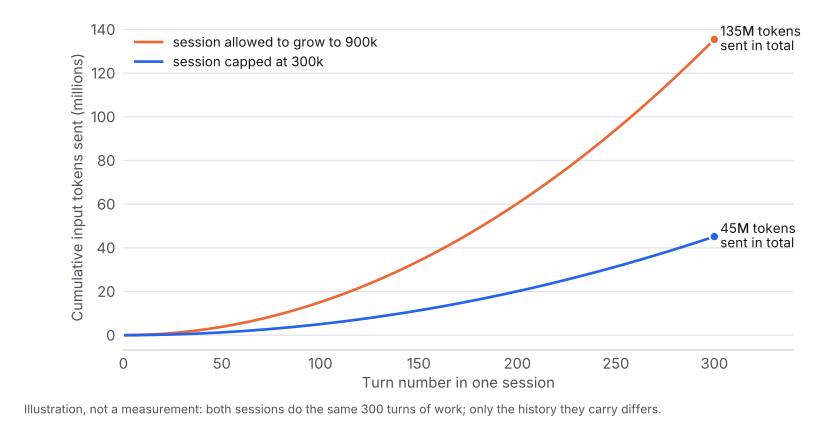
Das ist die Form des Problems. Die Kosten richten sich nicht nach der Arbeit, die Sie bekommen. Sie richten sich danach, wie lange Sie die Sitzung laufen lassen – im Quadrat. Jeder Zug, den Sie hinzufügen, macht jeden zukünftigen Zug teurer. Deshalb kann die letzte Stunde einer langen Sitzung mehr kosten als die ersten vier.
In Geld ausgedrückt, zum Listenpreis von Claude Opus 5 von 5 $ pro Million Eingabe-Tokens und wenn alles nach dem ersten Zug aus dem Cache zu einem Zehntel davon bedient wird: Die begrenzte Sitzung kostet etwa 22 $, die unbegrenzte etwa 68 $ – für dieselbe Arbeit. Bei einem Abonnement sehen Sie keine Dollar, sondern dass das Wochenlimit früher aufgebraucht ist.
Caching ändert den Satz, nicht die Kurve
Prompt-Caching ist der Grund, warum lange Agentensitzungen überhaupt machbar sind. Der Anbieter hält Ihr Unterhaltungspräfix warm und berechnet nur einen Bruchteil für das erneute Lesen.
In Anthropics API liegen die Multiplikatoren bei 1,25x des Basis-Eingabepreises für das Schreiben in den Fünf-Minuten-Cache, 2x für den Ein-Stunden-Cache und etwa 0,1x für das Lesen. Ein Schreibvorgang in den Fünf-Minuten-Cache bezahlt sich beim zweiten Request selbst. Jeder ernsthafte Agenten-Harness macht das automatisch, und es funktioniert: Über fünf Wochen meiner eigenen Sitzungen hinweg waren 98 % aller Eingabe-Tokens Cache-Lesevorgänge.
Schauen Sie genau hin, was Caching behoben hat und was nicht. Es hat die Kosten Ihres Verlaufs auf etwa ein Zehntel reduziert. Es hat nicht verhindert, dass der Verlauf wächst, und es hat nicht verhindert, dass Sie ihn bei jedem Zug erneut lesen. Ein Zehntel von 900.000 Tokens sind 90.000 Tokens berechnete Eingabe für eine Frage, die Sie in zwanzig hätten stellen können.
Caching ist das, was das Problem überlebbar macht. Es ist auch das, was es unsichtbar macht, denn die Zahl auf Ihrem Usage-Dashboard sieht nie so alarmierend aus wie die Zahl der Tokens, die tatsächlich bewegt werden.
Abonnieren Sie unseren Newsletter
Erhalten Sie die neuesten Tipps, Trends und Angebote kostenlos.
Was tatsächlich darin steckt
Wenn eine Sitzung groß wird, nehmen die Leute an, es sei die Unterhaltung. Meist ist es das nicht. In einer arbeitenden Agentensitzung liegt das Gewicht an vier Stellen.
Tool-Definitionen. Jedes Tool, das der Agent aufrufen kann, trägt einen Namen, eine Beschreibung und ein vollständiges Parameter-Schema – alles geladen, bevor der Agent irgendetwas tut. Verbinden Sie sechs MCP-Server mit je 25 Tools, und Sie haben im ersten Zug 150 Schemas im Fenster, von denen die meisten nie aufgerufen werden.
Dateilesevorgänge. Ein Agent, der eine Quelldatei mit 2.000 Zeilen liest, hat gerade etwa 25.000 Tokens zu jedem zukünftigen Zug der Sitzung hinzugefügt. Er brauchte die Datei einmal. Er trägt sie für immer mit.
Tool-Ausgaben. Eine Suche, die 200 Ergebnisse zurückgibt, ein Testlauf, der sein ganzes Log ausgibt, ein API-Aufruf, der ein vollständiges Dokument zurückgibt. Der Agent brauchte davon meist eine Zeile. Alles bleibt.
Die Unterhaltung selbst. Einschließlich der Teile, in denen der Agent eine Sackgasse erkundet hat, sich korrigierte und weitermachte. Diese Tokens sind noch im Fenster, werden noch erneut gelesen und prägen noch die nächste Antwort.
Der letzte Punkt zählt über die Kosten hinaus. Ein Fenster voller aufgegebener Versuche und veralteter Dateiinhalte ist auch ein Fenster, in dem das relevante Detail schwerer zu finden ist. Kontext ist gleichzeitig ein Budget- und ein Aufmerksamkeitsproblem.
Drei Wege, es zu verkleinern
Löschen. Starten Sie eine neue Sitzung. Alles, was Sie anderswo festgehalten haben, überlebt; alles andere ist weg. Das ist das grobste Werkzeug und oft das richtige. Eine Sitzung den ganzen Tag am Leben zu halten, weil sie „das Projekt kennt", ist die Angewohnheit, die am meisten kostet.
Kontext-Bearbeitung. Entfernen Sie bestimmtes Material und behalten Sie den Rest Wort für Wort, meist alte Tool-Ergebnisse, sobald sie verwendet wurden. Anthropics API stellt dies direkt als Kontextmanagement-Strategie bereit. Sie ist präzise und verfälscht das Verbleibende nicht, sie ist also das Erste, wozu man greift, wenn das Gewicht sperrige Tool-Ausgaben sind statt einer langen Unterhaltung.
Verdichtung. Fassen Sie den Verlauf zusammen und fahren Sie mit der Zusammenfassung fort. Das tun die meisten Coding-Agenten automatisch, wenn das Fenster voll ist, und es ist die einzige Option, die das Wachstum einer Sitzung begrenzt, ohne sie zu beenden. Sie lässt sehr viel fallen.
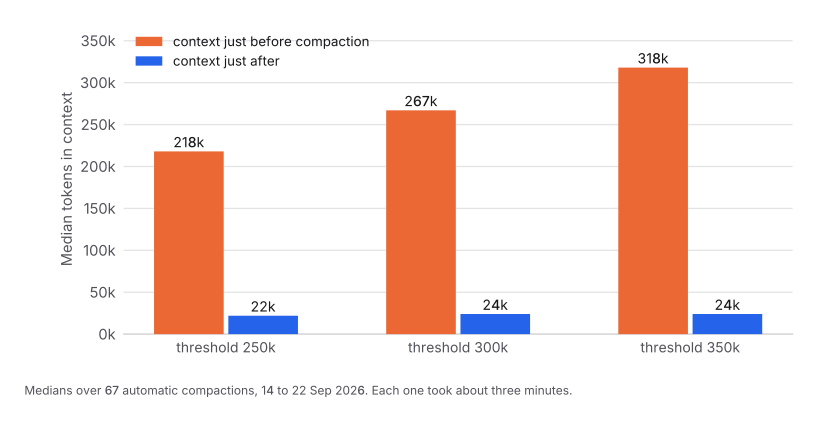
Das sind Mediane über 67 echte Verdichtungen in meinen eigenen Sitzungen. Jede dauerte etwa drei Minuten, und danach las der Agent Dateien, die er bereits gesehen hatte, mit fast doppelter Rate erneut und baute so wieder auf, was die Zusammenfassung verloren hatte. Der Tausch lohnt sich. Es bleibt trotzdem ein Tausch.
Die vierte Option ist besser als alle drei
Packen Sie es gar nicht erst ins Fenster.
Halten Sie dauerhaften Zustand in Dateien, die der Agent bei Bedarf erneut lesen kann, statt in der Unterhaltung. Schicken Sie leseintensive Arbeit an einen Subagenten mit eigenem kurzlebigen Kontext, damit die zwanzig Dateien, die er liest, die Hauptsitzung nie berühren. Laden Sie Tools, wenn sie gebraucht werden, statt alle vorab.
Ein Token, das nie hinzugefügt wird, ist ein Token, das Sie nie erneut lesen. Alles andere auf dieser Seite ist Schadensbegrenzung für Tokens, die es wurden.
Wo die Schwelle liegen sollte
Wenn Ihr Agent automatisch verdichtet, hat er eine Schwelle, und der Standardwert liegt meist nahe am vollen Fenster des Modells. Dieser Standard ist die teure Einstellung, denn er lässt Ihre Sitzung ihre produktivsten Stunden damit verbringen, den größtmöglichen Verlauf mitzuführen.
Sie niedriger anzusetzen hilft, aber es gibt eine Untergrenze. Verdichten Sie zu eifrig, zahlen Sie immer wieder die drei Minuten Wartezeit und die Nacharbeit. Bei einem Modell mit 1M-Kontext erzwang eine Schwelle von 250.000 in 36 % meiner langen Sitzungen eine Verdichtung; 350.000 löste nur in 12 % eine aus und erzielte fast dieselbe Ersparnis. Über fünf Wochen an Sitzungen war das Ergebnis 17 % weniger cache-gewichtete Tokens bei derselben Anzahl von Prompts und etwa die Hälfte der Kosten in den langen Sitzungen, in denen die Obergrenze tatsächlich griff. Die vollständigen Daten finden Sie in dem begleitenden Beitrag .
Eine brauchbare Regel: Setzen Sie die Obergrenze auf etwa ein Drittel des Fensters Ihres Modells und justieren Sie von dort aus nach. Niedrig genug, dass keine Sitzung Stunden nahe der Decke verbringt, hoch genug, dass gewöhnliche Arbeit ohne Unterbrechung durch eine Zusammenfassung fertig wird.
Messen Sie Ihre eigenen
Nichts davon braucht neue Instrumentierung. Jede API-Antwort trägt ein Usage-Objekt mit vier Feldern: input_tokens, cache_creation_input_tokens, cache_read_input_tokens und output_tokens. Die meisten Agenten-Harnesses schreiben diese ohnehin in ein Sitzungsprotokoll auf der Festplatte.
Zwei Zahlen sagen Ihnen fast alles.
Cache-gewichtete Eingabe pro Aufruf. Gewichten Sie die Felder nach ihren Kosten: frische Eingabe mit 1, Cache-Schreibvorgänge mit 1,25 oder 2, Cache-Lesevorgänge mit 0,1. Wenn dieser Wert Woche für Woche steigt, während Ihre Arbeitslast gleich bleibt, wachsen Ihre Sitzungen und Sie zahlen dafür.
Spitzenkontext pro Sitzung. Der größte einzelne Aufruf in jeder Sitzung. Wenn die Spitzen nahe am Fenster Ihres Modells liegen, haben Sie Ihre Rechnung gefunden.
Rohe Wochensummen führen Sie in die Irre, denn eine geschäftige Woche schlägt eine ruhige Woche, egal was Sie ändern. Teilen Sie immer durch etwas, das für Arbeit steht: eine abgeschlossene Aufgabe, einen Prompt, einen API-Aufruf.
Weiterlesen
Ein Kontextfenster ist eine wiederkehrende Gebühr, die bei jedem Zug für alles erhoben wird, was Sie je hineingelegt haben. Caching senkt den Satz um etwa neunzig Prozent und verbirgt den Trend. Die Lösung ist ein kleineres Fenster, das bewusst zurückgesetzt wird.
Für die gemessene Version – mit fünf Wochen Sitzungsdaten und der einen Einstellung, die den größten Teil der Ersparnis brachte – lesen Sie den begleitenden Beitrag über die Senkung des Token-Verbrauchs von Agenten um 17 % .
