


De korte versie
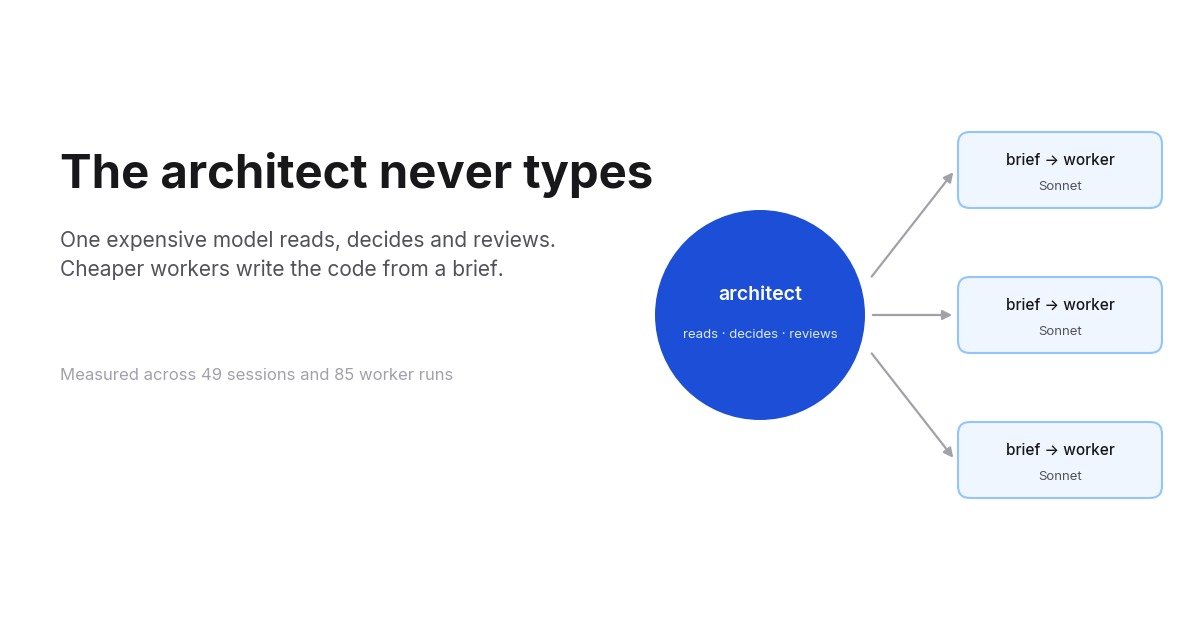
- Vijf weken lang liet ik mijn coding agent in een splitsing draaien: het hoofdmodel, Opus en later Fable, leest, beslist en reviewt, en een werkeragent schrijft de code op basis van een geschreven brief. Ik noem het het architect-patroon en het is nu een publieke skill: architect-skill op GitHub , MIT-licentie.
- Het hoofdmodel stopte met typen. Over 49 architect-sessies bewerkte het 6 keer een bronbestand in 1.467 prompts. In 275 gewone sessies in dezelfde weken bewerkte het 244 bestanden in 3.081 prompts. Dat is 0,4 tegen 7,9 per 100 prompts.
- Het totale aantal tokens per prompt daalde niet. Ze stegen, fors, twee weken lang, en kwamen daarna terug op het niveau van gewone sessies. Wat veranderde is wie ze uitgaf: het aandeel van Opus in de werkertokens ging van 100% naar ongeveer 4%, en sinds 14 september kost een prompt in een architect-sessie 364k gewogen tokens op het hoofdmodel, 205k op Sonnet-werkers en 80k op Opus-werkers.
- Die splitsing is wat een abonnement interesseert. Claude Max meet zijn weeklimiet over alle modellen tegen het tarief van elk model, dus een Sonnet-token trekt eraan tegen 40% van een Opus-token, en Fable heeft een eigen, krappere weeklimiet die geen enkele werker aanraakt.
- Ik heb ook geprobeerd de werkers via een headless Claude Code naar DeepSeek te routeren. Tegen lijstprijs kostte hetzelfde verkeer $10 in plaats van $202 op Sonnet of $505 op Opus. Op een abonnement bestaat die besparing niet, want het abonnement is al betaald. Ik heb het laten vallen. Betaal je per token, lees die sectie dan toch, want de cijfers zijn het punt.
Dit is de derde post in een reeks. De eerste mat wat één instelling met een contextvenster deed, 17% minder tokens , en de tweede legt uit wat een contextvenster kost en waarom. Deze gaat over de andere hendel: niet hoe groot de context is, maar welk model hem vasthoudt.
Wat het patroon is
Een coding-agent-sessie doet twee soorten werk. Het denkt: leest de codebase, bedenkt wat er moet veranderen, beslist namen en signaturen en edge cases, controleert de diff. En het typt: schrijft de code, draait het testbestand, fixt de lint. Het denken is waar een frontier-model zijn prijs verdient. Het typen niet. Het meeste daarvan wordt bepaald door de beslissing die eraan voorafging, en een kleiner model voert een beslist plan ongeveer net zo goed uit als een groot model.
Dus splitst de skill de sessie. Het hoofdmodel is de architect. Het doet alles in de hoofdlus behalve een bronbestand bewerken:
- De eis ondervragen en de codebase verkennen.
- De ontwerpbeslissingen nemen: aanpak, datastroom, namen, signaturen, edge cases. Het dichtstbijzijnde bestaande patroon om te spiegelen. De kleinste wijziging die de hoofdoorzaak verhelpt.
- Opdelen in slices die disjuncte sets bestanden bezitten.
- Per slice één implementatiebrief schrijven.
- De diff die terugkomt reviewen, de gates draaien, committen.
De werker is een subagent met een vers contextvenster. Hij krijgt de brief en niets anders, schrijft de code, draait de testbestanden die de brief noemt, en retourneert een kort gestructureerd rapport. Daarna wordt zijn context weggegooid. Hij wordt nooit onderdeel van de geschiedenis van de hoofdsessie, wat meer uitmaakt dan het klinkt: alles wat de hoofdsessie leest wordt bij elke latere call opnieuw verstuurd, dus een werker die twaalf bestanden en een testlog in zijn eigen context leest, houdt dat allemaal buiten de rekening van de architect.
De brief is het hele contract. De mijne heeft zeven velden en de skill gaat vooral over ze goed invullen:
## Implementatiebrief: <slice>
Doel: één zin, waarneembaar resultaat
Context: wat de verkenning opleverde: fragmenten, het patroon om te spiegelen, regelankers, valkuilen
Bestanden: paden om aan te maken/wijzigen, exclusief eigendom voor deze slice
Ontwerp: de besliste aanpak: datastroom, namen, signaturen, edge cases
Beperkingen: geldende projectregels: stijl, lagen, beveiliging
Buiten scope: wat niet aan te raken, inclusief bestanden die eigendom zijn van andere slices
Verifieer: exacte commando's en verwacht resultaat
Een brief bevat beslissingen, geen opties. Als ik nog twee aanpakken tegen elkaar afweeg, ben ik nog niet klaar om te delegeren.
Er is één uitzondering. Delegeren heeft vaste overhead: de brief schrijven, de werker opstarten, het rapport lezen, de diff reviewen. Een typfout fixen, een configuratiewaarde, een versiebump, een dode key verwijderen, een fix van één regel en zijn regressietest: daarvoor bewerkt de architect direct, want de brief zou meer kosten dan de aanpassing. De toets is kosten, niet regelaantal. Zodra de aanpassing een ontwerpoordeel vereist of een pad raakt dat de repo als kritiek markeert, gaat het naar een werker.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
Waarom een abonnement de rekensom verandert
Betaal je per token, dan is de zaak simpel. Opus 5 staat op $5 per miljoen inputtokens en $25 per miljoen output; Sonnet 5 op $2 en $10. Elke token implementatie die van Opus naar Sonnet verhuist, kost 40% van wat hij kostte.
Ik betaal een abonnement, en daar ligt het anders en, denk ik, sterker. Claude Max heeft twee weeklimieten, niet één: een limiet over alle modellen, waaraan elke token trekt tegen het tarief van dat model, en een aparte, krappere limiet waaraan alleen Fable trekt. Opus heeft geen eigen limiet. Dat geeft de splitsing twee effecten. Werk dat een Sonnet-werker doet, trekt aan de gedeelde limiet tegen 40% van het tarief van een Opus-werker, dus als je twee derde van de tokens van een sessie naar Sonnet verhuist, duurt de week langer, zelfs als het totale tokental onveranderd is. En als de architect Fable is, is elke token die hij niet aan typen besteedt een token die overblijft op de limiet die het eerst opraakt. Dus zelfs als het architect-patroon exact evenveel tokens uitgaf als een gewone sessie, zou wie ze uitgeeft nog steeds bepalen wanneer de week eindigt.
Dat “zelfs als” bleek veel werk te doen.
Wat de transcripten zeggen
Claude Code schrijft elke sessie naar een JSONL-transcript, en elke werkerrun naar een zusterbestand onder de map van de sessie. Ik heb ze allemaal sinds 19 augustus: 324 interactieve sessies met drie of meer prompts, waarvan 49 het patroon gebruikten, wat betekent dat ze een implementer-agent startten of er een brief naartoe stuurden. Tokens worden gewogen zoals de rekening: verse input op 1, cache-writes op 1,25 of 2, cache-reads op 0,1. CI-runs zijn uitgesloten.
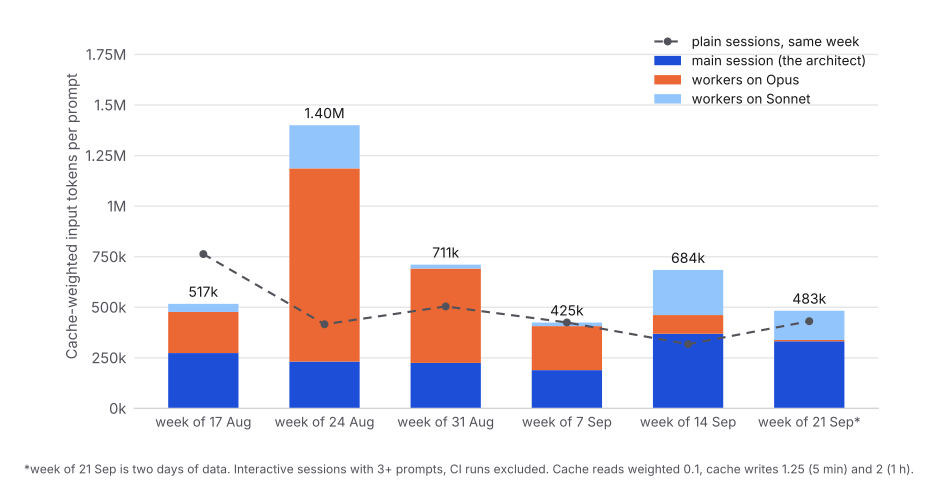
Lees het van links naar rechts en het is geen succesverhaal voor de eerste twee weken.
In de week van 24 augustus kostte een architect-sessie 1,40M gewogen tokens per prompt. Gewone sessies diezelfde week kostten 0,42M. Drieënhalf keer meer, en bijna al het overschot was oranje: Opus-werkers. Ik had de werkers een goed model gegeven en geen regels, en ze gedroegen zich als een goed model zonder regels. De mediane Opus-werkerrun die week was 176 turns. Verschillende draaiden de volledige backend-testsuite, wat ongeveer 100 KB output in een context zet die bij elke volgende turn opnieuw wordt verstuurd. Eén sessie met zes werkers op 14 september, nadat ik al begonnen was dingen aan te scherpen, verbrandde nog steeds 245M inputtokens over 1.585 turns om ongeveer zesduizend regels diff te produceren. Prompt-caching werkte de hele tijd met een hitrate van 91,6%. De rekening was volume, niet prijsstelling.
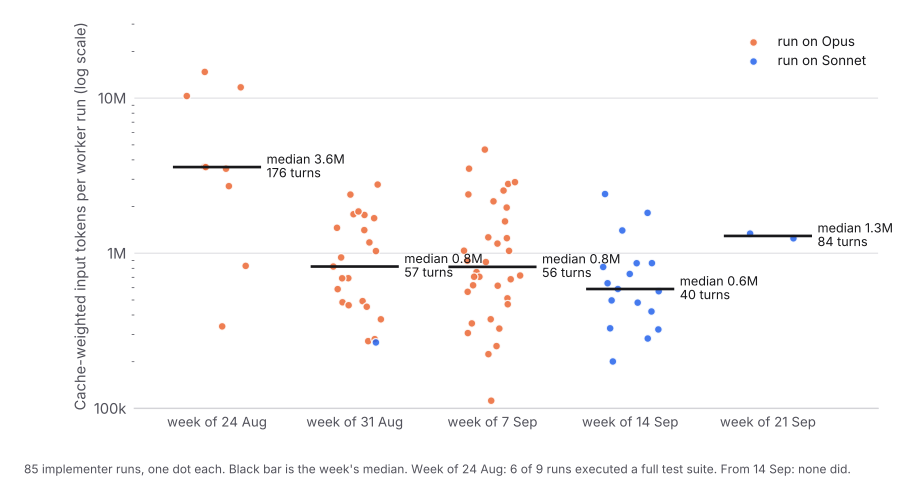
De werkerstrook laat zien waar de regels landden. Drie ervan deden het meeste werk, en ik schreef ze in de agentdefinities in plaats van in de brief, zodat ze gelden of ik het me nu herinner of niet:
- Een werker draait nooit een volledige testsuite. Hij draait de testbestanden die zijn brief noemt. De architect draait de gates.
maxTurnsis begrensd in de agentdefinitie, 140 voor Sonnet en 160 voor Opus. Een slice die 250 turns nodig heeft, was verkeerd gebriefd.- Een slice blijft onder ongeveer twaalf bestanden, en de brief onder ongeveer 8 KB. De brief wordt ook elke turn opnieuw verstuurd.
Tegen de week van 31 augustus was de mediane werkerrun 57 turns en 0,8M gewogen tokens. Vanaf 14 september, toen ik de standaardroute naar Sonnet verlegde, was het 40 turns en 0,6M, en geen enkele werker heeft sindsdien een volledige suite gedraaid.
Het totaal per prompt volgde: 711k, 425k, 684k, 483k over de laatste vier weken, tegen gewone sessies op 505k, 425k, 318k, 431k. Architect-sessies kosten nu ongeveer wat gewone sessies kosten. Iets meer in twee van de vier weken, iets minder in één. Wat ze daarvoor kopen, zijn de volgende twee grafieken.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
Het hoofdmodel stopte met typen
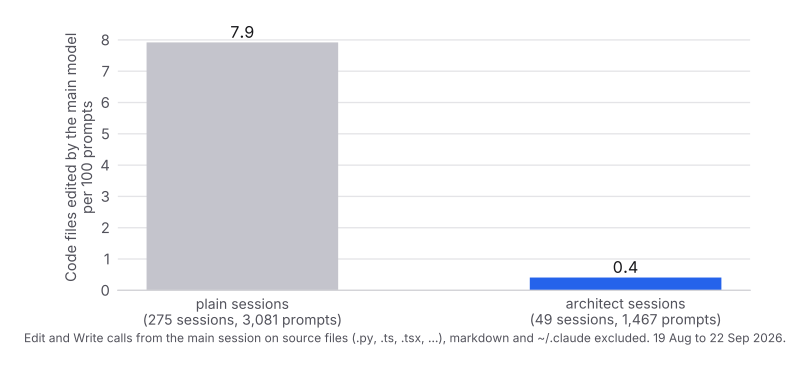
Dit is het getal dat ik wilde veranderen en het veranderde. In gewone sessies deed het hoofdmodel 244 Edit- of Write-calls op bronbestanden over 3.081 prompts. In architect-sessies deed het er 6 over 1.467. Die 6 zijn allemaal uitzonderingen voor kleine aanpassingen die ik kan verantwoorden.
Ondertussen waren de werkers productief. De 85 werkerruns deden 2.510 bewerkingen op bronbestanden. Hoofdlus en werkers samengeteld produceerde een architect-sessie 2.516 codebewerkingen uit 1.467 prompts; gewone sessies produceerden 943 uit 3.081. Per codebewerking gaf een architect-sessie in totaal 403k gewogen tokens uit en 330k op het Opus-familie-model. Een gewone sessie gaf 1.410k en 1.324k uit. Ik wil voorzichtig zijn met die vergelijking, want de twee populaties zijn niet hetzelfde werk: een sessie wordt als architect geclassificeerd doordat ze code delegeert, dus architect-sessies zijn per constructie code-intensief, en gewone sessies bevatten onderzoek, reviews en debugging die nooit iets bewerken. Lees het als “het patroon krijgt veel code geschreven per token”, niet als een claim van vier keer efficiëntie.
De schonere claim is de modelsplitsing. Sinds 14 september kost een prompt in een architect-sessie 364k gewogen tokens in de hoofdlus, 205k in Sonnet-werkers en 80k in Opus-werkers. Het aandeel van de Opus-werkers in alle werkertokens was 100% in augustus en ongeveer 4% in de week van 21 september. Op een Max-plan betekent dat dat de gedeelde weeklimiet voor bijna al het implementatiewerk tegen Sonnets tarief wordt aangesproken in plaats van Opus’, en dat niets ervan de Fable-limiet raakt.
Twee dingen verbeterden niet, en dat zeg ik liever dan dat de grafieken iets anders suggereren. De eigen context van de hoofdsessie kromp niet: architect-sessies compactten 8,7 keer per 100 prompts tegen 4,7 voor gewone sessies, omdat de architect veel leest voordat hij briefet. En het patroon is langzamer in kloktijd bij kleine taken, omdat de opstart en het rapport van een werker minuten zijn die je niet betaalt als je gewoon de aanpassing maakt. De uitzondering voor kleine aanpassingen bestaat omdat de eerste versie van de skill er geen had, en ik zag mezelf een brief van 3 KB schrijven voor een wijziging van twee regels.
De DeepSeek-omweg
Toen de werkers eenmaal Sonnet waren, was de voor de hand liggende volgende vraag of het überhaupt een Claude-model moest zijn. Van 13 tot 18 september richtte ik de werker op DeepSeek V4.1 Flash via een headless Claude Code met ANTHROPIC_BASE_URL ingesteld op een compatibel endpoint, eerst via OpenRouter en daarna native. Zelfde brief-formaat, zelfde rapportformaat, zelfde architect. 2.732 calls, 431M inputtokens waarvan 88% cache-reads, 1,7M outputtokens.
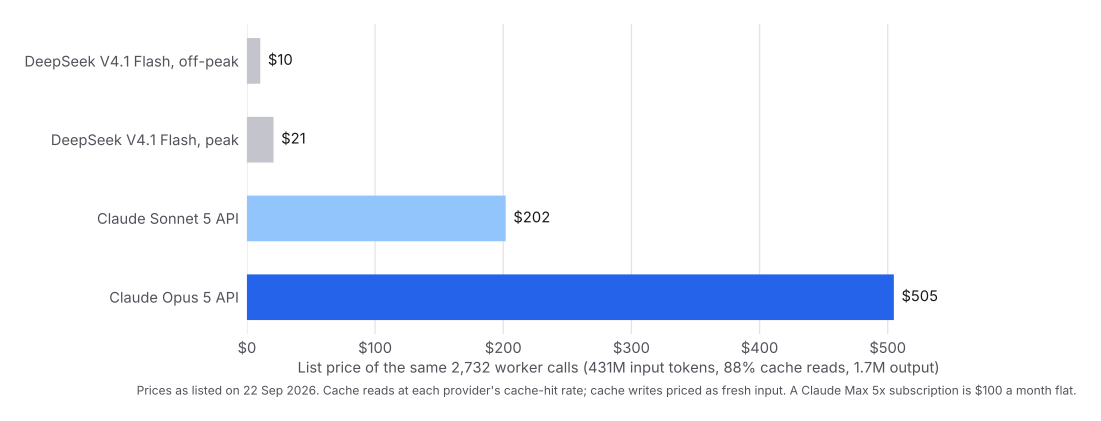
Tegen lijstprijzen op 22 september kost dat verkeer ongeveer $10 op DeepSeek off-peak, $21 op peak, $202 op de Sonnet API en $505 op de Opus API. Als ik per token betaalde, zou dit de kop van de post zijn en had ik het gehouden.
Ik betaal niet per token, en dat is het hele argument. Een Max-abonnement kost $100 per maand, of ik nu 30% van de weeklimiet gebruik of 100%. Het verkeer van werkers naar DeepSeek verplaatsen verlaagde die rekening geen cent. Het voegde er een tweede rekening van $10 tot $21 per week bovenop, om capaciteit te sparen op een plan waarvan ik de capaciteit al betaald had. Ik had “goedkoper dan de API” verward met “goedkoper dan wat ik betaal”, en dat is niet hetzelfde als wat je betaalt vast is. De juiste vergelijking voor een abonnee is DeepSeek tegen een tweede abonnement, en daar kost een tweede Claude-plan of een ChatGPT-plan met Codex ongeveer hetzelfde als een maand matig DeepSeek-gebruik, en het komt met zijn eigen weeklimiet, zijn eigen model en geen metering om in de gaten te houden.
Kwaliteit was de andere helft. Vijf backend-slices kwamen schoon terug en werden as-is gecommit. Eén frontend-slice verwijderde een geëxporteerd symbool en liet elke gebruiker ervan onaangeroerd, dus de tree compileerde niet en een latere slice moest het opruimen. Dat is precies de fout die een model heeft dat een specificatie uitvoert en een model dat de vorm van een component uit zijn broers en zussen afleidt niet, en de skill zegt dat nu: wijzigingen aan een gedeeld API-oppervlak gaan naar Sonnet, en de werkerregel luidt “verwijder of hernoem nooit een geëxporteerd symbool zonder elke gebruiker in dezelfde run te migreren”. DeepSeek Flash is een goede uitvoerder. Het architect-patroon heeft een werker nodig die opmerkt wanneer de brief de gebruikers heeft ondergeteld, en dat is het enige wat een brief niet kan leveren.
Dus de routingtabel van vandaag heeft twee rijen. Routinematig werk, backend-werk tegen een gedetailleerde brief met tests om te bevredigen, frontend-werk dat een bestaande ontwerpgrammatica volgt, en elke wijziging aan een gedeeld API-oppervlak gaan naar sonnet-implementer. Werk waarvan de moeilijkheid in de redenering zit, gaat naar opus-implementer: een async-race, een refactor op meerdere plekken waarvan de correctheid afhangt van plekken die de brief niet kan opsommen, een backfill-migratie die geen enkele test bewijst. Routeer op vorm, nooit op risico. Risico verandert hoe streng de diff wordt gereviewd en of een mens tekent. Het verandert nooit wie hem schrijft.
De reviewloop, waar het patroon zijn waarde verdient of verliest
Het rapport van een werker is een claim. De reviewloop van de skill is kort en elke regel kwam voort uit ervaring met branden:
- Lees het rapport en de werkelijke
git diff. Controleer de diffstat die de werker citeert tegen degene die je ziet. - Draai de belangrijkste verificatie zelf opnieuw wanneer de claim ertoe doet.
- Probleem gevonden? Stuur de correctie naar dezelfde werker. Die heeft zijn context nog en pakt op waar hij stopte. Fix het niet met de hand, start niet opnieuw.
- Twee mislukte correcties betekenen dat de brief te vaag was, niet dat het model te klein is. Decomponeren, het ontbrekende fragment in Context zetten, opnieuw draaien. Klim niet naar een groter model, want dat implementeert hetzelfde misverstand vloeiender.
- Draai de afgebakende gates voordat je iets accepteert: de geraakte tests, de linter op de geraakte bestanden, welk conventiescript de repo ook heeft.
In de transcripten stuurde ik ongeveer één correctie per werkerrun, 52 over 85 runs, en 7 Opus-runs raakten hun limiet van 160 turns, allemaal op een slice die ik nu zou splitsen. Dat zijn de twee getallen die ik in de gaten houd. Gaan correcties per run omhoog, dan worden mijn brieven lui. Raken werkers de limiet, dan zijn mijn slices te groot.
Wat je hiervan meeneemt
Betaal je per token: zet het dure model op beslissingen en review, zet een goedkoop model op implementatie, en prijs je werkverkeer tegen lijstprijs voordat je kiest welke goedkope. De grafiek met vier staven is het argument.
Betaal je een abonnement: het patroon verlaagt je tokental niet. Het verplaatst de implementatietokens naar het model dat de gedeelde weeklimiet het langzaamst aanspreekt, houdt de Fable-limiet voor het werk dat alleen Fable zou moeten doen, en voorkomt dat je duurste model zijn turns aan typen besteedt. Voeg geen gemeten API aan de zijkant toe om capaciteit te “sparen” die je al gekocht hebt. Kom je werkkapiteit tekort, koop een tweede abonnement.
Hoe dan ook, de regels die het lieten werken waren de saaie. Geen volledige testsuites in een werker. Begrens turns. Kleine slices, korte brieven. Corrigeer dezelfde werker één keer, fix dan de brief.
De skill, de drie agentdefinities en de guard-hook staan op github.com/LivinTribunal/architect-skill onder MIT. De begeleidende skill die de werker vertelt hoe hij code schrijft die past bij de repo waarin hij landt, is grain-skill , en de post daarover is code with the grain .
Methode
Alles wat de post beschrijft staat in github.com/LivinTribunal/architect-skill : de skill zelf, de brief-template, de routingtabel, de drie implementer-agentdefinities met hun turn-limieten en contextregels, en de guard-hook. Installeer het en je hebt de setup waar de onderstaande cijfers vandaan komen.
Sessies zijn Claude Code JSONL-transcripten van 19 augustus tot 22 september 2026, entrypoint cli, drie of meer gebruikersprompts. Een sessie wordt als architect geclassificeerd als ze opus-implementer, opus-implementer-xhigh of sonnet-implementer startte, een ds-slice-werker draaide, de architect-skill aanriep, of een bericht met een implementatiebrief naar een general-purpose agent stuurde, wat de manier was waarop de vroege weken werkten voordat de benoemde agents bestonden. Werkerruns zijn de subagent-transcripten onder de map van elke sessie. Gebruik is gededupliceerd op request-id en gewogen: verse input 1, cache-write van vijf minuten 1,25, cache-write van één uur 2, cache-read 0,1. Een “codebewerking” is een Edit- of Write-call op een .py-, .ts-, .tsx-, .js-, .sql- of vergelijkbaar bronbestand, met uitsluiting van markdown en alles onder ~/.claude. DeepSeek-prijzen zijn de native lijstprijs op 22 september 2026, off-peak en peak, met cache-reads tegen de cache-hitrate en cache-writes geprijsd als verse input; Claude API-prijzen zijn de gepubliceerde lijstprijzen van Opus 5 en Sonnet 5 met cache-reads op een tiende van input. De week van 21 september is twee dagen data.
