


Versiunea scurtă
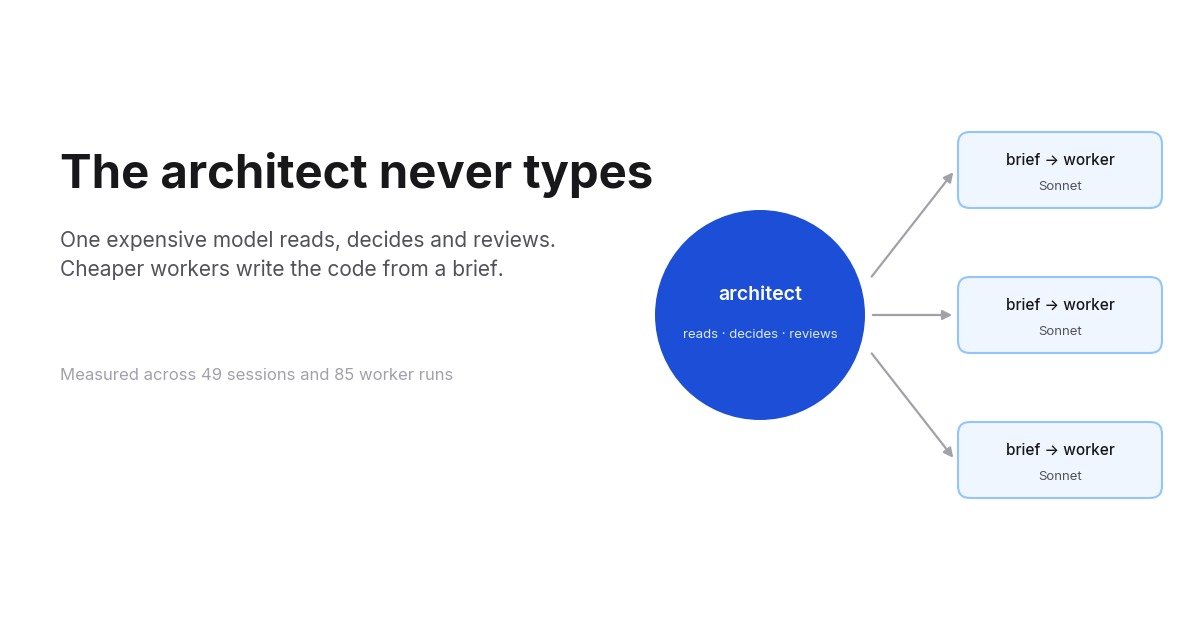
- Timp de cinci săptămâni mi-am rulat agentul de cod în mod divizat: modelul principal, Opus și mai târziu Fable, citește, decide și verifică, iar un agent lucrător scrie codul dintr-un brief scris. Îl numesc pattern-ul arhitectului și acum este un skill public: architect-skill pe GitHub , cu licență MIT.
- Modelul principal a încetat să tasteze. De-a lungul a 49 de sesiuni de arhitect a editat un fișier sursă de 6 ori în 1.467 de prompturi. În 275 de sesiuni simple, în aceleași săptămâni, a editat 244 de fișiere în 3.081 de prompturi. Adică 0,4 față de 7,9 la 100 de prompturi.
- Numărul total de tokeni per prompt nu a scăzut. A crescut, rău, timp de două săptămâni, apoi a revenit la nivelul sesiunilor simple. Ce s-a schimbat este cine i-a cheltuit: ponderea Opus din tokenii lucrătorilor a trecut de la 100% la aproximativ 4%, iar din 14 septembrie un prompt într-o sesiune de arhitect costă 364k tokeni ponderați pe modelul principal, 205k pe lucrătorii Sonnet și 80k pe lucrătorii Opus.
- Această împărțire este ceea ce contează pentru un abonament. Claude Max măsoară limita săptămânală pentru toate modelele la tariful fiecărui model, așa că un token Sonnet o consumă la 40% din cât consumă un token Opus, iar Fable are o limită săptămânală separată și mai strictă, pe care niciun lucrător nu o atinge.
- Am încercat și să rutez lucrătorii către DeepSeek printr-un Claude Code headless. La preț de listă, același trafic costa $10 în loc de $202 pe Sonnet sau $505 pe Opus. Pe un abonament acea economie nu există, pentru că abonamentul era deja plătit. Am renunțat. Dacă plătești per token, citește totuși secțiunea aceea, pentru că cifrele sunt esențiale.
Acesta este al treilea articol dintr-o serie. Primul a măsurat ce a făcut o singură setare unei ferestre de context, 17% mai puțini tokeni , iar al doilea explică cât costă o fereastră de context și de ce. Acesta este despre cealaltă pârghie: nu cât de mare este contextul, ci ce model îl ține.
Ce este pattern-ul
O sesiune de agent de cod face două tipuri de muncă. Gândește: citește baza de cod, stabilește ce trebuie schimbat, decide nume și semnături și cazuri limită, verifică diff-ul. Și tastează: scrie codul, rulează fișierul de test, repară lint-ul. Gândirea este locul unde un model de frontieră își merită prețul. Tastarea nu. Cea mai mare parte a ei este determinată de decizia care a precedat-o, iar un model mai mic execută un plan decis aproape la fel de bine ca unul mare.
Așa că skill-ul împarte sesiunea. Modelul principal este arhitectul. Face tot ce ține de bucla principală, în afară de editarea unui fișier sursă:
- Interoghează cerința și explorează baza de cod.
- Ia deciziile de design: abordarea, fluxul de date, numele, semnăturile, cazurile limită. Cel mai apropiat pattern existent de oglindit. Cea mai mică schimbare care rezolvă cauza rădăcină.
- Descompune în felii care dețin seturi disjuncte de fișiere.
- Scrie un brief de implementare per felie.
- Verifică diff-ul care se întoarce, rulează porțile de verificare, face commit.
Lucrătorul este un subagent cu o fereastră de context proaspătă. Primește brief-ul și nimic altceva, scrie codul, rulează fișierele de test pe care le numește brief-ul și returnează un raport structurat scurt. Apoi contextul lui este aruncat. Nu devine niciodată parte din istoricul sesiunii principale, ceea ce contează mai mult decât pare: tot ce citește sesiunea principală este retrimis la fiecare apel ulterior, așa că un lucrător care citește douăsprezece fișiere și un jurnal de test în propriul context ține toate acestea în afara facturii arhitectului.
Brief-ul este întregul contract. Al meu are șapte câmpuri, iar skill-ul este în mare parte despre a le completa bine:
## Brief de implementare: <felie>
Obiectiv: o propoziție, rezultat observabil
Context: ce a găsit explorarea: extrase, pattern-ul de oglindit, anchori de linie, capcane
Fișiere: căi de creat/modificat, proprietate exclusivă pentru această felie
Design: abordarea decisă: flux de date, nume, semnături, cazuri limită
Constrângeri: regulile de proiect care se aplică: stil, straturi, securitate
În afara scopului: ce să nu atingi, inclusiv fișierele deținute de alte felii
Verificare: comenzi exacte și rezultatul așteptat
Un brief conține decizii, nu opțiuni. Dacă încă cântăresc două abordări, nu sunt gata să deleg.
Există o singură excepție. Delegarea are un cost fix: scrierea brief-ului, pornirea lucrătorului, citirea raportului, verificarea diff-ului. O corectură de typo, o valoare de configurare, o creștere de versiune, ștergerea unei chei moarte, o corectură de o singură linie și testul ei de regresie: pentru acestea arhitectul editează direct, pentru că brief-ul ar costa mai mult decât editarea. Testul este costul, nu numărul de linii. În momentul în care editarea necesită o judecată de design sau atinge o cale pe care repo-ul o semnalează ca critică, merge la un lucrător.

Pregătit să îți dezvolți afacerea?
Începe perioada de probă gratuită astăzi și vezi rezultate în câteva zile.
De ce un abonament schimbă aritmetica
Dacă plătești per token, raționamentul este simplu. Opus 5 este listat la $5 per milion de tokeni de intrare și $25 per milion de ieșire; Sonnet 5 la $2 și $10. Fiecare token de implementare care se mută de la Opus la Sonnet costă 40% din cât costa.
Eu plătesc un abonament, iar acolo raționamentul este diferit și, cred, mai puternic. Claude Max are două limite săptămânale, nu una: o limită pentru toate modelele, consumată de fiecare token la tariful modelului respectiv, și o limită separată, mai strictă, pe care o consumă doar Fable. Opus nu are o limită proprie. Asta dă împărțirii două efecte. Munca făcută de un lucrător Sonnet consumă limita comună la 40% din tariful pe care l-ar consuma un lucrător Opus, așa că mutarea a două treimi din tokenii unei sesiuni către Sonnet face săptămâna să țină mai mult, chiar dacă numărul total de tokeni rămâne neschimbat. Iar când arhitectul este Fable, fiecare token pe care nu îl cheltuie tastând este un token rămas pe limita care se epuizează prima. Deci, chiar dacă pattern-ul arhitectului ar cheltui exact același număr de tokeni ca o sesiune simplă, cine îi cheltuie ar decide totuși când se termină săptămâna.
Acest „chiar dacă" s-a dovedit a face multă muncă.
Ce spun transcrierile
Claude Code scrie fiecare sesiune într-o transcriere JSONL, iar fiecare rulare de lucrător într-un fișier alăturat, în directorul sesiunii. Le am pe toate din 19 august: 324 de sesiuni interactive cu trei sau mai multe prompturi, dintre care 49 au folosit pattern-ul, adică au generat un agent implementator sau au trimis un brief către unul. Tokenii sunt ponderați așa cum este factura: intrare nouă la 1, scrieri în cache la 1,25 sau 2, citiri din cache la 0,1. Rulările CI sunt excluse.
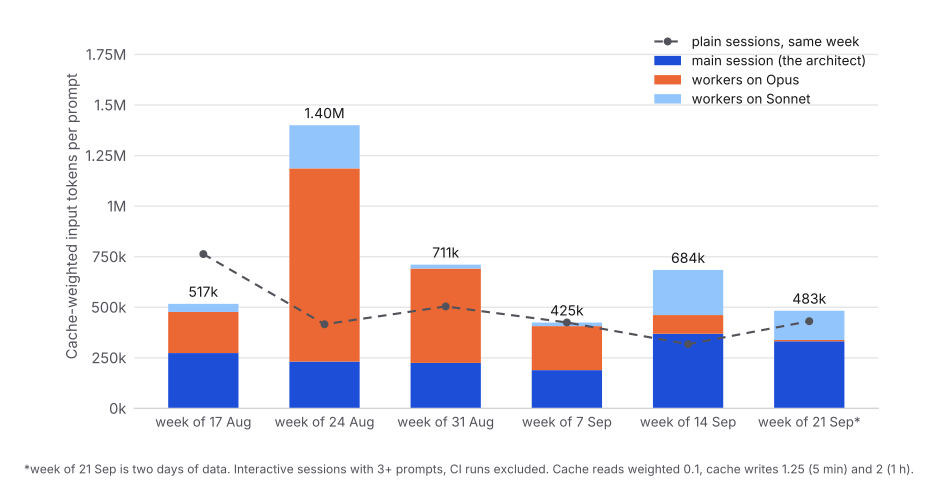
Citește-l de la stânga la dreapta și nu este o poveste de succes pentru primele două săptămâni.
În săptămâna 24 august o sesiune de arhitect a costat 1,40M tokeni ponderați per prompt. Sesiunile simple din aceeași săptămână au costat 0,42M. De trei ori și jumătate mai mult, iar aproape tot excesul era portocaliu: lucrătorii Opus. Le dădusem lucrătorilor un model bun și nicio regulă, iar ei s-au comportat ca un model bun fără reguli. Mediana unei rulări de lucrător Opus în acea săptămână a fost de 176 de ture. Câteva au rulat întreaga suită de teste de backend, ceea ce pune aproximativ 100 KB de output într-un context care este retrimis la fiecare tură după aceea. O sesiune cu șase lucrători, pe 14 septembrie, după ce începusem deja să strâng lucrurile, a ars totuși 245M tokeni de intrare în 1.585 de ture pentru a produce aproximativ șase mii de linii de diff. Cache-ul de prompturi funcționa cu o rată de hit de 91,6% tot timpul. Factura era volumul, nu prețul.
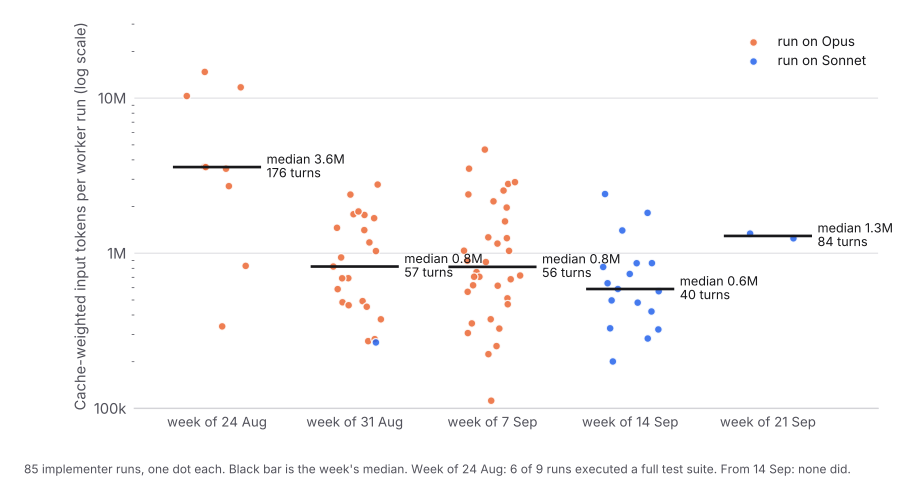
Fâșia lucrătorilor arată unde au ajuns regulile. Trei dintre ele au făcut cea mai mare parte a muncii, și le-am scris în definițiile agenților, nu în brief, ca să se aplice indiferent dacă îmi amintesc sau nu:
- Un lucrător nu rulează niciodată o suită completă de teste. Rulează fișierele de test pe care le numește brief-ul. Arhitectul rulează porțile de verificare.
maxTurnseste limitat în definiția agentului, 140 pentru Sonnet și 160 pentru Opus. O felie care are nevoie de 250 de ture a primit un brief greșit.- O felie rămâne sub aproximativ douăsprezece fișiere, iar brief-ul sub aproximativ 8 KB. Brief-ul este și el retrimis la fiecare tură.
Până în săptămâna 31 august mediana unei rulări de lucrător era de 57 de ture și 0,8M tokeni ponderați. Din 14 septembrie, când am mutat ruta implicită pe Sonnet, a fost de 40 de ture și 0,6M, și niciun lucrător nu a mai rulat o suită completă de atunci.
Totalul per prompt a urmat: 711k, 425k, 684k, 483k în ultimele patru săptămâni, față de sesiunile simple la 505k, 425k, 318k, 431k. Sesiunile de arhitect costă acum cam cât costă sesiunile simple. Puțin mai mult în două din cele patru săptămâni, puțin mai puțin într-una. Ce cumpără în schimb arată în următoarele două grafice.
Abonează-te la newsletter-ul nostru
Primește cele mai recente sfaturi, tendințe și oferte gratuit.
Modelul principal a încetat să tasteze
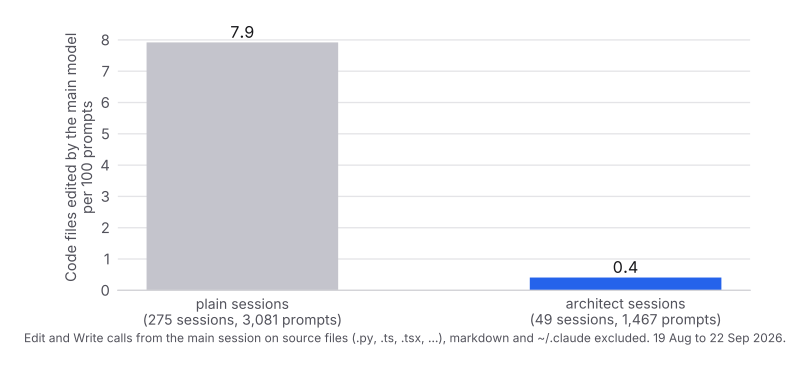
Acesta este numărul pe care mi-am propus să îl schimb și s-a schimbat. În sesiunile simple modelul principal a făcut 244 de apeluri Edit sau Write pe fișiere sursă în 3.081 de prompturi. În sesiunile de arhitect a făcut 6 în 1.467. Cele 6 sunt toate excepții de mici editări pe care le pot justifica.
Între timp lucrătorii au fost productivi. Cele 85 de rulări de lucrători au făcut 2.510 editări de fișiere sursă. Numărând bucla principală și lucrătorii împreună, o sesiune de arhitect a produs 2.516 editări de cod din 1.467 de prompturi; sesiunile simple au produs 943 din 3.081. Per editare de cod, o sesiune de arhitect a cheltuit 403k tokeni ponderați în total și 330k pe modelul din familia Opus. O sesiune simplă a cheltuit 1.410k și 1.324k. Vreau să fiu atent cu această comparație, pentru că cele două populații nu reprezintă aceeași muncă: o sesiune este clasificată ca sesiune de arhitect pentru că deleagă cod, deci sesiunile de arhitect sunt pline de cod prin construcție, iar sesiunile simple includ cercetare, verificări și depanare care nu editează niciodată nimic. Citește-o ca „pattern-ul produce mult cod per token", nu ca o afirmație de patru ori mai eficient.
Afirmația mai curată este împărțirea pe modele. Din 14 septembrie, un prompt într-o sesiune de arhitect costă 364k tokeni ponderați în bucla principală, 205k în lucrătorii Sonnet și 80k în lucrătorii Opus. Ponderea lucrătorilor Opus din toți tokenii lucrătorilor a fost 100% în august și aproximativ 4% în săptămâna 21 septembrie. Pe un plan Max asta înseamnă că limita săptămânală comună este consumată la tariful Sonnet, nu al Opus, pentru aproape toată munca de implementare, și că nimic din ea nu atinge limita Fable.
Două lucruri nu s-au îmbunătățit, și prefer să spun asta decât să las graficele să sugereze altceva. Contextul sesiunii principale nu s-a micșorat: sesiunile de arhitect s-au compactat de 8,7 ori la 100 de prompturi, față de 4,7 în sesiunile simple, pentru că arhitectul citește mult înainte să dea brief-ul. Iar pattern-ul este mai lent în timp real la sarcinile mici, pentru că pornirea și raportul unui lucrător sunt minute pe care nu le plătești când faci pur și simplu editarea. Excepția pentru mici editări există pentru că prima versiune a skill-ului nu avea una, și m-am văzut scriind un brief de 3 KB pentru o schimbare de două linii.
Ocolul prin DeepSeek
Odată ce lucrătorii erau Sonnet, următoarea întrebare evidentă era dacă trebuie să fie neapărat un model Claude. Din 13 până în 18 septembrie am îndreptat lucrătorul către DeepSeek V4.1 Flash printr-un Claude Code headless, cu ANTHROPIC_BASE_URL setat către un endpoint compatibil, mai întâi prin OpenRouter și apoi nativ. Același format de brief, același format de raport, același arhitect. 2.732 de apeluri, 431M tokeni de intrare dintre care 88% erau citiri din cache, 1,7M tokeni de ieșire.
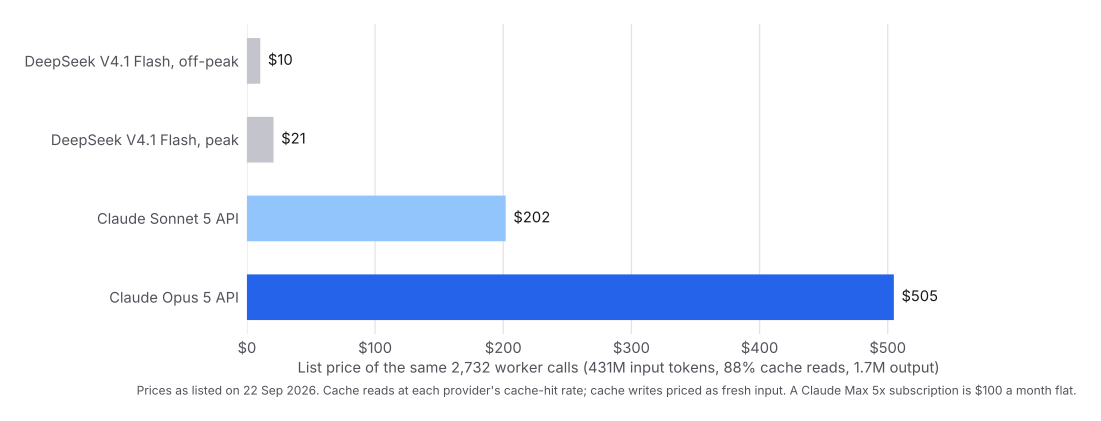
La prețurile de listă din 22 septembrie, acel trafic costă aproximativ $10 pe DeepSeek în afara orelor de vârf, $21 la vârf, $202 pe API-ul Sonnet și $505 pe API-ul Opus. Dacă aș plăti per token, acesta ar fi titlul articolului și l-aș fi păstrat.
Nu plătesc per token, și acesta este tot argumentul. Un abonament Max este $100 pe lună, indiferent dacă folosesc 30% din limita săptămânală sau 100%. Mutarea traficului lucrătorilor pe DeepSeek nu a scăzut factura cu un cent. A adăugat o a doua factură de $10 până la $21 pe săptămână peste ea, ca să economisească capacitate pe un plan a cărui capacitate o plătisem deja. Confundasem „mai ieftin decât API-ul" cu „mai ieftin decât ce plătesc", iar acestea nu sunt același lucru când ce plătești este fix. Comparația corectă pentru un abonat este DeepSeek față de un al doilea abonament, iar acolo un al doilea plan Claude sau un plan ChatGPT cu Codex costă cam cât o lună de utilizare moderată a DeepSeek și vine cu propria limită săptămânală, propriul model și fără măsurătoare de urmărit.
Calitatea a fost cealaltă jumătate. Cinci felii de backend s-au întors curate și au fost comise ca atare. O felie de frontend a eliminat un simbol exportat și a lăsat neatinși toți consumatorii lui, așa că arborele nu s-a compilat și o felie ulterioară a trebuit să curețe. Exact acesta este eșecul pe care îl are un model care execută o specificație și nu îl are un model care deduce forma unui component de la frații lui, iar skill-ul spune acum asta: schimbările de suprafață API partajată merg la Sonnet, iar regula lucrătorului sună așa: „nu elimina și nu redenumi niciodată un simbol exportat fără a migra fiecare consumator în aceeași rulare". DeepSeek Flash este un bun executant. Pattern-ul arhitectului are nevoie de un lucrător care observă când brief-ul a subestimat consumatorii, iar acesta este singurul lucru pe care un brief nu îl poate furniza.
Așa că tabelul de rutare de astăzi are două rânduri. Munca mecanică, munca de backend pe baza unui brief detaliat cu teste de satisfăcut, munca de frontend care urmează o gramatică de design existentă și orice schimbare a unei suprafețe API partajate merg la sonnet-implementer. Munca a cărei dificultate stă în raționament merge la opus-implementer: o condiție de cursă async, un refactor pe mai multe locuri a cărui corectitudine depinde de locuri pe care brief-ul nu le poate enumera, o migrare de backfill pe care niciun test individual nu o demonstrează. Rutează după formă, niciodată după risc. Riscul schimbă cât de atent este verificat diff-ul și dacă un om îl semnează. Nu schimbă niciodată cine îl scrie.
Bucla de verificare, acolo unde pattern-ul își merită sau își pierde rostul
Raportul unui lucrător este o afirmație. Bucla de verificare a skill-ului este scurtă și fiecare linie a venit din a fi pățit:
- Citește raportul și
git diff-ul real. Verifică încrucișat diffstat-ul citat de lucrător cu cel pe care îl vezi tu. - Rulează din nou tu însuți verificarea cheie atunci când afirmația contează.
- Ai găsit o problemă? Trimite corectura aceluiași lucrător. Își are încă contextul și continuă de unde s-a oprit. Nu o repara manual, nu porni unul nou.
- Două corecturi eșuate înseamnă că brief-ul a fost sub-specificat, nu că modelul este prea mic. Descompune, pune extractul lipsă în Context, rulează din nou. Nu urca la un model mai mare, pentru că va implementa aceeași neînțelegere mai fluent.
- Rulează porțile de verificare din scop înainte de a accepta ceva: testele atinse, linter-ul pe fișierele atinse, orice script de convenție pe care îl are repo-ul.
În transcrieri am trimis aproximativ o corectură per rulare de lucrător, 52 la 85 de rulări, iar 7 rulări Opus au atins limita lor de 160 de ture, fiecare pe o felie pe care aș împărți-o acum. Acestea sunt cele două numere pe care le urmăresc. Dacă corecturile per rulare cresc, brief-urile mele devin leneșe. Dacă lucrătorii ating limita, feliile mele sunt prea mari.
Ce să iei de aici
Dacă plătești per token: pune modelul scump pe decizii și verificare, pune unul ieftin pe implementare și prețuiește traficul lucrătorilor la listă înainte de a alege care model ieftin. Graficul cu patru bare este argumentul.
Dacă plătești un abonament: pattern-ul nu îți reduce numărul de tokeni. Mută tokenii de implementare către modelul care consumă cel mai încet limita săptămânală comună, păstrează limita Fable pentru munca pe care doar Fable ar trebui să o facă și oprește cel mai scump model al tău să își cheltuie turele tastând. Nu adăuga un API cu măsurare pe lateral ca să „economisești" capacitate pe care ai cumpărat-o deja. Dacă rămâi fără capacitate pentru lucrători, cumpără un al doilea abonament.
În oricare caz, regulile care au făcut ca asta să funcționeze au fost cele plictisitoare. Fără suite complete de teste într-un lucrător. Limitează turele. Felii mici, brief-uri scurte. Corectează același lucrător o dată, apoi repară brief-ul.
Skill-ul, cele trei definiții de agent și hook-ul de protecție sunt la github.com/LivinTribunal/architect-skill sub MIT. Skill-ul companion care îi spune lucrătorului cum să scrie cod care se potrivește cu repo-ul în care ajunge este grain-skill , iar articolul despre el este cod conform cu repo-ul .
Metodă
Tot ce descrie articolul este în github.com/LivinTribunal/architect-skill : skill-ul în sine, șablonul de brief, tabelul de rutare, cele trei definiții de agent implementator cu limitele lor de ture și regulile de context, și hook-ul de protecție. Instalează-l și ai configurația din care au venit cifrele de mai jos.
Sesiunile sunt transcrieri JSONL de Claude Code din 19 august până în 22 septembrie 2026, entrypoint cli, trei sau mai multe prompturi de utilizator. O sesiune este clasificată ca sesiune de arhitect dacă a generat opus-implementer, opus-implementer-xhigh sau sonnet-implementer, a rulat un lucrător ds-slice, a invocat skill-ul de arhitect sau a trimis un mesaj care conține un brief de implementare către un agent de uz general, ceea ce este modul în care funcționau primele săptămâni înainte de a exista agenții cu nume. Rulările de lucrători sunt transcrierile subagenților din directorul fiecărei sesiuni. Consumul este deduplicat după id-ul cererii și ponderat astfel: intrare nouă 1, scriere în cache de cinci minute 1,25, scriere în cache de o oră 2, citire din cache 0,1. „Editare de cod" este un apel Edit sau Write pe un fișier sursă .py, .ts, .tsx, .js, .sql sau similar, excluzând markdown și orice se află sub ~/.claude. Prețurile DeepSeek sunt prețurile de listă native din 22 septembrie 2026, off-peak și peak, cu citirile din cache la rata de hit a cache-ului și scrierile în cache prețuite ca intrare nouă; prețurile API Claude sunt prețurile de listă publicate pentru Opus 5 și Sonnet 5, cu citirile din cache la o zecime din intrare. Săptămâna 21 septembrie reprezintă două zile de date.
