


La versione breve
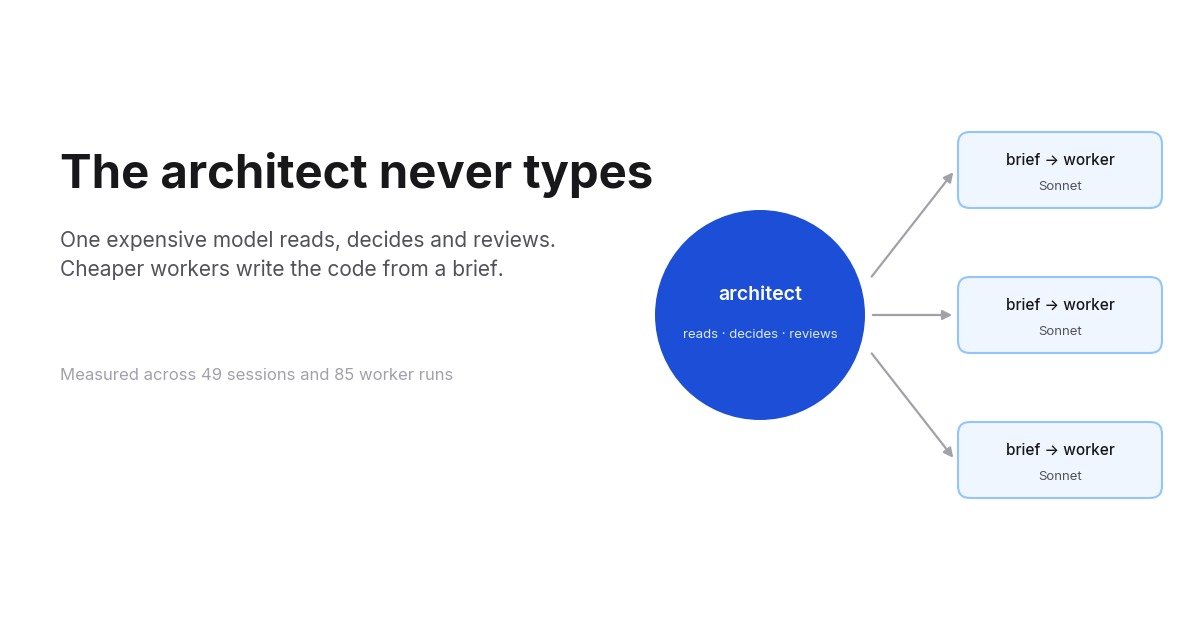
- Per cinque settimane ho fatto girare il mio agente di coding in modalità divisa: il modello principale, Opus e poi Fable, legge, decide e revisiona, mentre un agente worker scrive il codice da un brief scritto. La chiamo pattern architect ed è ormai una skill pubblica: architect-skill su GitHub , con licenza MIT.
- Il modello principale ha smesso di digitare. In 49 sessioni architect ha modificato un file sorgente 6 volte su 1.467 prompt. In 275 sessioni normali nelle stesse settimane ne ha modificati 244 su 3.081 prompt. Cioè 0,4 contro 7,9 ogni 100 prompt.
- I token totali per prompt non sono calati. Sono aumentati, e parecchio, per due settimane, poi sono tornati al livello delle sessioni normali. Quello che è cambiato è chi li ha spesi: la quota Opus dei token dei worker è passata dal 100% a circa il 4%, e dal 14 settembre un prompt in una sessione architect costa 364k token ponderati sul modello principale, 205k sui worker Sonnet e 80k sui worker Opus.
- È questa divisione che interessa a un abbonamento. Claude Max misura il suo limite settimanale su tutti i modelli al costo di ciascun modello, quindi un token Sonnet lo consuma al 40% di un token Opus, e Fable ha un limite settimanale separato e più stretto che nessun worker tocca.
- Ho anche provato a instradare i worker verso DeepSeek tramite un Claude Code headless. Ai prezzi di listino, lo stesso traffico costava $10 invece di $202 su Sonnet o $505 su Opus. Con un abbonamento quel risparmio non esiste, perché l’abbonamento era già pagato. L’ho abbandonato. Se paghi a token, leggi comunque quella sezione, perché i numeri sono il punto.
Questo è il terzo post di una serie. Il primo misurava cosa ha fatto un’impostazione a una finestra di contesto, 17% in meno di token , e il secondo spiega quanto costa una finestra di contesto e perché. Questo riguarda l’altra leva: non quanto è grande il contesto, ma quale modello lo tiene.
Che cos’è il pattern
Una sessione di un agente di coding fa due tipi di lavoro. Pensa: legge il codebase, capisce cosa cambiare, decide nomi, firme e casi limite, controlla il diff. E digita: scrive il codice, esegue il file di test, sistema il lint. Il pensiero è dove un modello di frontiera guadagna il suo prezzo. Il digitare no. Gran parte è determinata dalla decisione che lo precede, e un modello più piccolo esegue un piano già deciso più o meno come uno grande.
Quindi la skill divide la sessione. Il modello principale è l’architect. Fa tutto nel loop principale tranne modificare un file sorgente:
- Interroga il requisito ed esplora il codebase.
- Prende le decisioni di design: approccio, flusso dei dati, nomi, firme, casi limite. Il pattern esistente più vicino da rispecchiare. La modifica più piccola che risolve la causa radice.
- Scompone in slice che possiedono insiemi di file disgiunti.
- Scrive un brief di implementazione per slice.
- Revisiona il diff che torna indietro, esegue i gate, fa il commit.
Il worker è un subagente con una finestra di contesto nuova. Riceve il brief e nient’altro, scrive il codice, esegue i file di test indicati dal brief e restituisce un breve report strutturato. Poi il suo contesto viene buttato via. Non entra mai a far parte della cronologia della sessione principale, cosa che conta più di quanto sembri: tutto ciò che la sessione principale legge viene reinviato a ogni chiamata successiva, quindi un worker che legge dodici file e un log di test nel proprio contesto tiene tutto questo fuori dalla bolletta dell’architect.
Il brief è l’intero contratto. Il mio ha sette campi e la skill riguarda soprattutto compilarli bene:
## Implementation brief: <slice>
Goal: one sentence, observable outcome
Context: what exploration found: excerpts, the pattern to mirror, line anchors, gotchas
Files: paths to create/modify, exclusive ownership for this slice
Design: the decided approach: data flow, names, signatures, edge cases
Constraints: project rules that apply: style, layers, security
Out of scope: what not to touch, including files owned by other slices
Verify: exact commands and expected outcome
Un brief contiene decisioni, non opzioni. Se sto ancora soppesando due approcci, non sono pronto a delegare.
C’è una sola eccezione. La delega ha un costo fisso: scrivere il brief, l’avvio del worker, leggere il report, revisionare il diff. La correzione di un refuso, un valore di configurazione, un bump di versione, la cancellazione di una chiave morta, una correzione di una riga e il suo test di regressione: per questi l’architect modifica direttamente, perché il brief costerebbe più della modifica. Il criterio è il costo, non il numero di righe. Nel momento in cui la modifica richiede un giudizio di design o tocca un percorso che il repo segnala come critico, va a un worker.

Pronto a far crescere il tuo business?
Inizia oggi la tua prova gratuita e vedi i risultati in pochi giorni.
Perché un abbonamento cambia l’aritmetica
Se paghi a token, il caso è semplice. Opus 5 è a listino a $5 per milione di token di input e $25 per milione di output; Sonnet 5 a $2 e $10. Ogni token di implementazione che passa da Opus a Sonnet costa il 40% di prima.
Io pago un abbonamento, e lì il caso è diverso e, credo, più forte. Claude Max ha due limiti settimanali, non uno: un limite su tutti i modelli, consumato da ogni token al costo di quel modello, e un limite separato e più stretto che solo Fable consuma. Opus non ha un limite proprio. Questo dà alla divisione due effetti. Il lavoro che fa un worker Sonnet consuma il limite condiviso al 40% del costo di un worker Opus, quindi spostare due terzi dei token di una sessione su Sonnet fa durare più a lungo la settimana anche se il conteggio totale dei token resta invariato. E quando l’architect è Fable, ogni token che non spende digitando è un token lasciato sul limite che si esaurisce per primo. Quindi anche se il pattern architect spendesse esattamente lo stesso numero di token di una sessione normale, chi li spende deciderebbe comunque quando finisce la settimana.
Quel “anche se” si è rivelato fare molto lavoro.
Cosa dicono i transcript
Claude Code scrive ogni sessione in un transcript JSONL, e ogni esecuzione di un worker in un file gemello nella directory della sessione. Li ho tutti dal 19 agosto: 324 sessioni interattive con tre o più prompt, di cui 49 usavano il pattern, cioè avevano generato un agente implementatore o gli avevano inviato un brief. I token sono ponderati come lo è la bolletta: input fresco a 1, scritture in cache a 1,25 o 2, letture dalla cache a 0,1. Le esecuzioni CI sono escluse.
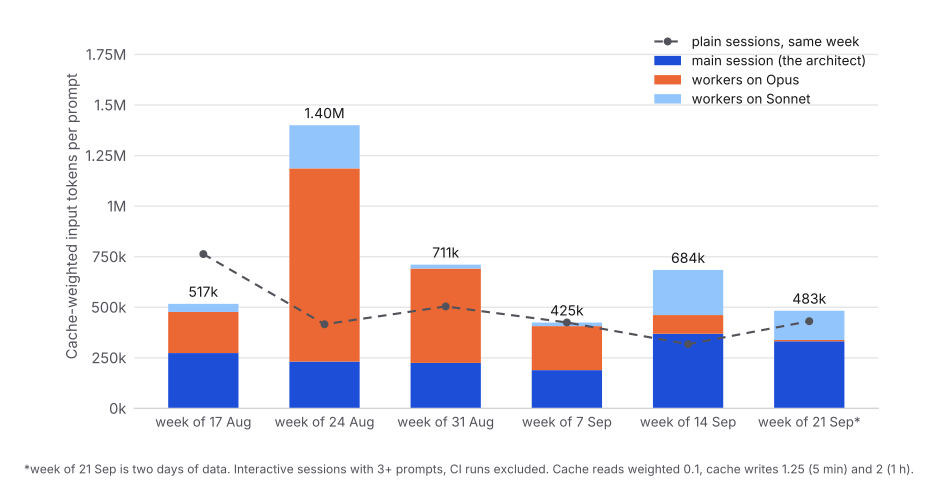
Leggilo da sinistra a destra e per le prime due settimane non è una storia di successo.
Nella settimana del 24 agosto una sessione architect costava 1,40M di token ponderati per prompt. Le sessioni normali nella stessa settimana costavano 0,42M. Tre volte e mezza di più, e quasi tutto l’eccesso era arancione: i worker Opus. Avevo dato ai worker un buon modello e nessuna regola, e si sono comportati come un buon modello senza regole. L’esecuzione mediana di un worker Opus quella settimana era di 176 turni. Diverse eseguivano l’intera suite di test del backend, che mette circa 100 KB di output in un contesto che viene reinviato a ogni turno successivo. Una sessione con sei worker del 14 settembre, quando avevo già iniziato a stringere le regole, ha comunque bruciato 245M di token di input su 1.585 turni per produrre circa seimila righe di diff. Il prompt caching funzionava con un hit rate del 91,6% per tutto il tempo. La bolletta era volume, non prezzo.
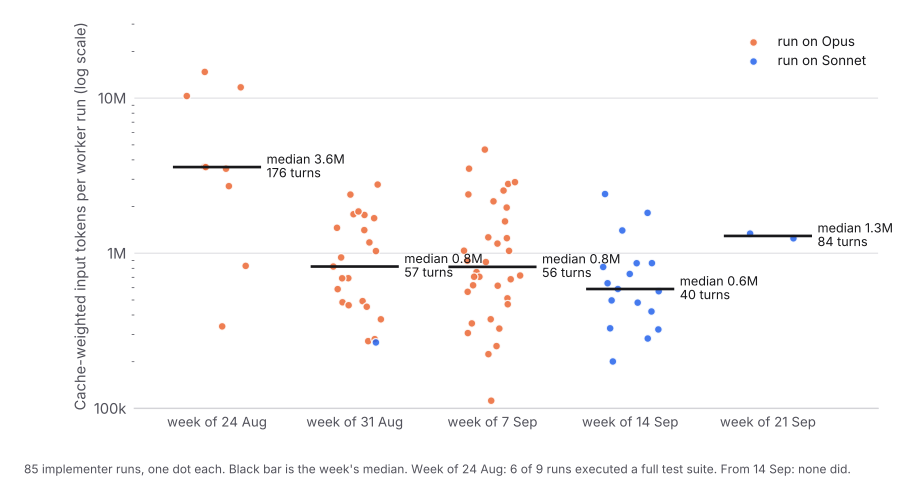
La striscia dei worker mostra dove sono atterrate le regole. Tre hanno fatto quasi tutto il lavoro, e le ho scritte nelle definizioni degli agenti invece che nel brief, così valgono che io me ne ricordi o no:
- Un worker non esegue mai una suite di test completa. Esegue i file di test indicati dal suo brief. I gate li esegue l’architect.
maxTurnsè limitato nella definizione dell’agente, 140 per Sonnet e 160 per Opus. Una slice che richiede 250 turni è stata briefata male.- Una slice resta sotto i circa dodici file e il brief sotto gli 8 KB circa. Anche il brief viene reinviato a ogni turno.
Alla settimana del 31 agosto l’esecuzione mediana di un worker era di 57 turni e 0,8M di token ponderati. Dal 14 settembre, quando ho spostato la rotta predefinita su Sonnet, era di 40 turni e 0,6M, e nessun worker ha più eseguito una suite completa.
Il totale per prompt ha seguito: 711k, 425k, 684k, 483k nelle ultime quattro settimane, contro sessioni normali a 505k, 425k, 318k, 431k. Le sessioni architect ora costano più o meno quanto costano le sessioni normali. Un po’ di più in due delle quattro settimane, un po’ meno in una. Quello che comprano in cambio sono i due grafici successivi.
Iscriviti alla nostra newsletter
Ricevi gratuitamente gli ultimi consigli, tendenze e offerte.
Il modello principale ha smesso di digitare
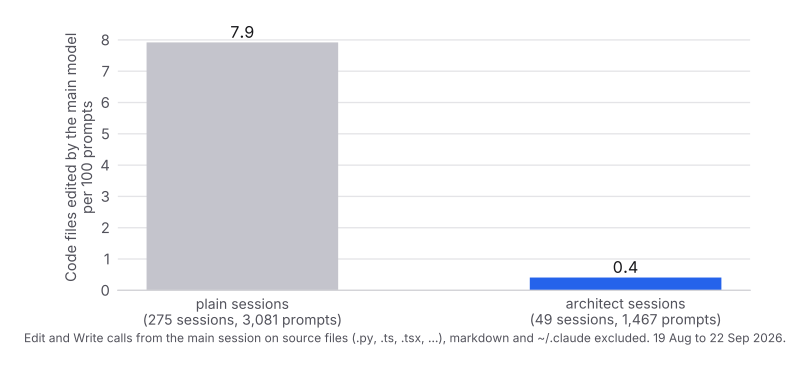
Questo è il numero che volevo cambiare, ed è cambiato. Nelle sessioni normali il modello principale ha fatto 244 chiamate Edit o Write su file sorgente su 3.081 prompt. Nelle sessioni architect ne ha fatte 6 su 1.467. Le 6 sono tutte eccezioni di piccole modifiche che posso giustificare.
Nel frattempo i worker erano produttivi. Le 85 esecuzioni dei worker hanno fatto 2.510 modifiche a file sorgente. Contando insieme loop principale e worker, una sessione architect ha prodotto 2.516 modifiche al codice da 1.467 prompt; le sessioni normali ne hanno prodotte 943 da 3.081. Per modifica al codice, una sessione architect ha speso 403k token ponderati in totale e 330k sul modello della famiglia Opus. Una sessione normale ne ha spesi 1.410k e 1.324k. Voglio essere prudente con questo confronto, perché le due popolazioni non fanno lo stesso lavoro: una sessione viene classificata come architect se delega codice, quindi le sessioni architect sono per costruzione ricche di coding, mentre le sessioni normali includono ricerca, revisioni e debug che non modificano mai nulla. Leggilo come “il pattern fa scrivere molto codice per token”, non come un’affermazione di efficienza quadrupla.
L’affermazione più pulita è la divisione tra modelli. Dal 14 settembre, un prompt in una sessione architect costa 364k token ponderati nel loop principale, 205k nei worker Sonnet e 80k nei worker Opus. La quota dei worker Opus su tutti i token dei worker era del 100% ad agosto e di circa il 4% nella settimana del 21 settembre. Su un piano Max significa che il limite settimanale condiviso viene consumato al costo di Sonnet invece che di Opus per quasi tutto il lavoro di implementazione, e che nulla di esso tocca il limite di Fable.
Due cose non sono migliorate, e preferisco dirlo piuttosto che lasciare che i grafici suggeriscano il contrario. Il contesto della sessione principale non si è ridotto: le sessioni architect hanno compattato 8,7 volte ogni 100 prompt contro 4,7 delle sessioni normali, perché l’architect legge molto prima di briefare. E il pattern è più lento in termini di tempo reale sulle attività piccole, perché l’avvio del worker e il report sono minuti che non paghi quando fai semplicemente la modifica. L’eccezione per le piccole modifiche esiste perché la prima versione della skill non ne aveva una, e mi sono visto scrivere un brief da 3 KB per una modifica di due righe.
La deviazione DeepSeek
Una volta che i worker erano Sonnet, la domanda successiva ovvia era se dovessero essere per forza un modello Claude. Dal 13 al 18 settembre ho puntato il worker su DeepSeek V4.1 Flash tramite un Claude Code headless con ANTHROPIC_BASE_URL impostato su un endpoint compatibile, prima attraverso OpenRouter e poi in modo nativo. Stesso formato di brief, stesso formato di report, stesso architect. 2.732 chiamate, 431M di token di input di cui l'88% erano letture dalla cache, 1,7M di token di output.
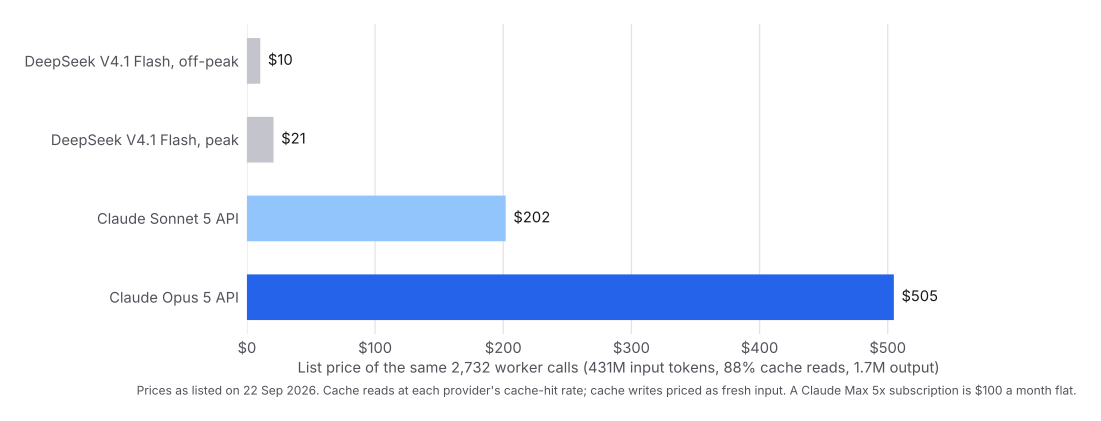
Ai prezzi di listino del 22 settembre, quel traffico costa circa $10 su DeepSeek fuori picco, $21 in picco, $202 sull’API Sonnet e $505 sull’API Opus. Se pagassi a token, questo sarebbe il titolo del post e l’avrei tenuto.
Io non pago a token, e questo è tutto l’argomento. Un abbonamento Max costa $100 al mese sia che io usi il 30% del limite settimanale sia che ne usi il 100%. Spostare il traffico dei worker su DeepSeek non ha ridotto quella bolletta di un centesimo. Ha aggiunto una seconda bolletta da $10 a $21 a settimana sopra di essa, per risparmiare capacità su un piano la cui capacità avevo già pagato. Avevo confuso “più economico dell’API” con “più economico di quello che pago”, e non sono la stessa cosa quando quello che paghi è fisso. Il confronto giusto per un abbonato è DeepSeek contro un secondo abbonamento, e lì un secondo piano Claude o un piano ChatGPT con Codex costa più o meno quanto un mese di uso moderato di DeepSeek e arriva con il proprio limite settimanale, il proprio modello e nessun conteggio da tenere d’occhio.
La qualità è stata l’altra metà. Cinque slice di backend sono tornate pulite e sono state committate così come erano. Una slice di frontend ha rimosso un simbolo esportato e ha lasciato intatti tutti i suoi consumatori, quindi l’albero non compilava e una slice successiva ha dovuto ripulire. È esattamente il tipo di errore che fa un modello che esegue una specifica e che non fa un modello che inferisce la forma di un componente dai suoi simili, e la skill ora lo dice: le modifiche alla superficie API condivisa vanno a Sonnet, e la regola per i worker recita “non rimuovere mai o rinominare un simbolo esportato senza migrare ogni consumatore nella stessa esecuzione”. DeepSeek Flash è un buon esecutore. Il pattern architect ha bisogno di un worker che si accorga quando il brief ha sottostimato i consumatori, e questa è l’unica cosa che un brief non può fornire.
Quindi la tabella di routing oggi ha due righe. Il lavoro ripetitivo, il lavoro di backend su un brief dettagliato con test da soddisfare, il lavoro di frontend che segue una grammatica di design esistente e qualsiasi modifica a una superficie API condivisa vanno a sonnet-implementer. Il lavoro la cui difficoltà sta nel ragionamento va a opus-implementer: una race asincrona, un refactoring multi-sito la cui correttezza dipende da siti che il brief non può enumerare, una migrazione di backfill che nessun singolo test dimostra. Instrada per forma, mai per rischio. Il rischio cambia quanto duramente viene revisionato il diff e se un umano lo firma. Non cambia mai chi lo scrive.
Il ciclo di revisione, che è dove il pattern guadagna o perde il suo valore
Il report di un worker è un’affermazione. Il ciclo di revisione della skill è breve e ogni riga nasce da una scottatura:
- Leggi il report e il vero
git diff. Verifica in modo incrociato il diffstat citato dal worker con quello che vedi tu. - Riesegui tu stesso la verifica chiave quando l’affermazione conta.
- Hai trovato un problema? Invia la correzione allo stesso worker. Ha ancora il suo contesto e riprende da dove si era fermato. Non correggerlo a mano, non generarne uno nuovo.
- Due correzioni fallite significano che il brief era sottospecificato, non che il modello è troppo piccolo. Scomponi, metti l’estratto mancante nel Context, riesegui. Non salire a un modello più grande, perché implementerà lo stesso fraintendimento con più fluidità.
- Esegui i gate con ambito ristretto prima di accettare qualsiasi cosa: i test toccati, il linter sui file toccati, qualsiasi script di convenzione che il repo porta con sé.
Nei transcript ho inviato circa una correzione per esecuzione di un worker, 52 su 85 esecuzioni, e 7 esecuzioni Opus hanno raggiunto il loro tetto di 160 turni, tutte su una slice che oggi dividerei. Questi sono i due numeri che tengo d’occhio. Se le correzioni per esecuzione salgono, i miei brief stanno diventando pigri. Se i worker raggiungono il tetto, le mie slice sono troppo grandi.
Cosa portarsi a casa
Se paghi a token: metti il modello costoso sulle decisioni e sulla revisione, metti uno economico sull’implementazione, e prezza il traffico dei tuoi worker a listino prima di scegliere quale economico. Il grafico a quattro barre è l’argomento.
Se paghi un abbonamento: il pattern non riduce il tuo conteggio di token. Sposta i token di implementazione sul modello che consuma più lentamente il limite settimanale condiviso, conserva il limite Fable per il lavoro che solo Fable dovrebbe fare e impedisce al tuo modello più costoso di spendere i suoi turni digitando. Non aggiungere un’API a consumo di fianco per “risparmiare” capacità che hai già comprato. Se esaurisci la capacità dei worker, compra un secondo abbonamento.
In ogni caso, le regole che l’hanno fatto funzionare erano quelle noiose. Nessuna suite di test completa in un worker. Limita i turni. Slice piccole, brief brevi. Correggi lo stesso worker una volta, poi sistema il brief.
La skill, le tre definizioni degli agenti e l’hook di guardia sono su github.com/LivinTribunal/architect-skill con licenza MIT. La skill complementare che dice al worker come scrivere codice che si adatti al repo in cui atterra è grain-skill , e il post che ne parla è codice che segue la vena .
Metodo
Tutto ciò che il post descrive è su github.com/LivinTribunal/architect-skill : la skill stessa, il template del brief, la tabella di routing, le tre definizioni degli agenti implementatori con i loro tetti di turni e le regole di contesto, e l’hook di guardia. Installalo e hai la configurazione da cui derivano i numeri qui sotto.
Le sessioni sono transcript JSONL di Claude Code dal 19 agosto al 22 settembre 2026, entrypoint cli, tre o più prompt utente. Una sessione è classificata come architect se ha generato opus-implementer, opus-implementer-xhigh o sonnet-implementer, ha eseguito un worker ds-slice, ha invocato la skill architect, o ha inviato un messaggio contenente un brief di implementazione a un agente general-purpose, che è come funzionavano le prime settimane prima che esistessero gli agenti con nome. Le esecuzioni dei worker sono i transcript dei subagenti nella directory di ogni sessione. L’uso è deduplicato per request id e ponderato con input fresco 1, scrittura in cache a cinque minuti 1,25, scrittura in cache a un’ora 2, lettura dalla cache 0,1. “Modifica al codice” è una chiamata Edit o Write su un file sorgente .py, .ts, .tsx, .js, .sql o simile, escludendo markdown e qualsiasi cosa sotto ~/.claude. I prezzi DeepSeek sono i prezzi di listino nativi del 22 settembre 2026, fuori picco e in picco, con le letture dalla cache al costo di cache hit e le scritture in cache prezzate come input fresco; i prezzi dell’API Claude sono i prezzi di listino pubblicati di Opus 5 e Sonnet 5 con le letture dalla cache a un decimo dell’input. La settimana del 21 settembre è di due giorni di dati.
