


Bản tóm tắt
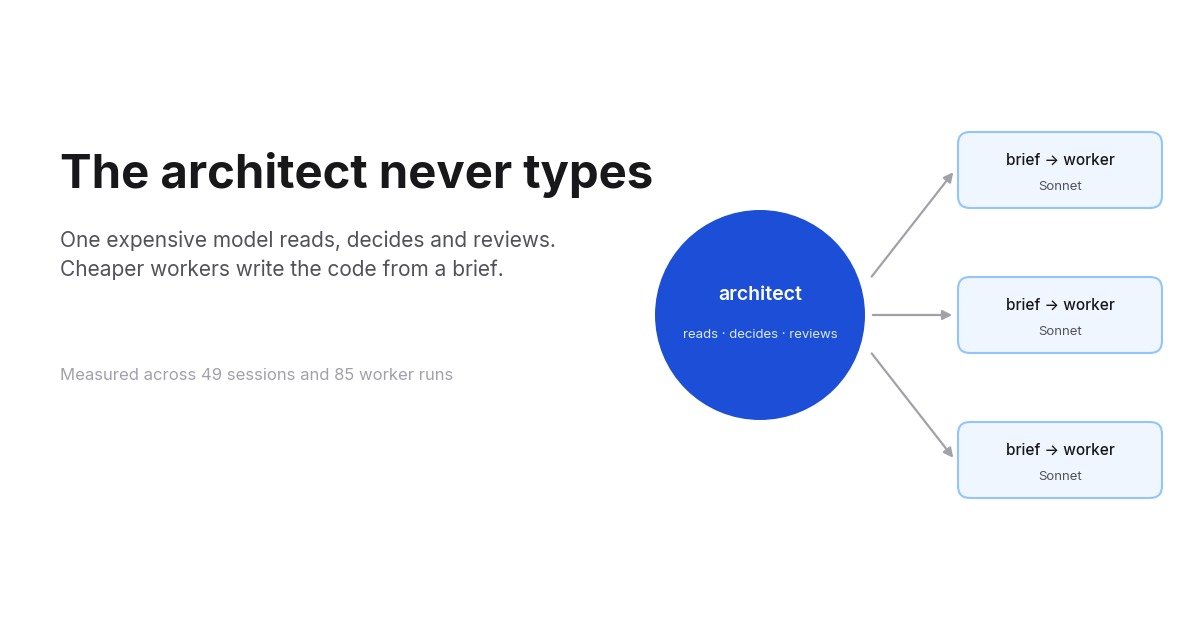
- Trong năm tuần, tôi chạy coding agent của mình theo cách tách vai: mô hình chính, Opus và sau đó là Fable, đọc, quyết định và review, còn một worker agent viết code từ một bản brief. Tôi gọi đó là mô hình architect và nó hiện là một skill công khai: architect-skill trên GitHub , giấy phép MIT.
- Mô hình chính ngừng gõ code. Qua 49 phiên architect, nó sửa file nguồn 6 lần trong 1,467 prompt. Trong 275 phiên thường cùng những tuần đó, nó sửa 244 file trong 3,081 prompt. Tức là 0.4 so với 7.9 trên mỗi 100 prompt.
- Tổng token mỗi prompt không giảm. Chúng tăng, tăng tệ, trong hai tuần, rồi trở về mức của các phiên thường. Điều thay đổi là ai đã tiêu số token đó: phần của Opus trong token của worker giảm từ 100% xuống khoảng 4%, và kể từ 14 tháng 9, một prompt trong phiên architect tốn 364k token có trọng số ở mô hình chính, 205k ở worker Sonnet và 80k ở worker Opus.
- Sự phân chia đó mới là điều mà gói đăng ký quan tâm. Claude Max tính giới hạn hàng tuần cho tất cả mô hình theo mức giá của từng mô hình, nên một token Sonnet rút giới hạn đó ở mức 40% của một token Opus, còn Fable có giới hạn hàng tuần riêng, chặt hơn, mà không worker nào đụng tới.
- Tôi cũng đã thử chuyển các worker sang DeepSeek thông qua một Claude Code headless. Tính theo giá niêm yết, cùng lưu lượng đó là 10 đô thay vì 202 đô trên Sonnet hay 505 đô trên Opus. Với gói đăng ký thì khoản tiết kiệm đó không tồn tại, vì gói đã được trả tiền rồi. Tôi đã bỏ nó. Nếu bạn trả tiền theo token, hãy đọc phần đó, vì các con số chính là điểm mấu chốt.
Đây là bài thứ ba trong một loạt bài. Bài đầu đo xem một thiết lập đã làm gì với context window, ít hơn 17% token , và bài thứ hai giải thích một context window tốn bao nhiêu và vì sao. Bài này nói về một đòn bẩy khác: không phải ngữ cảnh lớn đến đâu, mà là mô hình nào đang giữ nó.
Mô hình này là gì
Một phiên coding agent làm hai loại công việc. Nó suy nghĩ: đọc codebase, tìm ra cần thay đổi gì, quyết định tên gọi, chữ ký hàm và các trường hợp biên, kiểm tra diff. Và nó gõ: viết code, chạy file test, sửa lỗi lint. Phần suy nghĩ là nơi một mô hình tiên tiến xứng đáng với cái giá của nó. Phần gõ thì không. Phần lớn phần gõ đã được quyết định bởi quyết định trước đó, và một mô hình nhỏ hơn thực thi một kế hoạch đã định gần như tốt ngang một mô hình lớn.
Vì vậy skill tách phiên làm việc ra. Mô hình chính là architect. Nó làm mọi thứ trong vòng lặp chính, trừ việc sửa file nguồn:
- Thẩm vấn yêu cầu và khám phá codebase.
- Đưa ra các quyết định thiết kế: cách tiếp cận, luồng dữ liệu, tên gọi, chữ ký hàm, các trường hợp biên. Mẫu hiện có gần nhất để noi theo. Thay đổi nhỏ nhất khắc phục nguyên nhân gốc.
- Chia nhỏ thành các slice sở hữu những tập file không giao nhau.
- Viết một bản brief triển khai cho mỗi slice.
- Review diff trả về, chạy các gate, commit.
Worker là một subagent với một context window mới. Nó nhận bản brief và không gì khác, viết code, chạy những file test mà brief nêu tên, rồi trả về một báo cáo có cấu trúc ngắn. Sau đó ngữ cảnh của nó bị vứt đi. Nó không bao giờ trở thành một phần lịch sử của phiên chính, điều này quan trọng hơn vẻ ngoài của nó: mọi thứ phiên chính đọc đều được gửi lại trong mọi lần gọi sau đó, nên một worker đọc mười hai file và một log test trong ngữ cảnh riêng của nó sẽ giữ tất cả những thứ đó khỏi hoá đơn của architect.
Bản brief là toàn bộ bản hợp đồng. Bản của tôi có bảy trường và skill chủ yếu là về việc điền chúng cho tốt:
## Implementation brief: <slice>
Goal: one sentence, observable outcome
Context: what exploration found: excerpts, the pattern to mirror, line anchors, gotchas
Files: paths to create/modify, exclusive ownership for this slice
Design: the decided approach: data flow, names, signatures, edge cases
Constraints: project rules that apply: style, layers, security
Out of scope: what not to touch, including files owned by other slices
Verify: exact commands and expected outcome
Một bản brief chứa các quyết định, không phải các lựa chọn. Nếu tôi vẫn còn cân nhắc giữa hai cách tiếp cận thì tôi chưa sẵn sàng giao việc.
Có một ngoại lệ. Việc giao việc có một chi phí cố định: viết brief, khởi động worker, đọc báo cáo, review diff. Một lỗi chính tả, một giá trị cấu hình, một lần tăng phiên bản, xoá một key chết, một sửa lỗi một dòng và test hồi quy của nó: với những việc đó architect sửa trực tiếp, vì bản brief sẽ tốn hơn cả thao tác sửa. Phép thử là chi phí, không phải số dòng. Khoảnh khắc mà việc sửa cần một phán đoán thiết kế hoặc đụng đến một đường dẫn mà repo đánh dấu là quan trọng, nó sẽ được giao cho worker.

Sẵn sàng phát triển doanh nghiệp của bạn?
Bắt đầu dùng thử miễn phí ngay hôm nay và xem kết quả trong vài ngày.
Vì sao gói đăng ký thay đổi phép tính
Nếu bạn trả tiền theo token, lập luận rất đơn giản. Opus 5 niêm yết ở mức 5 đô cho mỗi triệu token đầu vào và 25 đô cho mỗi triệu token đầu ra; Sonnet 5 là 2 và 10. Mỗi token triển khai được chuyển từ Opus sang Sonnet chỉ còn tốn 40% so với trước.
Tôi trả tiền theo gói đăng ký, và ở đó lập luận khác đi, và tôi nghĩ là mạnh hơn. Claude Max có hai giới hạn hàng tuần, không phải một: một giới hạn cho tất cả mô hình, bị mọi token rút theo mức giá của mô hình đó, và một giới hạn riêng, chặt hơn, mà chỉ Fable rút. Opus không có giới hạn riêng. Điều đó cho việc tách vai hai tác dụng. Công việc mà một worker Sonnet làm sẽ rút giới hạn chung ở mức 40% so với mức mà một worker Opus sẽ rút, nên chuyển hai phần ba số token của một phiên sang Sonnet khiến tuần đó kéo dài hơn ngay cả khi tổng số token không đổi. Và khi architect là Fable, mỗi token nó không tiêu vào việc gõ là một token còn lại trên giới hạn cạn trước tiên. Nên ngay cả khi mô hình architect tiêu đúng số token như một phiên thường, việc ai tiêu số token đó vẫn sẽ quyết định khi nào tuần kết thúc.
Cái “ngay cả khi” đó hoá ra lại đang gánh rất nhiều việc.
Transcript nói gì
Claude Code ghi mọi phiên vào một transcript JSONL, và mọi lần chạy worker vào một file nằm cùng cấp trong thư mục của phiên. Tôi có tất cả chúng từ 19 tháng 8: 324 phiên tương tác với ba prompt trở lên, trong đó 49 phiên dùng mô hình này, nghĩa là chúng đã khởi tạo một implementer agent hoặc gửi một bản brief cho nó. Token được tính trọng số theo cách hoá đơn tính: input mới hệ số 1, ghi cache 1.25 hoặc 2, đọc cache 0.1. Các lần chạy CI bị loại trừ.
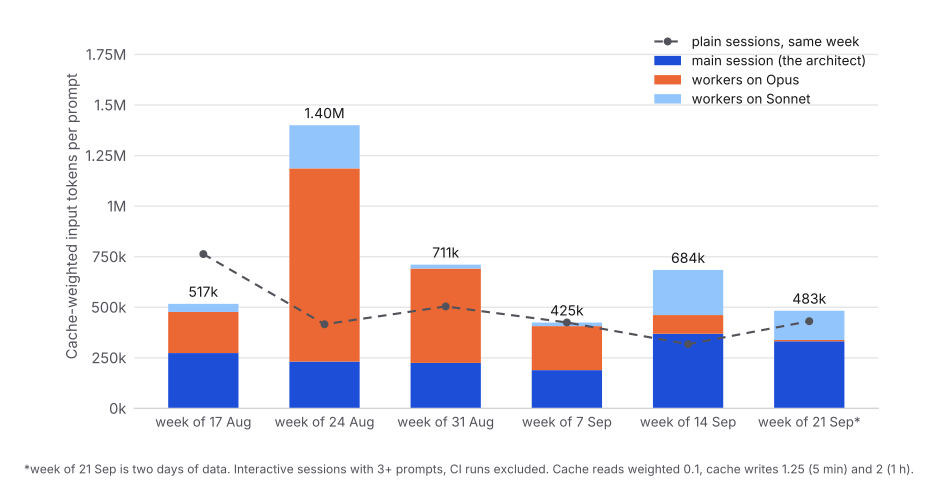
Đọc từ trái sang phải và nó không phải một câu chuyện thành công trong hai tuần đầu.
Trong tuần 24 tháng 8, một phiên architect tốn 1.40M token có trọng số mỗi prompt. Các phiên thường cùng tuần đó tốn 0.42M. Nhiều gấp ba lần rưỡi, và gần như toàn bộ phần vượt trội là màu cam: worker Opus. Tôi đã đưa cho các worker một mô hình tốt và không có quy tắc nào, và chúng hành xử như một mô hình tốt không có quy tắc. Trung vị một lần chạy worker Opus trong tuần đó là 176 lượt. Một số lần chạy cả bộ test backend đầy đủ, thứ đưa khoảng 100 KB kết quả vào một ngữ cảnh được gửi lại trong mọi lượt sau đó. Một phiên sáu worker vào ngày 14 tháng 9, sau khi tôi đã bắt đầu siết lại mọi thứ, vẫn đốt 245M token đầu vào qua 1,585 lượt để tạo ra khoảng sáu nghìn dòng diff. Prompt caching vẫn hoạt động với tỷ lệ trúng 91.6% suốt thời gian đó. Hoá đơn là do khối lượng, không phải do giá.
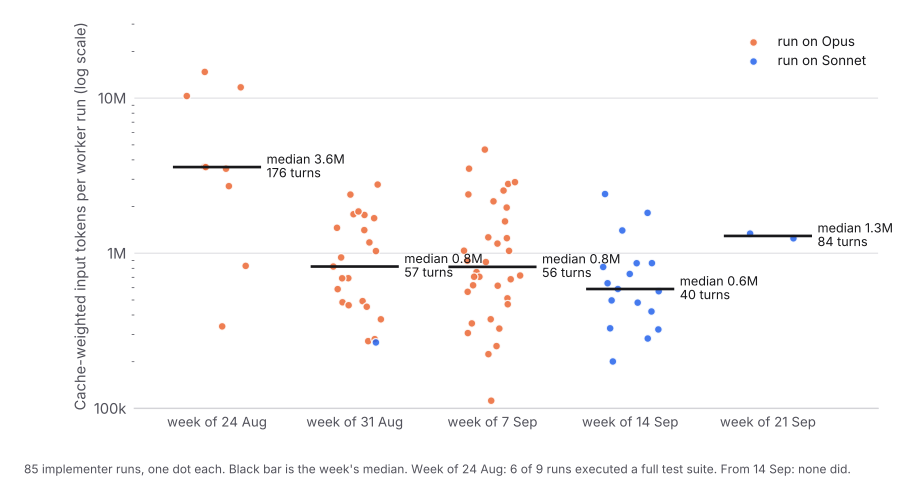
Dải của worker cho thấy các quy tắc đã tác động ở đâu. Ba quy tắc làm phần lớn công việc, và tôi đã viết chúng vào định nghĩa agent thay vì vào bản brief, để chúng luôn được áp dụng dù tôi có nhớ hay không:
- Worker không bao giờ chạy bộ test đầy đủ. Nó chạy những file test mà brief của nó nêu tên. Architect chạy các gate.
maxTurnsđược giới hạn trong định nghĩa agent, 140 cho Sonnet và 160 cho Opus. Một slice cần 250 lượt là một slice được viết brief sai.- Một slice giữ dưới khoảng mười hai file, và bản brief dưới khoảng 8 KB. Bản brief cũng được gửi lại mỗi lượt.
Đến tuần 31 tháng 8, trung vị một lần chạy worker là 57 lượt và 0.8M token có trọng số. Từ 14 tháng 9, khi tôi chuyển tuyến mặc định sang Sonnet, nó là 40 lượt và 0.6M, và không worker nào chạy bộ test đầy đủ kể từ đó.
Tổng theo mỗi prompt đi theo sau: 711k, 425k, 684k, 483k trong bốn tuần cuối, so với các phiên thường ở mức 505k, 425k, 318k, 431k. Các phiên architect hiện tốn khoảng bằng các phiên thường. Hơi nhiều hơn trong hai tuần trong số bốn tuần, hơi ít hơn trong một tuần. Thứ mà chúng đổi lấy cho điều đó là hai biểu đồ tiếp theo.
Tham gia bản tin của chúng tôi
Nhận các mẹo, xu hướng và ưu đãi mới nhất miễn phí.
Mô hình chính đã ngừng gõ code
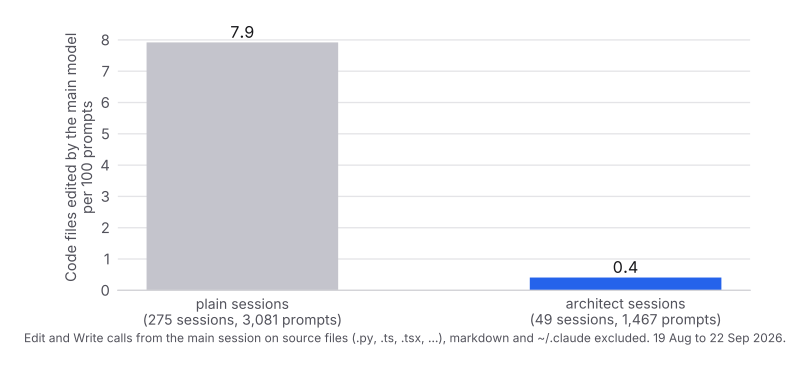
Đây là con số tôi đặt ra để thay đổi và nó đã thay đổi. Trong các phiên thường, mô hình chính thực hiện 244 lần gọi Edit hoặc Write trên các file nguồn qua 3,081 prompt. Trong các phiên architect, nó thực hiện 6 lần qua 1,467 prompt. Cả 6 lần đều là các ngoại lệ sửa nhỏ mà tôi có thể giải thích được.
Trong khi đó các worker lại làm việc hiệu quả. 85 lần chạy worker thực hiện 2,510 chỉnh sửa file nguồn. Tính cả vòng lặp chính và các worker, một phiên architect tạo ra 2,516 chỉnh sửa code từ 1,467 prompt; các phiên thường tạo ra 943 từ 3,081. Tính trên mỗi chỉnh sửa code, một phiên architect tiêu tổng cộng 403k token có trọng số và 330k ở mô hình thuộc họ Opus. Một phiên thường tiêu 1,410k và 1,324k. Tôi muốn cẩn thận với so sánh đó, vì hai nhóm này không làm cùng một công việc: một phiên được xếp vào loại architect khi nó giao việc code, nên các phiên architect nặng về code theo cách cấu thành, còn các phiên thường bao gồm cả nghiên cứu, review và debug mà không hề sửa gì. Hãy đọc nó như “mô hình này viết được rất nhiều code trên mỗi token”, chứ không phải như một tuyên bố hiệu quả gấp bốn lần.
Tuyên bố sạch sẽ hơn là về việc phân chia mô hình. Kể từ 14 tháng 9, một prompt trong phiên architect tốn 364k token có trọng số ở vòng lặp chính, 205k ở worker Sonnet và 80k ở worker Opus. Phần của worker Opus trong tổng token của worker là 100% vào tháng 8 và khoảng 4% trong tuần 21 tháng 9. Trên gói Max, điều đó có nghĩa giới hạn chung hàng tuần được rút theo mức giá của Sonnet thay vì của Opus cho gần như toàn bộ công việc triển khai, và không phần nào đụng đến giới hạn Fable.
Hai điều đã không được cải thiện, và tôi thà nói ra còn hơn để các biểu đồ ngụ ý điều khác. Ngữ cảnh của chính phiên chính không hề thu nhỏ lại: các phiên architect nén 8.7 lần trên mỗi 100 prompt so với 4.7 ở các phiên thường, vì architect đọc rất nhiều trước khi giao brief. Và mô hình này chậm hơn về thời gian thực trên các tác vụ nhỏ, vì thời gian khởi động và báo cáo của một worker là những phút bạn không phải trả khi bạn tự sửa luôn. Ngoại lệ sửa nhỏ tồn tại vì phiên bản đầu tiên của skill không có nó, và tôi đã tự chứng kiến mình viết một bản brief 3 KB cho một thay đổi hai dòng.
Đường vòng qua DeepSeek
Khi các worker đã là Sonnet, câu hỏi tiếp theo hiển nhiên là liệu chúng có nhất thiết phải là một mô hình Claude hay không. Từ 13 đến 18 tháng 9, tôi trỏ worker vào DeepSeek V4.1 Flash thông qua một Claude Code headless với ANTHROPIC_BASE_URL đặt vào một endpoint tương thích, đầu tiên qua OpenRouter rồi sau đó là kết nối trực tiếp. Cùng định dạng brief, cùng định dạng báo cáo, cùng architect. 2,732 lượt gọi, 431M token đầu vào trong đó 88% là đọc cache, 1.7M token đầu ra.
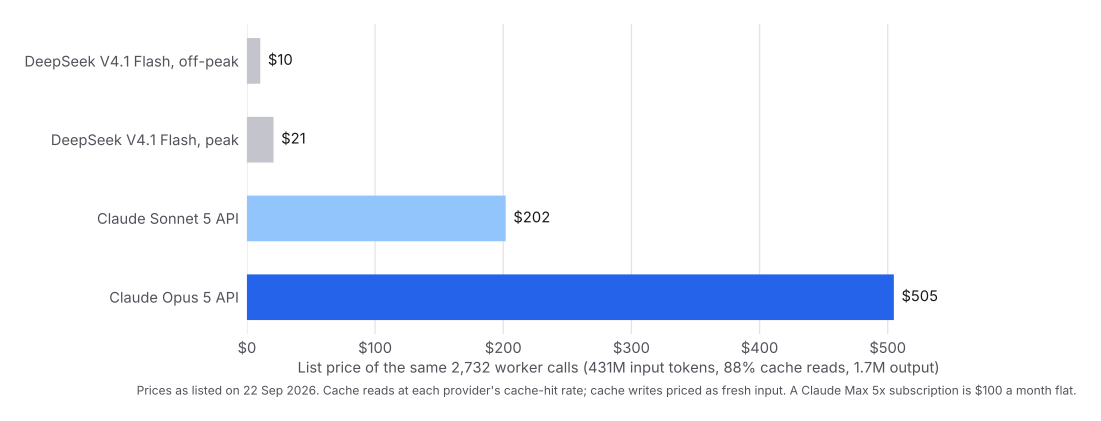
Theo giá niêm yết ngày 22 tháng 9, lưu lượng đó tốn khoảng 10 đô trên DeepSeek giờ thấp điểm, 21 đô giờ cao điểm, 202 đô trên API Sonnet và 505 đô trên API Opus. Nếu tôi trả tiền theo token, đây sẽ là tiêu đề của bài viết và tôi đã giữ nó lại.
Tôi không trả tiền theo token, và đó là toàn bộ lập luận. Một gói Max là 100 đô một tháng dù tôi dùng 30% hay 100% giới hạn hàng tuần. Chuyển lưu lượng worker sang DeepSeek không làm giảm hoá đơn đó một xu nào. Nó thêm một hoá đơn thứ hai từ 10 đến 21 đô một tuần lên trên, để tiết kiệm dung lượng của một gói mà dung lượng đó tôi đã trả tiền rồi. Tôi đã nhầm lẫn giữa “rẻ hơn API” và “rẻ hơn so với số tiền tôi trả”, và hai điều đó không giống nhau khi khoản bạn trả là cố định. So sánh đúng cho một người dùng gói đăng ký là DeepSeek với một gói đăng ký thứ hai, và ở đó một gói Claude thứ hai hoặc một gói ChatGPT có Codex tốn khoảng bằng một tháng dùng DeepSeek ở mức vừa phải, mà lại có giới hạn hàng tuần riêng, mô hình riêng và không phải theo dõi đồng hồ đo nào.
Chất lượng là nửa còn lại. Năm slice backend trả về sạch và được commit nguyên trạng. Một slice frontend xoá một symbol export và để mọi nơi tiêu thụ nó nguyên vẹn, nên cây mã không biên dịch được và một slice sau đó phải dọn dẹp. Đó đúng chính là kiểu thất bại mà một mô hình thực thi một đặc tả mắc phải, còn một mô hình suy ra hình dạng của một component từ những component anh em của nó thì không, và skill giờ đã ghi rõ điều đó: các thay đổi trên bề mặt API dùng chung sẽ giao cho Sonnet, và quy tắc dành cho worker ghi rằng “không bao giờ xoá hoặc đổi tên một symbol export mà không di trú mọi nơi tiêu thụ nó trong cùng một lần chạy”. DeepSeek Flash là một bộ thực thi tốt. Mô hình architect cần một worker nhận ra khi bản brief đếm thiếu số nơi tiêu thụ, và đó là điều duy nhất mà một bản brief không thể cung cấp.
Vậy nên bảng định tuyến hôm nay có hai dòng. Việc máy móc, việc backend theo một bản brief chi tiết với các test cần thoả, việc frontend tuân theo một ngữ pháp thiết kế đã có, và mọi thay đổi trên bề mặt API dùng chung đều giao cho sonnet-implementer. Việc mà độ khó nằm ở phần suy luận thì giao cho opus-implementer: một race condition bất đồng bộ, một refactor nhiều điểm mà tính đúng đắn phụ thuộc vào những điểm mà bản brief không thể liệt kê hết, một migration backfill mà không test đơn lẻ nào chứng minh được. Định tuyến theo hình dạng công việc, không bao giờ theo mức rủi ro. Rủi ro thay đổi mức độ khắt khe khi review diff và việc liệu có người ký duyệt hay không. Nó không bao giờ thay đổi ai là người viết.
Vòng review, nơi mô hình này đáng giá hay mất giá
Báo cáo của một worker là một lời khẳng định. Vòng review của skill thì ngắn và mỗi dòng đều đến từ việc bị vấp:
- Đọc báo cáo và
git diffthực tế. Đối chiếu diffstat mà worker trích dẫn với cái bạn thấy. - Tự chạy lại phần xác minh then chốt khi lời khẳng định đó quan trọng.
- Phát hiện vấn đề? Gửi bản sửa cho chính worker đó. Nó vẫn còn ngữ cảnh và tiếp tục từ chỗ đã dừng. Đừng sửa bằng tay, đừng khởi tạo lại.
- Hai lần sửa thất bại nghĩa là bản brief đã thiếu đặc tả, không phải mô hình quá nhỏ. Hãy chia nhỏ, đưa đoạn trích còn thiếu vào Context, chạy lại. Đừng leo lên một mô hình lớn hơn, vì nó sẽ triển khai cùng sự hiểu nhầm đó một cách trôi chảy hơn.
- Chạy các gate trong phạm vi liên quan trước khi chấp nhận bất cứ thứ gì: các test bị đụng tới, linter trên các file bị đụng tới, bất kỳ script quy ước nào mà repo có.
Trong các transcript, tôi gửi khoảng một bản sửa cho mỗi lần chạy worker, 52 trên 85 lần chạy, và 7 lần chạy Opus chạm giới hạn 160 lượt, tất cả đều trên những slice mà giờ tôi sẽ chia nhỏ. Đó là hai con số tôi theo dõi. Nếu số bản sửa trên mỗi lần chạy tăng lên, các bản brief của tôi đang trở nên lười biếng. Nếu các worker chạm giới hạn lượt, các slice của tôi quá lớn.
Rút ra từ bài này
Nếu bạn trả tiền theo token: đặt mô hình đắt tiền vào việc quyết định và review, đặt một mô hình rẻ vào việc triển khai, và tính giá lưu lượng worker theo giá niêm yết trước khi bạn chọn mô hình rẻ nào. Biểu đồ bốn cột chính là lập luận.
Nếu bạn trả tiền theo gói đăng ký: mô hình này không cắt giảm lượng token của bạn. Nó chuyển các token triển khai sang mô hình rút giới hạn chung hàng tuần chậm nhất, giữ giới hạn Fable cho công việc mà chỉ Fable nên làm, và ngăn mô hình đắt nhất của bạn tiêu số lượt của nó vào việc gõ. Đừng thêm một API tính theo đồng hồ đo bên cạnh để “tiết kiệm” dung lượng mà bạn đã mua rồi. Nếu bạn hết dung lượng worker, hãy mua một gói đăng ký thứ hai.
Dù theo cách nào, những quy tắc khiến nó hiệu quả đều là những quy tắc nhàm chán. Không chạy bộ test đầy đủ trong worker. Giới hạn số lượt. Slice nhỏ, brief ngắn. Sửa chính worker đó một lần, rồi sửa bản brief.
Skill, ba định nghĩa agent và guard hook nằm tại github.com/LivinTribunal/architect-skill theo giấy phép MIT. Skill đồng hành hướng dẫn worker cách viết code khớp với repo mà nó đáp xuống là grain-skill , và bài viết về nó là code thuận theo cấu trúc sẵn có .
Phương pháp
Mọi thứ mà bài viết mô tả đều nằm trong github.com/LivinTribunal/architect-skill : bản thân skill, mẫu brief, bảng định tuyến, ba định nghĩa implementer agent với các giới hạn lượt và quy tắc ngữ cảnh của chúng, và guard hook. Cài đặt nó và bạn có đúng thiết lập mà những con số dưới đây đến từ đó.
Các phiên là transcript JSONL của Claude Code từ 19 tháng 8 đến 22 tháng 9 năm 2026, entrypoint cli, từ ba prompt người dùng trở lên. Một phiên được xếp vào loại architect nếu nó khởi tạo opus-implementer, opus-implementer-xhigh hoặc sonnet-implementer, chạy một worker ds-slice, gọi skill architect, hoặc gửi một tin nhắn chứa bản brief triển khai cho một agent đa dụng, đó là cách những tuần đầu vận hành trước khi các agent có tên ra đời. Các lần chạy worker là các transcript subagent trong thư mục của mỗi phiên. Mức sử dụng được khử trùng lặp theo request id và tính trọng số input mới 1, ghi cache năm phút 1.25, ghi cache một giờ 2, đọc cache 0.1. “Chỉnh sửa code” là một lần gọi Edit hoặc Write trên file nguồn .py, .ts, .tsx, .js, .sql hoặc tương tự, không tính markdown và bất cứ thứ gì dưới ~/.claude. Giá DeepSeek là giá niêm yết trực tiếp ngày 22 tháng 9 năm 2026, giờ thấp điểm và cao điểm, với đọc cache tính theo tỷ lệ trúng cache và ghi cache tính như input mới; giá API Claude là giá niêm yết đã công bố của Opus 5 và Sonnet 5 với đọc cache bằng một phần mười giá input. Tuần 21 tháng 9 chỉ có hai ngày dữ liệu.
