


简短版
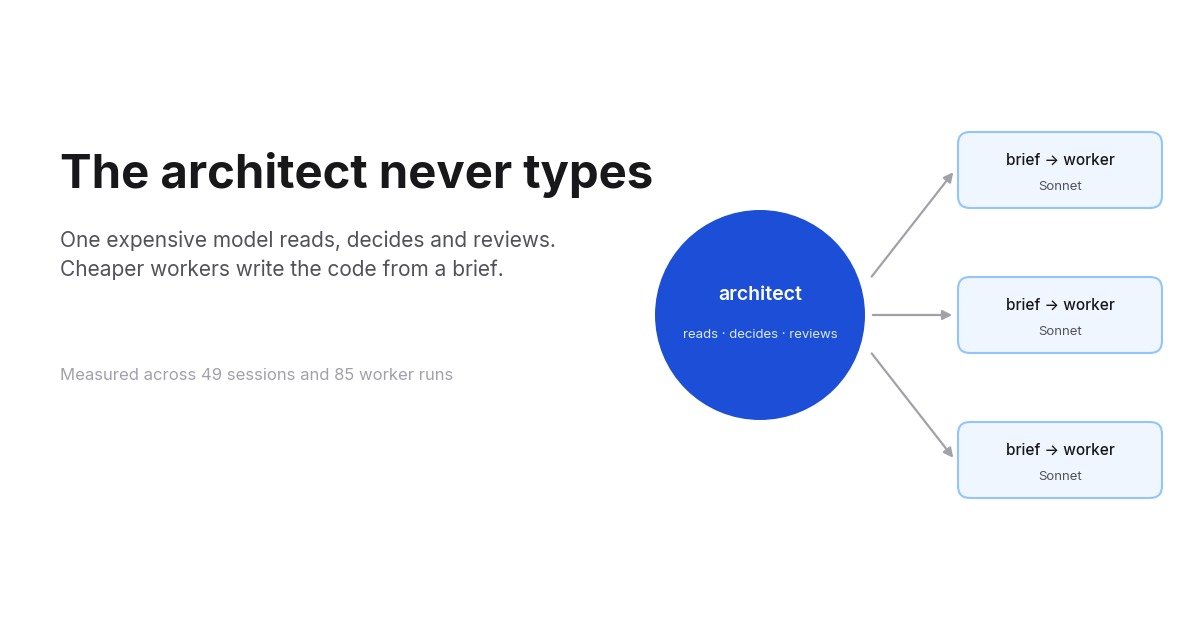
- 连续五周,我把我的编码智能体拆成两半来运行:主模型(先是 Opus,后来是 Fable)负责阅读、决策和审查,而一个工人智能体依据一份书面简报来写代码。我称之为架构师模式,它现在是一个公开技能:GitHub 上的 architect-skill ,MIT 许可。
- 主模型不再打字了。在 49 次架构师会话中,它在 1,467 条提示里只编辑了源文件 6 次。在同样这几周的 275 次普通会话中,它在 3,081 条提示里编辑了 244 个文件。也就是每 100 条提示 0.4 次对 7.9 次。
- 每条提示的总 token 数并没有下降。它上升了,前两周涨得很厉害,之后又回落到普通会话所在的位置。改变的是谁在花这些 token:Opus 在工人 token 中的占比从 100% 降到约 4%,而自 9 月 14 日起,一次架构师会话中每条提示在主模型上花费 364k 加权 token,Sonnet 工人 205k,Opus 工人 80k。
- 这种拆分正是订阅制所在意的。Claude Max 的全模型每周限额按每个模型各自的费率计扣,所以一个 Sonnet token 只按 Opus token 的 40% 计扣,而 Fable 有一个单独的、更紧的每周限额,没有任何工人会动用它。
- 我还试过通过一个无头 Claude Code 把工人路由到 DeepSeek。按标价计算,同样的流量是 $10,而在 Sonnet 上是 $202,在 Opus 上是 $505。在订阅制下这种节省并不存在,因为订阅费已经付过了。我放弃了它。如果你按 token 付费,还是读读那一节,因为那些数字才是重点。
这是系列文章的第三篇。第一篇测量了某一项设置对上下文窗口做了什么,token 减少 17% ;第二篇解释了上下文窗口要花多少钱 以及为什么。这一篇讲的是另一根杠杆:不是上下文有多大,而是由哪个模型持有它。
这个模式是什么
一次编码智能体会话做两类工作。它在思考:阅读代码库、弄清要改什么、决定命名、签名和边界情况、检查 diff。它也在打字:写代码、运行测试文件、修 lint。思考才是前沿模型值回票价的地方。打字不是。打字的大部分内容都由先前的决策决定,而一个较小的模型执行一份已经定好的方案,和一个大模型差不多好。
所以这个技能把会话拆开。主模型是架构师。它包办主循环里的一切,唯独不编辑源文件:
- 追问需求并探索代码库。
- 做出设计决策:方案、数据流、命名、签名、边界情况。要照搬的最接近的现有模式。能修复根因的最小改动。
- 拆解成若干切片,各自拥有互不重叠的文件集合。
- 每个切片写一份实现简报。
- 审查返回的 diff,运行门禁,提交。
工人是一个拥有全新上下文窗口的子智能体。它拿到简报,除此之外什么也没有,写代码,运行简报中指定的测试文件,返回一份简短的结构化报告。然后它的上下文就被丢弃了。它永远不会成为主会话历史的一部分,这一点比听起来更重要:主会话读到的所有内容都会在之后每次调用时重新发送,所以一个在自己的上下文里读了十二个文件和一份测试日志的工人,就把这些都挡在架构师的账单之外。
简报就是全部契约。我的是七个字段,这个技能的大部分内容就是关于把它们填好:
## 实现简报:<slice>
目标:一句话,可观察的结果
上下文:探索发现了什么:摘录、要照搬的模式、行锚点、坑
文件:要创建/修改的路径,本切片独占所有权
设计:已确定的方案:数据流、命名、签名、边界情况
约束:适用的项目规则:风格、分层、安全
范围外:不要碰什么,包括其他切片拥有的文件
验证:确切的命令和预期结果
一份简报包含的是决策,不是选项。如果我还在权衡两种方案,那我就还没准备好委派。
有一个例外。委派有固定的开销:写简报、工人启动、读报告、审查 diff。修一个拼写错误、一个配置值、一次版本号提升、删除一个失效的 key、一行修复及其回归测试:这些由架构师直接编辑,因为写简报的成本比编辑本身还高。判断标准是成本,不是行数。一旦编辑需要设计判断,或者触及仓库标记为关键的路径,就交给工人。
为什么订阅制会改变这笔账
如果你按 token 付费,情况很简单。Opus 5 的标价是每百万输入 token $5、每百万输出 $25;Sonnet 5 是 $2 和 $10。每一个从 Opus 移到 Sonnet 的实现 token,成本都只有原来的 40%。
我付的是订阅费,在这里情况不同,而且我认为更强。Claude Max 有两个每周限额,而不是一个:一个是跨所有模型的限额,每个 token 都按该模型自己的费率计扣;另一个是单独的、更紧的限额,只有 Fable 才计扣。Opus 没有自己的独立限额。这让这种拆分产生两个效果。Sonnet 工人所做的工作按 Opus 工人费率的 40% 计扣共享限额,所以把一次会话三分之二的 token 移到 Sonnet,会让这一周撑得更久,即使总 token 数不变。而当架构师是 Fable 时,它每少花一个 token 在打字上,就是给最先耗尽的那个限额多留一个 token。所以即便架构师模式花掉的 token 数和一个普通会话完全相同,由谁来花这些 token 仍然决定了这一周何时结束。
那个“即便”后来被证明起了很大作用。
记录说明了什么
Claude Code 会把每次会话写成一个 JSONL 记录,每次工人运行也会写到该会话目录下的一个同级文件。从 8 月 19 日起的记录我全都有:324 次有三条或更多提示的交互式会话,其中 49 次使用了这个模式,也就是生成了一个实现者智能体,或向它发送了一份简报。Token 按账单的方式加权:新输入按 1,缓存写入按 1.25 或 2,缓存读取按 0.1。CI 运行不计入。
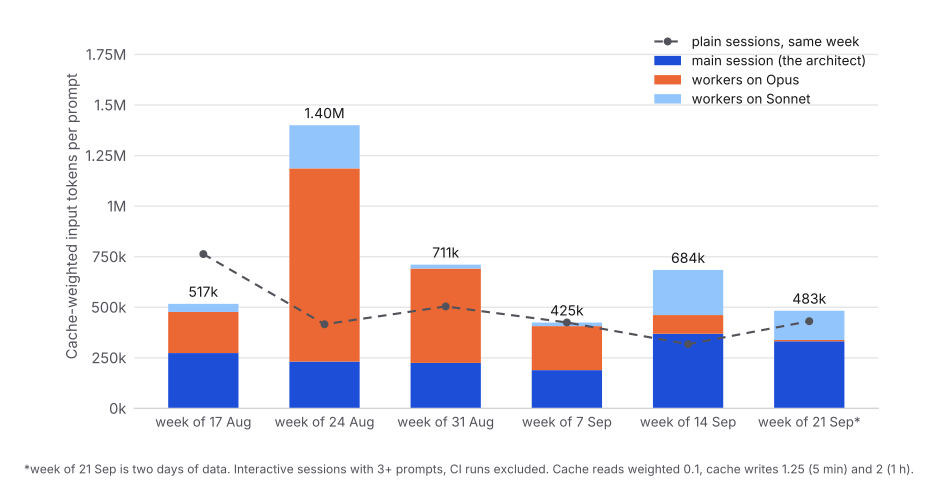
从左往右读,前两周并不是一个成功故事。
在 8 月 24 日那一周,一次架构师会话每条提示花费 1.40M 加权 token。同一周的普通会话花费 0.42M。多了三倍半,而且几乎全部超出部分都是橙色的:Opus 工人。我给工人配了一个好模型,却没给规则,于是它们表现得就像一个没有规则的好模型。那一周 Opus 工人运行的中位数是 176 轮。有几次跑了完整的后端测试套件,那会把大约 100 KB 的输出塞进一个在之后每一轮都会被重新发送的上下文里。9 月 14 日的一次六工人会话——那时我已经开始收紧一些东西了——仍然在 1,585 轮里烧掉了 245M 输入 token,只产出大约六千行 diff。提示缓存在整个过程里以 91.6% 的命中率正常运作。账单来自量,而不是定价。
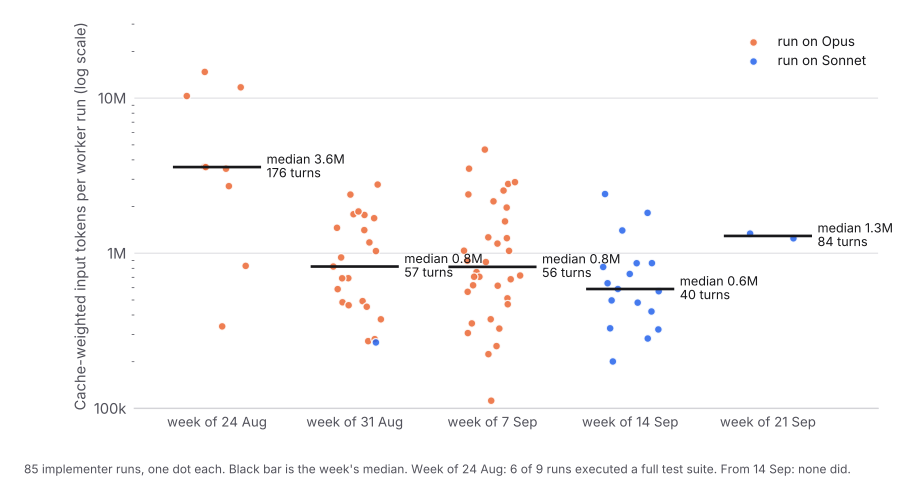
工人那一条显示了规则落在了哪里。其中三条起了主要作用,我把它们写进了智能体定义,而不是写进简报里,这样无论我记不记得,它们都会生效:
- 工人永远不跑完整测试套件。它只跑简报中指定的测试文件。门禁由架构师来跑。
maxTurns在智能体定义中被封顶,Sonnet 是 140,Opus 是 160。一个需要 250 轮的切片,说明简报写错了。- 一个切片保持在约十二个文件以内,简报保持在约 8 KB 以内。简报在每一轮也都会被重新发送。
到 8 月 31 日那一周,工人运行的中位数是 57 轮、0.8M 加权 token。从 9 月 14 日我把默认路由改到 Sonnet 起,是 40 轮、0.6M,此后没有任何工人跑过完整套件。
每条提示的总量也随之变化:最近四周分别是 711k、425k、684k、483k,而普通会话是 505k、425k、318k、431k。架构师会话现在的成本大约就是普通会话的成本。四周中有两周略高,一周略低。它为此换来的是接下来两张图。

加入我们的新闻通讯
免费获取最新提示、趋势和优惠。
主模型不再打字了
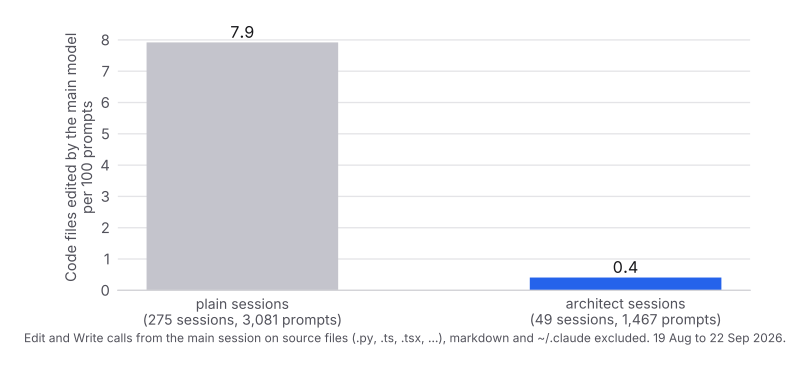
这就是我一开始想要改变的数字,它变了。在普通会话中,主模型在 3,081 条提示里对源文件发起了 244 次 Edit 或 Write 调用。在架构师会话中,是 1,467 条提示里 6 次。那 6 次都是我能解释清楚的小改动例外。
与此同时,工人们很有产出。85 次工人运行做了 2,510 次源文件编辑。把主循环和工人合在一起算,一次架构师会话从 1,467 条提示里产出了 2,516 次代码编辑;普通会话从 3,081 条提示里产出了 943 次。按每次代码编辑算,一次架构师会话总共花费 403k 加权 token,其中在 Opus 家族模型上花费 330k。一次普通会话花费 1,410k 和 1,324k。这个对比我要谨慎对待,因为这两组并不是同样的工作:一次会话只要委派了代码就会被归类为架构师会话,所以架构师会话按构造就是重编码的,而普通会话包含从不编辑任何东西的研究、评审和调试。请把它读作“这个模式每个 token 能写出很多代码”,而不是“四倍效率”的说法。
更干净的说法是模型拆分。自 9 月 14 日起,一次架构师会话中每条提示在主循环里花费 364k 加权 token,Sonnet 工人 205k,Opus 工人 80k。Opus 工人在所有工人 token 中的占比,8 月是 100%,到 9 月 21 日那一周约为 4%。在 Max 套餐上,这意味着几乎全部实现工作都以 Sonnet 而非 Opus 的费率计扣共享的每周限额,而且完全不触及 Fable 限额。
有两件事没有改善,我宁愿说出来,也不愿让图表暗示相反的情况。主会话自身的上下文并没有缩小:架构师会话每 100 条提示压缩 8.7 次,而普通会话是 4.7 次,因为架构师在写简报之前会读很多。而且在小任务上,这个模式按墙上时钟算更慢,因为工人的启动和报告是几分钟,而你直接做编辑时是不用付这几分钟的。小改动例外的存在,是因为这个技能的第一版没有这个例外,而我亲眼看着自己为一个两行的改动写了一份 3 KB 的简报。
DeepSeek 的弯路
当工人变成 Sonnet 之后,下一个明显的问题是:它们非得是 Claude 模型吗?从 9 月 13 日到 18 日,我把工人指向 DeepSeek V4.1 Flash,通过一个无头的 Claude Code,把 ANTHROPIC_BASE_URL 设为一个兼容端点,先是走 OpenRouter,后来用原生方式。相同的简报格式、相同的报告格式、相同的架构师。2,732 次调用,431M 输入 token,其中 88% 是缓存读取,1.7M 输出 token。
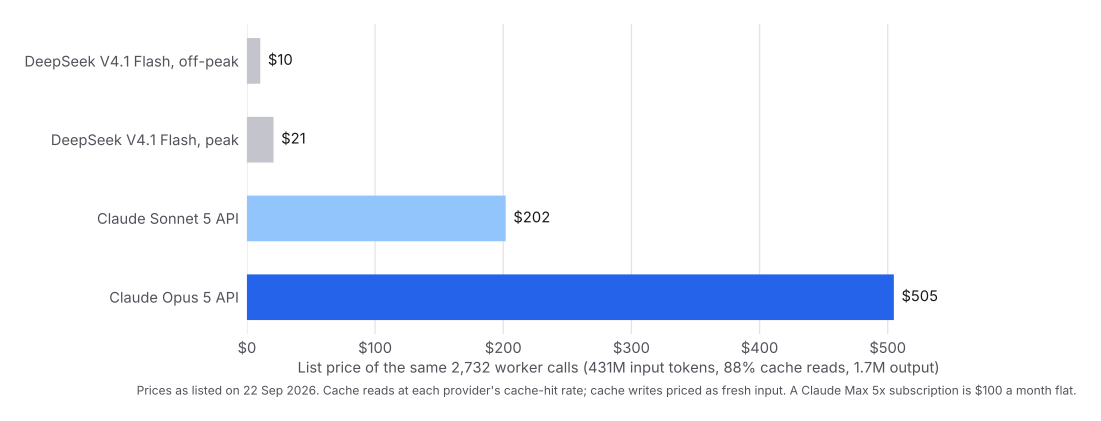
按 9 月 22 日的标价,这些流量在 DeepSeek 非高峰期大约花 $10,高峰期 $21,在 Sonnet API 上 $202,在 Opus API 上 $505。如果我按 token 付费,这会是这篇文章的头条,我也会保留它。
我不按 token 付费,这就是全部的论点。Max 订阅每月 $100,无论我用掉每周限额的 30% 还是 100%。把工人流量移到 DeepSeek 并没有让那张账单少一分钱。它在上面又加了每周 $10 到 $21 的第二张账单,为的是在一个我已经为其容量付过费的套餐上省出容量。我把“比 API 便宜”和“比我付的钱便宜”搞混了,而当你付的是固定费用时,这两者并不是一回事。对订阅用户来说,正确的比较是 DeepSeek 对比第二份订阅,而在这一点上,第二份 Claude 套餐或带 Codex 的 ChatGPT 套餐,成本大约相当于一个月中等强度的 DeepSeek 使用量,还自带每周限额、自己的模型,而且没有需要盯着的计量。
质量是另一半。五个后端切片干净地返回并原样提交。一个前端切片删除了一个导出的符号,却让它所有的消费者原封不动,于是代码树编译不过,后面的切片不得不来收拾。这正是“执行规格的模型”会犯、“从兄弟组件推断组件形态的模型”不会犯的失败,技能里现在也这么写了:共享 API 表面的改动交给 Sonnet,工人规则写着“绝不在同一次运行中删除或重命名一个导出符号而不迁移它的每一个消费者”。DeepSeek Flash 是个好的执行者。架构师模式需要的工人,要能在简报低估了消费者数量时察觉出来,而这恰恰是简报无法提供的东西。
所以今天的路由表有两行。机械性工作、对着带测试要满足的详细简报做的后端工作、遵循既有设计语法的前端工作,以及任何对共享 API 表面的改动,都交给 sonnet-implementer。难度在于推理的工作交给 opus-implementer:一个异步竞态、一次正确性取决于简报无法枚举的多个位置的多点重构、一次没有任何单一测试能证明的回填迁移。按形态路由,绝不按风险路由。风险改变的是 diff 被审查得多严、以及是否有人类签字。它从不改变由谁来写。
审查循环,模式在此赢得或失去它的价值
工人的报告是一种主张。技能的审查循环很短,每一行都来自被坑过的经历:
- 读报告和真实的
git diff。把工人引用的 diffstat 与你看到的那个做交叉核对。 - 当主张要紧时,自己重跑关键验证。
- 发现问题?把修正发回给同一个工人。它的上下文还在,会从停下的地方接着做。不要手工修,不要重新生成。
- 两次修正失败意味着简报写得不充分,而不是模型太小。拆解、把缺失的摘录放进上下文、重跑。不要升级到更大的模型,因为它只会更流畅地实现同一个误解。
- 在接受任何东西之前跑限定范围的各项门禁:被触及的测试、对被触及文件的 linter、仓库自带的任何约定脚本。
在记录里,我大约每次工人运行发送一次修正,85 次运行里 52 次,还有 7 次 Opus 运行撞到了它们的 160 轮上限,每一次都发生在一个我现在会拆开的切片上。这是我会盯着的两个数字。如果每次运行的修正数上升,说明我的简报变懒了。如果工人撞到上限,说明我的切片太大了。
从中学到什么
如果你按 token 付费:把昂贵的模型放在决策和审查上,把一个便宜的放在实现上,并在你挑选用哪个便宜的之前,先按标价给你的工人流量定价。那张四柱图就是论点。
如果你付订阅费:这个模式不会削减你的 token 数。它把实现 token 移到那个最慢计扣共享每周限额的模型上,把 Fable 限额留给只有 Fable 该做的工作,并阻止你最昂贵的模型把它的轮次花在打字上。不要在旁路加一个按量计费的 API 来“节省”你已经买下的容量。如果你的工人容量用完了,就再买一份订阅。
无论哪种情况,让它奏效的规则都是些无聊的规则。工人不跑完整测试套件。给轮数封顶。小切片,短简报。先修正同一个工人一次,然后去修简报。
技能、三个智能体定义和守卫钩子都在 github.com/LivinTribunal/architect-skill ,MIT 许可。那个告诉工人如何写出与它所落地仓库相匹配的代码的配套技能是 grain-skill ,关于它的文章是代码要顺着纹理 。
方法
文章描述的一切都在 github.com/LivinTribunal/architect-skill 里:技能本身、简报模板、路由表、三个实现者智能体定义(含它们的轮数上限和上下文规则),以及守卫钩子。安装它,你就得到了下面这些数字所来自的那套配置。
会话是 2026 年 8 月 19 日到 9 月 22 日的 Claude Code JSONL 记录,entrypoint 为 cli,三条或更多用户提示。一次会话如果生成了 opus-implementer、opus-implementer-xhigh 或 sonnet-implementer,运行了一个 ds-slice 工人,调用了架构师技能,或者向一个通用智能体发送了包含实现简报的消息,就被归类为架构师会话——在那些命名智能体存在之前,早期几周就是这么运作的。工人运行是每个会话目录下的子智能体记录。用量按请求 id 去重,并加权:新输入 1,五分钟缓存写入 1.25,一小时缓存写入 2,缓存读取 0.1。“代码编辑”是对 .py、.ts、.tsx、.js、.sql 或类似源文件的一次 Edit 或 Write 调用,不包括 markdown 和 ~/.claude 下的任何东西。DeepSeek 定价是 2026 年 9 月 22 日的原生标价,非高峰期和高峰期,缓存读取按缓存命中费率、缓存写入按新输入计价;Claude API 价格是已公布的 Opus 5 和 Sonnet 5 标价,缓存读取按输入的十分之一。9 月 21 日那一周只有两天的数据。
