


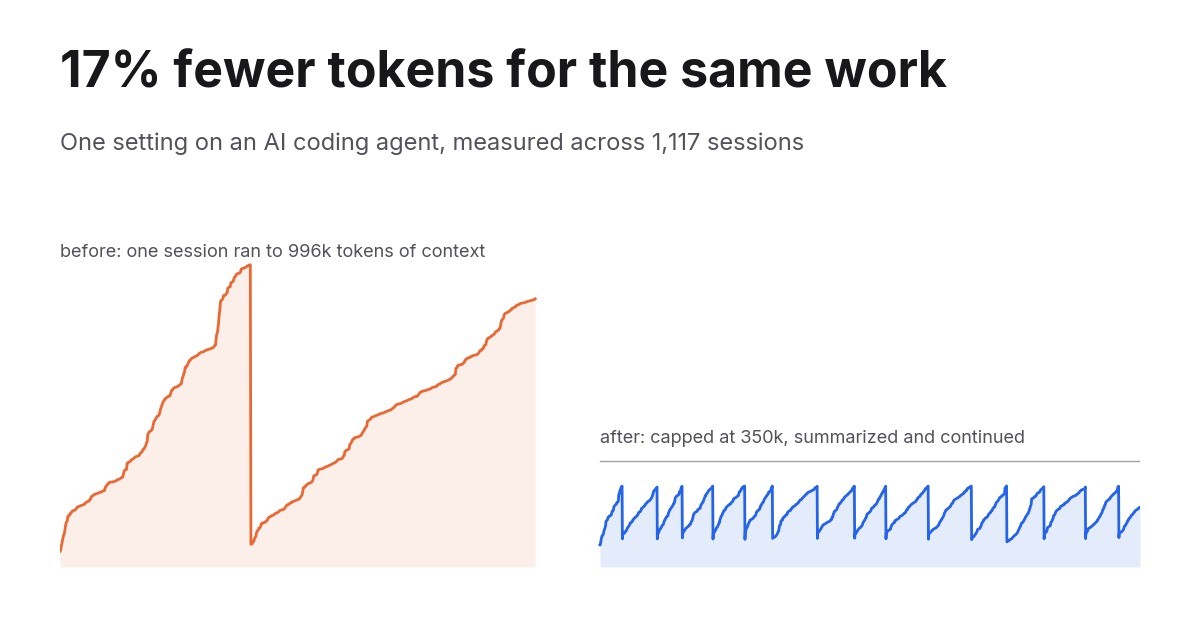
简要版
- 我全天运行一个 AI 编程代理,所用模型拥有 100 万 token 的上下文窗口。过去会话会不断增长,直到几乎把它填满。
- 我在它的配置里加了一行,把会话上下文限制在 350,000 token,超过后它会自行总结并继续。
- 对 1,117 份会话记录测量后:在提示词数量相同的情况下,token 减少 17%,而在上限真正起作用的长会话里,减少 55%。
下面是方法、每一张图表,以及你需要为此付出的代价,好让你判断它是否适用于你的环境。
为什么 100 万窗口的成本比看起来更高
与模型的对话是无状态的。每个请求都携带整段历史:系统提示、每个工具定义、代理读过的每个文件、每个工具返回结果、每条消息。不是增量,而是全部,每一次都是如此。
所以一个已经增长到 900,000 token 的会话,在下一次调用要为 900,000 token 的输入付费,再下一次也一样。第 400 轮并不比第 4 轮做更多工作,只是贵很多倍。
提示缓存缓解了这一点。模型此前见过的 token,计费约为正常输入价格的十分之一。这个折扣是真实的,正是它让长会话勉强可行,也正是它让没人去看这个问题。在我的数据里,98% 的输入 token 都是缓存读取。一个非常大的数字的十分之一,仍然是账单上最大的一项。
问题不在于你的历史有没有被缓存,而在于在有什么东西把它重置之前,它被允许涨到多大。
我改了什么
代理是 Claude Code,在 100 万上下文窗口上运行 Opus。设置项是 ~/.claude/settings.json 里的 autoCompactWindow。当会话达到这么多 token 时,代理会总结对话并从摘要继续。
{
  "autoCompactWindow": 350000
}
我此前从未设置过它,所以会话会一直运行到接近整个窗口。四天里我试了三个值:
| 日期 | 设置 |
|---|---|
| 9 月 14 日 | 250,000 |
| 9 月 15 日 | 300,000 |
| 9 月 18 日 | 350,000 |
我是如何测量的
Claude Code 会把每个会话写成 ~/.claude/projects/ 下的 JSONL 记录,其中包括每次 API 调用的 token 用量。我解析了全部 1,117 份记录,覆盖 8 月 19 日到 9 月 22 日的五周,按请求 ID 去重,只保留交互式会话。GitHub Actions 里的运行使用同一个账号,但不可能受我笔记本上设置的影响,所以被排除在外。
原始 token 总量本身具有误导性。忙碌的一周会胜过安静的一周,无论你改了什么。所以下面每个数字都是缓存加权的,也就是计费表实际读取的方式:新输入按 1x,缓存写入按 1.25x(5 分钟缓存)或 2x(1 小时缓存),缓存读取按 0.1x。并且每一次比较都按完成的工作量归一化,要么是我输入的提示词,要么是代理发起的 API 调用。

加入我们的新闻通讯
免费获取最新提示、趋势和优惠。
两个会话,同一个代理
这张图把机制一目了然地呈现出来。左边是 9 月 3 日的一个真实会话,在上限之前。右边是 9 月 15 日的一个真实会话,在上限之后。
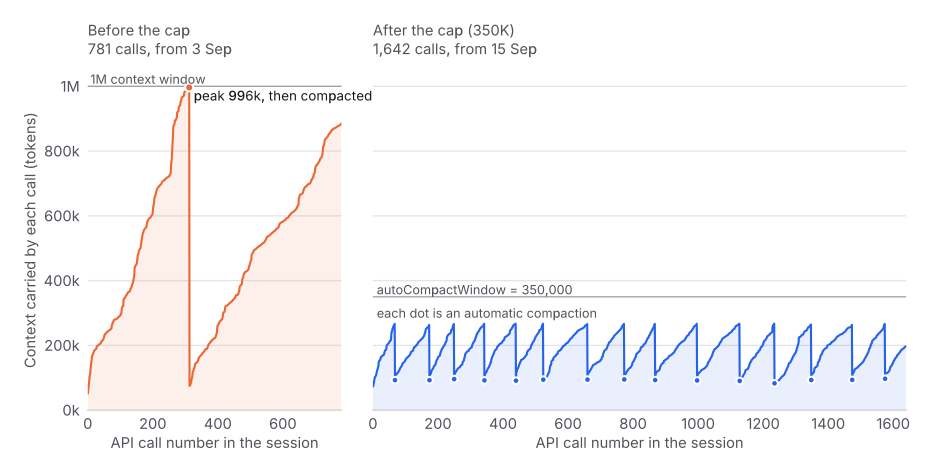
左边的会话运行了 781 次调用。它攀升到 996,000 token 的上下文,撞上 100 万窗口的墙,压缩了一次,然后又直接爬回 880,000。在那个会话的后半段,每一次调用都要重读超过 50 万 token。
右边的会话运行了 1,642 次调用,长度是前者两倍多,却从未超过 270,000。它压缩了十五次。每一次压缩就是一个点。
每周数据
仅统计交互式会话。柱状图是每次 API 调用的缓存加权输入 token,这是最公平的单一数字,因为它不在乎我在某一周工作了多少。
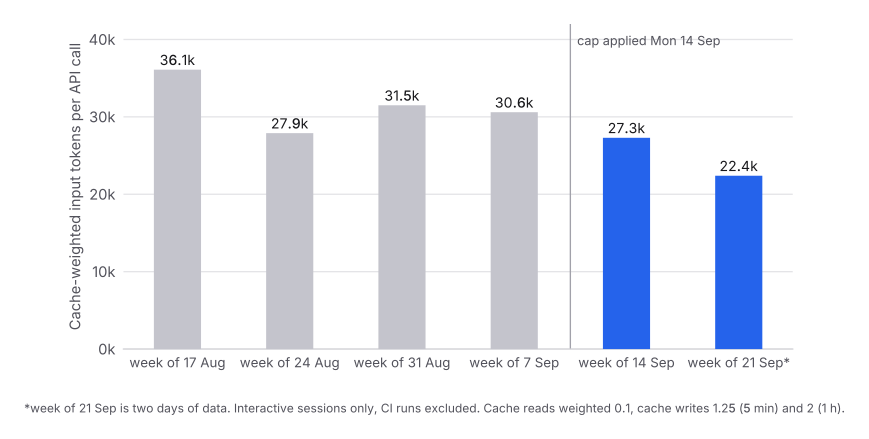
数据集里最干净的对比是 9 月 7 日那一周对 9 月 14 日那一周,因为这两周不是我挑的。它们恰好落在变更的两侧,而我在这两周输入的提示词数量几乎完全相同。
| 周起始 | 提示词 | API 调用 | 缓存加权输入 | 每次调用 |
|---|---|---|---|---|
| 9 月 7 日 | 971 | 11,364 | 348.1M | 30.6k |
| 9 月 14 日 | 968 | 10,555 | 288.5M | 27.3k |
971 条提示词对 968 条。有效输入从 348.1M 降到 288.5M。**这就是在提示量相同的情况下减少 17%。**接下来那一周的两天是每次调用 22.4k,更低。
钱花在了哪里
把每次 API 调用按它携带的上下文量拆开,机制就直接可见了。
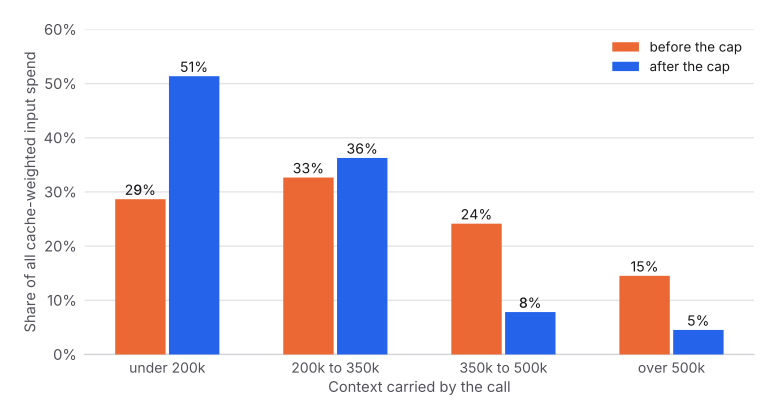
在上限之前,**我花掉的所有钱里有 39% 流向了那些拖着超过 350,000 token 历史的调用。**那些调用并不比别的调用做更多工作。它们做的是同样的工作,只是背着更多行李。上限之后这个比例是 12%。
天花板守住了吗
每个会话一个点,放在该会话曾携带过的最大上下文处。
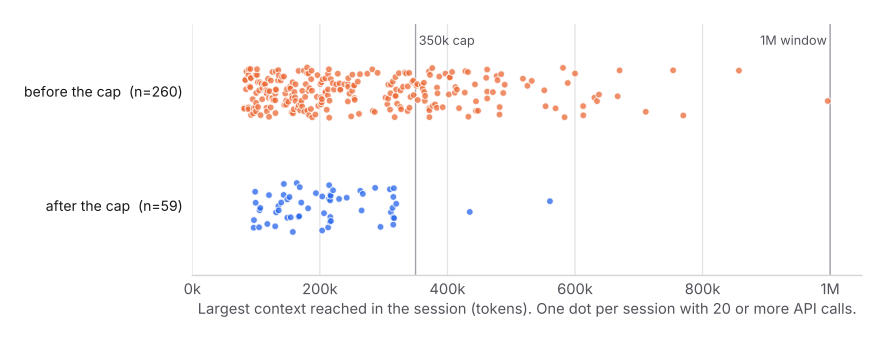
头两天仍有两个会话越过了上限,达到 434,000 和 561,000,我没查明原因。自从 9 月 18 日启用 350,000 这个设置以来,没有任何会话超过它。那些停留在 500k 到 1M 之间的会话长尾——也就是浪费最多的地方——已经消失。
没有上限本来要花多少
为了给出一个总量,我把变更之后开始的每一个会话都重放了一遍,假设被丢弃的上下文从未被总结,而且仍然会在之后每次调用中被重读,上限为 100 万窗口。
| 缓存加权输入 | |
|---|---|
| 实际值,73 个会话,9,675 次调用,55 次压缩 | 216.8M |
| 同样这些会话在没有上限的情况下 | 479.2M |
| 省下 | 262.5M,即 55% |
第一张图右边的那个会话自己就占了其中 118.5M。那是一次长重构,否则它最后几百次调用每次都要重读接近一百万 token。
把 55% 当作乐观的一端。没有上限,我其实不会让一个会话以 900k 空转好几个小时;最终我会手动清空它,而那同样会重置成本。保守的一端是观测到的每次调用数字,从 30.6k 降到 22.4k,也就是大约 20% 到 27%。真相在两者之间。
你要付出什么代价
这不是免费的,任何推荐它的人都应该说明这一点。
**等待。**变更以来共 67 次压缩,中位数约每次三分钟。八天里大约有 3.4 小时是在看着摘要被写出来。
**一些返工。**压缩会丢掉很多东西。在 350K 设置下,中位数压缩把 318,000 token 的会话降到 24,000。代理会丢失细节,有时会重建它:同一会话内重复读取的文件,从首次压缩前占读取量的 11.5% 上升到之后的 20.5%。第二个数字背后的样本很小,所以把它当作方向而不是测量值来读。
**阈值选择很重要。**在 250K 时,我有 36% 的长会话触发了压缩。在 350K 时是 12%,而天花板依然守得住。设得太低,你会为已经到手的节省反复付出那三分钟和返工。
如何设置
**Claude Code。**把 autoCompactWindow 加到 ~/.claude/settings.json。在 100 万上下文的模型上,350,000 是我试过的三个值里最好的。在 200K 模型上按比例缩小,从 120,000 到 140,000 左右开始。新会话会采用它;已经在运行的会话会保留旧值。
**其他代理。**去找同一个思路的不同名称:压缩触发器、上下文上限、总结并继续的阈值。如果没有,手动版本就是比你觉得自然更频繁地清空会话。因为“它了解这个项目”而让一个长会话整天活着的本能,才是昂贵的那一种。
**无论你用什么,两个习惯比任何设置都更管用。**把持久状态放在文件里而不是对话里,这样代理可以低成本地重读一个文件,而不必永远携带之前的每一个答案。并且把阅读密集型的工作推给拥有自己短暂上下文的子代理,这样它们读的二十个文件根本不会进入主会话。
如果你是按周限额
如果你付的是带每周用量限额的订阅,而不是按 token 计费,这是我发现的投入产出比最好的杠杆。一行 JSON,不改变你的工作方式,同样的限额就能明显用得更久。在我的情况里,相同的每周提示量成本降低了 17%,长会话的成本大约减半。
接下来读什么
上下文窗口被当作容量来卖。它们的表现却像一台一直在走的计费表,每一轮都为你曾经放进去的一切收费。如果你想要这背后的机制而不只是那个设置,配套文章 详细讲了到底是什么填满了上下文窗口、为什么一次长会话的成本远高于它所做的工作,以及缓存、清空和压缩各自如何改变这笔算术。
