


Phiên bản ngắn gọn
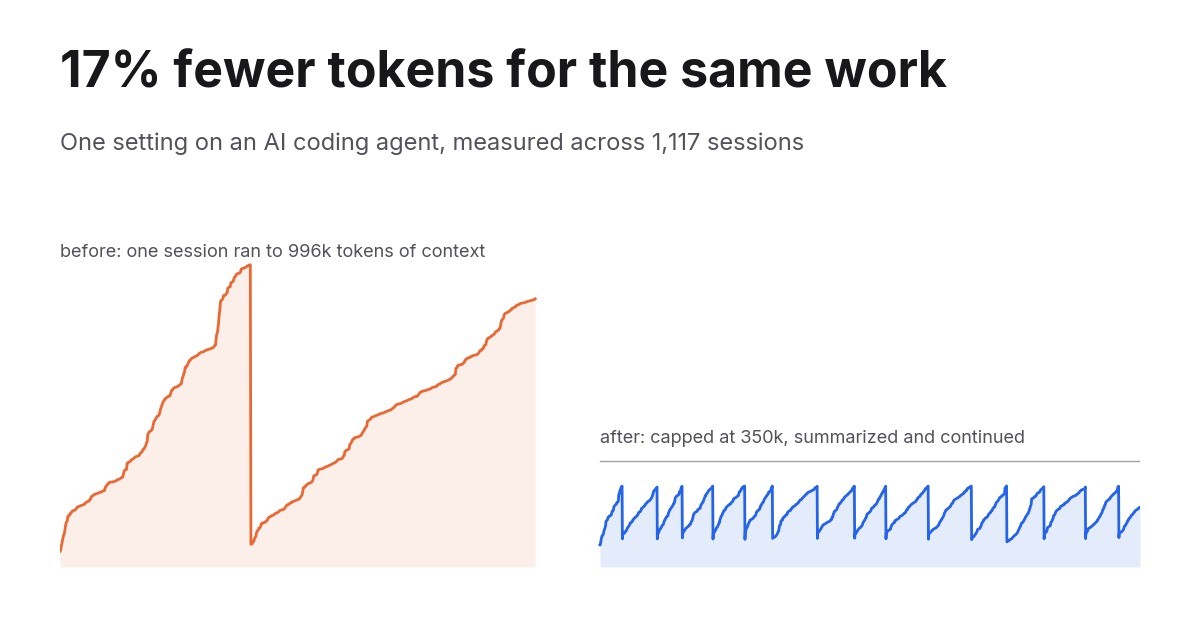
- Tôi chạy một AI coding agent cả ngày trên một model có cửa sổ ngữ cảnh 1M token. Trước đây, các phiên cứ phình ra cho đến khi gần lấp đầy cửa sổ đó.
- Tôi thêm một dòng vào file cấu hình, giới hạn mỗi phiên ở 350.000 token ngữ cảnh trước khi nó tự tóm tắt và tiếp tục.
- Đo trên 1.117 bản ghi phiên: ít hơn 17% token cho cùng số lượng prompt, và ở những phiên dài mà mức giới hạn thực sự phát huy tác dụng, ít hơn 55%.
Dưới đây là phương pháp, toàn bộ biểu đồ, và cái giá bạn phải trả, để bạn có thể tự quyết định xem nó có phù hợp với thiết lập của mình không.
Vì sao một cửa sổ 1M lại tốn kém hơn vẻ ngoài của nó
Một cuộc hội thoại với model là stateless. Mỗi request mang theo toàn bộ lịch sử: system prompt, mọi định nghĩa công cụ, mọi file agent đã đọc, mọi kết quả công cụ, mọi tin nhắn. Không phải phần chênh lệch. Mà là tất cả, mỗi lần.
Vì vậy, một phiên đã phình tới 900.000 token sẽ phải trả cho 900.000 token đầu vào ở lần gọi tiếp theo, và cả lần gọi sau đó nữa. Lượt thứ 400 không làm nhiều việc hơn lượt thứ 4. Nó chỉ tốn kém gấp nhiều lần.
Prompt caching làm dịu bớt điều này. Những token mà model đã thấy trước đó được tính giá bằng khoảng một phần mười giá đầu vào thông thường. Mức giảm đó là thật, chính nó khiến các phiên dài có thể tồn tại được, và cũng chính nó là lý do không ai để mắt tới vấn đề này. Trong dữ liệu của tôi, 98% tổng số token đầu vào là cache read. Một phần mười của một con số rất lớn vẫn là khoản lớn nhất trên hóa đơn.
Câu hỏi không phải là lịch sử của bạn có được cache hay không. Mà là nó được phép lớn tới mức nào trước khi có thứ gì đó thiết lập lại nó.

Sẵn sàng phát triển doanh nghiệp của bạn?
Bắt đầu dùng thử miễn phí ngay hôm nay và xem kết quả trong vài ngày.
Tôi đã thay đổi điều gì
Agent là Claude Code chạy Opus trên cửa sổ ngữ cảnh 1M. Thiết lập là autoCompactWindow trong ~/.claude/settings.json. Khi một phiên đạt tới số token đó, agent sẽ tóm tắt cuộc hội thoại và tiếp tục từ bản tóm tắt.
{
  "autoCompactWindow": 350000
}
Tôi chưa từng đặt nó, nên các phiên cứ chạy cho đến khi tiến sát cửa sổ đầy. Trong bốn ngày, tôi đã thử ba giá trị:
| Ngày | Thiết lập |
|---|---|
| 14 tháng 9 | 250.000 |
| 15 tháng 9 | 300.000 |
| 18 tháng 9 | 350.000 |
Tôi đã đo như thế nào
Claude Code ghi mọi phiên thành một transcript JSONL trong ~/.claude/projects/, bao gồm cả lượng token dùng cho mỗi lần gọi API. Tôi đã phân tích toàn bộ 1.117 file, trải dài năm tuần từ 19 tháng 8 đến 22 tháng 9, loại bỏ trùng lặp theo request ID, và chỉ giữ lại các phiên tương tác. Các lần chạy trong GitHub Actions dùng cùng tài khoản nhưng không thể bị ảnh hưởng bởi một thiết lập trên laptop của tôi, nên chúng bị loại ra.
Tổng token thô tự nó gây hiểu nhầm. Một tuần bận rộn luôn lớn hơn một tuần ít việc, bất kể bạn thay đổi điều gì. Vì vậy mọi con số dưới đây đều được quy theo cache, đúng như cách đồng hồ đo thực sự tính: đầu vào mới ở mức 1x, cache write ở mức 1,25x (cache 5 phút) hoặc 2x (cache 1 giờ), cache read ở mức 0,1x. Và mọi so sánh đều được chuẩn hóa theo khối lượng công việc đã làm, hoặc là số prompt tôi gõ, hoặc là số lần gọi API mà agent thực hiện.
Tham gia bản tin của chúng tôi
Nhận các mẹo, xu hướng và ưu đãi mới nhất miễn phí.
Hai phiên, cùng một agent
Đây là cơ chế trong một bức hình. Bên trái là một phiên thực tế ngày 3 tháng 9, trước khi áp mức giới hạn. Bên phải là một phiên thực tế ngày 15 tháng 9, sau đó.
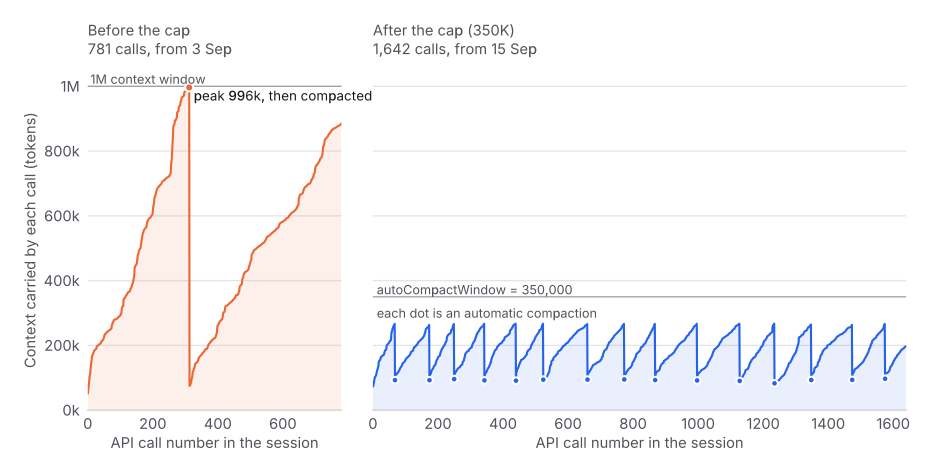
Phiên bên trái chạy 781 lần gọi. Nó leo lên 996.000 token ngữ cảnh, đụng vào bức tường của cửa sổ 1M, nén một lần, rồi leo thẳng trở lại 880.000. Trong nửa sau của phiên đó, mỗi lần gọi đều đọc lại hơn nửa triệu token.
Phiên bên phải chạy 1.642 lần gọi, dài hơn gấp đôi, và chưa bao giờ mang quá 270.000. Nó nén mười lăm lần. Mỗi lần nén là một điểm.
Những con số theo tuần
Chỉ tính các phiên tương tác. Các cột là số token đầu vào quy theo cache trên mỗi lần gọi API, đây là con số đơn lẻ công bằng nhất vì nó không quan tâm tôi đã làm việc nhiều hay ít trong một tuần nhất định.
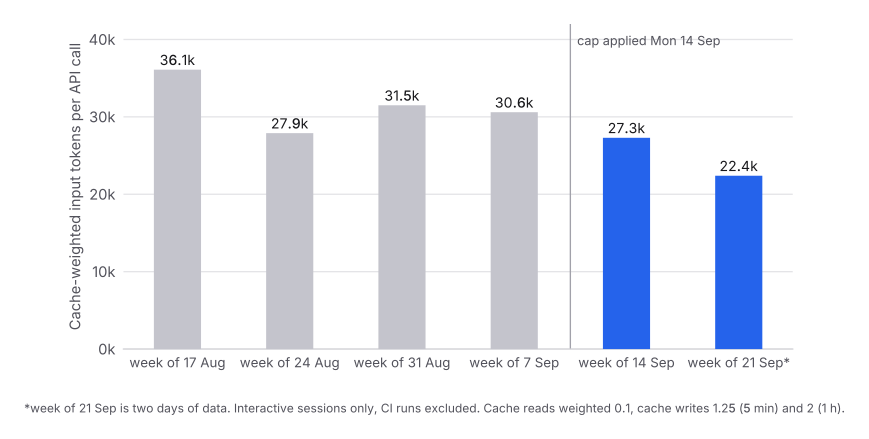
Phép so sánh sạch sẽ nhất trong bộ dữ liệu là tuần 7 tháng 9 so với tuần 14 tháng 9, vì tôi không chọn chúng. Chúng đơn giản nằm ở hai bên của thay đổi, và tôi gõ gần như đúng cùng số lượng prompt trong mỗi tuần.
| Tuần bắt đầu | Prompt | Lần gọi API | Đầu vào quy theo cache | Mỗi lần gọi |
|---|---|---|---|---|
| 7 tháng 9 | 971 | 11.364 | 348,1M | 30,6k |
| 14 tháng 9 | 968 | 10.555 | 288,5M | 27,3k |
971 prompt so với 968. Đầu vào hiệu dụng giảm từ 348,1M xuống 288,5M. Tức là ít hơn 17% cho cùng khối lượng prompt. Hai ngày của tuần kế tiếp đạt 22,4k mỗi lần gọi, còn thấp hơn nữa.
Tiền đã chảy đi đâu
Chia mỗi lần gọi API theo lượng ngữ cảnh mà nó mang theo, và cơ chế hiện ra ngay trước mắt.
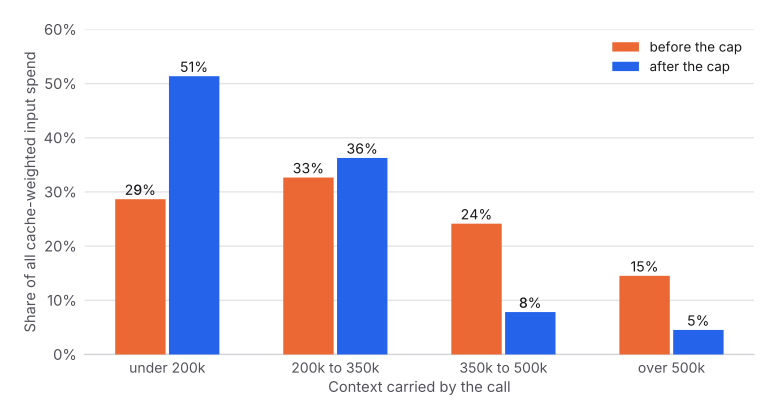
Trước khi áp giới hạn, 39% tổng số tiền tôi chi ra đổ vào những lần gọi kéo theo hơn 350.000 token lịch sử phía sau. Những lần gọi đó không làm nhiều việc hơn những lần khác. Chúng làm đúng công việc ấy, chỉ là mang vác nhiều hành lý hơn. Sau khi áp giới hạn, tỷ trọng đó là 12%.
Mức trần có giữ được không
Mỗi phiên một điểm, đặt tại ngữ cảnh lớn nhất mà phiên đó từng mang.
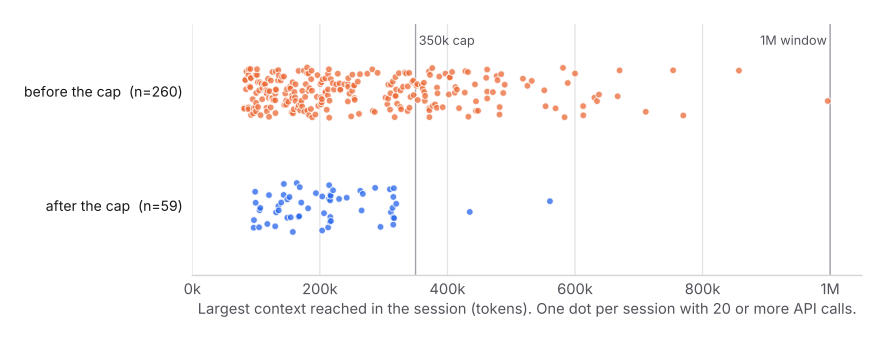
Hai phiên trong hai ngày đầu vẫn chạy vượt qua mức giới hạn, lên tới 434.000 và 561.000, và tôi không tìm ra lý do. Kể từ khi thiết lập 350.000 được áp vào ngày 18 tháng 9, không phiên nào vượt quá nó nữa. Phần đuôi gồm các phiên sống trong khoảng 500k đến 1M, nơi phần lớn sự lãng phí nằm ở đó, đã biến mất.
Sẽ tốn bao nhiêu nếu không có mức giới hạn
Để có một con số tổng, tôi chạy lại mọi phiên bắt đầu sau thay đổi như thể phần ngữ cảnh bị bỏ đi chưa từng được tóm tắt và vẫn đang được đọc lại ở mọi lần gọi về sau, giới hạn ở cửa sổ 1M.
| Đầu vào quy theo cache | |
|---|---|
| Thực tế, 73 phiên, 9.675 lần gọi, 55 lần nén | 216,8M |
| Cùng số phiên đó nếu không có giới hạn | 479,2M |
| Tiết kiệm được | 262,5M, tức 55% |
Phiên bên phải trong biểu đồ đầu tiên một mình chiếm 118,5M trong số đó. Một cuộc refactor dài mà nếu không có giới hạn thì sẽ dành hàng trăm lần gọi cuối để đọc lại gần một triệu token mỗi lần.
Hãy coi 55% là mức lạc quan nhất. Nếu không có giới hạn, thực tế tôi sẽ không để một phiên ì ạch ở 900k suốt nhiều giờ; rốt cuộc tôi sẽ xóa nó bằng tay, và việc đó cũng thiết lập lại chi phí. Mức thận trọng là con số quan sát được trên mỗi lần gọi, từ 30,6k xuống 22,4k, tức khoảng 20% đến 27%. Sự thật nằm đâu đó giữa hai con số đó.
Cái giá bạn phải trả
Điều này không miễn phí, và bất kỳ ai khuyên bạn dùng nó cũng nên nói rõ điều đó.
Chờ đợi. 67 lần nén kể từ thay đổi, trung vị khoảng ba phút mỗi lần. Tức khoảng 3,4 giờ ngồi nhìn một bản tóm tắt được viết ra, trải đều trong tám ngày.
Một chút làm lại. Nén bỏ đi rất nhiều thứ. Ở thiết lập 350K, lần nén trung vị đưa một phiên 318.000 token xuống còn 24.000. Agent mất chi tiết và đôi khi phải dựng lại chúng: số file được đọc lại trong cùng một phiên tăng từ 11,5% số lần đọc trước lần nén đầu tiên lên 20,5% sau đó. Mẫu đằng sau con số thứ hai khá nhỏ, nên hãy đọc nó như một xu hướng hơn là một phép đo.
Việc chọn ngưỡng rất quan trọng. Ở 250K, 36% số phiên dài của tôi phải nén. Ở 350K, chỉ 12% phải nén, mà mức trần vẫn giữ được. Đặt quá thấp thì bạn phải trả ba phút và phần làm lại lặp đi lặp lại cho một khoản tiết kiệm mà bạn đã có sẵn.
Cách thiết lập
Claude Code. Thêm autoCompactWindow vào ~/.claude/settings.json. Trên một model ngữ cảnh 1M, 350.000 là giá trị tốt nhất trong ba giá trị tôi đã thử. Trên một model 200K, hãy giảm tỷ lệ xuống và bắt đầu quanh 120.000 đến 140.000. Các phiên mới sẽ nhận thiết lập này; một phiên đang chạy vẫn giữ giá trị cũ.
Các agent khác. Hãy tìm ý tưởng tương tự dưới một cái tên khác: một trigger nén, một giới hạn ngữ cảnh, một ngưỡng tóm tắt-rồi-tiếp tục. Nếu không có, thì phiên bản thủ công là xóa phiên thường xuyên hơn mức bạn thấy tự nhiên. Bản năng giữ một phiên dài sống suốt cả ngày vì nó “biết rõ dự án” chính là bản năng tốn kém.
Dù bạn dùng gì, hai thói quen sau hiệu quả hơn mọi thiết lập. Giữ trạng thái bền vững trong file thay vì trong cuộc hội thoại, để agent có thể đọc lại một file với chi phí thấp thay vì mang theo mọi câu trả lời trước đó mãi mãi. Và đẩy những công việc nặng về đọc sang các subagent có ngữ cảnh ngắn hạn riêng, để hai mươi file mà chúng đọc không bao giờ lọt vào phiên chính.
Nếu bạn đang dùng hạn mức theo tuần
Nếu bạn trả phí thuê bao theo hạn mức sử dụng hàng tuần thay vì hóa đơn theo từng token, thì đây là đòn bẩy có tỷ lệ công sức trên hiệu quả tốt nhất mà tôi từng tìm thấy. Một dòng JSON, không thay đổi cách bạn làm việc, và cùng một hạn mức kéo dài thêm một cách rõ rệt. Trong trường hợp của tôi, cùng khối lượng prompt mỗi tuần tốn ít hơn 17%, và các phiên dài tốn khoảng một nửa.
Đọc tiếp
Cửa sổ ngữ cảnh được bán như một dạng dung lượng. Nhưng chúng hành xử như một đồng hồ chạy liên tục, tính phí ở mỗi lượt cho mọi thứ bạn từng đưa vào. Nếu bạn muốn hiểu cơ chế đằng sau điều này chứ không chỉ một thiết lập, bài viết đồng hành sẽ đi qua những gì thực sự lấp đầy một cửa sổ ngữ cảnh, vì sao một phiên dài tốn kém hơn nhiều so với công việc mà nó làm, và cách caching, xóa và nén mỗi thứ thay đổi phép tính như thế nào.
