


Phiên bản ngắn gọn
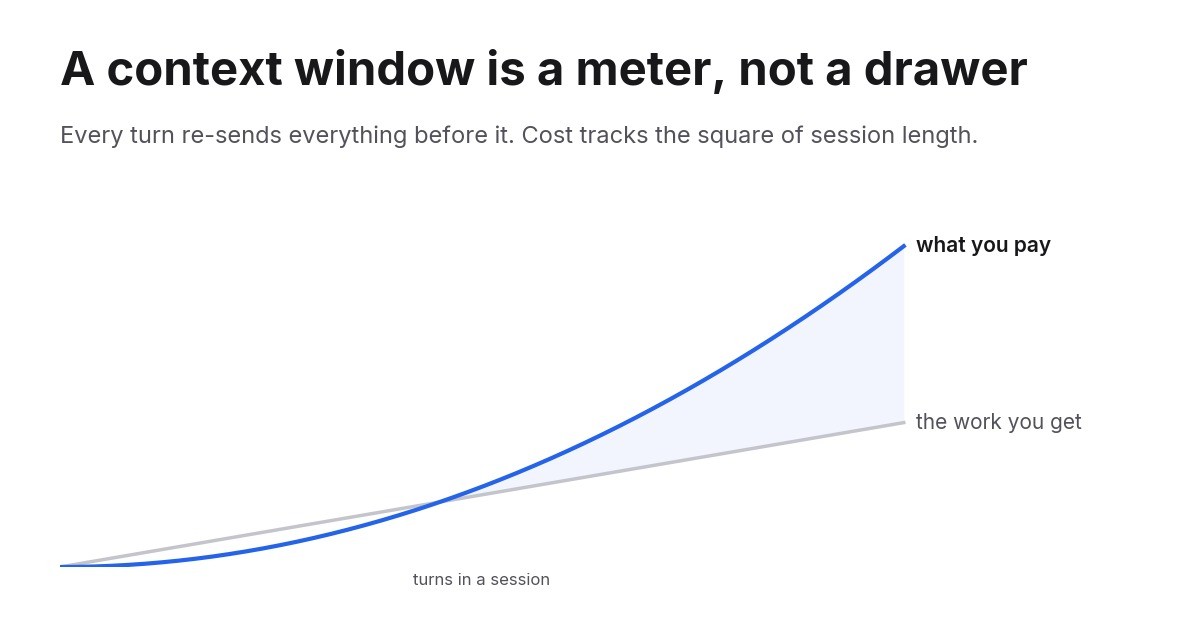
- Một model không có bộ nhớ giữa các yêu cầu. Mỗi lượt đều gửi lại toàn bộ cuộc hội thoại, nên cửa sổ ngữ cảnh là một khoản chi phí bị tính ở mọi lần gọi, không phải một nơi bạn lấp đầy một lần rồi thôi.
- Điều đó khiến chi phí của một phiên tăng theo bình phương độ dài của nó. Bộ nhớ đệm prompt cắt đơn giá xuống khoảng một phần mười nhưng không thay đổi hình dạng đường cong.
- Cách khắc phục là một cửa sổ nhỏ hơn được đặt lại một cách có chủ đích: giới hạn mức tăng của nó, xóa thường xuyên hơn, loại bỏ những kết quả công cụ đã dùng hết, và giữ những phần đọc nặng trong tệp và trong subagent, nơi chúng không bao giờ quay lại.
Cửa sổ ngữ cảnh là đồng hồ đo, không phải ngăn kéo
Hầu hết mọi người hình dung cửa sổ ngữ cảnh như một nơi lưu trữ. Bạn bỏ mọi thứ vào, model nhìn thấy chúng, cửa sổ lớn hơn thì chứa được nhiều hơn. Hình dung đó sai ở một điểm cụ thể, và sai lầm đó rất tốn kém.
Model không có trạng thái. Không có phiên nào ở đầu bên kia đang giữ cuộc hội thoại của bạn. Mỗi yêu cầu gửi lại toàn bộ lịch sử: prompt hệ thống, mọi định nghĩa công cụ, mọi tệp mà agent đã đọc, mọi kết quả công cụ, mọi tin nhắn mà một trong hai bên đã viết. Model đọc hết, trả lời, rồi quên. Tin nhắn tiếp theo của bạn lại gửi toàn bộ những thứ đó, cộng thêm phần mới.
Vậy nên cửa sổ không phải một ngăn kéo. Nó là một đồng hồ đo, và con số nó hiển thị ở mỗi lượt chính là kích thước của mọi thứ bạn đã tích lũy cho đến lúc đó.

Sẵn sàng phát triển doanh nghiệp của bạn?
Bắt đầu dùng thử miễn phí ngay hôm nay và xem kết quả trong vài ngày.
Phép toán không ai tính trước
Lấy một phiên tăng thêm khoảng 1.000 token mỗi lượt và chạy trong 300 lượt. Ngữ cảnh của nó leo từ gần như bằng không lên 300.000 token, trung bình 150.000. Tổng lượng đầu vào được gửi đi: 300 nhân 150.000, tức 45 triệu token, để có được 300 lượt làm việc.
Giờ để cùng phiên đó tăng nhanh gấp ba lần, lên 900.000. Trung bình là 450.000, tổng là 135 triệu, gấp ba hóa đơn cho đúng 300 lượt như vậy.
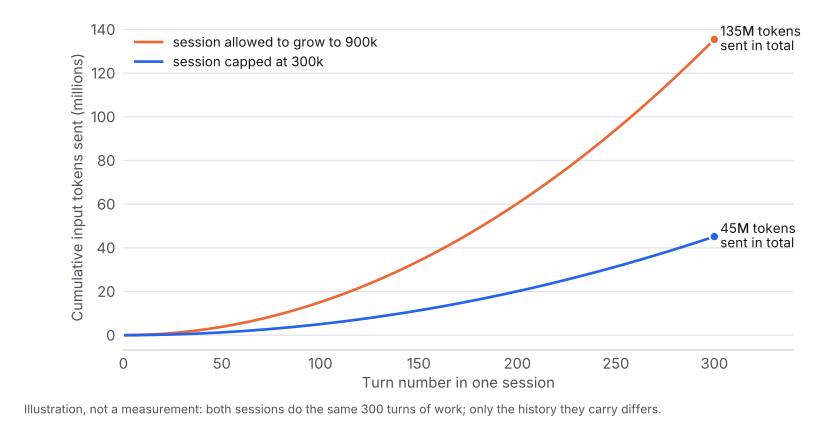
Đó chính là hình dạng của vấn đề. Chi phí không bám theo khối lượng công việc bạn nhận được. Nó bám theo thời gian bạn để phiên chạy, theo bình phương. Mỗi lượt bạn thêm vào đều khiến mọi lượt trong tương lai đắt hơn, đó là lý do giờ cuối cùng của một phiên dài có thể tốn hơn cả bốn giờ đầu.
Quy ra tiền, theo giá niêm yết của Claude Opus 5 là 5 đô la cho mỗi triệu token đầu vào và với mọi thứ sau lượt đầu được phục vụ từ bộ đệm ở mức một phần mười giá đó: phiên được giới hạn tốn khoảng 22 đô la, phiên không giới hạn tốn khoảng 68 đô la, cho cùng một khối lượng công việc. Với gói thuê bao, bạn không thấy đô la, bạn thấy hạn mức hàng tuần cạn sớm hơn.
Bộ nhớ đệm thay đổi đơn giá, không thay đổi đường cong
Bộ nhớ đệm prompt là lý do các phiên agent dài có thể tồn tại được. Nhà cung cấp giữ phần tiền tố hội thoại của bạn luôn ấm và chỉ thu một phần nhỏ chi phí để đọc lại nó.
Trên API của Anthropic, các hệ số là 1,25 lần giá đầu vào cơ bản để ghi vào bộ đệm năm phút, 2 lần cho bộ đệm một giờ, và khoảng 0,1 lần để đọc. Một lần ghi vào bộ đệm năm phút sẽ hoàn vốn ngay ở yêu cầu thứ hai. Mọi bộ khung agent nghiêm túc đều làm việc này tự động, và nó hiệu quả thật: qua năm tuần phiên làm việc của chính tôi, 98% tổng số token đầu vào là các lần đọc từ bộ đệm.
Hãy nhìn kỹ xem bộ nhớ đệm đã sửa được gì và chưa sửa được gì. Nó nhân chi phí lịch sử của bạn với khoảng một phần mười. Nó không ngăn lịch sử tiếp tục lớn lên, và nó không ngăn bạn đọc lại lịch sử đó ở mỗi lượt. Một phần mười của 900.000 token là 90.000 token đầu vào bị tính phí cho một câu hỏi mà bạn có thể đã đặt ra trong hai mươi token.
Bộ nhớ đệm là thứ giúp vấn đề này sống sót được. Nó cũng là thứ khiến vấn đề trở nên vô hình, bởi con số trên bảng điều khiển mức sử dụng của bạn không bao giờ trông đáng báo động như số token thực sự đang luân chuyển.
Tham gia bản tin của chúng tôi
Nhận các mẹo, xu hướng và ưu đãi mới nhất miễn phí.
Thực sự có gì trong đó
Khi một phiên trở nên lớn, người ta thường cho rằng đó là do cuộc hội thoại. Thường thì không phải. Trong một phiên agent đang làm việc, phần nặng nằm ở bốn chỗ.
Định nghĩa công cụ. Mỗi công cụ mà agent có thể gọi đều mang theo một tên, một mô tả và một lược đồ tham số đầy đủ, tất cả đều được nạp trước khi agent làm bất cứ điều gì. Kết nối sáu máy chủ MCP, mỗi máy 25 công cụ, và bạn có 150 lược đồ trong cửa sổ ngay từ lượt đầu tiên, phần lớn trong đó sẽ không bao giờ được gọi đến.
Các lần đọc tệp. Một agent đọc một tệp mã nguồn dài 2.000 dòng vừa mới thêm khoảng 25.000 token vào mọi lượt về sau của phiên. Nó cần tệp đó một lần. Nó mang theo tệp đó mãi mãi.
Kết quả công cụ. Một lần tìm kiếm trả về 200 kết quả, một lần chạy kiểm thử in ra toàn bộ nhật ký, một lần gọi API trả về cả một tài liệu. Agent thường chỉ cần một dòng trong đó. Tất cả vẫn ở lại.
Chính cuộc hội thoại. Kể cả những phần mà agent đã thử một hướng đi vào ngõ cụt, tự sửa mình rồi đi tiếp. Những token đó vẫn còn trong cửa sổ, vẫn đang được đọc lại, vẫn đang định hình câu trả lời tiếp theo.
Điểm cuối cùng quan trọng không chỉ vì chi phí. Một cửa sổ đầy những nỗ lực bị bỏ dở và những nội dung tệp đã cũ cũng là một cửa sổ mà ở đó chi tiết liên quan khó tìm thấy hơn. Ngữ cảnh vừa là một ngân sách vừa là một vấn đề về sự tập trung chú ý.
Ba cách để thu nhỏ nó
Xóa. Bắt đầu một phiên mới. Mọi thứ bạn đã ghi lại ở nơi khác vẫn tồn tại; mọi thứ còn lại đều biến mất. Đây là công cụ thô bạo nhất và cũng thường là công cụ đúng đắn. Giữ một phiên sống suốt cả ngày vì nó “biết dự án” là thói quen tốn kém nhất.
Chỉnh sửa ngữ cảnh. Loại bỏ những phần cụ thể và giữ nguyên phần còn lại từng chữ một, thường là những kết quả công cụ cũ sau khi đã được dùng. API của Anthropic công khai điều này trực tiếp như một chiến lược quản lý ngữ cảnh. Nó chính xác và không làm biến dạng phần còn lại, nên đây là thứ đầu tiên bạn nên dùng khi phần nặng là những kết quả công cụ cồng kềnh chứ không phải một cuộc hội thoại dài.
Nén ngữ cảnh. Tóm tắt lịch sử rồi tiếp tục từ bản tóm tắt. Đây là việc mà hầu hết các agent lập trình tự động làm khi cửa sổ đầy, và nó là lựa chọn duy nhất giới hạn được mức tăng của một phiên mà không kết thúc phiên đó. Nó loại bỏ rất nhiều thứ.
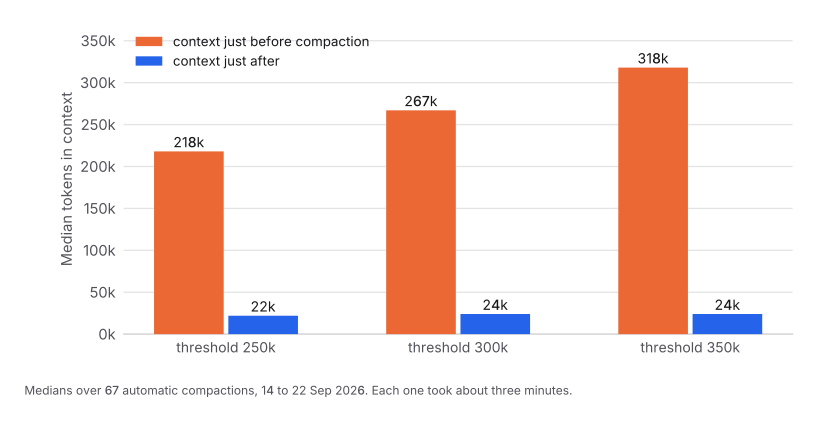
Đó là các giá trị trung vị trên 67 lần nén thực tế trong chính các phiên của tôi. Mỗi lần mất khoảng ba phút, và sau đó agent đọc lại những tệp nó đã từng thấy với tốc độ gần gấp đôi so với trước, dựng lại những gì bản tóm tắt đã đánh mất. Sự đánh đổi này đáng giá. Nhưng nó vẫn là một sự đánh đổi.
Lựa chọn thứ tư tốt hơn cả ba
Đừng đưa nó vào cửa sổ ngay từ đầu.
Hãy giữ trạng thái bền vững trong các tệp mà agent có thể đọc lại theo yêu cầu, thay vì trong cuộc hội thoại. Gửi những công việc đọc nặng cho một subagent với ngữ cảnh ngắn hạn riêng của nó, để hai mươi tệp nó đọc không bao giờ chạm đến phiên chính. Nạp công cụ khi cần thay vì nạp hết ngay từ đầu.
Một token không bao giờ được thêm vào là một token bạn không bao giờ phải đọc lại. Mọi thứ khác trên trang này chỉ là việc xử lý hậu quả cho những token đã bị thêm vào.
Ngưỡng nên đặt ở đâu
Nếu agent của bạn tự động nén, nó có một ngưỡng, và mặc định thường gần với toàn bộ cửa sổ của model. Mặc định đó là thiết lập đắt đỏ, vì nó để phiên của bạn dành những giờ làm việc hiệu quả nhất để mang theo lịch sử lớn nhất có thể.
Đặt ngưỡng thấp hơn sẽ giúp ích, nhưng có một mức sàn. Nén quá hăng và bạn phải trả giá bằng những lần chờ ba phút và những lần làm lại lặp đi lặp lại. Trên một model có ngữ cảnh 1M, ngưỡng 250.000 đã buộc phải nén trong 36% số phiên dài của tôi; ngưỡng 350.000 chỉ kích hoạt nén trong 12% số phiên và vẫn đạt được gần như toàn bộ khoản tiết kiệm tương tự. Qua năm tuần phiên làm việc, kết quả là ít hơn 17% token tính theo trọng số bộ đệm cho cùng số prompt, và chi phí chỉ còn khoảng một nửa ở những phiên dài nơi mức giới hạn thực sự phát huy tác dụng. Toàn bộ dữ liệu nằm trong bài viết đồng hành .
Một quy tắc khả thi: đặt mức giới hạn vào khoảng một phần ba cửa sổ của model bạn rồi điều chỉnh từ đó. Đủ thấp để không phiên nào dành hàng giờ sát mức trần, đủ cao để công việc thông thường kết thúc mà không bị một bản tóm tắt ngắt ngang.
Tự đo lường của bạn
Không điều nào trong số này cần công cụ đo lường mới. Mỗi phản hồi API đều mang theo một đối tượng usage với bốn trường: input_tokens, cache_creation_input_tokens, cache_read_input_tokens và output_tokens. Hầu hết các bộ khung agent đã ghi những trường này vào nhật ký phiên trên đĩa.
Hai con số cho bạn biết gần như mọi thứ.
Đầu vào tính theo trọng số bộ đệm cho mỗi lần gọi. Nhân các trường với chi phí của chúng: đầu vào mới hệ số 1, ghi vào bộ đệm hệ số 1,25 hoặc 2, đọc từ bộ đệm hệ số 0,1. Nếu con số này tăng qua từng tuần trong khi khối lượng công việc của bạn không đổi, các phiên của bạn đang lớn lên và bạn đang phải trả giá cho điều đó.
Ngữ cảnh đỉnh của mỗi phiên. Lần gọi đơn lẻ lớn nhất trong mỗi phiên. Nếu các đỉnh nằm gần cửa sổ của model bạn, bạn đã tìm ra hóa đơn của mình.
Tổng số theo tuần dạng thô sẽ đánh lừa bạn, vì một tuần bận rộn luôn hơn một tuần yên ắng dù bạn có thay đổi gì đi nữa. Hãy luôn chia cho một thứ đại diện cho công việc: một tác vụ đã hoàn thành, một prompt, một lần gọi API.
Đọc tiếp
Cửa sổ ngữ cảnh là một khoản phí định kỳ, bị tính ở mọi lượt, cho mọi thứ bạn từng đưa vào đó. Bộ nhớ đệm cắt đơn giá xuống khoảng chín mươi phần trăm và che giấu xu hướng. Cách khắc phục là một cửa sổ nhỏ hơn được đặt lại một cách có chủ đích.
Để xem phiên bản đã được đo lường, với năm tuần dữ liệu phiên và một thiết lập duy nhất tạo ra phần lớn khoản tiết kiệm, hãy đọc bài viết đồng hành về cắt 17% lượng token agent dùng .
