


De korte versie
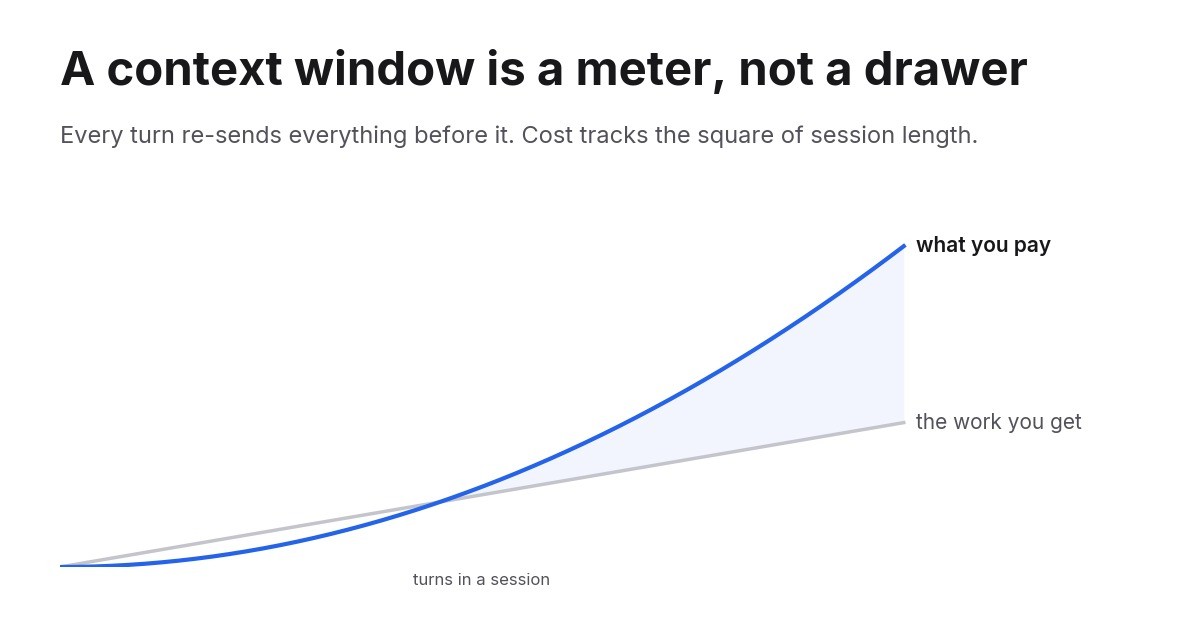
- Een model heeft geen geheugen tussen verzoeken. Elke beurt stuurt het hele gesprek opnieuw mee, dus het contextvenster is een kost die bij elke call wordt aangerekend, geen plek die je één keer vult.
- Daardoor groeit de kost van een sessie met het kwadraat van haar lengte. Prompt caching verlaagt het tarief tot ongeveer een tiende, maar verandert de vorm niet.
- De oplossing is een kleiner venster dat bewust reset: begrens de groei, wis vaker, verwijder verbruikte tooloutput, en houd zwaar leeswerk in bestanden en subagents waar het nooit terugkomt.
Een venster is een meter, geen lade
De meeste mensen zien een contextvenster als opslag. Je stopt er dingen in, het model kan ze zien, een groter venster bevat meer. Dat beeld is op één specifiek punt fout, en die fout is duur.
Modellen zijn stateless. Er is geen sessie aan de andere kant die je gesprek bijhoudt. Elk verzoek stuurt de hele geschiedenis opnieuw mee: de systeemprompt, elke tooldefinitie, elk bestand dat de agent las, elk toolresultaat, elk bericht dat een van jullie schreef. Het model leest het allemaal, antwoordt en vergeet. Je volgende bericht stuurt het allemaal opnieuw mee, plus het nieuwe stuk.
Het venster is dus geen lade. Het is een meter, en de stand ervan op elke beurt is de omvang van alles wat je tot dan toe hebt opgebouwd.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
De rekensom die niemand vooraf maakt
Neem een sessie die met ongeveer 1.000 tokens per beurt groeit en 300 beurten loopt. Haar context klimt van bijna nul naar 300.000 tokens, met een gemiddelde van 150.000. Totaal verzonden invoer: 300 keer 150.000, dat is 45 miljoen tokens, om 300 beurten werk te krijgen.
Laat dezelfde sessie nu drie keer sneller groeien, naar 900.000. Het gemiddelde is 450.000, het totaal is 135 miljoen, drie keer de rekening voor exact dezelfde 300 beurten.
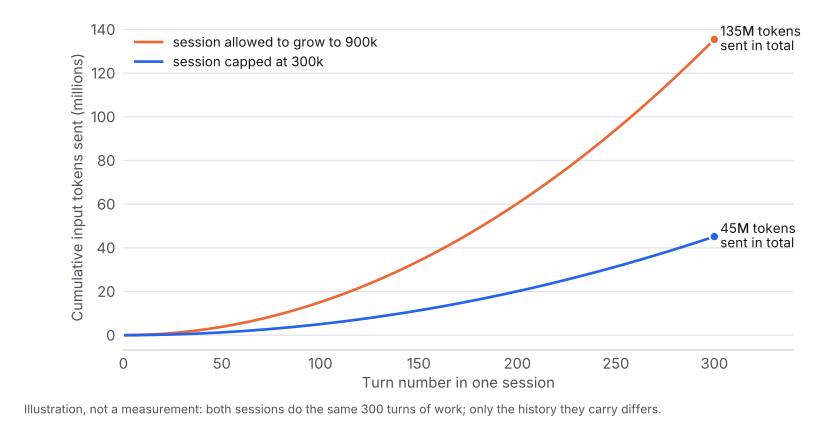
Dat is de vorm van het probleem. De kost volgt niet het werk dat je krijgt. Ze volgt hoe lang je de sessie laat lopen, in het kwadraat. Elke beurt die je toevoegt maakt elke toekomstige beurt duurder, en daarom kan het laatste uur van een lange sessie meer kosten dan de eerste vier.
In geld, tegen de lijstprijs van Claude Opus 5 van $5 per miljoen invoertokens en met alles na de eerste beurt uit cache tegen een tiende daarvan: de begrensde sessie kost ongeveer $22, de onbegrensde ongeveer $68, voor hetzelfde werk. Op een abonnement zie je geen dollars, je ziet de weeklimiet eerder opraken.
Caching verandert het tarief, niet de curve
Prompt caching is de reden dat lange agentsessies überhaupt levensvatbaar zijn. De provider houdt je gespreksprefix warm en rekent een fractie voor het opnieuw lezen ervan.
Op de API van Anthropic zijn de vermenigvuldigers 1,25x de basisinvoerprijs om naar de cache van vijf minuten te schrijven, 2x voor de cache van een uur, en ongeveer 0,1x om te lezen. Een cachewrite van vijf minuten verdient zichzelf terug bij het tweede verzoek. Elke serieuze agent-harness doet dit automatisch, en het werkt: over vijf weken van mijn eigen sessies was 98% van alle invoertokens cachereads.
Kijk goed naar wat caching wel en niet oploste. Het vermenigvuldigde de kost van je geschiedenis met ongeveer een tiende. Het stopte de geschiedenis niet in haar groei, en het stopte niet dat je ze op elke beurt opnieuw leest. Een tiende van 900.000 tokens is 90.000 tokens gefactureerde invoer voor een vraag die je in twintig tokens had kunnen stellen.
Caching is wat het probleem overleefbaar maakt. Het is ook wat het onzichtbaar maakt, want het getal op je usage-dashboard ziet er nooit zo alarmerend uit als het aantal tokens dat werkelijk in beweging is.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
Wat er werkelijk in zit
Wanneer een sessie groot wordt, denken mensen dat het het gesprek is. Meestal is dat niet zo. In een werkende agentsessie zit het gewicht op vier plekken.
Tooldefinities. Elke tool die de agent kan aanroepen draagt een naam, een beschrijving en een volledig parameterschema, allemaal geladen voordat de agent iets doet. Sluit je zes MCP-servers aan met elk 25 tools, dan heb je op beurt één 150 schema’s in het venster, waarvan de meeste nooit worden aangeroepen.
Bestandslezingen. Een agent die een bronbestand van 2.000 regels leest, heeft net ongeveer 25.000 tokens toegevoegd aan elke toekomstige beurt van de sessie. Hij had het bestand één keer nodig. Hij draagt het voor altijd mee.
Tooloutput. Een zoekopdracht die 200 resultaten teruggeeft, een testrun die haar hele log uitspuwt, een API-call die een volledig document retourneert. De agent had meestal één regel ervan nodig. Alles blijft staan.
Het gesprek zelf. Inclusief de stukken waarin de agent een dood spoor verkende, zichzelf corrigeerde en verderging. Die tokens zitten nog steeds in het venster, worden nog steeds opnieuw gelezen en beïnvloeden nog steeds het volgende antwoord.
Het laatste punt is meer dan een kwestie van kost. Een venster vol verlaten pogingen en verouderde bestandsinhoud is ook een venster waarin het relevante detail moeilijker te vinden is. Context is tegelijk een budget en een aandachtprobleem.
Drie manieren om het te verkleinen
Wissen. Start een nieuwe sessie. Alles wat je elders hebt opgeschreven overleeft; al het andere is weg. Dit is het botste gereedschap en vaak het juiste. Eén sessie de hele dag in leven houden omdat ze “het project kent” is de gewoonte die het meest kost.
Contextbewerking. Verwijder specifiek materiaal en houd de rest woord voor woord, meestal oude toolresultaten zodra ze gebruikt zijn. De API van Anthropic stelt dit direct beschikbaar als context-managementstrategie. Het is precies en vervormt wat overblijft niet, dus het is het eerste waarnaar je grijpt wanneer het gewicht omvangrijke tooloutput is in plaats van een lang gesprek.
Compacting. Vat de geschiedenis samen en ga verder vanaf de samenvatting. Dit doen de meeste codingagents automatisch wanneer het venster vol raakt, en het is de enige optie die de groei van een sessie begrenst zonder ze te beëindigen. Er valt heel wat weg.
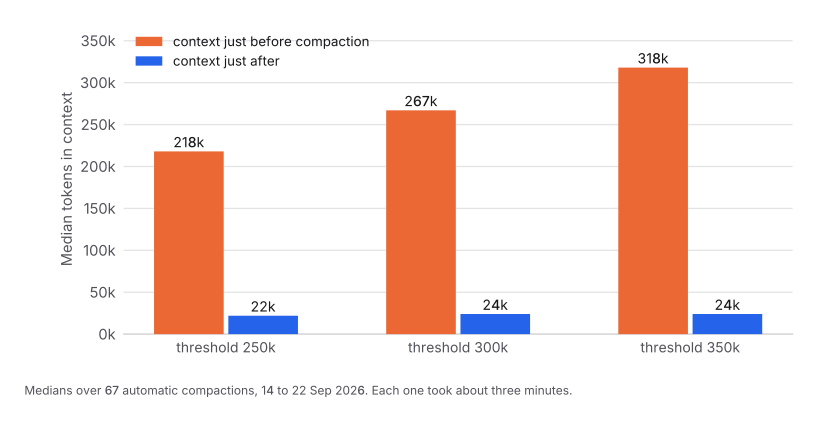
Dat zijn medianen over 67 echte compactingen in mijn eigen sessies. Elk duurde ongeveer drie minuten, en daarna herlas de agent bestanden die hij al had gezien bijna twee keer zo vaak als voordien, om opnieuw op te bouwen wat de samenvatting had verloren. De ruil is het waard. Het blijft een ruil.
De vierde optie is beter dan alle drie
Stop het niet in het venster in de eerste plaats.
Houd duurzame state in bestanden die de agent op verzoek opnieuw kan lezen, in plaats van in het gesprek. Stuur leesintensief werk naar een subagent met een eigen kortlevende context, zodat de twintig bestanden die hij leest de hoofdsessie nooit raken. Laad tools wanneer ze nodig zijn in plaats van allemaal vooraf.
Een token dat nooit wordt toegevoegd is een token dat je nooit opnieuw leest. Al het andere op deze pagina is schadebeperking voor tokens die dat wel werden.
Waar de drempel moet liggen
Als je agent automatisch compacteert, heeft hij een drempel, en de standaardwaarde ligt meestal dicht bij het volledige venster van het model. Die standaardwaarde is de dure instelling, want ze laat je sessie haar meest productieve uren doorbrengen met het dragen van de grootst mogelijke geschiedenis.
Hem lager zetten helpt, maar er is een ondergrens. Compacteer te gretig en je betaalt keer op keer de wachttijd van drie minuten en het herwerk. Op een model met 1M-context dwong een drempel van 250.000 een compacting af in 36% van mijn lange sessies; 350.000 veroorzaakte er een in slechts 12% en leverde bijna dezelfde besparing op. Over vijf weken sessies was het resultaat 17% minder cachegewogen tokens voor hetzelfde aantal prompts, en ongeveer de helft van de kost in de lange sessies waar het plafond echt knelde. De volledige data staan in het bijbehorende bericht .
Een werkbare regel: zet het plafond op ongeveer een derde van het venster van je model en stel van daaruit bij. Laag genoeg dat geen enkele sessie urenlang tegen het plafond aan zit, hoog genoeg dat gewoon werk afraakt zonder door een samenvatting te worden onderbroken.
Meet je eigen gebruik
Niets hiervan vereist nieuwe instrumentatie. Elke API-respons draagt een usage-object met vier velden: input_tokens, cache_creation_input_tokens, cache_read_input_tokens en output_tokens. De meeste agent-harnesses schrijven deze al naar een sessielog op schijf.
Twee getallen vertellen je bijna alles.
Cachegewogen invoer per call. Weeg de velden naar wat ze kosten: verse invoer op 1, cachewrites op 1,25 of 2, cachereads op 0,1. Als dit week na week stijgt terwijl je werklast gelijk blijft, groeien je sessies en betaal je daarvoor.
Piekcontext per sessie. De grootste enkele call in elke sessie. Als de pieken dicht bij het venster van je model liggen, heb je je rekening gevonden.
Ruwe weektotalen zullen je misleiden, want een drukke week verslaat een rustige week, wat je ook verandert. Deel altijd door iets dat werk vertegenwoordigt: een afgeronde taak, een prompt, een API-call.
Lees hierna
Een contextvenster is een terugkerende kost, aangerekend op elke beurt, voor alles wat je er ooit in hebt gestopt. Caching verlaagt het tarief met ongeveer negentig procent en verbergt de trend. De oplossing is een kleiner venster dat bewust reset.
Voor de gemeten versie, met vijf weken sessiedata en de ene instelling die het grootste deel van de besparing opleverde, lees het bijbehorende stuk over het verlagen van het tokengebruik van agents met 17% .
