


De korte versie
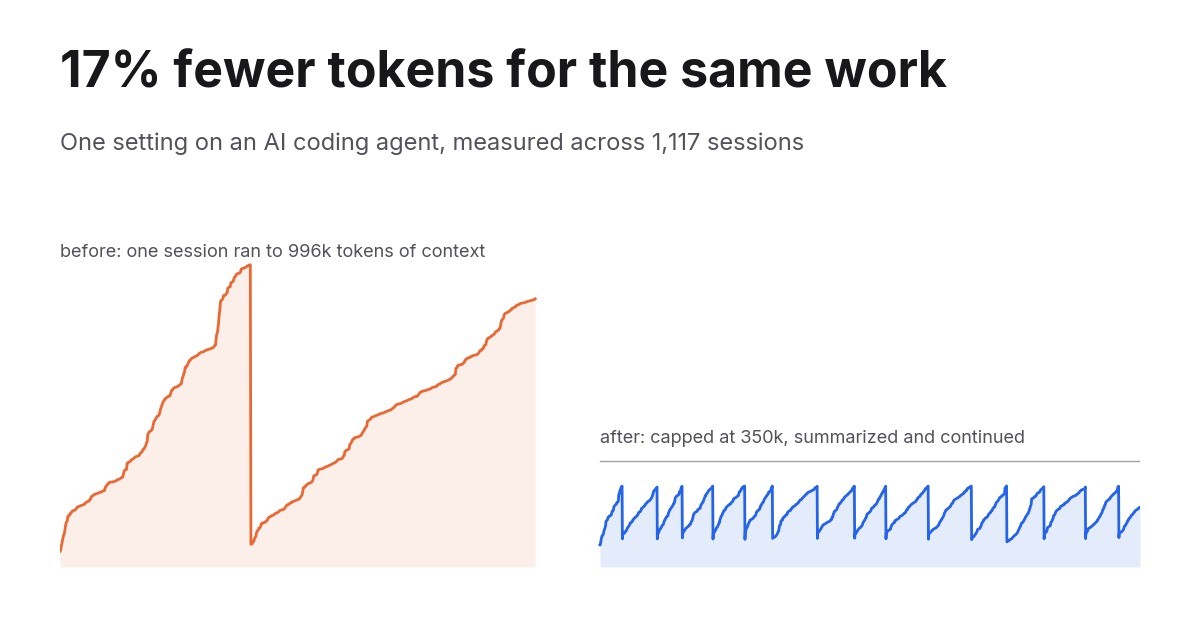
- Ik draai de hele dag een AI-codingagent op een model met een contextvenster van 1M tokens. Sessies groeiden voorheen tot ze het bijna vulden.
- Ik voegde één regel toe aan de configuratie, die een sessie beperkt tot 350.000 tokens context voordat hij zichzelf samenvat en verdergaat.
- Gemeten over 1.117 sessietranscripten: 17% minder tokens voor hetzelfde aantal prompts, en in de lange sessies waar de limiet echt aanslaat 55% minder.
Hieronder staat de methode, elke grafiek en wat het je kost, zodat je kunt beslissen of het op jouw opzet van toepassing is.
Waarom een venster van 1M meer kost dan het lijkt
Een gesprek met een model is stateless. Elk verzoek draagt de hele geschiedenis mee: de systeemprompt, elke tooldefinitie, elk bestand dat de agent heeft gelezen, elk toolresultaat, elk bericht. Geen delta. Alles, elke keer.
Dus een sessie die is gegroeid tot 900.000 tokens betaalt bij de volgende aanroep voor 900.000 tokens input, en bij de aanroep daarna weer. Beurt 400 verricht niet meer werk dan beurt 4. Hij kost alleen vele malen meer.
Prompt-caching verzacht dit. Tokens die het model eerder heeft gezien, worden gefactureerd tegen ongeveer een tiende van de normale inputprijs. Die korting is echt, zij is wat lange sessies überhaupt levensvatbaar maakt, en zij is ook de reden dat niemand naar het probleem kijkt. In mijn data bestond 98% van alle inputtokens uit cache-reads. Een tiende van een heel groot getal was nog steeds de grootste post op de rekening.
De vraag is niet of je geschiedenis gecached wordt. De vraag is hoe groot hij mag worden voordat iets hem reset.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
Wat ik heb gewijzigd
De agent is Claude Code die Opus draait op het contextvenster van 1M. De instelling is autoCompactWindow in ~/.claude/settings.json. Wanneer een sessie dat aantal tokens bereikt, vat de agent het gesprek samen en gaat verder vanaf de samenvatting.
{
  "autoCompactWindow": 350000
}
Ik had die nooit ingesteld, dus sessies liepen door tot ze het volledige venster naderden. In vier dagen tijd probeerde ik drie waarden:
| Datum | Instelling |
|---|---|
| 14 september | 250.000 |
| 15 september | 300.000 |
| 18 september | 350.000 |
Hoe ik het heb gemeten
Claude Code schrijft elke sessie naar een JSONL-transcript onder ~/.claude/projects/, inclusief het tokenverbruik van elke API-aanroep. Ik heb alle 1.117 ervan geparseerd, over vijf weken van 19 augustus tot 22 september, gededupliceerd op request-ID en alleen interactieve sessies behouden. Runs in GitHub Actions gebruiken hetzelfde account, maar kunnen niet worden beïnvloed door een instelling op mijn laptop, dus die zijn uitgesloten.
Ruwe tokentotalen zijn op zichzelf misleidend. Een drukke week verslaat een rustige week, wat je ook verandert. Daarom is elk cijfer hieronder cache-gewogen, wat is wat de meter feitelijk meet: verse input tegen 1x, cache-writes tegen 1,25x (cache van 5 minuten) of 2x (cache van 1 uur), cache-reads tegen 0,1x. En elke vergelijking is genormaliseerd naar verricht werk, ofwel de prompts die ik typte of de API-aanroepen die de agent deed.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
Twee sessies, dezelfde agent
Dit is het mechanisme in één beeld. Links een echte sessie van 3 september, vóór de limiet. Rechts een echte sessie van 15 september, erna.
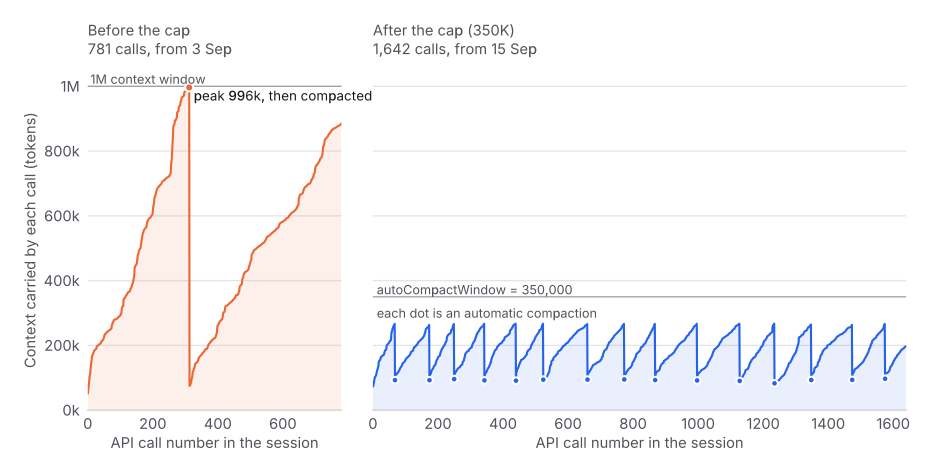
De sessie links liep 781 aanroepen. Hij klom naar 996.000 tokens context, raakte de muur van het 1M-venster, werd één keer gecompacteerd en klom daarna direct terug naar 880.000. In de tweede helft van die sessie las elke afzonderlijke aanroep meer dan een half miljoen tokens opnieuw.
De sessie rechts liep 1.642 aanroepen, meer dan twee keer zo lang, en droeg nooit meer dan 270.000. Hij werd vijftien keer gecompacteerd. Elke compactie is een punt.
De wekelijkse cijfers
Alleen interactieve sessies. De balken zijn cache-gewogen inputtokens per API-aanroep, wat het eerlijkste enkele getal is omdat het er niet toe doet hoeveel ik in een bepaalde week heb gewerkt.
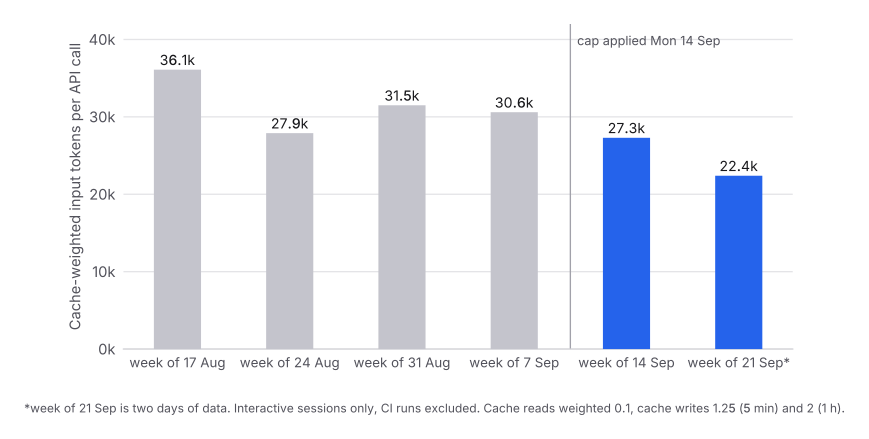
De schoonste vergelijking in de dataset is de week van 7 september tegen de week van 14 september, omdat ik die niet zelf heb gekozen. Ze kwamen simpelweg aan weerszijden van de wijziging te liggen, en ik typte in elk ervan bijna exact hetzelfde aantal prompts.
| Week van | Prompts | API-aanroepen | Cache-gewogen input | Per aanroep |
|---|---|---|---|---|
| 7 sep | 971 | 11.364 | 348,1M | 30,6k |
| 14 sep | 968 | 10.555 | 288,5M | 27,3k |
971 prompts tegen 968. Effectieve input omlaag van 348,1M naar 288,5M. Dat is 17% minder voor dezelfde hoeveelheid prompts. De twee dagen van de daaropvolgende week kwamen uit op 22,4k per aanroep, nog lager.
Waar het geld naartoe ging
Splits elke API-aanroep naar hoeveel context hij meedroeg, en het mechanisme wordt direct zichtbaar.
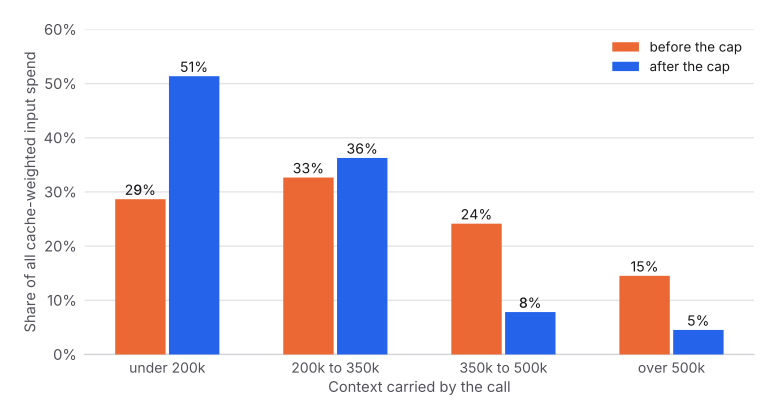
Vóór de limiet ging 39% van alles wat ik uitgaf naar aanroepen die meer dan 350.000 tokens geschiedenis met zich mee sleurden. Die aanroepen deden niet meer werk dan de andere. Het was hetzelfde werk, met meer bagage. Na de limiet is dat aandeel 12%.
Hield het plafond stand
Één punt per sessie, geplaatst op de grootste context die die sessie ooit meedroeg.
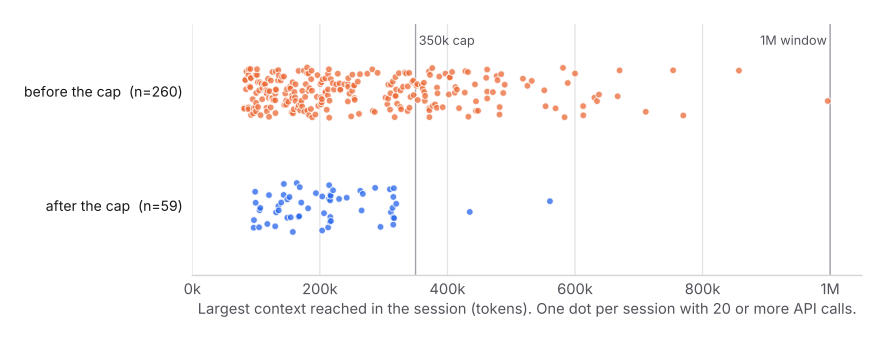
Twee sessies in de eerste twee dagen liepen nog voorbij de limiet, naar 434.000 en 561.000, en ik heb niet ontdekt waarom. Sinds de instelling van 350.000 op 18 september inging, heeft geen enkele sessie die overschreden. De staart van sessies tussen 500k en 1M, waar de meeste verspilling zat, is verdwenen.
Wat het zou hebben gekost zonder de limiet
Om er een totaal op te plakken, heb ik elke sessie die na de wijziging begon opnieuw afgespeeld alsof de weggevallen context nooit was samengevat en bij elke latere aanroep nog steeds opnieuw werd gelezen, begrensd op het 1M-venster.
| Cache-gewogen input | |
|---|---|
| Werkelijk, 73 sessies, 9.675 aanroepen, 55 compacties | 216,8M |
| Dezelfde sessies zonder de limiet | 479,2M |
| Vermeden | 262,5M, oftewel 55% |
De sessie rechts in de eerste grafiek is daar alleen al goed voor 118,5M. Een lange refactor die anders zijn laatste paar honderd aanroepen zou hebben besteed aan het opnieuw lezen van bijna een miljoen tokens per keer.
Beschouw 55% als het optimistische uiteinde. Zonder de limiet zou ik een sessie niet echt urenlang op 900k hebben laten doorjakkeren; uiteindelijk zou ik hem handmatig hebben gewist, wat de kosten ook reset. Het conservatieve uiteinde is het waargenomen cijfer per aanroep, van 30,6k naar 22,4k, dus ruwweg 20% tot 27%. De waarheid ligt ergens tussen die twee.
Wat het je kost
Dit is niet gratis, en iedereen die het aanraadt zou dat moeten zeggen.
Wachten. 67 compacties sinds de wijziging, met een mediaan van ongeveer drie minuten per stuk. Ruwweg 3,4 uur kijken naar het schrijven van een samenvatting, verspreid over acht dagen.
Wat herwerk. Compactie laat veel vallen. Bij de instelling van 350K bracht de mediane compactie een sessie van 318.000 tokens terug naar 24.000. De agent verliest detail en reconstrueert het soms: bestanden die binnen dezelfde sessie opnieuw werden gelezen, gingen van 11,5% van de reads vóór de eerste compactie naar 20,5% erna. De steekproef achter dat tweede getal is klein, dus lees het als een richting, niet als een meting.
De keuze van de drempel doet ertoe. Bij 250K kwam 36% van mijn lange sessies aan een compactie toe. Bij 350K was dat 12%, terwijl het plafond nog steeds standhield. Zet hem te laag en je betaalt de drie minuten en het herwerk keer op keer voor een besparing die je al binnen had.
Hoe je het instelt
Claude Code. Voeg autoCompactWindow toe aan ~/.claude/settings.json. Op een model met 1M context was 350.000 de beste van de drie waarden die ik probeerde. Op een model met 200K schaal je omlaag en begin je rond 120.000 tot 140.000. Nieuwe sessies pikken het op; een sessie die al loopt houdt de oude waarde.
Andere agents. Zoek naar hetzelfde idee onder een andere naam: een compactietrigger, een contextlimiet, een drempel voor samenvatten-en-doorgaan. Is die er niet, dan is de handmatige versie: de sessie vaker wissen dan natuurlijk voelt. Het instinct om de hele dag één lange sessie in leven te houden omdat hij “het project kent” is het dure instinct.
Wat je ook gebruikt, twee gewoontes doen meer dan welke instelling dan ook. Bewaar duurzame status in bestanden in plaats van in het gesprek, zodat de agent één bestand goedkoop opnieuw kan lezen in plaats van voor altijd elk eerder antwoord mee te dragen. En schuif leesintensief werk door naar subagents met hun eigen kortlevende context, zodat de twintig bestanden die zij lezen nooit in de hoofdsessie terechtkomen.
Als je op een weeklimiet zit
Als je een abonnement betaalt met een wekelijks gebruikslimiet in plaats van een rekening per token, is dit de hefboom met de beste verhouding tussen inspanning en effect die ik heb gevonden. Eén regel JSON, geen verandering in hoe je werkt, en dezelfde limiet rekt meetbaar verder op. In mijn geval kostte hetzelfde wekelijkse volume aan prompts 17% minder, en de lange sessies ongeveer de helft.
Lees hierna
Contextvensters worden verkocht als capaciteit. Ze gedragen zich als een lopende meter, die bij elke beurt alles factureert wat je er ooit in hebt gestopt. Wil je de mechanica hierachter in plaats van alleen de instelling, dan loopt het begeleidende stuk door wat een contextvenster werkelijk vult, waarom een lange sessie veel meer kost dan het werk dat hij doet, en hoe caching, wissen en compactie elk de rekensom veranderen.
