


Pe scurt
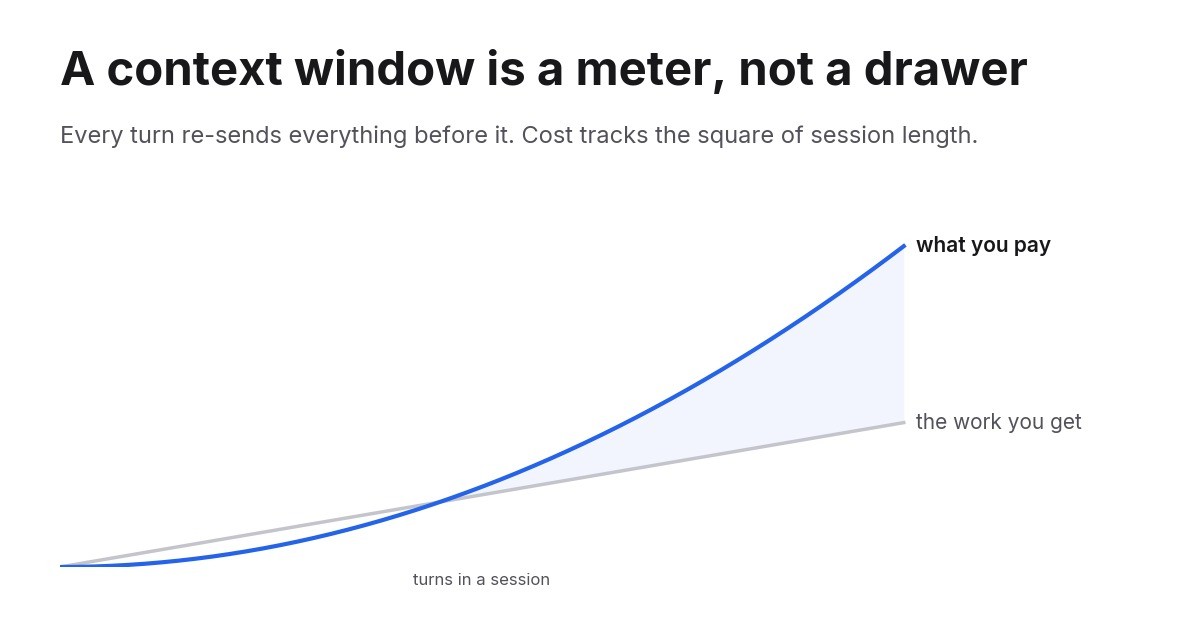
- Un model nu are memorie între cereri. Fiecare tură retrimite întreaga conversație, așa că fereastra de context este un cost perceput la fiecare apel, nu un loc pe care îl umpli o singură dată.
- Asta face ca costul unei sesiuni să crească cu pătratul lungimii ei. Prompt caching reduce tariful la aproximativ o zecime, dar nu schimbă forma curbei.
- Soluția este o fereastră mai mică, care se resetează intenționat: limitează-i creșterea, golește mai des, elimină rezultatele de unelte deja consumate și ține citirea grea în fișiere și subagenți, de unde nu se mai întoarce.
O fereastră este un contor, nu un sertar
Majoritatea oamenilor își imaginează fereastra de context ca pe un spațiu de stocare. Pui lucruri în ea, modelul le vede, o fereastră mai mare ține mai mult. Această imagine este greșită într-un mod anume, iar greșeala este costisitoare.
Modelele sunt fără stare. Nu există nicio sesiune la celălalt capăt care să-ți țină conversația. Fiecare cerere trimite din nou întregul istoric: promptul de sistem, fiecare definiție de unealtă, fiecare fișier citit de agent, fiecare rezultat de unealtă, fiecare mesaj scris de oricare dintre voi. Modelul citește tot, răspunde și uită. Următorul tău mesaj trimite totul din nou, plus partea nouă.
Deci fereastra nu este un sertar. Este un contor, iar citirea lui la fiecare tură este mărimea a tot ce ai acumulat până acum.

Pregătit să îți dezvolți afacerea?
Începe perioada de probă gratuită astăzi și vezi rezultate în câteva zile.
Aritmetica pe care nimeni nu o face de la început
Ia o sesiune care crește cu aproximativ 1.000 de tokeni pe tură și rulează 300 de ture. Contextul ei urcă de la aproape zero la 300.000 de tokeni, cu o medie de 150.000. Total input trimis: 300 înmulțit cu 150.000, adică 45 de milioane de tokeni, pentru a obține 300 de ture de lucru.
Acum lasă aceeași sesiune să crească de trei ori mai repede, până la 900.000. Media este 450.000, totalul este 135 de milioane, de trei ori factura pentru exact aceleași 300 de ture.
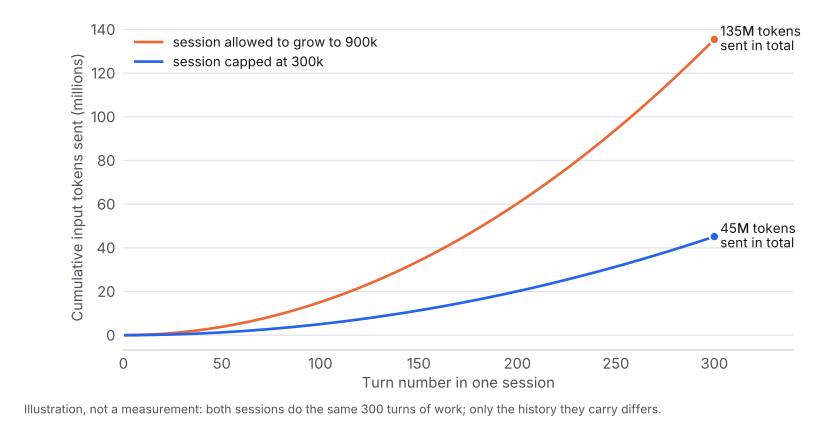
Aceasta este forma problemei. Costul nu urmărește munca pe care o obții. Urmărește cât timp lași sesiunea să ruleze, la pătrat. Fiecare tură pe care o adaugi face fiecare tură viitoare mai scumpă, motiv pentru care ultima oră a unei sesiuni lungi poate costa mai mult decât primele patru.
În bani, la prețul de listă al Claude Opus 5 de 5 dolari pe milion de tokeni de input și cu tot ce urmează după prima tură servit din cache la o zecime din acest preț: sesiunea plafonată costă aproximativ 22 de dolari, cea neplafonată aproximativ 68 de dolari, pentru aceeași muncă. Pe un abonament nu vezi dolari, vezi că limita săptămânală se epuizează mai repede.
Cache-ul schimbă tariful, nu curba
Prompt caching este motivul pentru care sesiunile lungi de agent sunt viabile. Furnizorul păstrează cald prefixul conversației tale și percepe o fracțiune din preț pentru a-l reciti.
În API-ul Anthropic, multiplicatorii sunt 1,25x prețul de bază al inputului pentru scrierea în cache-ul de cinci minute, 2x pentru cache-ul de o oră și aproximativ 0,1x pentru citire. O scriere în cache-ul de cinci minute se amortizează la a doua cerere. Orice harness serios de agent face asta automat și funcționează: pe parcursul a cinci săptămâni de sesiuni ale mele, 98% din toți tokenii de input au fost citiri din cache.
Privește atent ce a rezolvat cache-ul și ce nu. A înmulțit costul istoricului tău cu aproximativ o zecime. Nu a oprit creșterea istoricului și nu te-a oprit să îl recitești la fiecare tură. O zecime din 900.000 de tokeni înseamnă 90.000 de tokeni de input facturați pentru o întrebare pe care ai fi putut-o pune în douăzeci.
Cache-ul este ceea ce face problema suportabilă. Este și ceea ce o face invizibilă, pentru că numărul din panoul tău de utilizare nu pare niciodată la fel de alarmant ca numărul de tokeni care circulă de fapt.
Abonează-te la newsletter-ul nostru
Primește cele mai recente sfaturi, tendințe și oferte gratuit.
Ce se află de fapt acolo
Când o sesiune devine mare, oamenii presupun că este conversația. De obicei nu este. Într-o sesiune de agent care funcționează, greutatea stă în patru locuri.
Definițiile uneltelor. Fiecare unealtă pe care agentul o poate apela are un nume, o descriere și o schemă completă de parametri, toate încărcate înainte ca agentul să facă ceva. Conectează șase servere MCP cu câte 25 de unelte fiecare și ai 150 de scheme în fereastră încă din prima tură, dintre care majoritatea nu vor fi niciodată apelate.
Citirile de fișiere. Un agent care citește un fișier sursă de 2.000 de linii tocmai a adăugat aproximativ 25.000 de tokeni la fiecare tură viitoare a sesiunii. A avut nevoie de fișier o singură dată. Îl cară pentru totdeauna.
Rezultatele uneltelor. O căutare care returnează 200 de rezultate, o rulare de teste care își tipărește tot logul, un apel API care returnează un document întreg. Agentul avea nevoie de obicei de o singură linie din el. Tot restul rămâne.
Conversația în sine. Inclusiv părțile în care agentul a explorat o fundătură, s-a corectat și a mers mai departe. Acei tokeni sunt încă în fereastră, sunt încă recitiți, încă influențează următorul răspuns.
Ultimul punct contează dincolo de cost. O fereastră plină de încercări abandonate și de conținuturi de fișiere perimate este și o fereastră în care detaliul relevant este mai greu de găsit. Contextul este simultan o problemă de buget și una de atenție.
Trei moduri de a o micșora
Golirea. Începe o sesiune nouă. Tot ce ai notat în altă parte supraviețuiește; restul dispare. Acesta este cel mai brutal instrument și adesea cel potrivit. Să ții o singură sesiune activă toată ziua pentru că „cunoaște proiectul” este obiceiul care costă cel mai mult.
Editarea contextului. Elimină material specific și păstrează restul cuvânt cu cuvânt, de obicei rezultate vechi de unelte, odată ce au fost folosite. API-ul Anthropic expune acest lucru direct ca strategie de gestionare a contextului. Este precisă și nu distorsionează ce rămâne, așa că este primul lucru la care să apelezi când greutatea constă în rezultate voluminoase de unelte, nu într-o conversație lungă.
Compactarea. Rezumă istoricul și continuă din rezumat. Este ceea ce fac automat majoritatea agenților de codare când fereastra se umple și este singura opțiune care limitează creșterea unei sesiuni fără a o încheia. Elimină foarte mult.
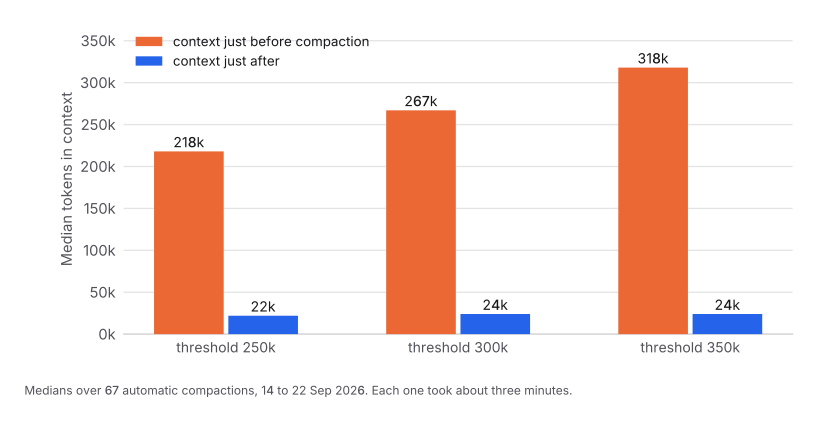
Acestea sunt mediane pentru 67 de compactări reale din propriile mele sesiuni. Fiecare a durat aproximativ trei minute, iar după aceea agentul a recitit fișiere pe care le văzuse deja, la aproape dublul ratei anterioare, reconstruind ce a pierdut rezumatul. Compromisul merită. Rămâne totuși un compromis.
A patra opțiune este mai bună decât toate trei
Nu o pune în fereastră de la bun început.
Păstrează starea durabilă în fișiere pe care agentul le poate reciti la cerere, în loc să o ții în conversație. Trimite munca intensivă de citire către un subagent cu context propriu de scurtă durată, astfel încât cele douăzeci de fișiere pe care le citește să nu atingă niciodată sesiunea principală. Încarcă uneltele când sunt necesare, nu pe toate de la început.
Un token care nu este niciodată adăugat este un token pe care nu îl recitești niciodată. Tot restul din această pagină este limitarea pagubelor pentru tokenii care au fost adăugați.
Unde ar trebui să se afle pragul
Dacă agentul tău compactează automat, are un prag, iar valoarea implicită este de obicei aproape de fereastra completă a modelului. Această valoare implicită este setarea scumpă, pentru că lasă sesiunea să petreacă cele mai productive ore cărând cel mai mare istoric posibil.
O valoare mai mică ajută, dar există un prag minim. Compactează prea zelos și plătești așteptarea de trei minute și reluarea muncii iar și iar. Pe un model cu context de 1M, un prag de 250.000 a forțat o compactare în 36% din sesiunile mele lungi; 350.000 a declanșat una doar în 12% și a capturat aproape toată aceeași economie. Pe cinci săptămâni de sesiuni, rezultatul a fost cu 17% mai puțini tokeni ponderați prin cache pentru același număr de prompturi și aproximativ jumătate din cost în sesiunile lungi unde plafonul chiar a contat. Datele complete sunt în articolul însoțitor .
O regulă funcțională: setează plafonul la aproximativ o treime din fereastra modelului tău și ajustează de acolo. Suficient de scăzut încât nicio sesiune să nu petreacă ore aproape de plafon, suficient de ridicat încât munca obișnuită să se termine fără a fi întreruptă de un rezumat.
Măsoară-ți propriile cifre
Nimic din toate acestea nu necesită instrumentare nouă. Fiecare răspuns API conține un obiect de utilizare cu patru câmpuri: input_tokens, cache_creation_input_tokens, cache_read_input_tokens și output_tokens. Majoritatea harness-urilor de agenți scriu deja aceste date într-un jurnal de sesiune pe disc.
Două numere îți spun aproape totul.
Input ponderat prin cache per apel. Ponderează câmpurile după ce costă: input nou la 1, scrieri în cache la 1,25 sau 2, citiri din cache la 0,1. Dacă acest număr crește de la o săptămână la alta în timp ce volumul tău de muncă rămâne constant, sesiunile tale cresc și plătești pentru asta.
Contextul de vârf per sesiune. Cel mai mare apel individual din fiecare sesiune. Dacă vârfurile se situează aproape de fereastra modelului tău, ai găsit factura.
Totalurile săptămânale brute te vor induce în eroare, pentru că o săptămână aglomerată bate o săptămână liniștită indiferent ce schimbi. Împarte întotdeauna la ceva care reprezintă muncă: o sarcină finalizată, un prompt, un apel API.
Citește în continuare
O fereastră de context este o taxă recurentă, percepută la fiecare tură, pentru tot ce ai pus vreodată în ea. Cache-ul reduce tariful cu aproximativ nouăzeci la sută și ascunde tendința. Soluția este o fereastră mai mică, care se resetează intenționat.
Pentru versiunea măsurată, cu cinci săptămâni de date de sesiune și singura setare care a produs cea mai mare parte a economiei, citește articolul însoțitor despre reducerea consumului de tokeni al agentului cu 17% .
