


Kortversjonen
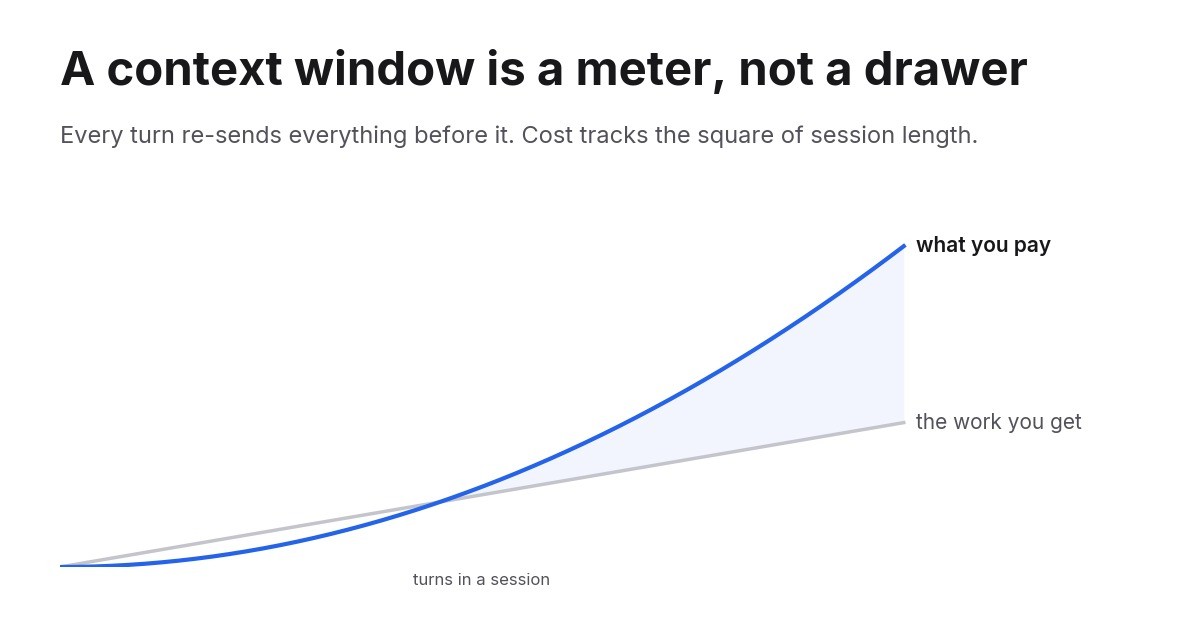
- En modell har ingen hukommelse mellom forespørsler. Hver tur sender hele samtalen på nytt, så kontekstvinduet er en kostnad som belastes ved hvert kall, ikke et sted du fyller én gang.
- Det gjør at kostnaden for en økt vokser med kvadratet av lengden. Prompt-caching kutter satsen til omtrent en tidel, men endrer ikke formen.
- Løsningen er et mindre vindu som nullstilles med vilje: begrens veksten, tøm oftere, rediger bort brukte verktøyutdata, og hold tung lesing i filer og subagenter der det aldri kommer tilbake.
Et vindu er en måler, ikke en skuff
De fleste ser for seg et kontekstvindu som lagring. Du putter ting inn, modellen kan se dem, et større vindu rommer mer. Det bildet er feil på én bestemt måte, og feilen er dyr.
Modeller er tilstandsløse. Det finnes ingen økt i den andre enden som holder på samtalen din. Hver forespørsel sender hele historikken på nytt: systemprompten, hver verktøydefinisjon, hver fil agenten leste, hvert verktøyresultat, hver melding en av dere skrev. Modellen leser alt sammen, svarer og glemmer. Din neste melding sender alt sammen på nytt, pluss den nye delen.
Så vinduet er ikke en skuff. Det er en måler, og avlesningen på hver tur er størrelsen på alt du har samlet opp så langt.

Klar til å vokse bedriften din?
Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
Regnestykket ingen gjør på forhånd
Ta en økt som vokser med omtrent 1 000 tokens per tur og varer i 300 turer. Konteksten klatrer fra nær null til 300 000 tokens, med et gjennomsnitt på 150 000. Totalt sendt input: 300 ganger 150 000, altså 45 millioner tokens, for å få 300 turer med arbeid.
La nå den samme økten vokse tre ganger så raskt, til 900 000. Gjennomsnittet er 450 000, totalen er 135 millioner, tre ganger regningen for nøyaktig de samme 300 turene.
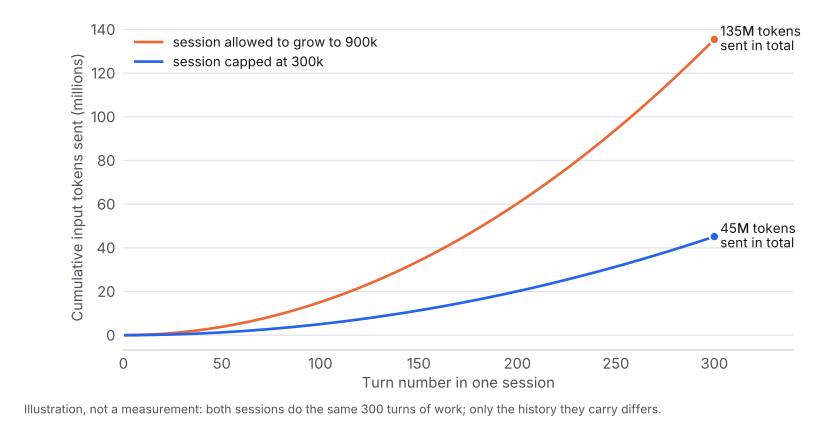
Det er formen på problemet. Kostnaden følger ikke arbeidet du får gjort. Den følger hvor lenge du lar økten kjøre, kvadrert. Hver tur du legger til, gjør hver framtidig tur dyrere, og derfor kan den siste timen av en lang økt koste mer enn de fire første.
I penger, med Claude Opus 5s listepris på 5 dollar per million input-tokens og med alt etter første tur servert fra cache til en tidel av det: den begrensede økten koster rundt 22 dollar, den ubegrensede rundt 68 dollar, for samme arbeid. På et abonnement ser du ikke dollar, du ser at den ukentlige grensen tar slutt tidligere.
Caching endrer satsen, ikke kurven
Prompt-caching er grunnen til at lange agentøkter i det hele tatt er gjennomførbare. Leverandøren holder samtaleprefikset ditt varmt og tar en brøkdel av prisen for å lese det på nytt.
På Anthropics API er multiplikatorene 1,25x grunnprisen for input for å skrive til fem-minutters-cachen, 2x for én-times-cachen, og omtrent 0,1x for å lese. En fem-minutters cache-skriving betaler seg selv ved andre forespørsel. Alle seriøse agent-rammeverk gjør dette automatisk, og det virker: gjennom fem uker med mine egne økter var 98 % av alle input-tokens cache-lesinger.
Se nøye på hva caching løste og ikke løste. Den reduserte kostnaden for historikken din til omtrent en tidel. Den stoppet ikke historikken fra å vokse, og den stoppet deg ikke fra å lese den på nytt ved hver tur. En tidel av 900 000 tokens er 90 000 tokens fakturert input for et spørsmål du kunne stilt på tjue.
Caching er det som gjør problemet overlevelig. Det er også det som gjør det usynlig, fordi tallet på bruksdashbordet ditt aldri ser like alarmerende ut som antallet tokens som faktisk flyttes.
Bli med i vårt nyhetsbrev
Få de siste tipsene, trendene og tilbudene gratis.
Hva som faktisk ligger der inne
Når en økt blir stor, tror folk at det er samtalen. Vanligvis er det ikke det. I en fungerende agentøkt ligger vekten på fire steder.
Verktøydefinisjoner. Hvert verktøy agenten kan kalle, har et navn, en beskrivelse og et fullstendig parameterskjema, alt lastet inn før agenten gjør noe som helst. Koble til seks MCP-servere med 25 verktøy hver, og du har 150 skjemaer i vinduet på første tur, de fleste av dem vil aldri bli kalt.
Filinnlesing. En agent som leser en kildefil på 2 000 linjer, har nettopp lagt til rundt 25 000 tokens på hver framtidige tur i økten. Den trengte filen én gang. Den bærer den for alltid.
Verktøyutdata. Et søk som returnerer 200 treff, en testkjøring som skriver ut hele loggen, et API-kall som returnerer et helt dokument. Agenten trengte vanligvis én linje av det. Alt blir liggende.
Selve samtalen. Inkludert delene der agenten utforsket en blindgate, korrigerte seg selv og gikk videre. Disse tokenene ligger fortsatt i vinduet, blir fortsatt lest på nytt, former fortsatt neste svar.
Det siste punktet betyr noe utover kostnad. Et vindu fullt av forlatte forsøk og utdatert filinnhold er også et vindu der den relevante detaljen er vanskeligere å finne. Kontekst er et budsjett og et oppmerksomhetsproblem på samme tid.
Tre måter å krympe det på
Tømming. Start en ny økt. Alt du skrev ned andre steder, overlever; alt annet er borte. Dette er det groveste verktøyet og ofte det riktige. Å holde én økt i live hele dagen fordi den «kjenner prosjektet», er vanen som koster mest.
Kontekstredigering. Fjern bestemt materiale og behold resten ord for ord, vanligvis gamle verktøyresultater når de er brukt. Anthropics API eksponerer dette direkte som en strategi for kontekststyring. Det er presist og forvrenger ikke det som blir igjen, så det er det første du bør gripe til når vekten er klumpete verktøyutdata snarere enn en lang samtale.
Komprimering. Oppsummer historikken og fortsett fra sammendraget. Dette er det de fleste kodeagenter gjør automatisk når vinduet fylles, og det er det eneste alternativet som begrenser en økts vekst uten å avslutte den. Det slipper en hel del.
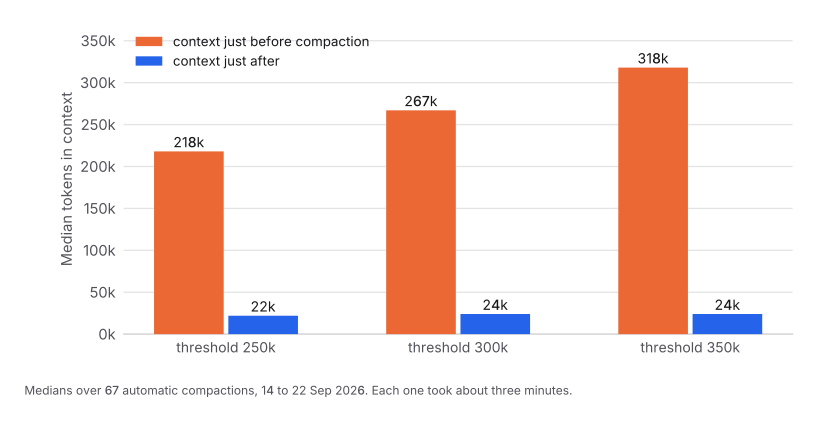
Dette er medianer over 67 virkelige komprimeringer i mine egne økter. Hver tok omtrent tre minutter, og etterpå leste agenten filer den allerede hadde sett, i nesten dobbelt så høy takt som før, og bygde opp igjen det sammendraget mistet. Byttet er verdt det. Det er fortsatt et bytte.
Det fjerde alternativet er bedre enn alle tre
Ikke putt det i vinduet i utgangspunktet.
Hold varig tilstand i filer agenten kan lese på nytt ved behov, i stedet for i samtalen. Send lesetungt arbeid til en subagent med sitt eget kortlivede kontekstvindu, slik at de tjue filene den leser, aldri berører hovedøkten. Last inn verktøy når de trengs, i stedet for alle på forhånd.
Et token som aldri blir lagt til, er et token du aldri leser på nytt. Alt annet på denne siden er skadebegrensning for tokens som ble lagt til.
Hvor terskelen bør ligge
Hvis agenten din komprimerer automatisk, har den en terskel, og standardverdien ligger vanligvis nær modellens fulle vindu. Den standardverdien er den dyre innstillingen, fordi den lar økten bruke sine mest produktive timer på å bære størst mulig historikk.
Å sette den lavere hjelper, men det finnes et gulv. Komprimer for ivrig, og du betaler tre minutters venting og omarbeidet om og om igjen. På en modell med 1M kontekst tvang en terskel på 250 000 fram en komprimering i 36 % av mine lange økter; 350 000 utløste det i bare 12 % og fanget nesten hele den samme besparelsen. Over fem uker med økter var resultatet 17 % færre cache-vektede tokens for det samme antallet prompter, og omtrent halve kostnaden i de lange øktene der taket faktisk bet. De fulle dataene er i følgeinnlegget .
En brukbar regel: sett taket på omtrent en tredjedel av modellens vindu og juster derfra. Lavt nok til at ingen økt tilbringer timer nær taket, høyt nok til at vanlig arbeid blir ferdig uten å bli avbrutt av et sammendrag.
Mål dine egne
Ingenting av dette krever ny instrumentering. Hver API-respons inneholder et usage-objekt med fire felt: input_tokens, cache_creation_input_tokens, cache_read_input_tokens og output_tokens. De fleste agent-rammeverk skriver allerede disse til en øktlogg på disk.
To tall forteller deg nesten alt.
Cache-vektet input per kall. Vekt feltene etter hva de koster: frisk input til 1, cache-skrivinger til 1,25 eller 2, cache-lesinger til 0,1. Hvis dette klatrer uke for uke mens arbeidsmengden er flat, vokser øktene dine, og du betaler for det.
Toppkontekst per økt. Det største enkeltkallet i hver økt. Hvis toppene ligger nær modellens vindu, har du funnet regningen din.
Råe ukestotaler vil villede deg, fordi en travel uke slår en rolig uke uansett hva du endrer. Del alltid på noe som står for arbeid: en fullført oppgave, en prompt, et API-kall.
Les videre
Et kontekstvindu er en tilbakevendende kostnad, tatt på hver tur, for alt du noensinne har lagt inn i det. Caching kutter satsen med omtrent nitti prosent og skjuler trenden. Løsningen er et mindre vindu som nullstilles med vilje.
For den målte versjonen, med fem uker med øktdata og den ene innstillingen som ga mesteparten av besparelsen, les følgeartikkelen om å kutte agenters tokenbruk med 17 % .
