


Krátká verze
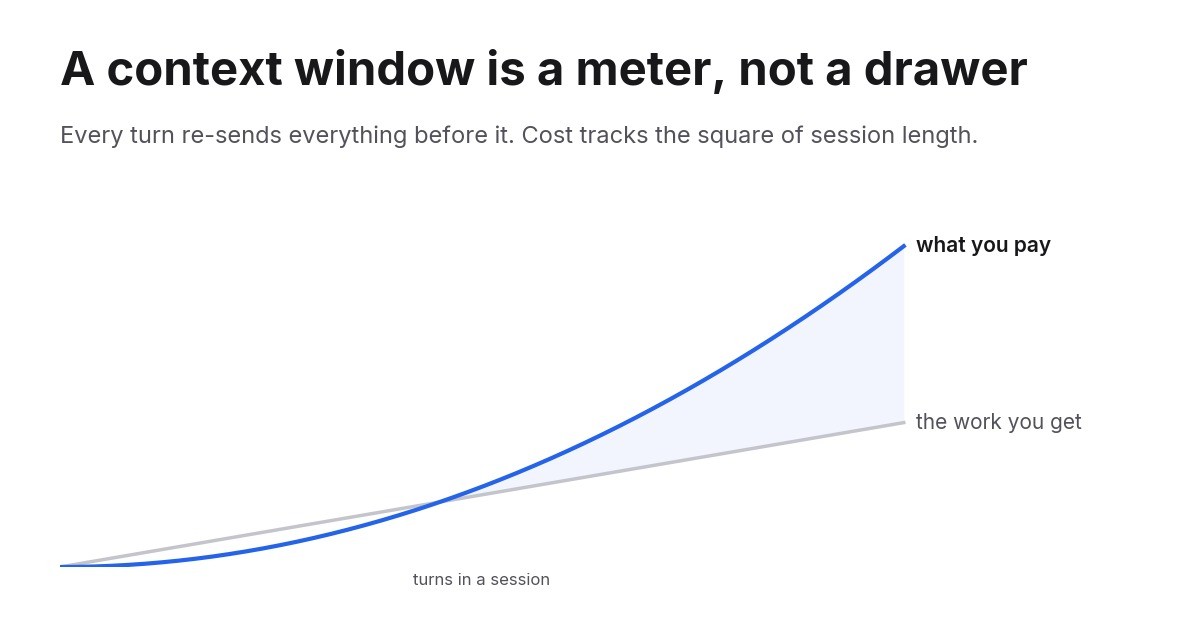
- Model nemá mezi požadavky žádnou paměť. Každý tah znovu posílá celou konverzaci, takže kontextové okno je náklad účtovaný při každém volání, ne místo, které jednou zaplníte.
- Proto náklady relace rostou s druhou mocninou její délky. Prompt caching snižuje sazbu na zhruba desetinu, ale nemění tvar křivky.
- Řešením je menší okno, které se záměrně resetuje: omezte jeho růst, čistěte častěji, vyjměte spotřebovaný výstup nástrojů a náročné čtení nechte v souborech a subagentech, odkud se už nikdy nevrací.
Okno je měřidlo, ne zásuvka
Většina lidí si kontextové okno představuje jako úložiště. Něco do něj dáte, model to vidí, větší okno pojme víc. Tato představa je v jednom konkrétním ohledu chybná a ta chyba je drahá.
Modely jsou bezstavové. Na druhé straně neexistuje žádná relace, která by podržela vaši konverzaci. Každý požadavek posílá celou historii znovu: systémový prompt, každou definici nástroje, každý soubor, který agent přečetl, každý výsledek nástroje, každou zprávu, kterou jste napsali vy nebo on. Model to všechno přečte, odpoví a zapomene. Vaše další zpráva posílá všechno znovu, plus tu novou část.
Okno tedy není zásuvka. Je to měřidlo a jeho údaj při každém tahu odpovídá velikosti všeho, co jste dosud nashromáždili.

Připraveni rozšířit své podnikání?
Začněte svou bezplatnou zkušební verzi ještě dnes a viďte výsledky během několika dní.
Aritmetika, kterou si předem nikdo neudělá
Vezměte relaci, která roste o zhruba 1 000 tokenů na tah a běží 300 tahů. Její kontext stoupá z téměř nuly na 300 000 tokenů, v průměru 150 000. Celkový odeslaný vstup: 300 krát 150 000, tedy 45 milionů tokenů, a to za 300 tahů práce.
Nyní nechte stejnou relaci růst třikrát rychleji, na 900 000. Průměr je 450 000, celkem 135 milionů, trojnásobný účet za přesně stejných 300 tahů.
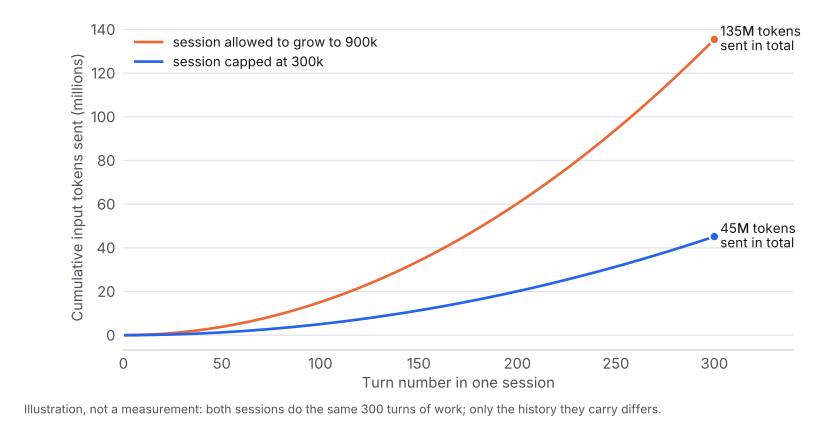
Takový je tvar problému. Náklady nesledují práci, kterou dostanete. Sledují druhou mocninu toho, jak dlouho necháte relaci běžet. Každý přidaný tah zdražuje každý budoucí tah, a proto může poslední hodina dlouhé relace stát víc než první čtyři.
V penězích, při ceníku Claude Opus 5 za 5 dolarů za milion vstupních tokenů a s tím, že vše po prvním tahu je obslouženo z cache za desetinu: omezená relace stojí asi 22 dolarů, neomezená asi 68 dolarů, a to za stejnou práci. U předplatného nevidíte dolary, vidíte, že týdenní limit dojde dřív.
Cache mění sazbu, ne křivku
Prompt caching je důvod, proč jsou dlouhé relace agentů vůbec proveditelné. Poskytovatel udržuje prefix vaší konverzace v teple a za zlomek ceny ho znovu přečte.
V API Anthropicu jsou násobitele 1,25x základní ceny vstupu za zápis do pětiminutové cache, 2x za hodinovou cache a asi 0,1x za čtení. Zápis do pětiminutové cache se zaplatí už při druhém požadavku. Každé seriózní prostředí pro agenty to dělá automaticky a funguje to: za pět týdnů mých vlastních relací bylo 98 % všech vstupních tokenů čtení z cache.
Podívejte se pozorně, co cache vyřešila a co ne. Vynásobila náklady na vaši historii zhruba desetinou. Nezastavila růst historie a nezastavila její opětovné čtení při každém tahu. Desetina z 900 000 tokenů je 90 000 tokenů účtovaného vstupu za otázku, kterou jste mohli položit ve dvaceti.
Cache je to, co dělá problém přežitelným. Je také to, co ho dělá neviditelným, protože číslo na vašem dashboardu spotřeby nikdy nevypadá tak alarmujícím dojmem jako počet tokenů, které skutečně protečou.
Přihlaste se k odběru newsletteru
Získejte nejnovější tipy, trendy a nabídky zdarma.
Co v něm vlastně je
Když je relace velká, lidé předpokládají, že je to konverzace. Obvykle ne. V pracovní relaci agenta leží váha na čtyřech místech.
Definice nástrojů. Každý nástroj, který agent může zavolat, nese název, popis a plné schéma parametrů, a to vše se načte dřív, než agent cokoli udělá. Připojte šest MCP serverů s 25 nástroji každý a v prvním tahu máte v okně 150 schémat, z nichž většina nebude nikdy zavolána.
Čtení souborů. Agent, který přečte zdrojový soubor o 2 000 řádcích, právě přidal zhruba 25 000 tokenů do každého budoucího tahu relace. Soubor potřeboval jednou. Nese ho navždy.
Výstup nástrojů. Hledání, které vrátí 200 výsledků, běh testů, který vypíše celý log, volání API, které vrátí celý dokument. Agent obvykle potřeboval jeden řádek. Zůstává to celé.
Samotná konverzace. Včetně částí, kde agent zkoumal slepou uličku, opravil se a šel dál. Tyto tokeny jsou stále v okně, stále se znovu čtou a stále formují další odpověď.
Poslední bod je důležitý i mimo náklady. Okno plné opuštěných pokusů a zastaralých obsahů souborů je zároveň oknem, ve kterém se relevantní detail hledá obtížněji. Kontext je současně rozpočtový i pozornostní problém.
Tři způsoby, jak ho zmenšit
Vyčištění. Začněte novou relaci. Vše, co jste si zapsali jinam, přežije; všechno ostatní je pryč. Je to nejhrubší nástroj a často ten správný. Udržovat jednu relaci živou celý den, protože „zná projekt", je návyk, který stojí nejvíc.
Úpravy kontextu. Odstraňte konkrétní materiál a zbytek ponechte slovo od slova, obvykle staré výsledky nástrojů, jakmile byly použity. API Anthropicu to přímo nabízí jako strategii správy kontextu. Je přesné a nezkresluje to, co zůstává, takže je první volbou, když je váhou objemný výstup nástrojů, a ne dlouhá konverzace.
Komprimace. Shrňte historii a pokračujte ze shrnutí. To je to, co většina programovacích agentů dělá automaticky, když se okno zaplní, a je to jediná možnost, která ohraničí růst relace, aniž by ji ukončila. Zahodí přitom hodně.
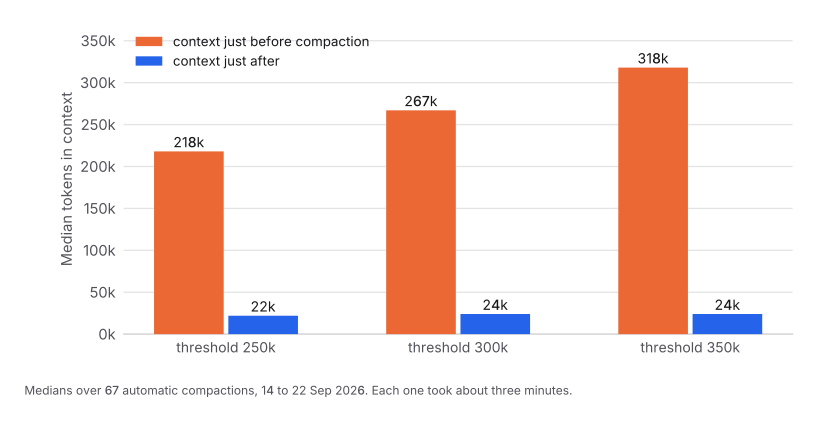
To jsou mediány ze 67 skutečných komprimací v mých vlastních relacích. Každá trvala asi tři minuty a poté agent znovu četl soubory, které už viděl, téměř dvakrát častěji než předtím, a znovu stavěl to, co shrnutí ztratilo. Ta výměna se vyplatí. Pořád je to výměna.
Čtvrtá možnost je lepší než všechny tři
Nedávejte to do okna vůbec.
Udržujte trvalý stav v souborech, které agent může na vyžádání znovu přečíst, místo v konverzaci. Práci náročnou na čtení posílejte subagentovi s vlastním krátce žijícím kontextem, aby se těch dvacet souborů, které přečte, nikdy nedotklo hlavní relace. Načítejte nástroje, když jsou potřeba, ne všechny dopředu.
Token, který nikdy není přidán, je token, který nikdy znovu nepřečtete. Všechno ostatní na této stránce je jen hašení škod u tokenů, které přidány byly.
Kde by měl ležet práh
Pokud váš agent komprimuje automaticky, má nějaký práh a výchozí hodnota se obvykle blíží plnému oknu modelu. To výchozí nastavení je to drahé, protože nechává vaši relaci strávit její nejproduktivnější hodiny s co největší historií.
Nastavit ho níž pomáhá, ale existuje spodní hranice. Komprimujte příliš horlivě a platíte tu tříminutovou čekací dobu a přepracování znovu a znovu. U modelu s kontextem 1M vynutil práh 250 000 komprimaci ve 36 % mých dlouhých relací; 350 000 spustilo komprimaci jen ve 12 % případů a přitom zachytilo téměř celou stejnou úsporu. Za pět týdnů relací byl výsledkem o 17 % méně tokenů vážených cache při stejném počtu promptů a zhruba poloviční náklady u dlouhých relací, kde se strop skutečně projevil. Kompletní data najdete v doprovodném článku .
Použitelné pravidlo: nastavte strop na zhruba třetinu okna svého modelu a odtud ho upravujte. Dost nízko, aby žádná relace netrávila hodiny u stropu, dost vysoko, aby běžná práce skončila, aniž by ji přerušilo shrnutí.
Změřte si to sami
Nic z toho nepotřebuje nové instrumentování. Každá odpověď API nese objekt usage se čtyřmi poli: input_tokens, cache_creation_input_tokens, cache_read_input_tokens a output_tokens. Většina prostředí pro agenty je už zapisuje do logu relace na disku.
Dvě čísla vám řeknou téměř všechno.
Vstup na volání vážený cache. Převážíte pole podle toho, co stojí: čerstvý vstup 1, zápisy do cache 1,25 nebo 2, čtení z cache 0,1. Pokud to týden po týdnu roste, zatímco vaše vytížení je stejné, vaše relace rostou a vy za to platíte.
Špičkový kontext na relaci. Největší jednotlivé volání v každé relaci. Pokud se špičky drží u okna vašeho modelu, našli jste svůj účet.
Nezpracované týdenní součty vás budou mást, protože rušný týden porazí klidný týden bez ohledu na to, co změníte. Vždy dělte něčím, co zastupuje práci: dokončeným úkolem, promptem, voláním API.
Čtěte dál
Kontextové okno je opakující se poplatek, účtovaný při každém tahu, za všechno, co jste do něj kdy vložili. Cache snižuje sazbu o zhruba devadesát procent a skrývá trend. Řešením je menší okno, které se záměrně resetuje.
Naměřenou verzi, s daty z pěti týdnů relací a tím jedním nastavením, které přineslo většinu úspory, najdete v doprovodném článku o snížení spotřeby tokenů agenta o 17 % .
