


La versión corta
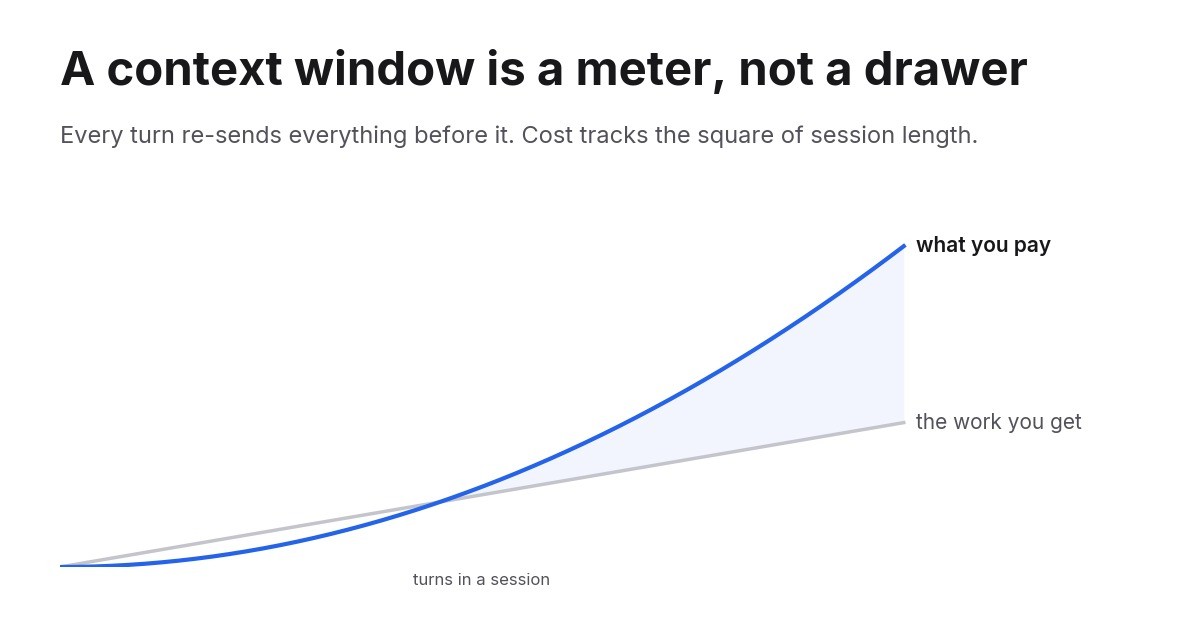
- Un modelo no tiene memoria entre solicitudes. Cada turno reenvía toda la conversación, así que la ventana de contexto es un coste que se cobra en cada llamada, no un lugar que llenas una sola vez.
- Eso hace que el coste de una sesión crezca con el cuadrado de su longitud. La caché de prompts reduce la tarifa a alrededor de una décima parte, pero no cambia la forma.
- La solución es una ventana más pequeña que se reinicie a propósito: limitar su crecimiento, vaciar más a menudo, editar la salida de herramientas ya gastada y mantener la lectura pesada en archivos y subagentes, donde nunca vuelve.
Una ventana es un contador, no un cajón
La mayoría de la gente imagina una ventana de contexto como un almacén. Metes cosas, el modelo las puede ver, una ventana más grande contiene más. Esa imagen es errónea de una forma concreta, y el error es caro.
Los modelos no tienen estado. No hay ninguna sesión al otro lado que guarde tu conversación. Cada solicitud envía todo el historial de nuevo: el prompt del sistema, cada definición de herramienta, cada archivo que leyó el agente, cada resultado de herramienta, cada mensaje que escribió cualquiera de los dos. El modelo lee todo eso, responde y olvida. Tu siguiente mensaje lo envía todo otra vez, más la parte nueva.
Así que la ventana no es un cajón. Es un contador, y su lectura en cada turno es el tamaño de todo lo que has acumulado hasta ese momento.

¿Listo para hacer crecer tu negocio?
Comienza tu prueba gratuita hoy y ve resultados en días.
La aritmética que nadie hace por adelantado
Toma una sesión que crece unos 1.000 tokens por turno y dura 300 turnos. Su contexto sube desde casi cero hasta 300.000 tokens, con una media de 150.000. Total de entrada enviada: 300 por 150.000, que son 45 millones de tokens, para obtener 300 turnos de trabajo.
Ahora deja que la misma sesión crezca tres veces más rápido, hasta 900.000. La media es 450.000, el total es 135 millones, tres veces la factura por exactamente los mismos 300 turnos.
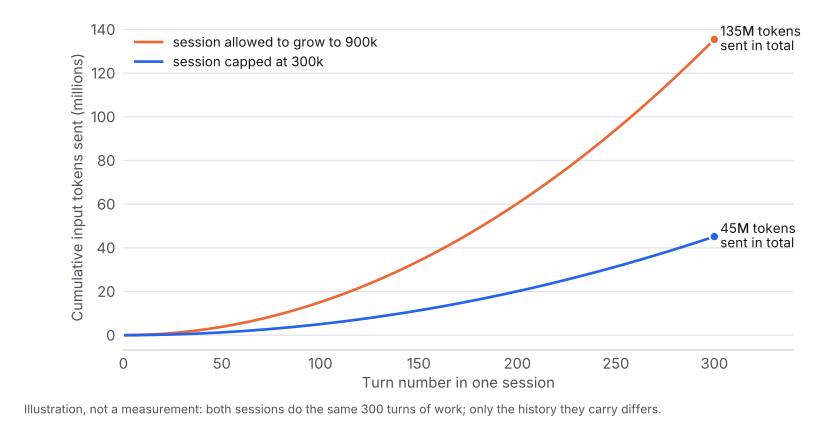
Esa es la forma del problema. El coste no sigue el trabajo que obtienes. Sigue cuánto tiempo dejas que se ejecute la sesión, al cuadrado. Cada turno que añades hace más caro cada turno futuro, y por eso la última hora de una sesión larga puede costar más que las cuatro primeras.
En dinero, al precio de tarifa de Claude Opus 5 de 5 $ por millón de tokens de entrada y con todo lo posterior al primer turno servido desde caché a una décima parte de eso: la sesión limitada cuesta unos 22 $ y la no limitada unos 68 $, por el mismo trabajo. Con una suscripción no ves dólares, ves que el límite semanal se agota antes.
La caché cambia la tarifa, no la curva
La caché de prompts es la razón por la que las sesiones largas de agentes son viables. El proveedor mantiene caliente el prefijo de tu conversación y cobra una fracción por releerlo.
En la API de Anthropic los multiplicadores son 1,25x el precio base de entrada para escribir en la caché de cinco minutos, 2x para la caché de una hora y alrededor de 0,1x para leer. Una escritura en caché de cinco minutos se amortiza en la segunda solicitud. Todo harness de agente serio hace esto automáticamente, y funciona: a lo largo de cinco semanas de mis propias sesiones, el 98% de todos los tokens de entrada fueron lecturas de caché.
Fíjate bien en lo que la caché arregló y lo que no. Multiplicó el coste de tu historial por aproximadamente una décima parte. No impidió que el historial creciera, ni impidió que lo releyeras en cada turno. Una décima parte de 900.000 tokens son 90.000 tokens de entrada facturada por una pregunta que podrías haber hecho en veinte.
La caché es lo que hace que el problema sea sobrellevable. También es lo que lo hace invisible, porque el número de tu panel de uso nunca parece tan alarmante como la cantidad de tokens que se están moviendo de verdad.
Únete a nuestro boletín
Obtén los últimos consejos, tendencias y ofertas gratis.
Qué hay realmente ahí dentro
Cuando una sesión se hace grande, la gente asume que es la conversación. Normalmente no lo es. En una sesión de agente en funcionamiento, el peso se reparte en cuatro sitios.
Definiciones de herramientas. Cada herramienta que el agente puede llamar lleva un nombre, una descripción y un esquema completo de parámetros, todo cargado antes de que el agente haga nada. Conecta seis servidores MCP con 25 herramientas cada uno y tendrás 150 esquemas en la ventana en el primer turno, la mayoría de los cuales nunca se llamarán.
Lecturas de archivos. Un agente que lee un archivo de código de 2.000 líneas acaba de añadir unos 25.000 tokens a cada turno futuro de la sesión. Necesitaba el archivo una vez. Lo lleva para siempre.
Salida de herramientas. Una búsqueda que devuelve 200 resultados, una ejecución de pruebas que imprime todo su log, una llamada a una API que devuelve un documento completo. El agente normalmente necesitaba una línea. Todo se queda.
La propia conversación. Incluidas las partes en las que el agente exploró un callejón sin salida, se corrigió y siguió adelante. Esos tokens siguen en la ventana, siguen releyéndose, siguen dando forma a la siguiente respuesta.
El último punto importa más allá del coste. Una ventana llena de intentos abandonados y contenidos de archivos obsoletos es también una ventana donde el detalle relevante es más difícil de encontrar. El contexto es un presupuesto y un problema de atención al mismo tiempo.
Tres formas de encogerla
Vaciar. Empieza una sesión nueva. Todo lo que anotaste en otro sitio sobrevive; todo lo demás desaparece. Es la herramienta más contundente y a menudo la correcta. Mantener una sesión viva todo el día porque “conoce el proyecto” es el hábito que más cuesta.
Edición de contexto. Elimina material concreto y conserva el resto palabra por palabra, normalmente resultados antiguos de herramientas una vez usados. La API de Anthropic expone esto directamente como estrategia de gestión de contexto. Es precisa y no distorsiona lo que queda, así que es lo primero a lo que recurrir cuando el peso es la salida voluminosa de herramientas y no una conversación larga.
Compactación. Resume el historial y continúa desde el resumen. Esto es lo que hacen automáticamente la mayoría de los agentes de programación cuando la ventana se llena, y es la única opción que acota el crecimiento de una sesión sin terminarla. Descarta muchísimo.
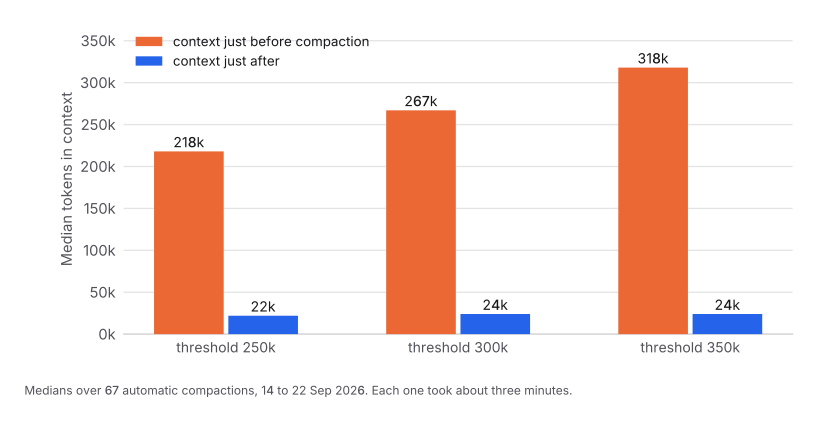
Esas son medianas de 67 compactaciones reales en mis propias sesiones. Cada una tardó unos tres minutos y, después, el agente releyó archivos que ya había visto a casi el doble de la tasa anterior, reconstruyendo lo que el resumen había perdido. El intercambio merece la pena. Sigue siendo un intercambio.
La cuarta opción es mejor que las tres
No lo metas en la ventana en primer lugar.
Mantén el estado duradero en archivos que el agente pueda releer bajo demanda, en lugar de en la conversación. Envía el trabajo de lectura pesada a un subagente con su propio contexto de vida corta, para que los veinte archivos que lee nunca toquen la sesión principal. Carga las herramientas cuando se necesiten en lugar de todas por adelantado.
Un token que nunca se añade es un token que nunca relees. Todo lo demás en esta página es control de daños para tokens que sí se añadieron.
Dónde debería estar el umbral
Si tu agente compacta automáticamente, tiene un umbral, y el valor por defecto suele estar cerca de la ventana completa del modelo. Ese valor por defecto es la configuración cara, porque deja que tu sesión pase sus horas más productivas cargando el mayor historial posible.
Ponerlo más bajo ayuda, pero hay un suelo. Compacta con demasiada avidez y pagas la espera de tres minutos y el retrabajo una y otra vez. En un modelo con 1M de contexto, un umbral de 250.000 forzó una compactación en el 36% de mis sesiones largas; 350.000 la provocó solo en el 12% y capturó casi todo el mismo ahorro. A lo largo de cinco semanas de sesiones, el resultado fue un 17% menos de tokens ponderados por caché para el mismo número de prompts, y aproximadamente la mitad del coste en las sesiones largas donde el límite realmente se activó. Los datos completos están en el artículo complementario .
Una regla práctica: fija el límite en aproximadamente un tercio de la ventana de tu modelo y ajusta desde ahí. Lo bastante bajo para que ninguna sesión pase horas cerca del techo, lo bastante alto para que el trabajo ordinario termine sin que lo interrumpa un resumen.
Mide lo tuyo
Nada de esto necesita instrumentación nueva. Cada respuesta de la API lleva un objeto usage con cuatro campos: input_tokens, cache_creation_input_tokens, cache_read_input_tokens y output_tokens. La mayoría de los harness de agentes ya escriben estos en un log de sesión en disco.
Dos números te dicen casi todo.
Entrada ponderada por caché por llamada. Pondera los campos por lo que cuestan: entrada nueva a 1, escrituras en caché a 1,25 o 2, lecturas de caché a 0,1. Si esto sube semana tras semana mientras tu carga de trabajo se mantiene plana, tus sesiones están creciendo y lo estás pagando.
Contexto máximo por sesión. La llamada individual más grande de cada sesión. Si los máximos se sitúan cerca de la ventana de tu modelo, has encontrado tu factura.
Los totales semanales en bruto te engañarán, porque una semana ajetreada supera a una tranquila hagas lo que hagas. Divide siempre por algo que represente trabajo: una tarea completada, un prompt, una llamada a la API.
Lee a continuación
Una ventana de contexto es un cargo recurrente, aplicado en cada turno, por todo lo que hayas metido en ella. La caché recorta la tarifa alrededor de un noventa por ciento y oculta la tendencia. La solución es una ventana más pequeña que se reinicie a propósito.
Para la versión medida, con cinco semanas de datos de sesiones y la única configuración que produjo la mayor parte del ahorro, lee el artículo complementario sobre reducir el uso de tokens de agentes un 17% .
