


La version courte
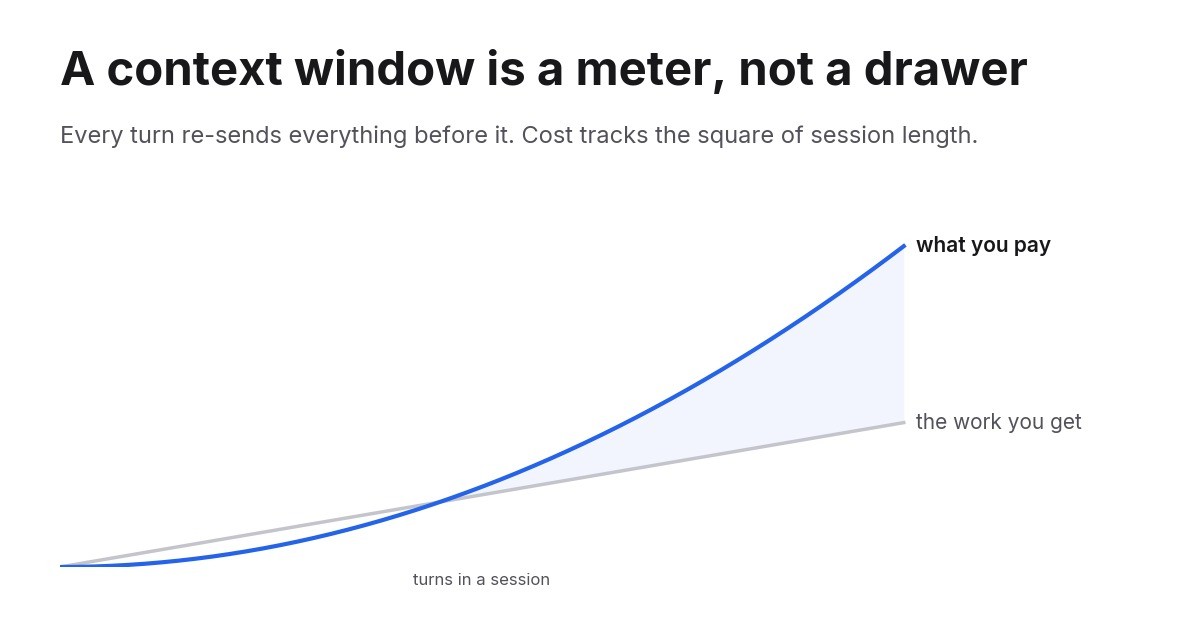
- Un modèle n’a aucune mémoire entre les requêtes. Chaque tour renvoie toute la conversation : la fenêtre de contexte est donc un coût facturé à chaque appel, et non un espace que l’on remplit une fois.
- Le coût d’une session croît ainsi avec le carré de sa longueur. La mise en cache des prompts ramène le tarif à environ un dixième, mais ne change pas la courbe.
- La solution est une fenêtre plus petite qui se réinitialise volontairement : plafonner sa croissance, vider plus souvent, supprimer les sorties d’outils déjà consommées, et garder les lectures lourdes dans des fichiers et des sous-agents, d’où elles ne reviennent jamais.
Une fenêtre est un compteur, pas un tiroir
La plupart des gens se représentent une fenêtre de contexte comme un espace de stockage. On y met des choses, le modèle les voit, une fenêtre plus grande en contient davantage. Cette représentation est fausse d’une manière bien précise, et l’erreur coûte cher.
Les modèles sont sans état. Il n’y a aucune session de l’autre côté qui conserve votre conversation. Chaque requête renvoie tout l’historique : le prompt système, chaque définition d’outil, chaque fichier lu par l’agent, chaque résultat d’outil, chaque message écrit par l’un ou l’autre. Le modèle lit tout cela, répond, puis oublie. Votre message suivant renvoie tout cela de nouveau, plus la partie nouvelle.
La fenêtre n’est donc pas un tiroir. C’est un compteur, et sa lecture à chaque tour correspond à la taille de tout ce que vous avez accumulé jusqu’ici.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
L’arithmétique que personne ne fait en amont
Prenez une session qui grandit d’environ 1 000 tokens par tour et qui dure 300 tours. Son contexte passe de presque zéro à 300 000 tokens, avec une moyenne de 150 000. Total d’entrée envoyé : 300 fois 150 000, soit 45 millions de tokens, pour obtenir 300 tours de travail.
Faites maintenant grandir la même session trois fois plus vite, jusqu’à 900 000. La moyenne est de 450 000, le total de 135 millions : trois fois la facture pour exactement les mêmes 300 tours.
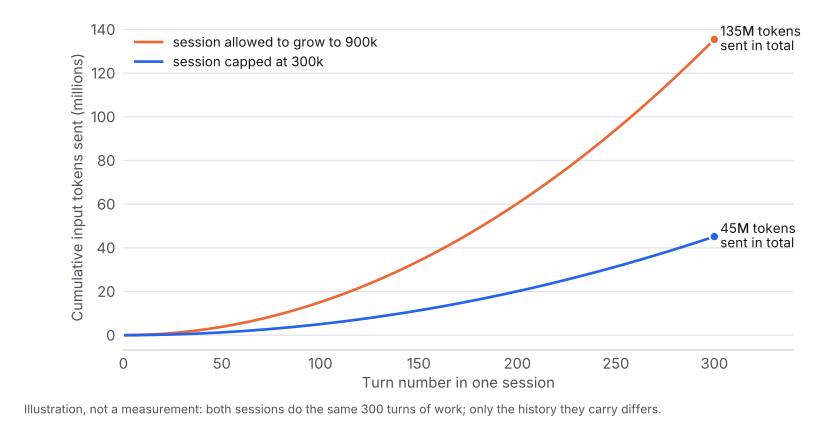
Voilà la forme du problème. Le coût ne suit pas le travail que vous obtenez. Il suit la durée pendant laquelle vous laissez la session tourner, au carré. Chaque tour que vous ajoutez rend tous les tours suivants plus chers, et c’est pourquoi la dernière heure d’une longue session peut coûter plus que les quatre premières.
En argent, au prix catalogue de Claude Opus 5, à 5 $ par million de tokens d’entrée, et avec tout ce qui suit le premier tour servi depuis le cache à un dixième de ce prix : la session plafonnée coûte environ 22 $, celle qui ne l’est pas environ 68 $, pour le même travail. Avec un abonnement, vous ne voyez pas de dollars, vous voyez la limite hebdomadaire s’épuiser plus tôt.
La mise en cache change le tarif, pas la courbe
La mise en cache des prompts est ce qui rend les longues sessions d’agents viables. Le fournisseur garde le préfixe de votre conversation au chaud et facture une fraction de prix pour le relire.
Sur l’API d’Anthropic, les multiplicateurs sont de 1,25x le prix d’entrée de base pour écrire dans le cache de cinq minutes, 2x pour le cache d’une heure, et environ 0,1x pour la lecture. Une écriture dans le cache de cinq minutes est rentabilisée dès la deuxième requête. Tout harnais d’agent sérieux fait cela automatiquement, et cela fonctionne : sur cinq semaines de mes propres sessions, 98 % de tous les tokens d’entrée étaient des lectures de cache.
Regardez attentivement ce que la mise en cache a corrigé et ce qu’elle n’a pas corrigé. Elle a multiplié le coût de votre historique par environ un dixième. Elle n’a pas empêché l’historique de grandir, et elle ne vous a pas empêché de le relire à chaque tour. Un dixième de 900 000 tokens, c’est 90 000 tokens d’entrée facturés pour une question que vous auriez pu poser en vingt.
La mise en cache est ce qui rend le problème survivable. C’est aussi ce qui le rend invisible, car le chiffre affiché sur votre tableau de bord d’usage n’a jamais l’air aussi alarmant que le nombre de tokens réellement en circulation.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Ce qu’il y a réellement dedans
Quand une session devient volumineuse, les gens supposent que c’est la conversation. En général, ce n’est pas le cas. Dans une session d’agent en activité, le poids se répartit en quatre endroits.
Les définitions d’outils. Chaque outil que l’agent peut appeler porte un nom, une description et un schéma de paramètres complet, tous chargés avant que l’agent ne fasse quoi que ce soit. Connectez six serveurs MCP avec 25 outils chacun et vous avez 150 schémas dans la fenêtre dès le premier tour, dont la plupart ne seront jamais appelés.
Les lectures de fichiers. Un agent qui lit un fichier source de 2 000 lignes vient d’ajouter environ 25 000 tokens à chaque tour futur de la session. Il avait besoin de ce fichier une fois. Il le transporte pour toujours.
Les sorties d’outils. Une recherche qui renvoie 200 résultats, une exécution de tests qui imprime tout son journal, un appel d’API qui renvoie un document entier. L’agent n’avait généralement besoin que d’une ligne. Tout le reste demeure.
La conversation elle-même. Y compris les passages où l’agent a exploré une impasse, s’est corrigé et est passé à autre chose. Ces tokens sont toujours dans la fenêtre, toujours relus, toujours en train de façonner la réponse suivante.
Le dernier point compte au-delà du coût. Une fenêtre remplie de tentatives abandonnées et de contenus de fichiers périmés est aussi une fenêtre où le détail pertinent est plus difficile à trouver. Le contexte est à la fois un budget et un problème d’attention.
Trois façons de la réduire
Le vidage. Démarrez une nouvelle session. Tout ce que vous avez consigné ailleurs survit ; tout le reste disparaît. C’est l’outil le plus brutal et souvent le bon. Garder une session en vie toute la journée parce qu’elle « connaît le projet » est l’habitude qui coûte le plus cher.
L’édition du contexte. Supprimez des éléments précis et conservez le reste mot pour mot, généralement d’anciens résultats d’outils une fois qu’ils ont été utilisés. L’API d’Anthropic l’expose directement comme stratégie de gestion du contexte. C’est précis et cela ne déforme pas ce qui reste : c’est donc la première chose à utiliser quand le poids vient de sorties d’outils volumineuses plutôt que d’une longue conversation.
La compaction. Résumez l’historique et repartez du résumé. C’est ce que font automatiquement la plupart des agents de codage quand la fenêtre se remplit, et c’est la seule option qui borne la croissance d’une session sans y mettre fin. Elle laisse beaucoup de choses de côté.
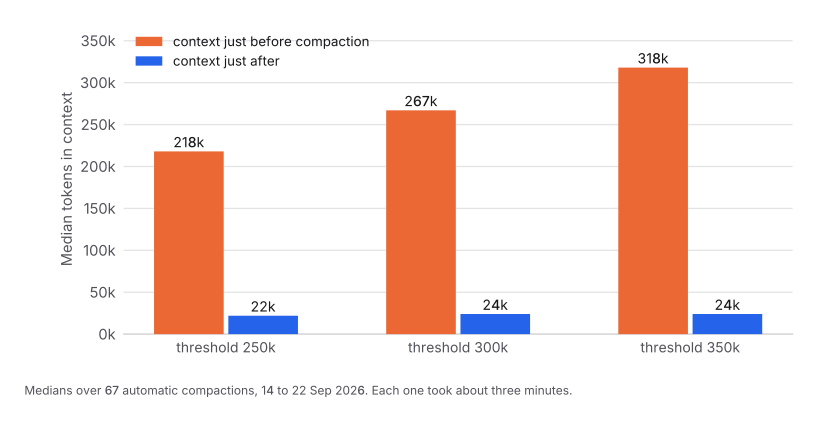
Ce sont des médianes calculées sur 67 compactions réelles dans mes propres sessions. Chacune a pris environ trois minutes, et ensuite l’agent relisait des fichiers déjà vus à près de deux fois le rythme précédent, reconstruisant ce que le résumé avait perdu. Le compromis en vaut la peine. Cela reste un compromis.
La quatrième option est meilleure que les trois autres
Ne la mettez pas dans la fenêtre, dès le départ.
Gardez l’état durable dans des fichiers que l’agent peut relire à la demande, plutôt que dans la conversation. Envoyez le travail à forte composante de lecture à un sous-agent doté de son propre contexte éphémère, pour que les vingt fichiers qu’il lit ne touchent jamais la session principale. Chargez les outils au moment où ils sont nécessaires plutôt que tous en amont.
Un token qui n’est jamais ajouté est un token que vous ne relirez jamais. Tout le reste sur cette page n’est que gestion des dégâts pour des tokens qui, eux, l’ont été.
Où placer le seuil
Si votre agent compacte automatiquement, il possède un seuil, et la valeur par défaut est généralement proche de la fenêtre complète du modèle. Ce réglage par défaut est le plus coûteux, car il laisse votre session passer ses heures les plus productives à transporter l’historique le plus volumineux possible.
Le fixer plus bas aide, mais il existe un plancher. Compactez trop tôt et vous payez l’attente de trois minutes et le travail refait, encore et encore. Sur un modèle à contexte de 1 M, un seuil de 250 000 a forcé une compaction dans 36 % de mes longues sessions ; 350 000 n’en déclenchait une que dans 12 % des cas tout en capturant presque toute la même économie. Sur cinq semaines de sessions, le résultat a été 17 % de tokens pondérés par le cache en moins pour le même nombre de prompts, et environ la moitié du coût dans les longues sessions où le plafond mordait réellement. Les données complètes sont dans l’article compagnon .
Une règle applicable : fixez le plafond à environ un tiers de la fenêtre de votre modèle, puis ajustez à partir de là. Assez bas pour qu’aucune session ne passe des heures près du plafond, assez haut pour que le travail ordinaire se termine sans être interrompu par un résumé.
Mesurez les vôtres
Rien de tout cela ne nécessite une nouvelle instrumentation. Chaque réponse d’API porte un objet usage avec quatre champs : input_tokens, cache_creation_input_tokens, cache_read_input_tokens et output_tokens. La plupart des harnais d’agents les écrivent déjà dans un journal de session sur le disque.
Deux chiffres vous disent presque tout.
L’entrée pondérée par le cache par appel. Pondérez les champs par ce qu’ils coûtent : entrée fraîche à 1, écritures de cache à 1,25 ou 2, lectures de cache à 0,1. Si ce chiffre grimpe semaine après semaine alors que votre charge de travail reste stable, vos sessions grandissent et vous le payez.
Le contexte maximal par session. Le plus gros appel unique de chaque session. Si les pics se situent près de la fenêtre de votre modèle, vous avez trouvé votre facture.
Les totaux hebdomadaires bruts vous induiront en erreur, car une semaine chargée bat une semaine calme quoi que vous changiez. Divisez toujours par quelque chose qui représente du travail : une tâche terminée, un prompt, un appel d’API.
À lire ensuite
Une fenêtre de contexte est une charge récurrente, prélevée à chaque tour, pour tout ce que vous y avez jamais mis. La mise en cache réduit le tarif d’environ quatre-vingt-dix pour cent et masque la tendance. La solution est une fenêtre plus petite qui se réinitialise volontairement.
Pour la version mesurée, avec cinq semaines de données de sessions et l’unique réglage qui a produit l’essentiel de l’économie, lisez l’article compagnon sur la réduction de 17 % de la consommation de tokens des agents .
