


A Versão Curta
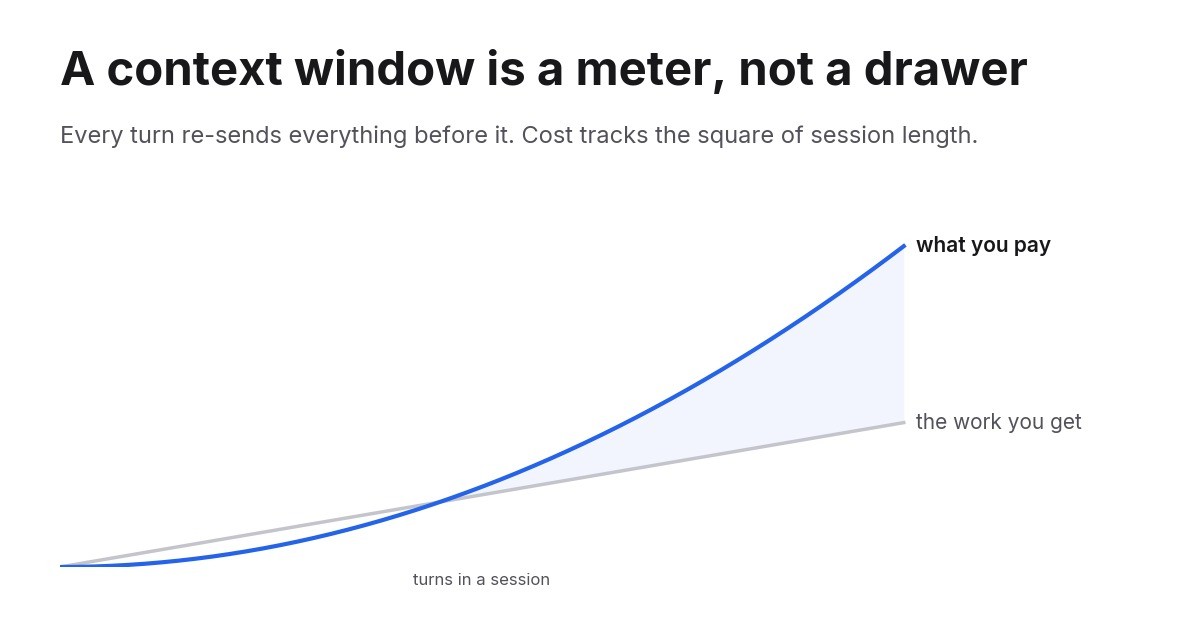
- Um modelo não tem memória entre requisições. Cada turno reenvia a conversa inteira, então a janela de contexto é um custo cobrado em cada chamada, não um lugar que você preenche uma vez.
- Isso faz o custo de uma sessão crescer com o quadrado do seu comprimento. O cache de prompt reduz a taxa para cerca de um décimo, mas não muda o formato.
- A solução é uma janela menor que se reinicia de propósito: limite o crescimento, limpe com mais frequência, edite fora a saída de ferramentas já consumida e mantenha a leitura pesada em arquivos e subagentes, onde ela nunca volta.
Uma Janela É um Medidor, Não uma Gaveta
A maioria das pessoas imagina uma janela de contexto como armazenamento. Você coloca coisas dentro, o modelo consegue vê-las, uma janela maior comporta mais. Essa imagem está errada em um ponto específico, e o erro é caro.
Modelos não têm estado. Não há uma sessão do outro lado guardando a sua conversa. Cada requisição envia o histórico inteiro de novo: o prompt de sistema, cada definição de ferramenta, cada arquivo que o agente leu, cada resultado de ferramenta, cada mensagem que qualquer um dos dois escreveu. O modelo lê tudo isso, responde e esquece. A sua próxima mensagem envia tudo isso novamente, mais a parte nova.
Então a janela não é uma gaveta. É um medidor, e a sua leitura em cada turno é o tamanho de tudo o que você acumulou até ali.

Pronto para expandir seu negócio?
Comece seu teste gratuito hoje e veja resultados em dias.
A Aritmética Que Ninguém Faz de Antemão
Considere uma sessão que cresce cerca de 1.000 tokens por turno e dura 300 turnos. Seu contexto sobe de perto de zero até 300.000 tokens, com média de 150.000. Total de entrada enviada: 300 vezes 150.000, o que dá 45 milhões de tokens, para obter 300 turnos de trabalho.
Agora deixe a mesma sessão crescer três vezes mais rápido, até 900.000. A média é 450.000, o total é 135 milhões, três vezes a fatura pelos exatos mesmos 300 turnos.
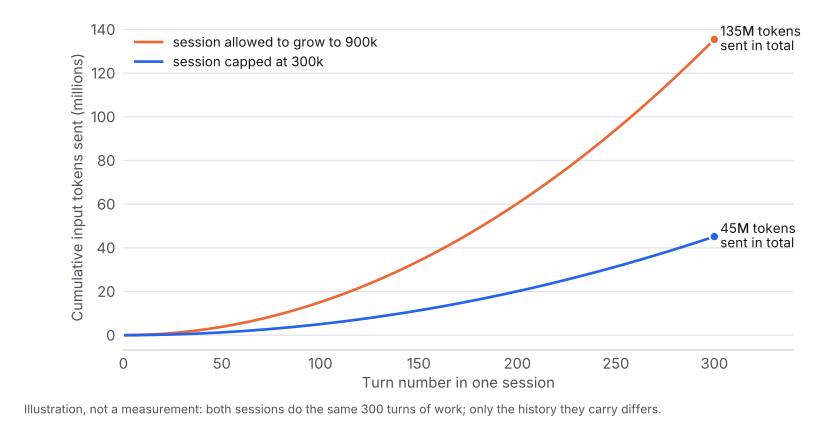
Esse é o formato do problema. O custo não acompanha o trabalho que você obtém. Ele acompanha há quanto tempo você deixa a sessão rodar, ao quadrado. Cada turno que você adiciona torna cada turno futuro mais caro, e é por isso que a última hora de uma sessão longa pode custar mais do que as quatro primeiras.
Em dinheiro, ao preço de tabela do Claude Opus 5, de US$ 5 por milhão de tokens de entrada, e com tudo depois do primeiro turno servido do cache a um décimo disso: a sessão limitada custa cerca de US$ 22, a sem limite cerca de US$ 68, pelo mesmo trabalho. Em uma assinatura você não vê dólares, você vê o limite semanal acabar mais cedo.
O Cache Muda a Taxa, Não a Curva
O cache de prompt é o motivo pelo qual sessões longas de agente são viáveis. O provedor mantém o prefixo da sua conversa aquecido e cobra uma fração para relê-lo.
Na API da Anthropic os multiplicadores são 1,25x o preço base de entrada para gravar no cache de cinco minutos, 2x para o cache de uma hora e cerca de 0,1x para ler. Uma gravação no cache de cinco minutos se paga já na segunda requisição. Todo harness de agente sério faz isso automaticamente, e funciona: ao longo de cinco semanas das minhas próprias sessões, 98% de todos os tokens de entrada foram leituras de cache.
Observe com atenção o que o cache resolveu e o que não resolveu. Ele multiplicou o custo do seu histórico por cerca de um décimo. Não impediu o histórico de crescer, e não impediu você de relê-lo em cada turno. Um décimo de 900.000 tokens são 90.000 tokens de entrada faturados por uma pergunta que você poderia ter feito em vinte.
O cache é o que torna o problema sobrevivível. É também o que o torna invisível, porque o número no seu painel de uso nunca parece tão alarmante quanto o número de tokens que de fato estão circulando.
Junte-se à nossa newsletter
Receba gratuitamente as últimas dicas, tendências e ofertas.
O Que Realmente Está Ali Dentro
Quando uma sessão fica grande, as pessoas presumem que é a conversa. Normalmente não é. Em uma sessão de agente em funcionamento, o peso está em quatro lugares.
Definições de ferramentas. Cada ferramenta que o agente pode chamar carrega um nome, uma descrição e um esquema completo de parâmetros, tudo carregado antes de o agente fazer qualquer coisa. Conecte seis servidores MCP com 25 ferramentas cada e você terá 150 esquemas na janela já no primeiro turno, a maioria dos quais nunca será chamada.
Leituras de arquivos. Um agente que lê um arquivo-fonte de 2.000 linhas acabou de adicionar cerca de 25.000 tokens a cada turno futuro da sessão. Ele precisou do arquivo uma vez. Ele o carrega para sempre.
Saída de ferramentas. Uma busca que retorna 200 resultados, uma execução de testes que imprime o log inteiro, uma chamada de API que retorna um documento completo. O agente normalmente precisava de uma linha disso. Tudo permanece.
A própria conversa. Incluindo as partes em que o agente explorou um beco sem saída, se corrigiu e seguiu adiante. Esses tokens ainda estão na janela, ainda sendo relidos, ainda moldando a próxima resposta.
O último ponto importa além do custo. Uma janela cheia de tentativas abandonadas e conteúdos de arquivos desatualizados é também uma janela em que o detalhe relevante é mais difícil de encontrar. Contexto é um orçamento e um problema de atenção ao mesmo tempo.
Três Formas de Encolhê-la
Limpeza. Inicie uma nova sessão. Tudo o que você anotou em outro lugar sobrevive; todo o resto se vai. Esta é a ferramenta mais brusca e muitas vezes a correta. Manter uma sessão viva o dia inteiro porque ela “conhece o projeto” é o hábito que mais custa.
Edição de contexto. Remova material específico e mantenha o resto palavra por palavra, geralmente resultados antigos de ferramentas depois de já terem sido usados. A API da Anthropic expõe isso diretamente como estratégia de gerenciamento de contexto. É precisa e não distorce o que permanece, então é a primeira coisa a usar quando o peso é a saída volumosa de ferramentas, e não uma conversa longa.
Compactação. Resuma o histórico e continue a partir do resumo. É o que a maioria dos agentes de codificação faz automaticamente quando a janela se enche, e é a única opção que limita o crescimento de uma sessão sem encerrá-la. Ela descarta muita coisa.
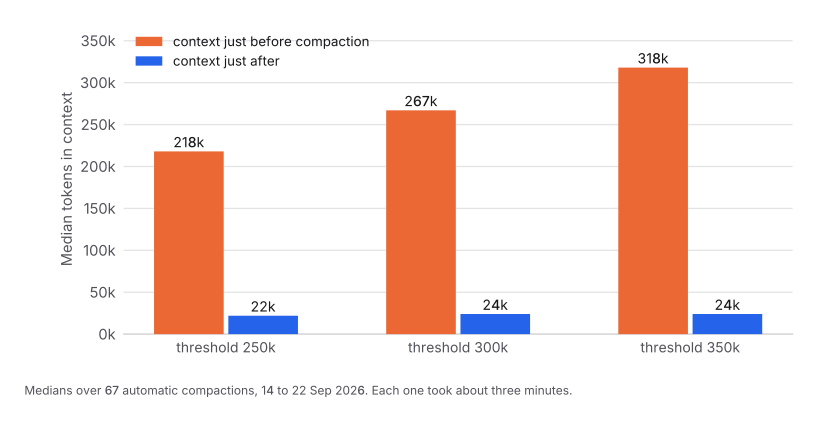
Essas são medianas de 67 compactações reais nas minhas próprias sessões. Cada uma levou cerca de três minutos e, depois, o agente releu arquivos que já tinha visto a quase o dobro da taxa anterior, reconstruindo o que o resumo perdeu. A troca vale a pena. Ainda assim, é uma troca.
A Quarta Opção É Melhor Que as Três
Não coloque na janela desde o início.
Mantenha o estado durável em arquivos que o agente pode reler sob demanda, em vez de na conversa. Envie o trabalho intensivo em leitura para um subagente com seu próprio contexto de curta duração, para que os vinte arquivos que ele lê nunca toquem a sessão principal. Carregue ferramentas quando forem necessárias, em vez de todas de antemão.
Um token que nunca é adicionado é um token que você nunca relê. Todo o resto nesta página é controle de danos para tokens que foram adicionados.
Onde o Limite Deve Ficar
Se o seu agente compacta automaticamente, ele tem um limite, e o padrão costuma ficar próximo da janela completa do modelo. Esse padrão é a configuração cara, porque deixa a sua sessão gastar as suas horas mais produtivas carregando o maior histórico possível.
Defini-lo mais baixo ajuda, mas existe um piso. Compacte com ansiedade excessiva e você paga a espera de três minutos e o retrabalho repetidas vezes. Em um modelo de contexto de 1M, um limite de 250.000 forçou uma compactação em 36% das minhas sessões longas; 350.000 disparou uma em apenas 12% e capturou quase toda a mesma economia. Ao longo de cinco semanas de sessões, o resultado foi 17% menos tokens ponderados por cache para o mesmo número de prompts, e cerca da metade do custo nas sessões longas em que o limite de fato teve efeito. Os dados completos estão no post companheiro .
Uma regra viável: defina o limite em cerca de um terço da janela do seu modelo e ajuste a partir daí. Baixo o suficiente para que nenhuma sessão passe horas perto do teto, alto o suficiente para que o trabalho comum termine sem ser interrompido por um resumo.
Meça os Seus Próprios
Nada disso precisa de instrumentação nova. Cada resposta da API carrega um objeto usage com quatro campos: input_tokens, cache_creation_input_tokens, cache_read_input_tokens e output_tokens. A maioria dos harnesses de agentes já grava isso em um log de sessão em disco.
Dois números lhe dizem quase tudo.
Entrada ponderada por cache por chamada. Pondere os campos pelo que custam: entrada nova a 1, gravações de cache a 1,25 ou 2, leituras de cache a 0,1. Se isso sobe semana após semana enquanto a sua carga de trabalho está estável, suas sessões estão crescendo e você está pagando por isso.
Contexto de pico por sessão. A maior chamada individual de cada sessão. Se os picos ficam perto da janela do seu modelo, você encontrou a sua fatura.
Totais semanais brutos vão enganar você, porque uma semana movimentada supera uma semana tranquila, não importa o que você mude. Sempre divida por algo que represente trabalho: uma tarefa concluída, um prompt, uma chamada de API.
Leia a Seguir
Uma janela de contexto é uma cobrança recorrente, feita em cada turno, por tudo o que você já colocou nela. O cache reduz a taxa em cerca de noventa por cento e esconde a tendência. A solução é uma janela menor que se reinicia de propósito.
Para a versão medida, com cinco semanas de dados de sessões e a única configuração que produziu a maior parte da economia, leia o artigo companheiro sobre reduzir o uso de tokens do agente em 17% .
