


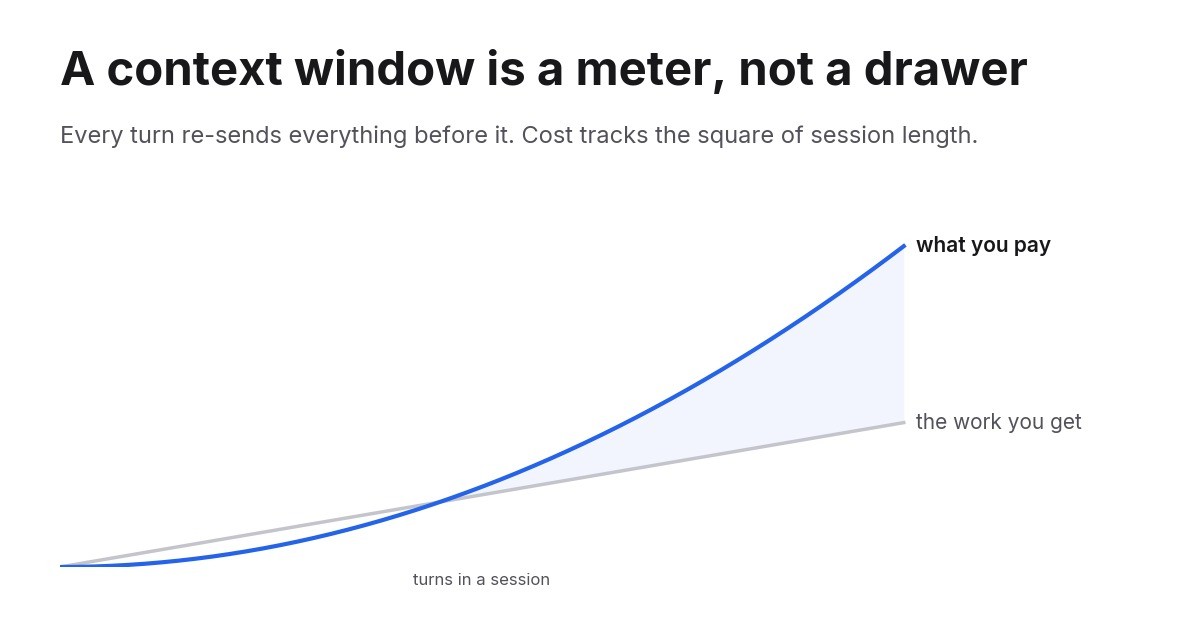
要点
- モデルはリクエスト間の記憶を持ちません。毎ターン、会話全体が再送されるため、コンテキストウィンドウは一度埋める場所ではなく、呼び出しごとに課金されるコストです。
- そのため、セッションのコストは長さの2乗で増えていきます。プロンプトキャッシュは単価を約10分の1に下げますが、この形は変わりません。
- 解決策は、意図的にリセットする小さめのウィンドウです。成長に上限を設け、より頻繁にクリアし、使い終わったツール出力は編集で取り除き、大量の読み込みは二度と戻ってこないファイルやサブエージェント側に置きます。
ウィンドウは引き出しではなくメーター
ほとんどの人はコンテキストウィンドウをストレージのように想像します。中に入れればモデルが見られるようになり、ウィンドウが大きいほど多くを保持できる、と。このイメージはある一点で間違っており、その誤解は高くつきます。
モデルはステートレスです。向こう側に会話を保持しているセッションはありません。リクエストのたびに履歴全体が再送されます。システムプロンプト、すべてのツール定義、エージェントが読んだすべてのファイル、すべてのツール結果、双方が書いたすべてのメッセージ。モデルはそのすべてを読み、答え、そして忘れます。次のメッセージでは、そのすべてが新しい部分とともに再び送られます。
つまり、ウィンドウは引き出しではありません。メーターであり、各ターンでの表示値は、それまでに蓄積したすべてのサイズです。
誰も事前に計算しない算数
1ターンあたり約1,000トークンずつ増え、300ターン続くセッションを考えてみましょう。コンテキストはほぼゼロから30万トークンまで上昇し、平均は15万トークンです。送信される入力の合計は300×15万、つまり4,500万トークンで、得られるのは300ターン分の作業です。
次に、同じセッションが3倍の速さで増え、90万トークンに達するとします。平均は45万、合計は1億3,500万トークンで、まったく同じ300ターンに対して3倍の請求になります。
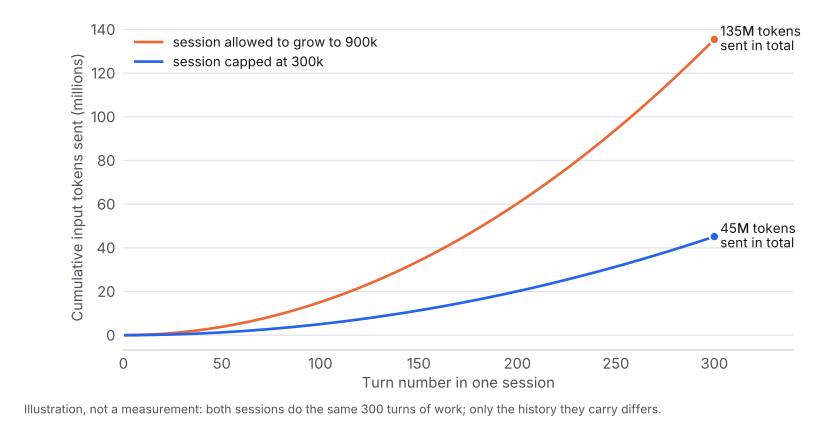
これが問題の形です。コストは得られる作業量には比例しません。セッションをどれだけ長く走らせたかの2乗に比例します。ターンを1つ加えるたびに、将来のすべてのターンが高くなります。だからこそ、長いセッションの最後の1時間は最初の4時間より高くつくことがあるのです。
金額に直すと、Claude Opus 5の定価が入力100万トークンあたり5ドル、最初のターン以降はすべてキャッシュから10分の1の価格で供給されるとすると、上限ありのセッションは約22ドル、上限なしは約68ドルで、作業内容は同じです。サブスクリプションではドルは見えず、週間上限がより早く尽きるのが見えるだけです。
キャッシュは単価を変えるが、曲線は変えない
長いエージェントセッションがそもそも成立するのはプロンプトキャッシュのおかげです。プロバイダーは会話のプレフィックスを温かい状態に保ち、読み直しにはごく一部の料金しか請求しません。
AnthropicのAPIでは、基本入力価格に対して5分キャッシュへの書き込みが1.25倍、1時間キャッシュが2倍、読み出しが約0.1倍です。5分キャッシュへの書き込みは2回目のリクエストで元が取れます。本格的なエージェントハーネスはどれもこれを自動で行い、実際に機能します。私自身の5週間のセッションでは、全入力トークンの98%がキャッシュ読み出しでした。
キャッシュが直したものと直していないものを注意深く見てください。履歴のコストをおよそ10分の1にしただけです。履歴が増えるのを止めたわけでも、毎ターン読み直すのを止めたわけでもありません。90万トークンの10分の1は9万トークンで、20トークンで済んだはずの質問に対して課金される入力です。
キャッシュはこの問題を生き延びられるものにします。同時に、それを不可視にします。使用状況ダッシュボードに表示される数字は、実際に動いているトークン数ほど深刻には見えないからです。

ニュースレターに登録
最新のヒント、トレンド、お得な情報を無料で入手。
実際に何が入っているのか
セッションが大きくなると、人はそれを会話のせいだと考えます。通常は違います。実際に動いているエージェントセッションでは、重みは4か所にあります。
ツール定義。 エージェントが呼び出せるすべてのツールは、名前、説明、完全なパラメータスキーマを伴い、エージェントが何かをする前にすべて読み込まれます。各25ツールを持つMCPサーバーを6つ接続すれば、1ターン目から150のスキーマがウィンドウに入り、そのほとんどは決して呼び出されません。
ファイル読み込み。 2,000行のソースファイルを読んだエージェントは、そのセッションの今後のすべてのターンに約25,000トークンを追加したことになります。ファイルが必要だったのは一度だけなのに、永遠に持ち歩くのです。
ツール出力。 200件の結果を返す検索、ログ全体を出力するテスト実行、完全なドキュメントを返すAPI呼び出し。エージェントが必要としていたのは通常そのうち1行です。それでも全部が残ります。
会話そのもの。 エージェントが行き止まりを探索し、自己修正して先に進んだ部分も含みます。それらのトークンは依然としてウィンドウ内にあり、読み直され、次の回答を形成し続けています。
最後の点はコスト以上に重要です。放棄された試行と古くなったファイル内容で満ちたウィンドウは、関連する詳細を見つけにくいウィンドウでもあります。コンテキストは予算の問題であり、同時に注意力の問題でもあります。
小さくする3つの方法
クリア。 新しいセッションを開始します。別の場所に書き出しておいたものはすべて残り、それ以外は失われます。最も乱暴な手段ですが、多くの場合それが正解です。「プロジェクトを分かっている」という理由で1つのセッションを一日中生かし続けるのが、最もコストのかかる習慣です。
コンテキスト編集。 特定の素材を削除し、残りは一言一句そのままにします。通常は、使い終わった古いツール結果が対象です。AnthropicのAPIはこれをコンテキスト管理戦略として直接公開しています。正確で、残ったものを歪めないため、重みの正体が長い会話ではなくかさばるツール出力である場合に最初に手を伸ばすべき手段です。
圧縮(コンパクション)。 履歴を要約し、その要約から続けます。ほとんどのコーディングエージェントがウィンドウいっぱいになると自動で行うもので、セッションを終わらせずに成長に上限を設ける唯一の選択肢です。多くのものを捨て去ります。
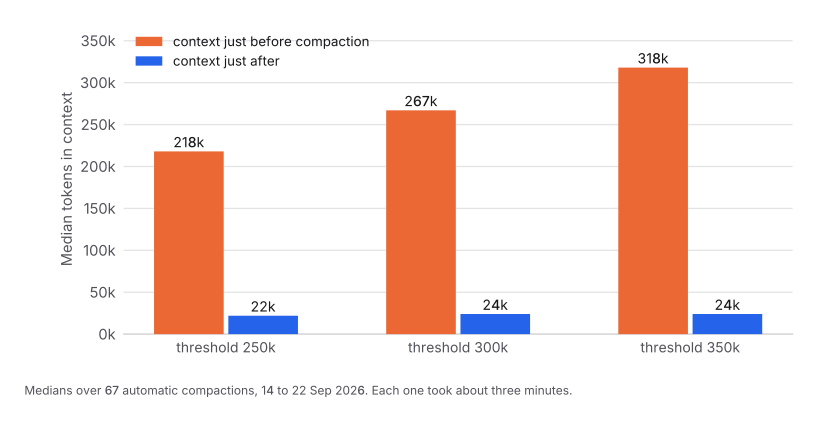
これは私自身のセッションにおける67回の実際の圧縮の中間値です。いずれも約3分かかり、その後エージェントは以前のほぼ2倍の頻度で既に見たファイルを読み直し、要約が失ったものを再構築しました。このトレードオフには価値があります。それでもトレードオフであることに変わりはありません。
4つ目の選択肢は他の3つより優れている
そもそもウィンドウに入れないことです。
永続的な状態は会話ではなく、エージェントが必要に応じて読み直せるファイルに置きます。読み込みの多い作業は、独自の短命なコンテキストを持つサブエージェントに送り、そこで読まれる20個のファイルがメインセッションに一切触れないようにします。ツールは最初にすべてではなく、必要になったときに読み込みます。
決して追加されなかったトークンは、決して読み直されないトークンです。このページの他のすべては、追加されてしまったトークンの被害を抑える策にすぎません。
しきい値はどこに置くべきか
エージェントが自動で圧縮するなら、しきい値があり、そのデフォルトは通常モデルのウィンドウいっぱいに近い値です。そのデフォルトは高くつく設定です。セッションが最も生産的な時間を、可能な限り最大の履歴を抱えて過ごすことを許してしまうからです。
低く設定すると効果がありますが、下限もあります。あまりに頻繁に圧縮すると、3分の待ち時間とやり直しを何度も支払うことになります。100万トークンのコンテキストモデルでは、25万のしきい値は私の長いセッションの36%で圧縮を強制しました。35万ではわずか12%で発動し、ほぼ同じ節約を確保できました。5週間のセッションを通じた結果は、同じプロンプト数でキャッシュ加重トークンが17%減少し、上限が実際に効いた長いセッションではコストがおよそ半分になりました。完全なデータはこちらの関連記事 にあります。
実用的なルール:上限をモデルのウィンドウのおよそ3分の1に設定し、そこから調整します。どのセッションも上限付近で何時間も過ごさない程度に低く、通常の作業が要約に中断されずに終わる程度に高く。
自分で計測する
これらに新しい計測の仕組みは必要ありません。すべてのAPIレスポンスには、input_tokens、cache_creation_input_tokens、cache_read_input_tokens、output_tokens という4つのフィールドを持つusageオブジェクトが含まれます。ほとんどのエージェントハーネスは、これらをすでにディスク上のセッションログに書き出しています。
2つの数値でほぼすべてが分かります。
呼び出しあたりのキャッシュ加重入力。 各フィールドをコストで重み付けします。新規入力は1、キャッシュ書き込みは1.25または2、キャッシュ読み出しは0.1。作業量が横ばいなのにこれが週ごとに増えていくなら、セッションが大きくなっており、その分を支払っています。
セッションごとのピークコンテキスト。 各セッションで最大の単一呼び出しです。ピークがモデルのウィンドウ付近にあるなら、それが請求の正体です。
週ごとの生の合計は誤解を招きます。何を変えても、忙しい週は静かな週を上回るからです。常に作業を表す何かで割ってください。完了したタスク、プロンプト、API呼び出しなどです。
次に読む
コンテキストウィンドウは、これまでに入れたすべてに対して毎ターン課される継続的な請求です。キャッシュは単価を約90%下げ、その傾向を覆い隠します。解決策は、意図的にリセットする小さめのウィンドウです。
計測に基づく詳細版、5週間のセッションデータと節約の大半を生んだ1つの設定については、エージェントのトークン使用量を17%削減した方法 の関連記事をお読みください。
