


Den korte version
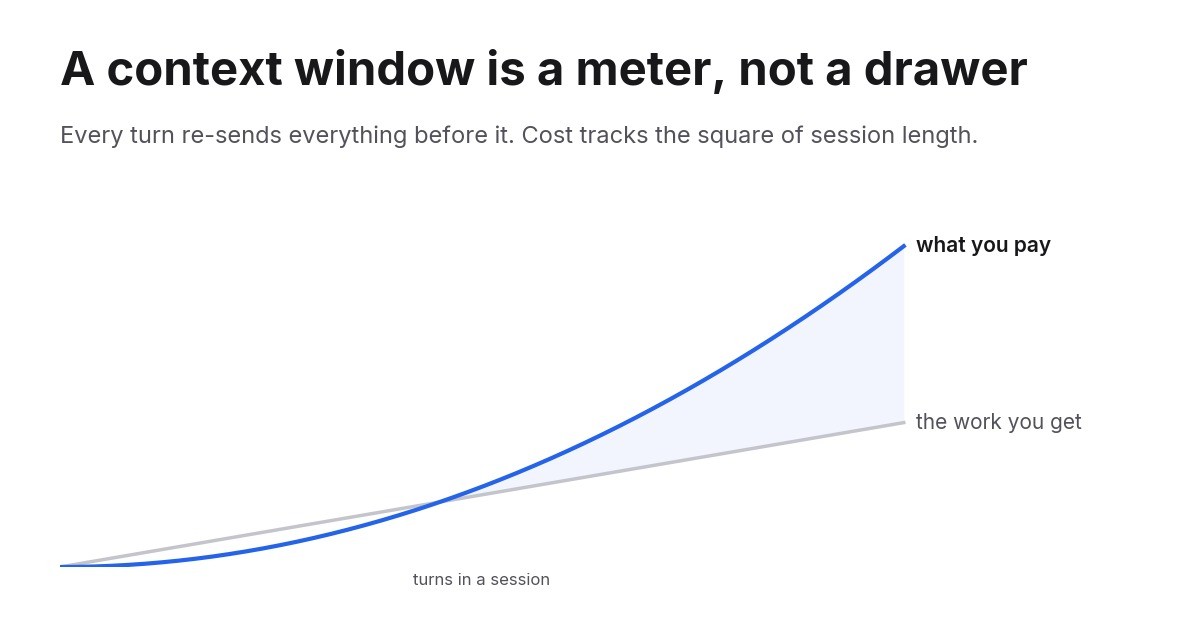
- En model har ingen hukommelse mellem forespørgsler. Hver tur gensender hele samtalen, så kontekstvinduet er en omkostning, der opkræves ved hvert kald, ikke et sted, du fylder én gang.
- Det gør omkostningen ved en session voksende med kvadratet på dens længde. Prompt caching skærer satsen ned til omkring en tiendedel, men ændrer ikke formen.
- Løsningen er et mindre vindue, der nulstilles med vilje: begræns dets vækst, ryd oftere, rediger brugte værktøjsoutput ud, og hold tung læsning i filer og subagenter, hvor den aldrig kommer tilbage.
Et vindue er en måler, ikke en skuffe
De fleste forestiller sig et kontekstvindue som lagerplads. Du lægger ting ind, modellen kan se dem, og et større vindue rummer mere. Det billede er forkert på ét bestemt punkt, og fejlen er dyr.
Modeller er tilstandsløse. Der er ingen session i den anden ende, der holder på din samtale. Hver forespørgsel sender hele historikken igen: systemprompten, hver værktøjsdefinition, hver fil agenten læste, hvert værktøjsresultat, hver besked en af jer skrev. Modellen læser det hele, svarer og glemmer. Din næste besked sender det hele igen, plus det nye.
Så vinduet er ikke en skuffe. Det er en måler, og dens visning ved hver tur er størrelsen på alt, hvad du hidtil har samlet.

Klar til at vokse din virksomhed?
Start din gratis prøveperiode i dag og se resultater inden for få dage.
Det regnestykke, ingen laver på forhånd
Tag en session, der vokser med omkring 1.000 tokens pr. tur og kører i 300 ture. Dens kontekst klatrer fra nær nul til 300.000 tokens med et gennemsnit på 150.000. Samlet input sendt: 300 gange 150.000, altså 45 millioner tokens, for at få 300 ture ud af arbejdet.
Lad nu den samme session vokse tre gange hurtigere, til 900.000. Gennemsnittet er 450.000, totalen er 135 millioner, tre gange regningen for præcis de samme 300 ture.
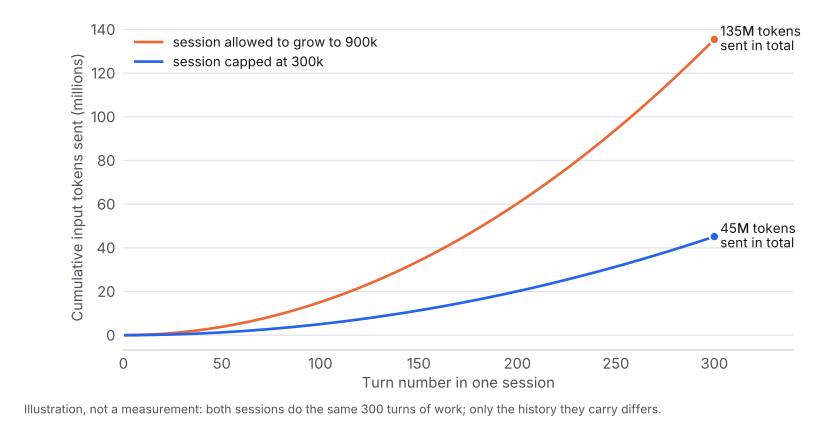
Det er problemets form. Omkostningen følger ikke det arbejde, du får udført. Den følger, hvor længe du lader sessionen køre, i anden potens. Hver tur, du tilføjer, gør hver fremtidig tur dyrere, og det er derfor, den sidste time af en lang session kan koste mere end de første fire.
I penge, ved Claude Opus 5’s listepris på 5 USD pr. million input-tokens og med alt efter den første tur leveret fra cache til en tiendedel af det: den begrænsede session koster omkring 22 USD, den ubegrænsede omkring 68 USD, for det samme arbejde. På et abonnement ser du ikke dollars, du ser ugens grænse slippe op tidligere.
Caching ændrer satsen, ikke kurven
Prompt caching er grunden til, at lange agentsessioner overhovedet er mulige. Udbyderen holder dit samtale-prefix varmt og opkræver en brøkdel for at genlæse det.
På Anthropics API er multiplikatorerne 1,25x basisprisen for input for at skrive til fem-minutters cachen, 2x for en-times cachen og omkring 0,1x for at læse. En skrivning til fem-minutters cachen betaler sig selv ved den anden forespørgsel. Enhver seriøs agent-harness gør dette automatisk, og det virker: på tværs af fem uger med mine egne sessioner var 98 % af alle input-tokens cache-læsninger.
Se nøje på, hvad caching løste, og hvad det ikke løste. Det gangede omkostningen ved din historik med cirka en tiendedel. Det standsede ikke historikken i at vokse, og det standsede dig ikke i at læse den igen ved hver tur. En tiendedel af 900.000 tokens er 90.000 tokens faktureret input for et spørgsmål, du kunne have stillet med blot tyve tokens.
Caching er det, der gør problemet overleveligt. Det er også det, der gør det usynligt, fordi tallet på dit forbrugsdashboard aldrig ser så alarmerende ud som antallet af tokens, der faktisk flyttes.
Tilmeld dig vores nyhedsbrev
Få de seneste tips, trends og tilbud gratis.
Hvad der faktisk er derinde
Når en session bliver stor, antager folk, at det er samtalen. Det er den normalt ikke. I en aktiv agentsession ligger vægten fire steder.
Værktøjsdefinitioner. Hvert værktøj, agenten kan kalde, bærer et navn, en beskrivelse og et fuldt parameterskema, alt indlæst før agenten gør noget som helst. Forbind seks MCP-servere med 25 værktøjer hver, og du har 150 skemaer i vinduet fra første tur, hvoraf de fleste aldrig bliver kaldt.
Fillæsninger. En agent, der læser en kildefil på 2.000 linjer, har netop tilføjet cirka 25.000 tokens til hver fremtidig tur i sessionen. Den havde brug for filen én gang. Den bærer den for evigt.
Værktøjsoutput. En søgning, der returnerer 200 resultater, en testkørsel, der printer hele sin log, et API-kald, der returnerer et fuldt dokument. Agenten havde normalt brug for én linje af det. Det hele bliver liggende.
Selve samtalen. Inklusive de dele, hvor agenten udforskede en blindgyde, rettede sig selv og gik videre. De tokens er stadig i vinduet, bliver stadig læst igen og former stadig det næste svar.
Det sidste punkt betyder noget ud over omkostningen. Et vindue fuldt af opgivne forsøg og forældet filindhold er også et vindue, hvor den relevante detalje er sværere at finde. Kontekst er på samme tid et budget og et opmærksomhedsproblem.
Tre måder at krympe det på
Rydning. Start en ny session.Alt, hvad du har skrevet ned andre steder, overlever; alt andet er væk. Det er det mest kontante værktøj og ofte det rigtige. At holde én session i live hele dagen, fordi den “kender projektet”, er den vane, der koster mest.
Kontekstredigering. Fjern specifikt materiale og behold resten ord for ord, typisk gamle værktøjsresultater, når de er blevet brugt. Anthropics API eksponerer dette direkte som en kontekststyringsstrategi. Det er præcist og forvrænger ikke det, der er tilbage, så det er det første, man griber efter, når vægten er omfangsrigt værktøjsoutput snarere end en lang samtale.
Komprimering. Opsummer historikken og fortsæt fra opsummeringen. Det er, hvad de fleste kodeagenter gør automatisk, når vinduet fyldes, og det er den eneste mulighed, der begrænser en sessions vækst uden at afslutte den. Den smider en hel del væk.
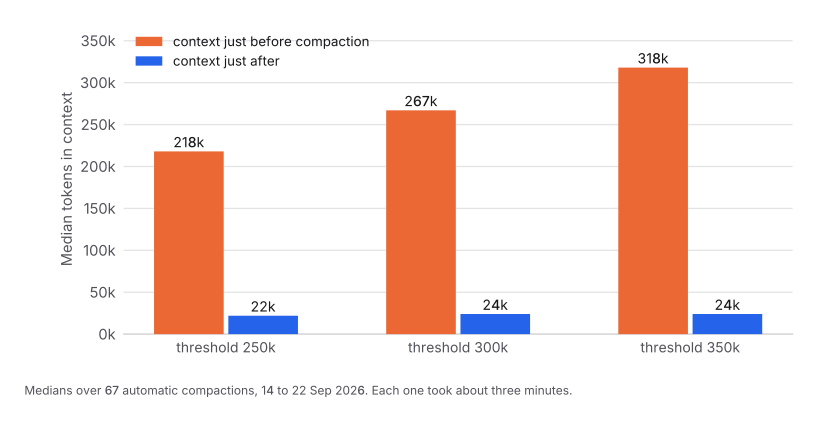
Det er medianer over 67 rigtige komprimeringer i mine egne sessioner. Hver tog omkring tre minutter, og bagefter genlæste agenten filer, den allerede havde set, med næsten dobbelt så høj hastighed som før og genopbyggede det, opsummeringen havde tabt. Bytten er det værd. Det er stadig en afvejning.
Den fjerde mulighed er bedre end alle tre
Lad være med at putte det i vinduet i første omgang.
Hold varig tilstand i filer, agenten kan genlæse efter behov, i stedet for i samtalen. Send læsetungt arbejde til en subagent med sit eget kortlivede kontekst, så de tyve filer, den læser, aldrig rører hovedsessionen. Indlæs værktøjer, når de er nødvendige, i stedet for alle på forhånd.
Et token, der aldrig bliver tilføjet, er et token, du aldrig genlæser. Alt andet på denne side er skadesbegrænsning for tokens, der blev tilføjet.
Hvor tærsklen bør ligge
Hvis din agent komprimerer automatisk, har den en tærskel, og standarden ligger normalt tæt på modellens fulde vindue. Den standard er den dyre indstilling, fordi den lader din session tilbringe sine mest produktive timer med at bære den størst mulige historik.
At sætte den lavere hjælper, men der er et gulv. Komprimer for ivrigt, og du betaler tre-minutters ventetiden og omarbejdet igen og igen. På en model med 1M kontekst tvang en tærskel på 250.000 en komprimering i 36 % af mine lange sessioner; 350.000 udløste kun én i 12 % og indfangede næsten hele den samme besparelse. Over fem ugers sessioner var resultatet 17 % færre cache-vægtede tokens for det samme antal prompts, og omkring halvdelen af omkostningen i de lange sessioner, hvor grænsen faktisk bed. De fulde data findes i den tilhørende artikel .
En brugbar tommelfingerregel: sæt grænsen til cirka en tredjedel af din models vindue, og juster derfra. Lavt nok til, at ingen session bruger timer nær loftet, højt nok til, at almindeligt arbejde bliver færdigt uden at blive afbrudt af en opsummering.
Mål dine egne
Intet af dette kræver ny instrumentering. Hvert API-svar bærer et usage-objekt med fire felter: input_tokens, cache_creation_input_tokens, cache_read_input_tokens og output_tokens. De fleste agent-harnesses skriver dem allerede til en sessionslog på disken.
To tal fortæller dig næsten alt.
Cache-vægtet input pr. kald. Vægt felterne efter, hvad de koster: frisk input til 1, cache-skrivninger til 1,25 eller 2, cache-læsninger til 0,1. Hvis dette stiger uge for uge, mens din arbejdsbyrde er uændret, vokser dine sessioner, og du betaler for det.
Spidskontekst pr. session. Det største enkeltkald i hver session. Hvis spidserne ligger nær din models vindue, har du fundet din regning.
Rå ugentlige totaler vil vildlede dig, fordi en travl uge slår en stille uge, uanset hvad du ændrer. Divider altid med noget, der står for arbejde: en fuldført opgave, en prompt, et API-kald.
Læs næste
Et kontekstvindue er en tilbagevendende udgift, opkrævet ved hver tur, for alt, hvad du nogensinde har lagt i det. Caching skærer satsen med omkring halvfems procent og skjuler tendensen. Løsningen er et mindre vindue, der nulstilles med vilje.
For den målte version, med fem ugers sessionsdata og den ene indstilling, der gav det meste af besparelsen, læs den tilhørende artikel om at skære agenters tokenforbrug med 17 % .
