


Den korta versionen
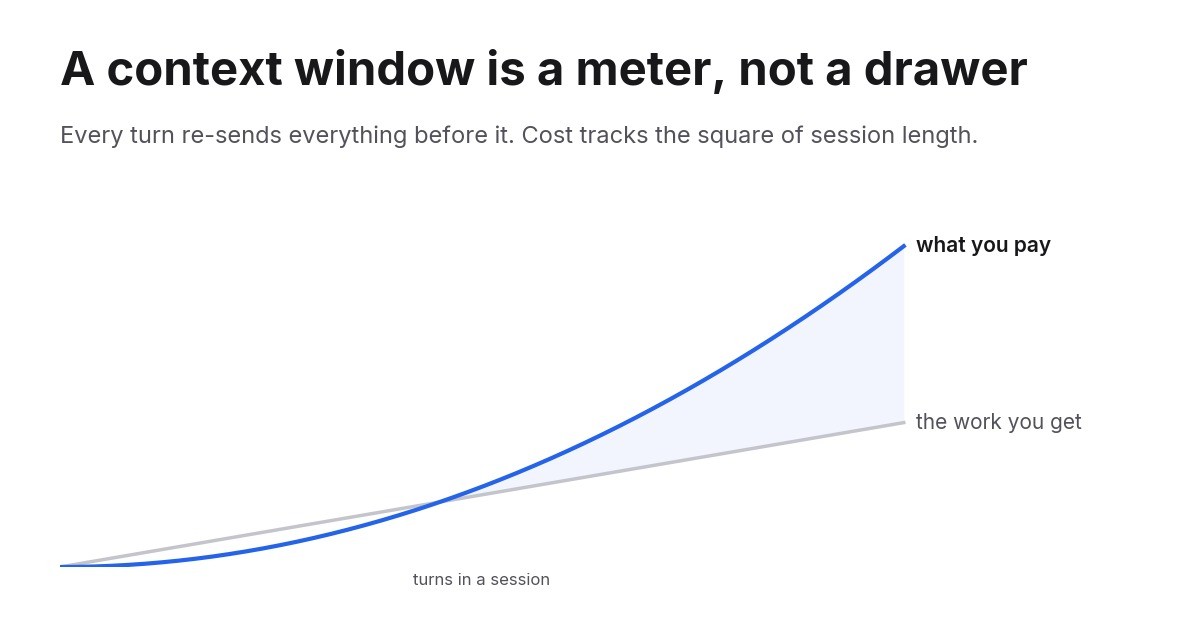
- En modell har inget minne mellan förfrågningar. Varje tur skickar hela konversationen igen, så kontextfönstret är en kostnad som debiteras vid varje anrop, inte en plats du fyller en gång.
- Det gör att kostnaden för en session växer med kvadraten på dess längd. Prompt-cachning sänker taxan till ungefär en tiondel men ändrar inte formen.
- Lösningen är ett mindre fönster som återställs med avsikt: begränsa dess tillväxt, rensa oftare, redigera bort förbrukad verktygsutdata och håll tung läsning i filer och subagenter där den aldrig kommer tillbaka.
Ett fönster är en mätare, inte en låda
De flesta föreställer sig ett kontextfönster som lagring. Du lägger in saker, modellen kan se dem, ett större fönster rymmer mer. Den bilden är fel på ett specifikt sätt, och misstaget är dyrt.
Modeller är tillståndslösa. Det finns ingen session i andra änden som håller din konversation. Varje förfrågan skickar hela historiken igen: systemprompten, varje verktygsdefinition, varje fil agenten läste, varje verktygsresultat, varje meddelande som någon av er skrev. Modellen läser allt, svarar och glömmer. Ditt nästa meddelande skickar allt igen, plus den nya delen.
Så fönstret är inte en låda. Det är en mätare, och dess avläsning vid varje tur är storleken på allt du har samlat på dig hittills.

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Matematiken som ingen gör i förväg
Ta en session som växer med ungefär 1 000 tokens per tur och kör i 300 turer. Dess kontext klättrar från nära noll till 300 000 tokens, i genomsnitt 150 000. Total indata som skickas: 300 gånger 150 000, vilket är 45 miljoner tokens, för att få 300 turer av arbete.
Låt nu samma session växa tre gånger snabbare, till 900 000. Genomsnittet är 450 000, totalen är 135 miljoner, tre gånger räkningen för exakt samma 300 turer.
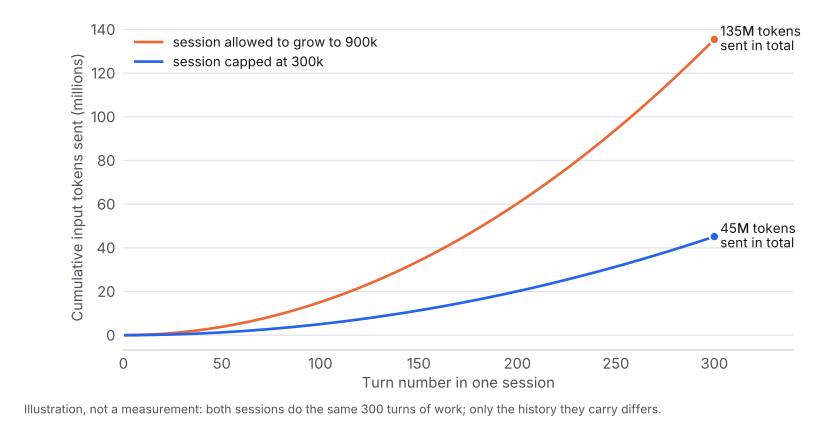
Det är problemets form. Kostnaden följer inte arbetet du får. Den följer hur länge du låter sessionen köra, i kvadrat. Varje tur du lägger till gör varje framtida tur dyrare, vilket är varför den sista timmen av en lång session kan kosta mer än de första fyra.
I pengar, till Claude Opus 5:s listpris på 5 dollar per miljon indatatokens och med allt efter den första turen serverat från cache till en tiondel av det: den begränsade sessionen kostar omkring 22 dollar, den obegränsade omkring 68 dollar, för samma arbete. På en prenumeration ser du inga dollar, du ser att veckogränsen tar slut tidigare.
Cachning ändrar taxan, inte kurvan
Prompt-cachning är anledningen till att långa agentsessioner är genomförbara överhuvudtaget. Leverantören håller ditt konversationsprefix varmt och tar en bråkdel för att läsa om det.
I Anthropics API är multiplikatorerna 1,25x basindatapriset för att skriva till femminuterscachen, 2x för en timmes cache, och omkring 0,1x för att läsa. En skrivning till femminuterscachen betalar sig själv vid den andra förfrågan. Varje seriöst agentramverk gör detta automatiskt, och det fungerar: över fem veckor av mina egna sessioner var 98% av alla indatatokens cacheläsningar.
Titta noga på vad cachningen löste och inte löste. Den multiplicerade kostnaden för din historik med ungefär en tiondel. Den stoppade inte historiken från att växa, och den stoppade inte dig från att läsa om den vid varje tur. En tiondel av 900 000 tokens är 90 000 tokens debiterad indata för en fråga du hade kunnat ställa med tjugo.
Cachning är det som gör problemet överlevbart. Det är också det som gör det osynligt, eftersom siffran på din användningsöversikt aldrig ser lika alarmerande ut som antalet tokens som faktiskt rör sig.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Vad som faktiskt finns där inne
När en session blir stor antar folk att det är konversationen. Oftast är det inte det. I en fungerande agentsession ligger tyngden på fyra ställen.
Verktygsdefinitioner. Varje verktyg agenten kan anropa bär ett namn, en beskrivning och ett fullständigt parameterschema, allt laddat innan agenten gör något. Anslut sex MCP-servrar med 25 verktyg vardera och du har 150 scheman i fönstret redan vid första turen, varav de flesta aldrig kommer att anropas.
Filläsningar. En agent som läser en källkodsfil på 2 000 rader har just lagt till ungefär 25 000 tokens till varje framtida tur i sessionen. Den behövde filen en gång. Den bär den för evigt.
Verktygsutdata. En sökning som returnerar 200 resultat, en testkörning som skriver ut hela sin logg, ett API-anrop som returnerar ett fullständigt dokument. Agenten behövde oftast en rad av det. Allt stannar kvar.
Själva konversationen. Inklusive de delar där agenten utforskade en återvändsgränd, rättade sig själv och gick vidare. De tokens finns fortfarande i fönstret, läses fortfarande om, formar fortfarande nästa svar.
Den sista punkten spelar roll bortom kostnaden. Ett fönster fullt av övergivna försök och inaktuellt filinnehåll är också ett fönster där den relevanta detaljen är svårare att hitta. Kontext är en budget och ett uppmärksamhetsproblem samtidigt.
Tre sätt att krympa det
Rensa. Starta en ny session. Allt du skrev ner någon annanstans överlever; allt annat är borta. Detta är det trubbigaste verktyget och ofta det rätta. Att hålla en session vid liv hela dagen för att den “känner till projektet” är vanan som kostar mest.
Kontextredigering. Ta bort specifikt material och behåll resten ordagrant, vanligtvis gamla verktygsresultat när de har använts. Anthropics API exponerar detta direkt som en kontexthanteringsstrategi. Det är precist och förvränger inte det som återstår, så det är det första att ta till när tyngden är skrymmande verktygsutdata snarare än en lång konversation.
Kompaktering. Sammanfatta historiken och fortsätt från sammanfattningen. Detta är vad de flesta kodningsagenter gör automatiskt när fönstret fylls, och det är det enda alternativet som begränsar en sessions tillväxt utan att avsluta den. Det tappar väldigt mycket.
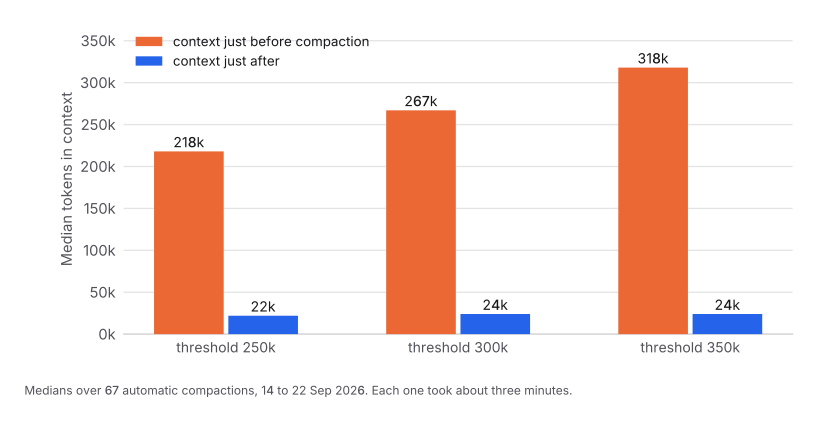
Det där är medianer över 67 verkliga kompakteringar i mina egna sessioner. Var och en tog ungefär tre minuter, och efteråt läste agenten om filer den redan hade sett i nästan dubbelt så hög takt som tidigare och byggde upp det som sammanfattningen tappade. Avvägningen är värd det. Det är fortfarande en avvägning.
Det fjärde alternativet är bättre än alla tre
Lägg det inte i fönstret från första början.
Håll varaktigt tillstånd i filer som agenten kan läsa om vid behov, i stället för i konversationen. Skicka läsintensivt arbete till en subagent med ett eget kortlivat kontextfönster, så att de tjugo filerna den läser aldrig rör huvudsessions kontext. Ladda verktyg när de behövs i stället för alla på en gång i förväg.
En token som aldrig läggs till är en token du aldrig läser om. Allt annat på den här sidan är skadebegränsning för tokens som blev tillagda.
Var tröskeln bör ligga
Om din agent kompakterar automatiskt har den en tröskel, och standardvärdet ligger oftast nära modellens fulla fönster. Det standardvärdet är den dyra inställningen, eftersom det låter din session tillbringa sina mest produktiva timmar med att bära den största möjliga historiken.
Att sätta den lägre hjälper, men det finns en golvgräns. Kompaktera för ivrigt och du betalar treminutersväntan och omarbetet om och om igen. På en modell med 1M-kontext tvingade en tröskel på 250 000 fram en kompaktering i 36% av mina långa sessioner; 350 000 utlöste en i bara 12% och fångade nästan hela samma besparing. Över fem veckor av sessioner blev resultatet 17% färre cacheviktade tokens för samma antal prompter, och ungefär halva kostnaden i de långa sessionerna där taket faktiskt bet. Den fullständiga datan finns i den kompletterande artikeln .
En användbar tumregel: sätt taket vid ungefär en tredjedel av din modells fönster och justera därifrån. Lågt nog att ingen session tillbringar timmar nära taket, högt nog att vanligt arbete blir klart utan att avbrytas av en sammanfattning.
Mät ditt eget
Inget av detta behöver ny instrumentering. Varje API-svar bär ett usage-objekt med fyra fält: input_tokens, cache_creation_input_tokens, cache_read_input_tokens och output_tokens. De flesta agentramverk skriver redan dessa till en sessionslogg på disk.
Två siffror berättar nästan allt.
Cacheviktad indata per anrop. Vikta fälten efter vad de kostar: färsk indata vid 1, cache-skrivningar vid 1,25 eller 2, cacheläsningar vid 0,1. Om detta klättrar vecka efter vecka medan din arbetsbelastning är oförändrad, växer dina sessioner och du betalar för det.
Toppkontext per session. Det största enskilda anropet i varje session. Om topparna ligger nära din modells fönster har du hittat din räkning.
Råa veckototaler vilseleder dig, eftersom en hektisk vecka slår en lugn vecka vad du än ändrar. Dividera alltid med något som står för arbete: en slutförd uppgift, en prompt, ett API-anrop.
Läs vidare
Ett kontextfönster är en återkommande kostnad, som tas ut vid varje tur, för allt du någonsin har lagt in i det. Cachning sänker taxan med ungefär nittio procent och döljer trenden. Lösningen är ett mindre fönster som återställs med avsikt.
För den uppmätta versionen, med fem veckor av sessionsdata och den enda inställning som gav större delen av besparingen, läs den kompletterande artikeln om att skära ner agenters tokenanvändning med 17% .
