


简短版
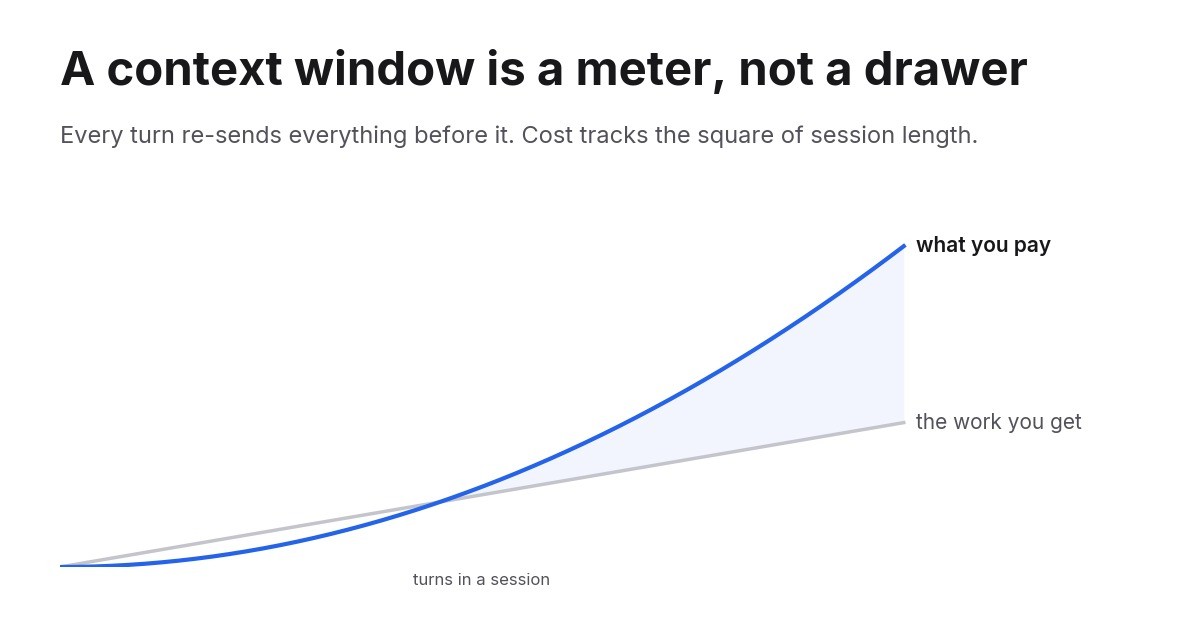
- 模型在两次请求之间没有记忆。每一轮都会重新发送整段对话,所以上下文窗口是每次调用都要计费的成本,而不是一个填一次就完事的地方。
- 这使一次会话的成本随其长度的平方增长。提示词缓存把单价降到约十分之一,但没有改变这条曲线的形状。
- 解法是刻意重置的小窗口:限制它的增长、更频繁地清空、把已经用掉的工具输出编辑掉,并把重量级的阅读工作放进文件和子 agent,让它永远不再回来。
窗口是计费表,不是抽屉
大多数人把上下文窗口想象成存储空间:你往里放东西,模型就能看到它们,窗口越大装得越多。这幅图景在一个具体的地方是错的,而这个错误代价高昂。
模型是无状态的。另一端并没有一个会话在替你保存对话。每一次请求都会重新发送整段历史:系统提示词、每一条工具定义、agent 读过的每个文件、每条工具结果、双方写下的每条消息。模型读完这一切,给出回答,然后忘掉。你的下一条消息又会把这一切再发一遍,再加上新增的部分。
所以窗口不是抽屉,而是计费表,它每一轮的读数就是到目前为止你累积的全部内容的大小。
没人提前算过的那笔账
假设一次会话每轮大约增长 1,000 个 token,运行 300 轮。它的上下文从接近零爬升到 300,000 个 token,平均 150,000。总共发送的输入量是 300 乘以 150,000,也就是 4500 万个 token,换来的是 300 轮工作。
现在让同一个会话以三倍速度增长,到 900,000。平均值是 450,000,总量是 1.35 亿,同样的 300 轮,账单变成三倍。
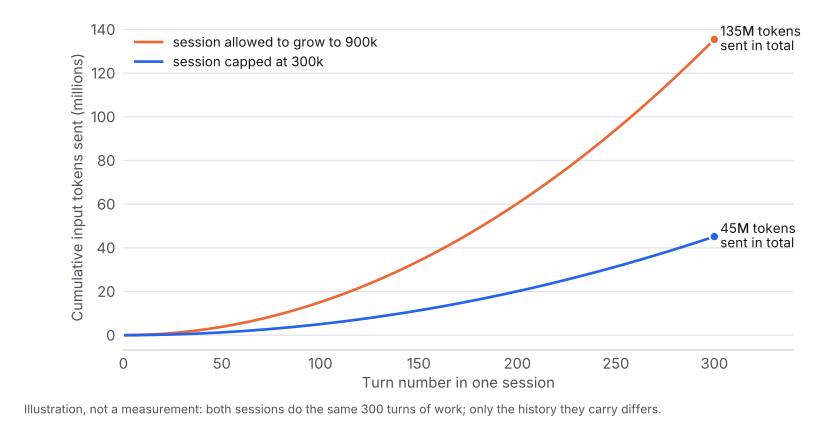
这就是问题的形状。成本并不跟随你得到的工作量,而是跟随你让会话运行的时间的平方。你每增加一轮,都会让之后每一轮更贵,这也是为什么一次漫长会话的最后一个小时可能比前四个小时更花钱。
换算成钱,按 Claude Opus 5 每百万输入 token 5 美元的标价,且第一轮之后的一切都以十分之一的价格从缓存读取:设了上限的会话大约花 22 美元,没设上限的大约花 68 美元,而完成的是同样的工作。用订阅制你看不到美元,你看到的是每周额度更早用完。
缓存改变的是单价,不是曲线
提示词缓存正是漫长 agent 会话还能成立的原因。服务商把你对话的前缀保持温热,重新读取只收很小一部分费用。
在 Anthropic 的 API 上,倍数是:写入五分钟缓存为基准输入价的 1.25 倍,一小时缓存为 2 倍,读取约为 0.1 倍。五分钟缓存在第二次请求时就已经回本。每一个认真的 agent 框架都会自动这么做,而且确实有效:在我自己连续五周的会话里,全部输入 token 的 98% 都是缓存读取。
仔细看缓存修好了什么、又没修好什么。它把你历史的成本大致乘了个十分之一。它没有阻止历史增长,也没有阻止你在每一轮重新读取它。900,000 个 token 的十分之一,就是 90,000 个计费输入 token,而你的问题本可以用二十个 token 问完。
缓存让这个问题得以存活,也让它变得不可见,因为你用量面板上的数字,从来不像实际在流动的 token 数量那样触目惊心。

加入我们的新闻通讯
免费获取最新提示、趋势和优惠。
里面到底装着什么
当一次会话变得很大时,人们会以为那是对话。通常并不是。在一个实际运行的 agent 会话里,重量落在四个地方。
工具定义。 agent 能调用的每个工具都带有一个名称、一段描述和一份完整的参数 schema,这些都在 agent 做任何事之前就加载好了。接上六个 MCP 服务器、每个 25 个工具,第一轮窗口里就有 150 份 schema,而其中大多数永远不会被调用。
文件读取。 agent 读了一个 2,000 行的源码文件,就等于给这次会话之后每一轮都加上了大约 25,000 个 token。它当时只需要这个文件一次,却会一直带着它。
工具输出。 一次返回 200 条结果的搜索、一次把整个日志都打印出来的测试运行、一次返回整份文档的 API 调用。agent 通常只需要其中一行,但全部都留了下来。
对话本身。 包括 agent 走进死胡同、自我纠正然后继续前进的那些部分。这些 token 仍然留在窗口里,仍然在被重新读取,仍然在塑造下一个回答。
最后一点的重要性超出成本之外。一个塞满废弃尝试和陈旧文件内容的窗口,也是一个相关细节更难被找到的窗口。上下文同时是预算问题和注意力问题。
缩小它的三种方法
清空。 开一个新的会话。你写在别处的所有东西都还在,其余的都消失了。这是最粗暴的工具,也往往是最正确的。因为会话"了解这个项目"就让它整天不关,是最费钱的习惯。
上下文编辑。 删掉特定材料,其余一字不改地保留,通常是那些已经用过的旧工具结果。Anthropic 的 API 直接把它作为一种上下文管理策略暴露出来。它精确,且不会扭曲保留下来的内容,所以当重量来自体积庞大的工具输出而非冗长的对话时,这是第一件该拿起的工具。
压缩。 把历史总结成摘要,再从摘要继续。这是大多数编程 agent 在窗口填满时自动做的事,也是唯一能在不结束会话的前提下限制其增长的办法。它会丢掉大量内容。
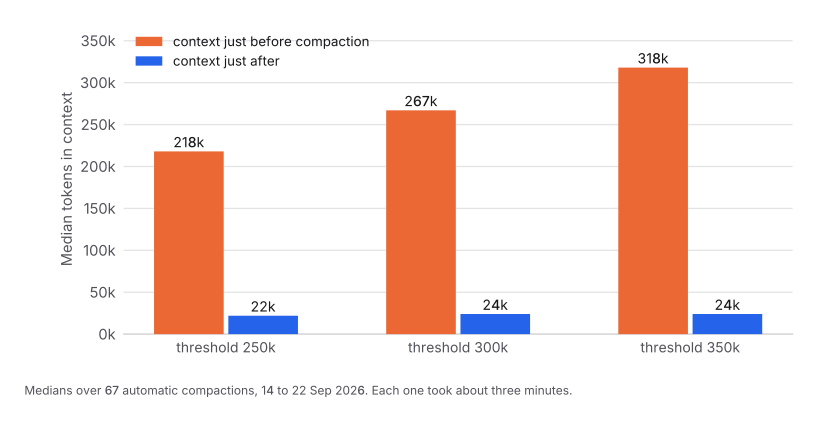
这些是我自己会话中 67 次真实压缩的中位数。每次大约耗时三分钟,之后 agent 会以接近此前两倍的速度重读它已经看过的文件,把摘要丢掉的东西重新建回来。这笔交易是值得的,但它仍然是一笔交易。
第四个选项比这三种都好
一开始就不要把它放进窗口。
把持久状态放在 agent 能按需重读的文件里,而不是放在对话里。把以阅读为主的工作交给拥有自己短生命周期上下文的子 agent,这样它读的二十个文件永远不会碰到主会话。工具要用到时再加载,而不是一次性全加载。
一个从未被加入的 token,就是一个你永远不会重读的 token。这一页上其余的一切,都只是在为那些已经被加入的 token 做损害控制。
阈值应该设在哪里
如果你的 agent 会自动压缩,它就有一个阈值,而默认值通常接近模型的完整窗口。这个默认值是昂贵的设置,因为它让会话把最有产出的那几个小时用来携带尽可能大的历史。
把它设低一些有帮助,但存在一个下限。压缩得太急,你会一次又一次地付出三分钟等待和返工的代价。在一个 1M 上下文的模型上,250,000 的阈值让我 36% 的长会话被迫触发压缩;350,000 只在 12% 的会话里触发,却拿到了几乎相同的节省。跨越五周的会话,结果是同样的提示词数量下缓存加权 token 少了 17%,而在上限真正起作用的那些长会话里成本大约减半。完整数据在这篇姊妹文章 里。
一条可用的规则:把上限设在模型窗口的三分之一左右,再据此调整。低到没有任何会话会在接近天花板的地方耗上几个小时,高到普通工作能在不被摘要打断的情况下完成。
测量你自己的用量
这一切都不需要新的埋点。每个 API 响应都带有一个 usage 对象,含四个字段:input_tokens、cache_creation_input_tokens、cache_read_input_tokens 和 output_tokens。大多数 agent 框架已经把它们写进磁盘上的会话日志。
两个数字几乎能告诉你一切。
每次调用的缓存加权输入量。 按成本给这些字段加权:新输入为 1,缓存写入为 1.25 或 2,缓存读取为 0.1。如果这个数字逐周上升而你的工作量没变,那说明你的会话在变大,而你在为此付钱。
每个会话的峰值上下文。 每个会话中最大的那一次调用。如果峰值贴近模型的窗口,你就找到你的账单了。
每周的原始总量会误导你,因为无论你改了什么,忙碌的一周总会比清闲的一周更高。永远要除以某个代表工作量的东西:一个完成的任务、一次提示词、一次 API 调用。
接着读
上下文窗口是一笔循环发生的费用,每一轮都要收取,为你曾经放进去的一切付费。缓存把单价降低了约九成,同时掩盖了趋势。解法是刻意重置的小窗口。
要看有实测数据的版本,包含五周的会话数据和那个产生了大部分节省的设置,请阅读姊妹篇:把 agent 的 token 用量削减 17% 。
