


W skrócie
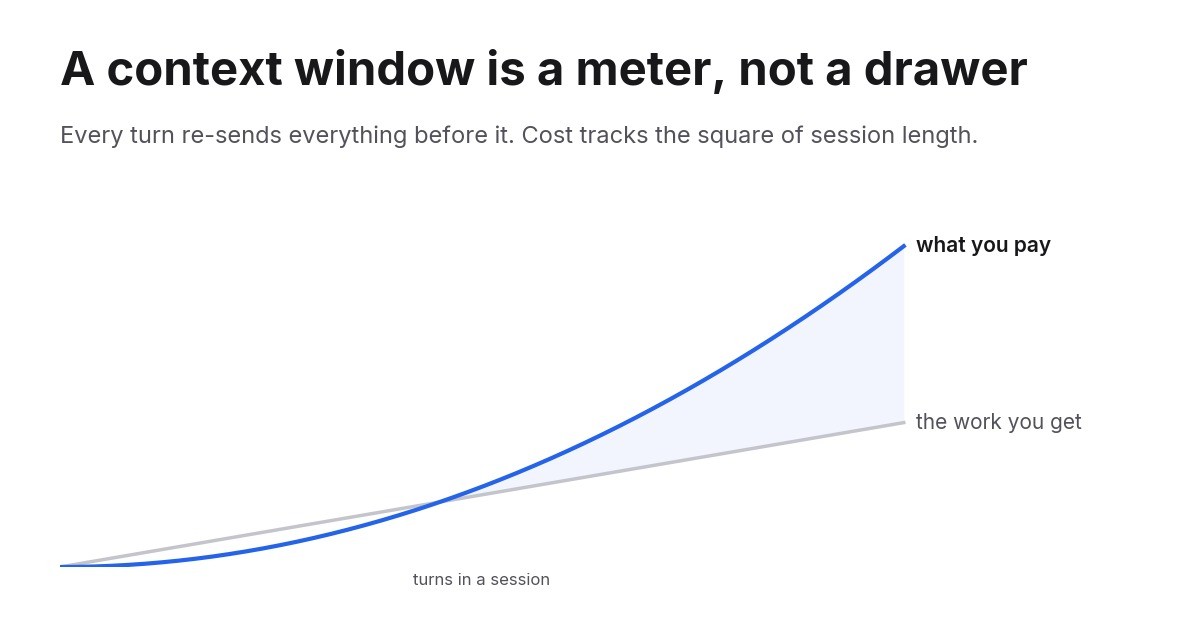
- Model nie ma pamięci między zapytaniami. Każda tura wysyła całą rozmowę od nowa, więc okno kontekstowe to koszt naliczany przy każdym wywołaniu, a nie miejsce, które zapełniasz raz.
- W efekcie koszt sesji rośnie z kwadratem jej długości. Prompt caching obniża stawkę do około jednej dziesiątej, ale nie zmienia kształtu krzywej.
- Rozwiązaniem jest mniejsze okno, które resetuje się celowo: ogranicz jego wzrost, czyść częściej, usuwaj zużyte wyniki narzędzi, a intensywne czytanie trzymaj w plikach i podagentach, skąd już nie wraca.
Okno to licznik, nie szuflada
Większość ludzi wyobraża sobie okno kontekstowe jako magazyn. Wkładasz do niego rzeczy, model je widzi, a większe okno mieści ich więcej. Ten obraz jest błędny w jednym konkretnym punkcie, a ten błąd jest kosztowny.
Modele są bezstanowe. Po drugiej stronie nie ma żadnej sesji, która przechowuje twoją rozmowę. Każde zapytanie wysyła całą historię jeszcze raz: prompt systemowy, każdą definicję narzędzia, każdy plik, który agent przeczytał, każdy wynik narzędzia, każdą wiadomość, którą napisał którekolwiek z was. Model czyta to wszystko, odpowiada i zapomina. Twoja następna wiadomość wysyła to wszystko ponownie, plus nową część.
Okno nie jest więc szufladą. Jest licznikiem, a jego wskazanie w każdej turze to rozmiar wszystkiego, co do tej pory nagromadziłeś.

Gotowy na rozwój swojej firmy?
Rozpocznij bezpłatny okres próbny już dziś i zobacz rezultaty w ciągu kilku dni.
Arytmetyka, której nikt nie robi z góry
Weź sesję, która rośnie o około 1000 tokenów na turę i trwa 300 tur. Jej kontekst wspina się z okolic zera do 300 000 tokenów, średnio 150 000. Łączne wysłane wejście: 300 razy 150 000, czyli 45 milionów tokenów, aby uzyskać 300 tur pracy.
Teraz pozwól tej samej sesji rosnąć trzy razy szybciej, do 900 000. Średnia wynosi 450 000, suma to 135 milionów — trzy razy większy rachunek za dokładnie te same 300 tur.
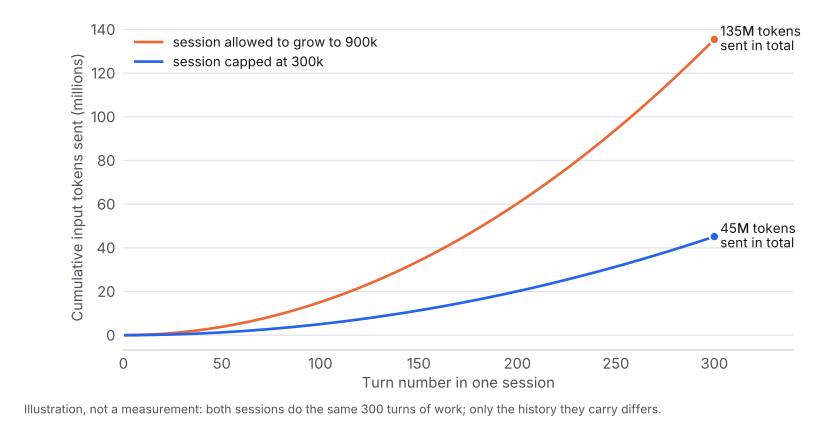
Taki jest kształt tego problemu. Koszt nie idzie w parze z pracą, którą otrzymujesz. Idzie w parze z tym, jak długo pozwalasz sesji działać — do kwadratu. Każda dodana tura czyni każdą przyszłą turę droższą, dlatego ostatnia godzina długiej sesji może kosztować więcej niż pierwsze cztery.
W przeliczeniu na pieniądze, przy cenniku Claude Opus 5 wynoszącym 5 dolarów za milion tokenów wejściowych i przy założeniu, że wszystko po pierwszej turze jest obsługiwane z cache za jedną dziesiątą tej ceny: sesja z limitem kosztuje około 22 dolarów, a sesja bez limitu około 68 dolarów — za tę samą pracę. Przy subskrypcji nie widzisz dolarów, widzisz tylko, że tygodniowy limit kończy się szybciej.
Caching zmienia stawkę, nie krzywą
Prompt caching to powód, dla którego długie sesje agentów są w ogóle wykonalne. Dostawca utrzymuje twój prefiks rozmowy w gotowości i pobiera ułamek ceny za jego ponowne odczytanie.
W API Anthropic mnożniki wynoszą 1,25x bazowej ceny wejścia za zapis do pięciominutowego cache, 2x za godzinny cache i około 0,1x za odczyt. Zapis do pięciominutowego cache zwraca się przy drugim zapytaniu. Każde poważne środowisko uruchamiające agenta robi to automatycznie i to działa: w ciągu pięciu tygodni moich własnych sesji 98% wszystkich tokenów wejściowych stanowiły odczyty z cache.
Przyjrzyj się uważnie temu, co caching naprawił, a czego nie. Pomnożył koszt twojej historii przez mniej więcej jedną dziesiątą. Nie powstrzymał jednak historii przed rośnięciem i nie powstrzymał cię przed jej ponownym odczytywaniem w każdej turze. Jedna dziesiąta z 900 000 tokenów to 90 000 tokenów rozliczonego wejścia za pytanie, które mogłeś zadać w dwudziestu.
Caching sprawia, że problem da się przetrwać. Sprawia też, że staje się niewidoczny, bo liczba na twoim dashboardzie zużycia nigdy nie wygląda tak alarmująco jak liczba tokenów, które faktycznie krążą.
Dołącz do naszego newslettera
Otrzymuj najnowsze wskazówki, trendy i oferty za darmo.
Co tak naprawdę się w nim znajduje
Gdy sesja staje się duża, ludzie zakładają, że to wina rozmowy. Zwykle tak nie jest. W działającej sesji agenta ciężar leży w czterech miejscach.
Definicje narzędzi. Każde narzędzie, które agent może wywołać, niesie nazwę, opis i pełny schemat parametrów — wszystko ładowane, zanim agent cokolwiek zrobi. Podłącz sześć serwerów MCP po 25 narzędzi każdy, a w pierwszej turze będziesz mieć w oknie 150 schematów, z których większość nigdy nie zostanie wywołana.
Odczyt plików. Agent czytający plik źródłowy o 2000 linii właśnie dodał około 25 000 tokenów do każdej przyszłej tury sesji. Plik był mu potrzebny raz. Niesie go już na zawsze.
Wynik działania narzędzia. Wyszukiwanie zwracające 200 wyników, przebieg testów drukujący cały swój log, wywołanie API zwracające pełny dokument. Agent potrzebował z tego zwykle jednej linii. Wszystko zostaje.
Sama rozmowa. W tym te fragmenty, w których agent badał ślepą uliczkę, poprawiał się i szedł dalej. Te tokeny wciąż są w oknie, wciąż są odczytywane ponownie i wciąż kształtują kolejną odpowiedź.
Ten ostatni punkt ma znaczenie wykraczające poza koszt. Okno pełne porzuconych prób i nieaktualnych treści plików to także okno, w którym trudniej znaleźć istotny szczegół. Kontekst jest jednocześnie budżetem i problemem uwagi.
Trzy sposoby, by go zmniejszyć
Czyszczenie. Zacznij nową sesję. Wszystko, co zapisałeś gdzie indziej, przetrwa; wszystko inne przepada. To najbardziej tępe narzędzie i często to właściwe. Utrzymywanie jednej sesji przy życiu przez cały dzień, bo „zna projekt", to nawyk, który kosztuje najwięcej.
Edycja kontekstu. Usuń konkretny materiał, a resztę zachowaj słowo w słowo — zwykle stare wyniki narzędzi, gdy zostały już wykorzystane. API Anthropic udostępnia to wprost jako strategię zarządzania kontekstem. Jest precyzyjna i nie zniekształca tego, co zostaje, więc sięgasz po nią w pierwszej kolejności, gdy ciężar stanowią obszerne wyniki narzędzi, a nie długa rozmowa.
Kompaktowanie. Streszcz historię i kontynuuj od streszczenia. To właśnie robi automatycznie większość agentów do kodowania, gdy okno się zapełni, i to jedyna opcja, która ogranicza wzrost sesji bez jej kończenia. Wyrzuca przy tym bardzo wiele.
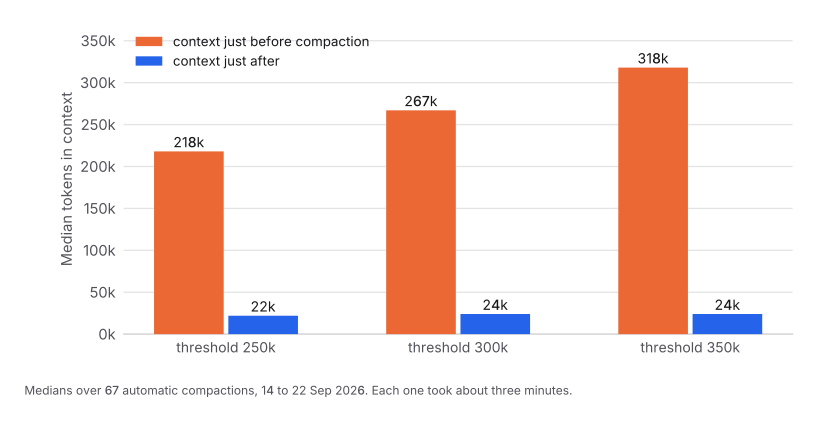
To mediany z 67 rzeczywistych kompaktowań w moich własnych sesjach. Każde trwało około trzech minut, a potem agent odczytywał pliki, które już widział, niemal dwa razy częściej niż wcześniej, odbudowując to, co zgubiło streszczenie. Ten kompromis się opłaca. To jednak wciąż kompromis.
Czwarta opcja jest lepsza od wszystkich trzech
Nie wkładaj tego do okna w ogóle.
Trwały stan trzymaj w plikach, które agent może odczytać na żądanie, a nie w rozmowie. Pracę opartą na czytaniu wysyłaj do podagenta z jego własnym, krótko żyjącym kontekstem, dzięki czemu dwadzieścia czytanych przez niego plików nigdy nie dotknie głównej sesji. Ładuj narzędzia wtedy, gdy są potrzebne, a nie wszystkie z góry.
Token, który nigdy nie został dodany, to token, którego nigdy nie odczytasz ponownie. Wszystko inne na tej stronie to ograniczanie szkód wyrządzonych przez tokeny, które zostały dodane.
Gdzie powinien leżeć próg
Jeśli twój agent kompaktuje automatycznie, ma próg, a domyślna wartość zwykle jest bliska pełnemu oknu modelu. Ten domyślny próg to ustawienie drogie, bo pozwala twojej sesji spędzić najbardziej produktywne godziny na niesieniu największej możliwej historii.
Ustawienie go niżej pomaga, ale istnieje dolna granica. Kompaktuj zbyt ochoczo, a będziesz raz za razem płacić trzyminutowym oczekiwaniem i powtórną pracą. W modelu z kontekstem 1M próg 250 000 wymuszał kompaktowanie w 36% moich długich sesji; 350 000 wywoływało je tylko w 12% przypadków i pozwalało zachować niemal całą tę samą oszczędność. W ciągu pięciu tygodni sesji dało to 17% mniej tokenów ważonych cache przy tej samej liczbie zapytań i około połowę kosztu w długich sesjach, w których limit faktycznie zadziałał. Pełne dane znajdziesz w tekście towarzyszącym .
Praktyczna zasada: ustaw limit na mniej więcej jedną trzecią okna twojego modelu i koryguj go od tego miejsca. Wystarczająco nisko, by żadna sesja nie spędzała godzin blisko pułapu, wystarczająco wysoko, by zwykła praca kończyła się bez przerywania jej streszczeniem.
Mierz własne zużycie
Nic z tego nie wymaga nowej instrumentacji. Każda odpowiedź API niesie obiekt usage z czterema polami: input_tokens, cache_creation_input_tokens, cache_read_input_tokens i output_tokens. Większość środowisk uruchamiających agentów zapisuje je już do logu sesji na dysku.
Dwie liczby powiedzą ci niemal wszystko.
Wejście ważone cache na wywołanie. Zważ pola według ich kosztu: świeże wejście po 1, zapisy do cache po 1,25 lub 2, odczyty z cache po 0,1. Jeśli ta wartość rośnie tydzień po tygodniu, gdy twoje obciążenie jest stałe, twoje sesje rosną i za to płacisz.
Szczytowy kontekst na sesję. Największe pojedyncze wywołanie w każdej sesji. Jeśli szczyty leżą blisko okna twojego modelu, właśnie znalazłeś swój rachunek.
Surowe tygodniowe sumy będą cię wprowadzać w błąd, bo pracowity tydzień bije spokojny tydzień niezależnie od tego, co zmienisz. Zawsze dziel przez coś, co reprezentuje pracę: ukończone zadanie, zapytanie, wywołanie API.
Czytaj dalej
Okno kontekstowe to powtarzająca się opłata, pobierana w każdej turze, za wszystko, co kiedykolwiek do niego włożyłeś. Caching obniża stawkę o około dziewięćdziesiąt procent i ukrywa ten trend. Rozwiązaniem jest mniejsze okno, które resetuje się celowo.
Aby poznać wersję opartą na pomiarach — z pięcioma tygodniami danych o sesjach i tym jednym ustawieniem, które dało większość oszczędności — przeczytaj tekst towarzyszący o ograniczeniu zużycia tokenów przez agenta o 17% .
