


La versione breve
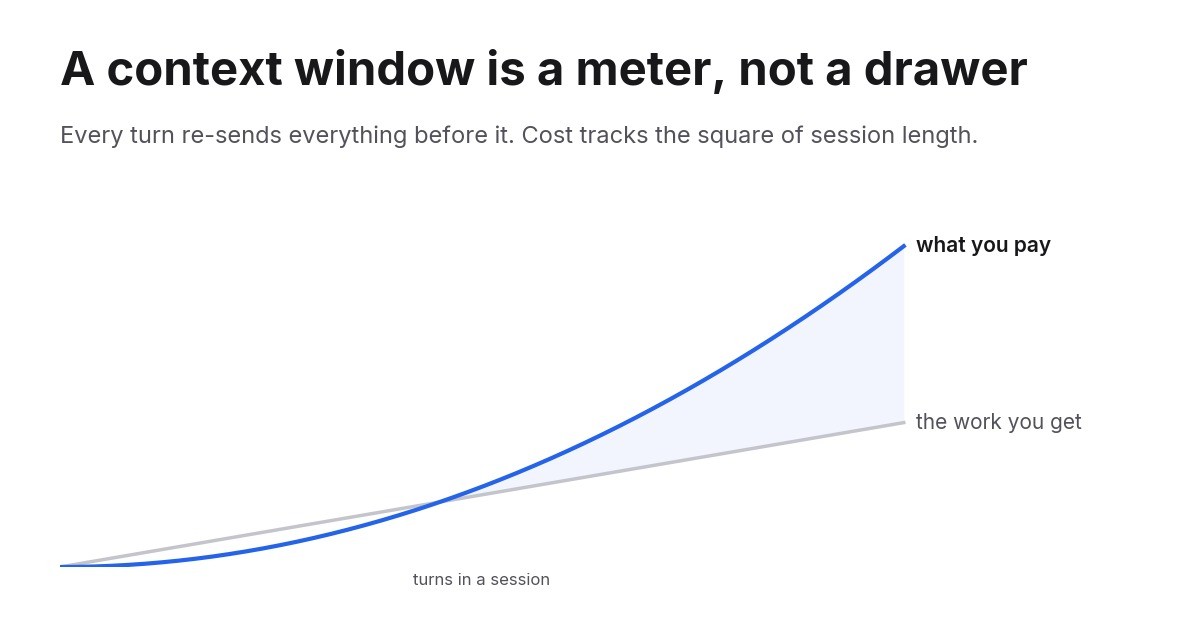
- Un modello non ha memoria tra una richiesta e l’altra. Ogni turno re-invia l’intera conversazione, quindi la context window è un costo addebitato a ogni chiamata, non un posto che riempi una volta sola.
- Questo fa crescere il costo di una sessione con il quadrato della sua lunghezza. Il prompt caching taglia la tariffa a circa un decimo, ma non cambia la forma della curva.
- La soluzione è una finestra più piccola che si azzera di proposito: limitane la crescita, svuota più spesso, elimina l’output dei tool già consumato e tieni le letture pesanti in file e subagenti, dove non tornano più indietro.
Una finestra è un contatore, non un cassetto
La maggior parte delle persone immagina la context window come uno spazio di archiviazione. Ci metti delle cose, il modello le vede, una finestra più grande ne contiene di più. Questa immagine è sbagliata in un modo molto specifico, e l’errore è costoso.
I modelli sono stateless. Non c’è nessuna sessione dall’altra parte che conserva la tua conversazione. Ogni richiesta invia di nuovo tutta la cronologia: il system prompt, ogni definizione di tool, ogni file che l’agente ha letto, ogni risultato di tool, ogni messaggio scritto da uno dei due. Il modello legge tutto, risponde e dimentica. Il tuo messaggio successivo invia di nuovo tutto quanto, più la parte nuova.
Quindi la finestra non è un cassetto. È un contatore, e la sua lettura a ogni turno corrisponde alla dimensione di tutto ciò che hai accumulato fino a quel momento.

Pronto a far crescere il tuo business?
Inizia oggi la tua prova gratuita e vedi i risultati in pochi giorni.
L’aritmetica che nessuno fa in anticipo
Prendi una sessione che cresce di circa 1.000 token per turno e dura 300 turni. Il suo contesto sale da quasi zero a 300.000 token, con una media di 150.000. Input totale inviato: 300 per 150.000, cioè 45 milioni di token, per ottenere 300 turni di lavoro.
Ora lascia che la stessa sessione cresca tre volte più in fretta, fino a 900.000. La media è 450.000, il totale è 135 milioni, tre volte il conto per esattamente gli stessi 300 turni.
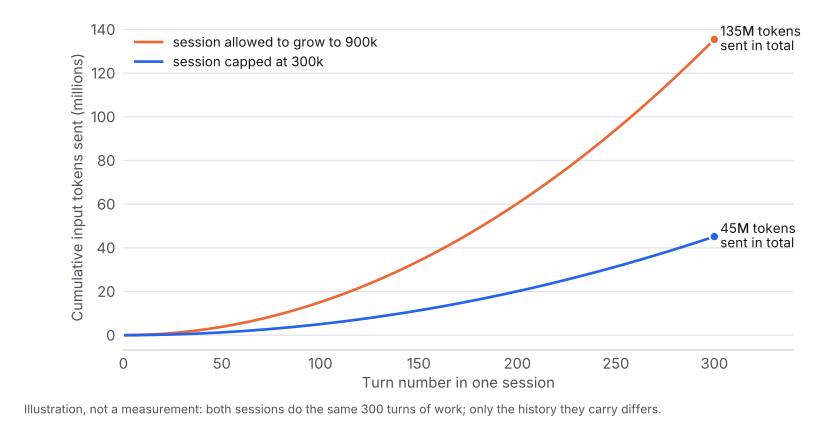
Questa è la forma del problema. Il costo non segue il lavoro che ottieni. Segue quanto a lungo lasci girare la sessione, elevato al quadrato. Ogni turno che aggiungi rende più costoso ogni turno futuro, ed è per questo che l’ultima ora di una sessione lunga può costare più delle prime quattro.
In denaro, al prezzo di listino di Claude Opus 5 di 5 $ per milione di token di input e con tutto ciò che viene dopo il primo turno servito dalla cache a un decimo di quella tariffa: la sessione limitata costa circa 22 $, quella senza limite circa 68 $, per lo stesso lavoro. Con un abbonamento non vedi i dollari, vedi il limite settimanale esaurirsi prima.
Il caching cambia la tariffa, non la curva
Il prompt caching è ciò che rende sostenibili le sessioni lunghe degli agenti. Il provider tiene caldo il prefisso della tua conversazione e addebita una frazione del prezzo per rileggerlo.
Sull’API di Anthropic i moltiplicatori sono 1,25x il prezzo base dell’input per scrivere nella cache da cinque minuti, 2x per quella da un’ora e circa 0,1x per la lettura. Una scrittura in cache da cinque minuti si ripaga già alla seconda richiesta. Ogni harness serio per agenti lo fa automaticamente, e funziona: nelle cinque settimane delle mie sessioni, il 98% di tutti i token di input erano letture dalla cache.
Guarda bene cosa ha risolto il caching e cosa no. Ha moltiplicato il costo della tua cronologia per circa un decimo. Non ha impedito alla cronologia di crescere e non ti ha impedito di rileggerla a ogni turno. Un decimo di 900.000 token sono 90.000 token di input fatturati per una domanda che avresti potuto fare in venti.
Il caching è ciò che rende il problema sopravvivibile. È anche ciò che lo rende invisibile, perché il numero sulla tua dashboard di utilizzo non sembra mai così allarmante quanto il numero di token che si muovono davvero.
Iscriviti alla nostra newsletter
Ricevi gratuitamente gli ultimi consigli, tendenze e offerte.
Cosa c’è davvero dentro
Quando una sessione diventa grande, la gente presume che sia colpa della conversazione. Di solito non è così. In una sessione di lavoro di un agente il peso sta in quattro punti.
Definizioni dei tool. Ogni tool che l’agente può chiamare porta con sé un nome, una descrizione e uno schema completo dei parametri, tutti caricati prima che l’agente faccia qualsiasi cosa. Collega sei server MCP con 25 tool ciascuno e al primo turno hai 150 schemi nella finestra, la maggior parte dei quali non verrà mai chiamata.
Letture di file. Un agente che legge un file sorgente di 2.000 righe ha appena aggiunto circa 25.000 token a ogni turno futuro della sessione. Quel file gli serviva una volta. Se lo porta dietro per sempre.
Output dei tool. Una ricerca che restituisce 200 risultati, un test run che stampa tutto il suo log, una chiamata API che restituisce un documento intero. Di solito all’agente serviva una riga. Rimane tutto.
La conversazione stessa. Comprese le parti in cui l’agente ha esplorato un vicolo cieco, si è corretto e ha tirato avanti. Quei token sono ancora nella finestra, vengono ancora riletti e continuano a plasmare la risposta successiva.
L’ultimo punto conta al di là del costo. Una finestra piena di tentativi abbandonati e contenuti di file ormai obsoleti è anche una finestra in cui il dettaglio rilevante è più difficile da trovare. Il contesto è allo stesso tempo un problema di budget e di attenzione.
Tre modi per ridurla
Svuotare. Inizia una nuova sessione. Tutto ciò che hai annotato altrove sopravvive; tutto il resto sparisce. È lo strumento più brutale e spesso quello giusto. Tenere in vita un’unica sessione tutto il giorno perché “conosce il progetto” è l’abitudine che costa di più.
Context editing. Rimuovi materiale specifico e mantieni il resto parola per parola, di solito i vecchi risultati dei tool una volta usati. L’API di Anthropic lo espone direttamente come strategia di gestione del contesto. È preciso e non distorce ciò che rimane, quindi è la prima cosa a cui ricorrere quando il peso è dato da output di tool voluminosi più che da una conversazione lunga.
Compattazione. Riassumi la cronologia e prosegui dal riassunto. È ciò che la maggior parte degli agenti di coding fa automaticamente quando la finestra si riempie, ed è l’unica opzione che limita la crescita di una sessione senza porvi fine. Fa cadere moltissimo materiale.
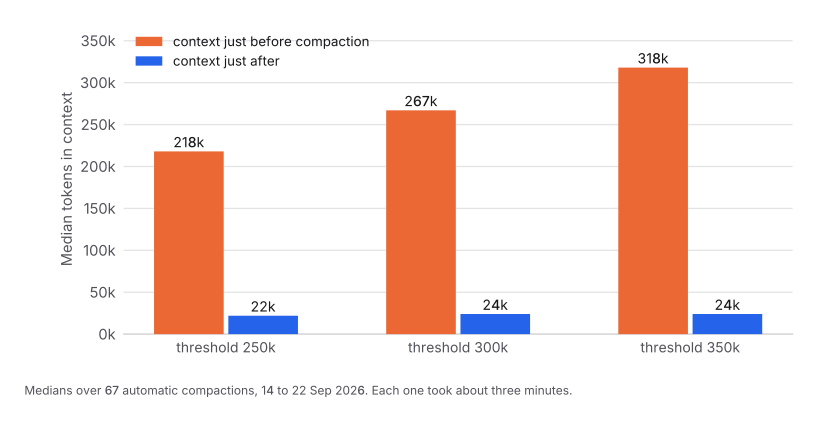
Quelle sono mediane su 67 compattazioni reali nelle mie sessioni. Ognuna ha richiesto circa tre minuti e, subito dopo, l’agente ha riletto file che aveva già visto a una velocità quasi doppia rispetto a prima, ricostruendo ciò che il riassunto aveva perso. Lo scambio vale la pena. Resta comunque uno scambio.
La quarta opzione è migliore di tutte e tre
Non metterlo nella finestra fin dall’inizio.
Tieni lo stato durevole in file che l’agente può rileggere su richiesta, invece che nella conversazione. Manda il lavoro a forte intensità di lettura a un subagente con il proprio contesto di breve durata, così i venti file che legge non toccano mai la sessione principale. Carica i tool quando servono, invece che tutti in anticipo.
Un token che non viene mai aggiunto è un token che non rileggerai mai. Tutto il resto in questa pagina è contenimento dei danni per i token che invece sono stati aggiunti.
Dove dovrebbe stare la soglia
Se il tuo agente compatta automaticamente, ha una soglia, e il valore predefinito di solito è vicino alla finestra completa del modello. Quel valore predefinito è l’impostazione costosa, perché lascia che la tua sessione passi le sue ore più produttive portandosi dietro la cronologia più grande possibile.
Abbassarla aiuta, ma esiste un limite inferiore. Se compatti troppo spesso, paghi ripetutamente l’attesa di tre minuti e il lavoro da rifare. Su un modello con contesto da 1M, una soglia di 250.000 ha forzato una compattazione nel 36% delle mie sessioni lunghe; 350.000 ne ha innescata una solo nel 12% dei casi, catturando quasi lo stesso risparmio. Su cinque settimane di sessioni il risultato è stato il 17% di token pesati sulla cache in meno per lo stesso numero di prompt, e circa la metà del costo nelle sessioni lunghe in cui il limite ha effettivamente morso. I dati completi sono in il post di accompagnamento .
Una regola applicabile: fissa il limite a circa un terzo della finestra del tuo modello e aggiusta da lì. Abbastanza basso perché nessuna sessione passi ore vicino al tetto, abbastanza alto perché il lavoro ordinario si concluda senza essere interrotto da un riassunto.
Misura i tuoi
Niente di tutto questo richiede nuova strumentazione. Ogni risposta API porta con sé un oggetto usage con quattro campi: input_tokens, cache_creation_input_tokens, cache_read_input_tokens e output_tokens. La maggior parte degli harness per agenti li scrive già in un log di sessione su disco.
Due numeri ti dicono quasi tutto.
Input pesato sulla cache per chiamata. Pesa i campi in base a quanto costano: input fresco a 1, scritture in cache a 1,25 o 2, letture dalla cache a 0,1. Se questo valore sale settimana dopo settimana mentre il tuo carico di lavoro resta piatto, le tue sessioni stanno crescendo e lo stai pagando.
Contesto di picco per sessione. La singola chiamata più grande in ogni sessione. Se i picchi si avvicinano alla finestra del tuo modello, hai trovato il tuo conto.
I totali settimanali grezzi ti inganneranno, perché una settimana intensa batte una settimana tranquilla qualunque cosa tu cambi. Dividi sempre per qualcosa che rappresenti il lavoro: un’attività completata, un prompt, una chiamata API.
Leggi dopo
Una context window è un addebito ricorrente, preso a ogni turno, per tutto ciò che ci hai mai messo dentro. Il caching taglia la tariffa di circa il novanta per cento e nasconde la tendenza. La soluzione è una finestra più piccola che si azzera di proposito.
Per la versione misurata, con cinque settimane di dati di sessione e l’unica impostazione che ha prodotto gran parte del risparmio, leggi l’articolo di accompagnamento su come ridurre l’uso di token di un agente del 17% .
