


Krátka verzia
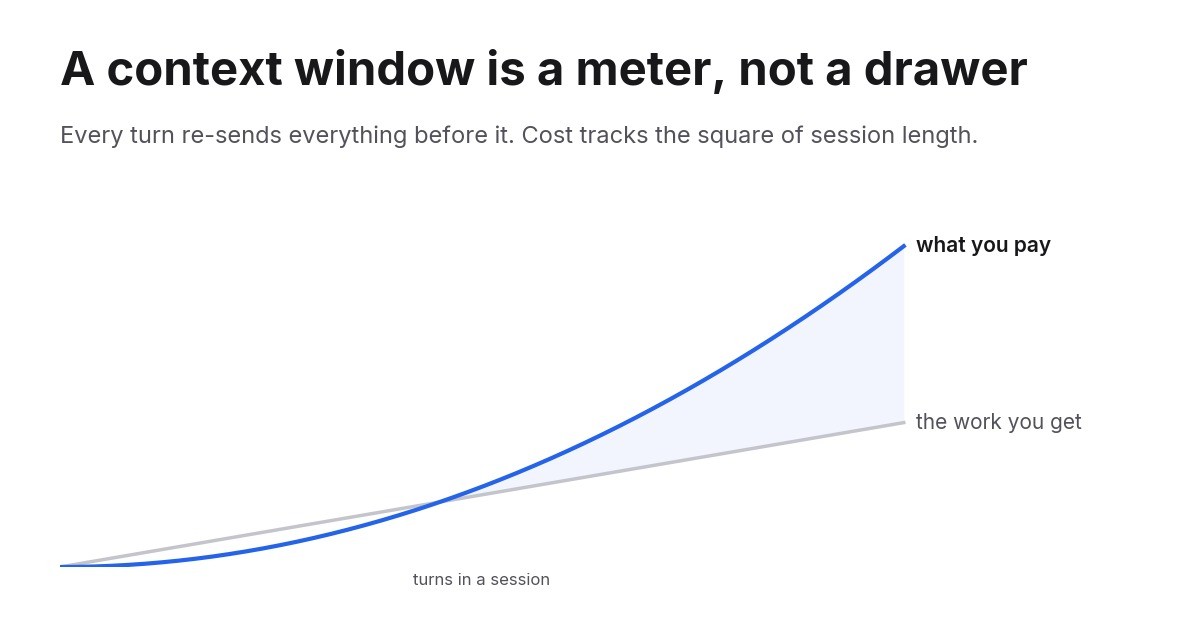
- Model nemá medzi požiadavkami žiadnu pamäť. Každý krok znovu posiela celú konverzáciu, takže kontextové okno je náklad účtovaný pri každom volaní, nie miesto, ktoré raz naplníte.
- Preto náklady na reláciu rastú s druhou mocninou jej dĺžky. Prompt caching zníži sadzbu na približne desatinu, ale nemení tvar krivky.
- Riešením je menšie okno, ktoré sa zámerne resetuje: obmedzte jeho rast, častejšie ho čistite, vymažte minutý výstup nástrojov a náročné čítanie držte v súboroch a podriadených agentoch, odkiaľ sa už nikdy nevráti.
Okno je merač, nie zásuvka
Väčšina ľudí si kontextové okno predstavuje ako úložisko. Vložíte doň veci, model ich vidí, väčšie okno pojme viac. Tá predstava je nesprávna v jednom konkrétnom bode a tá chyba je drahá.
Modely sú bezstavové. Na druhej strane neexistuje žiadna relácia, ktorá by držala vašu konverzáciu. Každá požiadavka posiela celú históriu znova: systémový prompt, každú definíciu nástroja, každý súbor, ktorý agent prečítal, každý výsledok nástroja, každú správu, ktorú ste napísali vy alebo on. Model to všetko prečíta, odpovie a zabudne. Vaša ďalšia správa pošle všetko znovu, plus tú novú časť.
Takže okno nie je zásuvka. Je to merač a jeho hodnota v každom kroku je veľkosť všetkého, čo ste doteraz nahromadili.

Pripravení rozšíriť svoje podnikanie?
Začnite svoju 30-dňovú skúšobnú verziu ešte dnes a vidzte výsledky behom pár dní.
Aritmetika, ktorú nikto nerobí vopred
Vezmite reláciu, ktorá narastie o približne 1 000 tokenov na krok a beží 300 krokov. Jej kontext stúpne z takmer nuly na 300 000 tokenov, v priemere 150 000. Celkový odoslaný vstup: 300 krát 150 000, čo je 45 miliónov tokenov, aby ste dostali 300 krokov práce.
Teraz nech tá istá relácia rastie trikrát rýchlejšie, na 900 000. Priemer je 450 000, celkový súčet 135 miliónov, trojnásobný účet za presne tých istých 300 krokov.
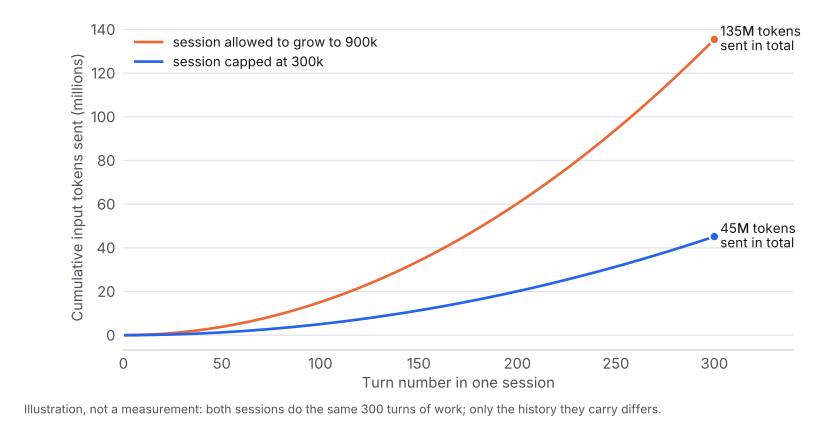
To je tvar problému. Náklady nesledujú prácu, ktorú dostanete. Sledujú, ako dlho necháte reláciu bežať, a to na druhú. Každý pridaný krok zdražuje každý budúci krok, a preto môže posledná hodina dlhej relácie stáť viac než prvé štyri.
V peniazoch, pri katalógovej cene Claude Opus 5 päť dolárov za milión vstupných tokenov a so všetkým po prvom kroku obsluhovaným z vyrovnávacej pamäte za desatinu: obmedzená relácia stojí približne 22 dolárov, neobmedzená približne 68 dolárov, za rovnakú prácu. Pri predplatnom nevidíte doláre, vidíte len to, že týždenný limit sa minie skôr.
Caching mení sadzbu, nie krivku
Prompt caching je dôvod, prečo sú dlhé relácie agentov vôbec realizovateľné. Poskytovateľ udržiava váš prefix konverzácie v teple a za zlomok ceny ho znovu prečíta.
V rozhraní API od Anthropicu sú násobiče 1,25x základnej ceny vstupu za zápis do päťminútovej vyrovnávacej pamäte, 2x za hodinovú a približne 0,1x za čítanie. Zápis do päťminútovej pamäte sa zaplatí už pri druhej požiadavke. Každé seriózne prostredie pre agentov to robí automaticky a funguje to: za päť týždňov mojich vlastných relácií bolo 98 % všetkých vstupných tokenov čítaniami z vyrovnávacej pamäte.
Pozorne si všimnite, čo caching vyriešil a čo nie. Vynásobil náklady na vašu históriu približne jednou desatinou. Nezastavil rast histórie a nezastavil ani to, aby ste ju znovu neprečítali v každom kroku. Desatina z 900 000 tokenov je 90 000 účtovaných vstupných tokenov za otázku, ktorú ste mohli položiť v dvadsiatich.
Caching je to, čo robí tento problém prežiteľným. Je to aj to, čo ho robí neviditeľným, pretože číslo na vašom paneli spotreby nikdy nevyzerá tak alarmujúco ako počet tokenov, ktoré sa naozaj hýbu.
Prihláste sa na newsletter
Získajte najnovšie tipy, trendy a ponuky zadarmo.
Čo v ňom vlastne je
Keď je relácia veľká, ľudia predpokladajú, že je to konverzácia. Zvyčajne nie. V pracovnej relácii agenta spočíva váha na štyroch miestach.
Definície nástrojov. Každý nástroj, ktorý agent môže zavolať, nesie názov, popis a úplnú schému parametrov, a to všetko načítané ešte predtým, než agent čokoľvek urobí. Pripojte šesť serverov MCP s 25 nástrojmi a v prvom kroku máte v okne 150 schém, z ktorých väčšina nebude nikdy zavolaná.
Čítanie súborov. Agent, ktorý prečíta zdrojový súbor s 2 000 riadkami, práve pridal približne 25 000 tokenov do každého budúceho kroku relácie. Súbor potreboval raz. Nosiť ho bude navždy.
Výstup nástrojov. Vyhľadávanie, ktoré vráti 200 výsledkov, spustenie testov, ktoré vypíše celý svoj log, volanie API, ktoré vráti celý dokument. Agent z toho zvyčajne potreboval jeden riadok. Všetko ostatné zostáva.
Samotná konverzácia. Vrátane častí, kde agent skúmal slepú uličku, opravil sa a šiel ďalej. Tie tokeny sú stále v okne, stále sa znovu čítajú a stále formujú ďalšiu odpoveď.
Posledný bod je dôležitý nielen z hľadiska nákladov. Okno plné opustených pokusov a zastaraného obsahu súborov je aj oknom, v ktorom je ťažšie nájsť relevantný detail. Kontext je zároveň rozpočtom aj problémom pozornosti.
Tri spôsoby, ako ho zmenšiť
Čistenie. Začnite novú reláciu. Všetko, čo ste si zapísali inde, prežije; všetko ostatné je preč. Je to najhrubší nástroj a často ten správny. Udržiavať jednu reláciu nažive celý deň, pretože „pozná projekt“, je návyk, ktorý stojí najviac.
Úprava kontextu. Odstráňte konkrétny materiál a zvyšok ponechajte slovo za slovom, zvyčajne staré výsledky nástrojov, keď už boli použité. Rozhranie API od Anthropicu to sprístupňuje priamo ako stratégiu správy kontextu. Je presná a neskresľuje to, čo zostáva, takže po nej siahneme ako po prvej, keď je váha v objemnom výstupe nástrojov a nie v dlhej konverzácii.
Kompakcia. Zhrňte históriu a pokračujte zo zhrnutia. To je to, čo väčšina programátorských agentov robí automaticky, keď sa okno naplní, a je to jediná možnosť, ktorá ohraničí rast relácie bez toho, aby ju ukončila. Zahodí veľa.
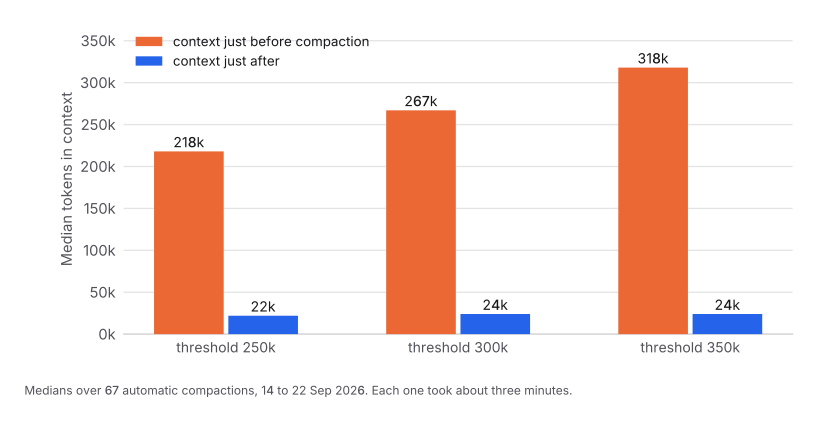
To sú mediány zo 67 skutočných kompakcií v mojich vlastných reláciách. Každá trvala približne tri minúty a potom agent znovu prečítal súbory, ktoré už videl, takmer dvakrát častejšie než predtým, a znovu budoval to, čo zhrnutie stratilo. Ten obchod sa vyplatí. Stále je to obchod.
Štvrtá možnosť je lepšia než všetky tri
Nedávajte to do okna v prvom rade.
Trvalý stav držte v súboroch, ktoré agent môže podľa potreby znovu prečítať, namiesto v konverzácii. Prácu náročnú na čítanie pošlite podriadenému agentovi s vlastným krátkodobým kontextom, aby sa tých dvadsať súborov, ktoré prečíta, nikdy nedotklo hlavnej relácie. Nástroje načítavajte vtedy, keď sú potrebné, a nie všetky dopredu.
Token, ktorý nikdy nebol pridaný, je token, ktorý nikdy znovu neprečítate. Všetko ostatné na tejto stránke je sanácia škôd pre tokeny, ktoré pridané boli.
Kde má byť prah
Ak váš agent kompaktuje automaticky, má prah a predvolená hodnota je zvyčajne blízko plného okna modelu. Toto predvolené nastavenie je to drahé, pretože dovoľuje vašej relácii stráviť svoje najproduktívnejšie hodiny nesením čo najväčšej histórie.
Nastaviť ho nižšie pomáha, ale existuje spodná hranica. Kompaktujte príliš horlivo a zaplatíte tú trojminútovú čakaciu dobu a prerobenie znova a znova. Na modeli s kontextom 1 milión vyvolal prah 250 000 kompakciu v 36 % mojich dlhých relácií; 350 000 ju spustilo len v 12 % a zachytilo takmer celú rovnakú úsporu. Za päť týždňov relácií bol výsledok o 17 % menej tokenov vážených vyrovnávacou pamäťou za rovnaký počet promptov a približne polovičné náklady v dlhých reláciách, kde obmedzenie naozaj zabralo. Kompletné dáta sú v sprievodnom článku .
Použiteľné pravidlo: nastavte strop na približne tretinu okna vášho modelu a odtiaľ ho ladte. Dosť nízko na to, aby žiadna relácia nestrávila hodiny pri strope, a dosť vysoko na to, aby bežná práca skončila bez prerušenia zhrnutím.
Zmerajte si to sami
Nič z toho nepotrebuje nové meranie. Každá odpoveď API nesie objekt usage so štyrmi poľami: input_tokens, cache_creation_input_tokens, cache_read_input_tokens a output_tokens. Väčšina prostredí pre agentov ich už zapisuje do logu relácie na disku.
Dve čísla vám povedia takmer všetko.
Vstup na volanie vážený vyrovnávacou pamäťou. Vážte polia podľa toho, čo stoja: čerstvý vstup 1, zápisy do pamäte 1,25 alebo 2, čítania z pamäte 0,1. Ak to stúpa týždeň po týždni, kým vaše zaťaženie je rovnaké, vaše relácie rastú a vy za to platíte.
Špičkový kontext na reláciu. Najväčšie jednotlivé volanie v každej relácii. Ak sa špičky držia blízko okna vášho modelu, našli ste svoj účet.
Surové týždenné súčty vás zavedú na scestie, pretože rušný týždeň porazí pokojný bez ohľadu na to, čo zmeníte. Vždy delte niečím, čo zastupuje prácu: dokončenou úlohou, promptom, volaním API.
Čítajte ďalej
Kontextové okno je opakovaný poplatok, účtovaný pri každom kroku, za všetko, čo ste doň kedy vložili. Caching znižuje sadzbu približne o deväťdesiat percent a skrýva trend. Riešením je menšie okno, ktoré sa zámerne resetuje.
Pre nameranú verziu, s piatimi týždňami údajov o reláciách a tým jedným nastavením, ktoré prinieslo väčšinu úspory, si prečítajte sprievodný článok o znížení spotreby tokenov agenta o 17 % .
