


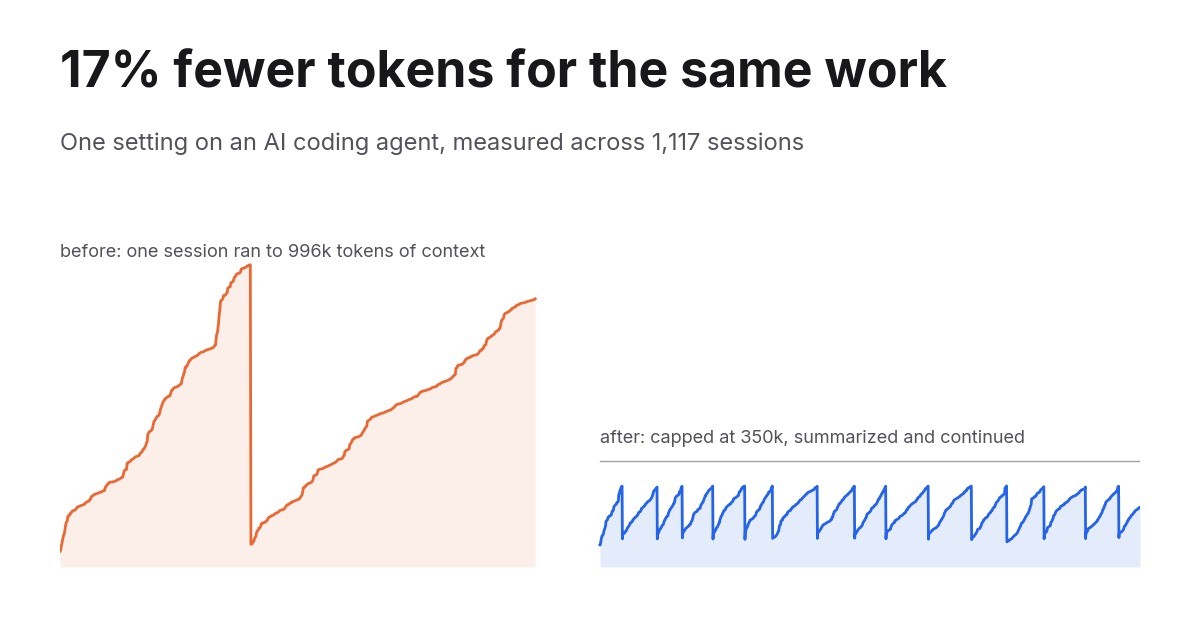
Lyhyt versio
- Ajan AI-koodausagenttia koko päivän mallilla, jossa on 1M tokenin konteksti-ikkuna. Istunnot kasvoivat ennen siihen pisteeseen, että ne täyttivät sen lähes kokonaan.
- Lisäsin sen konfiguraatioon yhden rivin, joka rajaa istunnon 350 000 tokenin kontekstiin ennen kuin se tiivistää itsensä ja jatkaa.
- Mitattuna 1 117 istuntotallenteesta: 17 % vähemmän tokeneita samalla kehotemäärällä ja niissä pitkissä istunnoissa, joissa raja todella puree, 55 % vähemmän.
Alla on menetelmä, jokainen kaavio ja se, mitä se sinulta vastineeksi vaatii, jotta voit itse päättää, soveltuuko tämä sinun ympäristöösi.
Miksi 1M:n ikkuna maksaa enemmän kuin miltä näyttää
Keskustelu mallin kanssa on tilaton. Jokainen pyyntö kuljettaa mukanaan koko historian: järjestelmäkehote, jokainen työkalun määritelmä, jokainen tiedosto, jonka agentti on lukenut, jokainen työkalun tulos, jokainen viesti. Ei muutos, vaan kaikki se, joka kerta.
Niinpä istunto, joka on kasvanut 900 000 tokeniin, maksaa 900 000 tokenia syötettä seuraavalla kutsulla ja sitä seuraavalla. Kierros 400 ei tee enempää työtä kuin kierros 4. Se vain maksaa moninkertaisesti enemmän.
Kehotteiden välimuisti pehmentää tätä. Tokenit, jotka malli on nähnyt aiemmin, laskutetaan noin kymmenesosalla normaalisyötteen hinnasta. Alennus on todellinen, se tekee pitkistä istunnoista ylipäätään mahdollisia, ja juuri siksi kukaan ei katso ongelmaa. Aineistossani 98 % kaikista syötetokeneista oli välimuistilukuja. Kymmenesosa hyvin suuresta luvusta oli silti laskun suurin erä.
Kysymys ei ole siitä, onko historiasi välimuistissa. Kysymys on siitä, kuinka suureksi sen annetaan kasvaa ennen kuin jokin nollaa sen.

Valmis kasvattamaan liiketoimintaasi?
Aloita ilmainen kokeilujakso tänään ja näe tulokset muutamassa päivässä.
Mitä muutin
Agentti on Claude Code, joka ajaa Opusta 1M:n konteksti-ikkunalla. Asetus on autoCompactWindow tiedostossa ~/.claude/settings.json. Kun istunto saavuttaa sen verran tokeneita, agentti tiivistää keskustelun ja jatkaa tiivistelmän pohjalta.
{
  "autoCompactWindow": 350000
}
En ollut koskaan asettanut sitä, joten istunnot kulkivat, kunnes ne lähestyivät täyttä ikkunaa. Neljän päivän aikana kokeilin kolmea arvoa:
| Päivä | Asetus |
|---|---|
| 14. syyskuuta | 250 000 |
| 15. syyskuuta | 300 000 |
| 18. syyskuuta | 350 000 |
Miten mittasin sen
Claude Code kirjoittaa jokaisen istunnon JSONL-tallenteeseen hakemistoon ~/.claude/projects/, mukaan lukien jokaisen API-kutsun tokenien käytön. Jäsensin kaikki 1 117 tallennetta, jotka kattavat viisi viikkoa 19. elokuuta – 22. syyskuuta, poistin päällekkäisyydet pyyntötunnuksen perusteella ja pidin vain interaktiiviset istunnot. GitHub Actionsissa tehdyt ajot käyttävät samaa tiliä, mutta kannettavani asetus ei voi vaikuttaa niihin, joten ne on jätetty pois.
Raakatokenmäärät ovat yksinään harhaanjohtavia. Kiireinen viikko päihittää rauhallisen viikon riippumatta siitä, mitä muutat. Siksi jokainen alla oleva luku on välimuistipainotettu, eli juuri se, mitä mittari todella lukee: tuore syöte 1x, välimuistiin kirjoitukset 1,25x (5 minuutin välimuisti) tai 2x (1 tunnin välimuisti), välimuistiluvut 0,1x. Ja jokainen vertailu on normalisoitu tehdyn työn mukaan, joko kirjoittamieni kehotteiden tai agentin tekemien API-kutsujen mukaan.
Liity uutiskirjeellemme
Saa uusimmat vinkit, trendit ja tarjoukset ilmaiseksi.
Kaksi istuntoa, sama agentti
Tässä on mekanismi yhdessä kuvassa. Vasemmalla on todellinen istunto 3. syyskuuta ennen rajaa. Oikealla todellinen istunto 15. syyskuuta sen jälkeen.
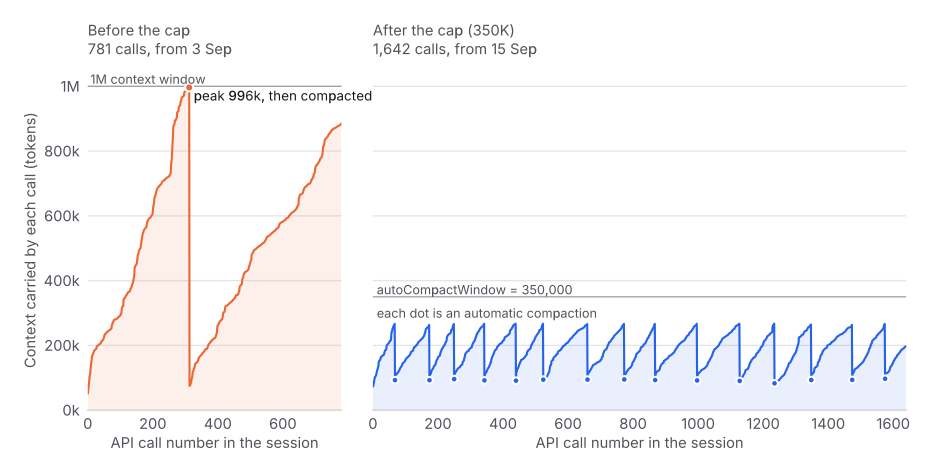
Vasemmanpuoleinen istunto kesti 781 kutsua. Se kipusi 996 000 tokenin kontekstiin, osui 1M:n ikkunan seinään, tiivistyi kerran ja kipusi sitten suoraan takaisin 880 000:een. Tuon istunnon jälkipuoliskolla jokainen yksittäinen kutsu luki uudelleen yli puoli miljoonaa tokenia.
Oikeanpuoleinen istunto kesti 1 642 kutsua, yli kaksi kertaa pidempään, eikä kuljettanut koskaan yli 270 000:ta. Se tiivistyi viisitoista kertaa. Jokainen tiivistys on piste.
Viikkoluvut
Vain interaktiiviset istunnot. Palkit ovat välimuistipainotettuja syötetokeneita API-kutsua kohti, mikä on reiluin yksittäinen luku, koska se ei välitä siitä, kuinka paljon työskentelin tiettynä viikkona.
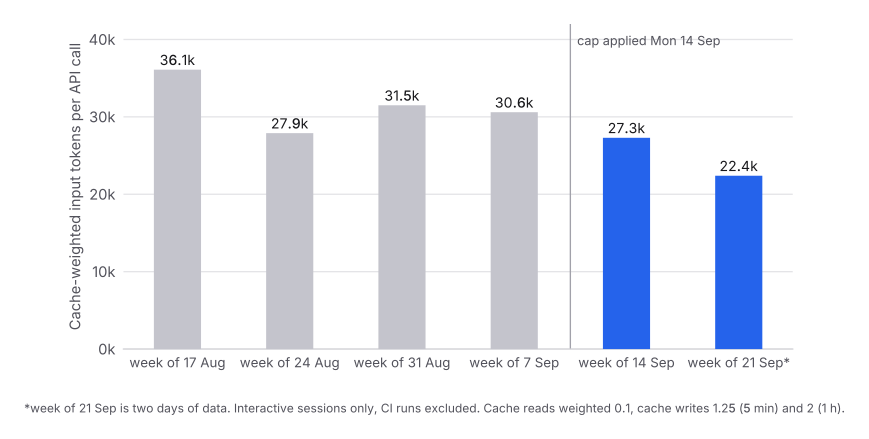
Selkein vertailu aineistossa on 7. syyskuuta alkava viikko verrattuna 14. syyskuuta alkavaan viikkoon, koska en valinnut niitä itse. Ne vain osuivat muutoksen eri puolille, ja kirjoitin kumpaankin lähes täsmälleen saman määrän kehotteita.
| Viikko alkaen | Kehotteet | API-kutsut | Välimuistipainotettu syöte | Kutsua kohti |
|---|---|---|---|---|
| 7.9. | 971 | 11 364 | 348,1M | 30,6k |
| 14.9. | 968 | 10 555 | 288,5M | 27,3k |
971 kehotetta vastaan 968. Tehollinen syöte laski 348,1M:stä 288,5M:ään. Se on 17 % vähemmän samalla kehotemäärällä. Seuraavan viikon kaksi päivää tulivat 22,4k:hon kutsua kohti, vielä alemmas.
Mihin raha meni
Jaa jokainen API-kutsu sen mukaan, kuinka paljon kontekstia se kuljetti, niin mekanismi näkyy suoraan.
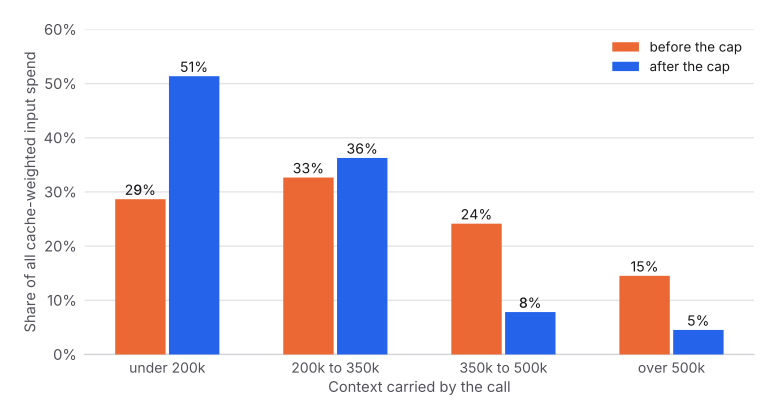
Ennen rajaa 39 % kaikesta kuluttamastani meni kutsuihin, jotka raahasivat perässään yli 350 000 tokenin historiaa. Ne kutsut eivät tehneet enempää työtä kuin muut. Ne olivat samaa työtä, mutta kantoivat enemmän matkatavaraa. Rajan jälkeen osuus on 12 %.
Pitikö katto
Yksi piste istuntoa kohti, sijoitettuna suurimpaan kontekstiin, jonka istunto koskaan kuljetti.
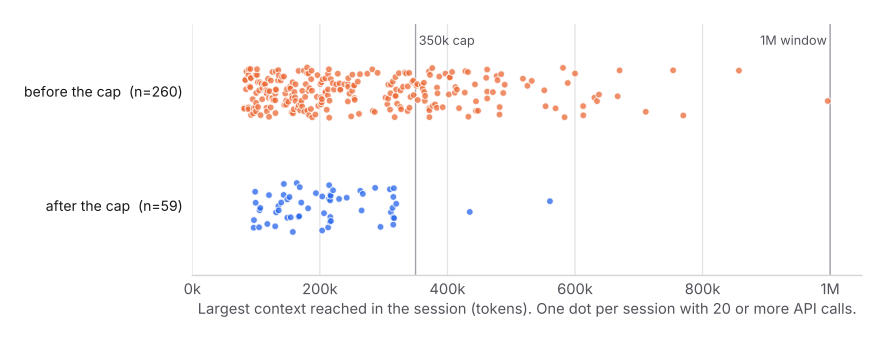
Kaksi istuntoa kahden ensimmäisen päivän aikana ylitti silti rajan, 434 000:een ja 561 000:een, enkä saanut selville miksi. Sen jälkeen kun 350 000:n asetus otettiin käyttöön 18. syyskuuta, yksikään istunto ei ole ylittänyt sitä. Se 500k:n ja 1M:n välillä elävien istuntojen häntä, jossa suurin osa tuhlasta oli, on poissa.
Mitä se olisi maksanut ilman rajaa
Saadakseni kokonaissumman toistin jokaisen muutoksen jälkeen alkaneen istunnon ikään kuin pudotettua kontekstia ei olisi koskaan tiivistetty ja sitä olisi yhä luettu uudelleen jokaisella myöhemmällä kutsulla, rajattuna 1M:n ikkunaan.
| Välimuistipainotettu syöte | |
|---|---|
| Todellinen, 73 istuntoa, 9 675 kutsua, 55 tiivistystä | 216,8M |
| Samat istunnot ilman rajaa | 479,2M |
| Vältetty | 262,5M eli 55 % |
Ensimmäisen kaavion oikeanpuoleinen istunto vastaa yksinään 118,5M:ää tästä. Pitkä refaktorointi, joka muuten olisi käyttänyt viimeiset useat sadat kutsunsa lukemalla uudelleen lähes miljoona tokenia kussakin.
Suhtaudu 55 %:iin optimistisena ääripäänä. Ilman rajaa en olisi oikeasti antanut istunnon jauhaa 900k:ssa tunteja; lopulta olisin tyhjentänyt sen käsin, mikä sekin nollaa kustannuksen. Varovainen ääripää on havaittu kutsukohtainen luku, 30,6k:sta 22,4k:hon, eli suunnilleen 20–27 %. Totuus on jossain näiden kahden välillä.
Mitä se sinulta vaatii
Tämä ei ole ilmaista, ja jokaisen sitä suosittelevan pitäisi sanoa se.
Odotus. 67 tiivistystä muutoksen jälkeen, mediaaniltaan noin kolme minuuttia kukin. Karkeasti 3,4 tuntia tiivistelmän kirjoittamisen seuraamista kahdeksan päivän aikana.
Jonkin verran uudelleentyötä. Tiivistäminen pudottaa paljon pois. 350K:n asetuksella mediaanitiivistys vei 318 000 tokenin istunnon alas 24 000:een. Agentti menettää yksityiskohtia ja rakentaa niitä joskus uudelleen: saman istunnon sisällä uudelleen luetut tiedostot nousivat 11,5 %:sta lukukerroista 20,5 %:iin ensimmäisen tiivistyksen jälkeen. Jälkimmäisen luvun taustalla oleva otos on pieni, joten lue se suuntana, älä mittauksena.
Kynnysarvon valinnalla on väliä. 250K:lla 36 % pitkistä istunnoistani osui tiivistykseen. 350K:lla 12 % osui, ja katto piti silti. Aseta se liian alas, niin maksat kolme minuuttia ja uudelleentyön toistuvasti säästöstä, jonka olit jo tienannut.
Miten se otetaan käyttöön
Claude Code. Lisää autoCompactWindow tiedostoon ~/.claude/settings.json. 1M-kontekstin mallilla 350 000 oli paras kolmesta kokeilemastani arvosta. 200K:n mallilla skaalaa alaspäin ja aloita noin 120 000–140 000:sta. Uudet istunnot ottavat sen käyttöön; jo käynnissä oleva istunto pitää vanhan arvon.
Muut agentit. Etsi samaa ideaa eri nimellä: tiivistysliipaisin, kontekstiraja, tiivistä ja jatka -kynnysarvo. Jos sellaista ei ole, manuaalinen versio on istunnon tyhjentäminen useammin kuin tuntuu luontevalta. Vaisto pitää yhtä pitkää istuntoa elossa koko päivän, koska se “tuntee projektin”, on se kallis.
Käytitpä mitä tahansa, kaksi tapaa tekee enemmän kuin yksikään asetus. Pidä kestävä tila tiedostoissa keskustelun sijaan, jotta agentti voi lukea yhden tiedoston halvalla uudelleen sen sijaan, että se kantaisi jokaista aiempaa vastausta ikuisesti. Ja siirrä lukupainotteinen työ ala-agentteihin, joilla on oma lyhytikäinen kontekstinsa, jotta ne kaksikymmentä tiedostoa, jotka ne lukevat, eivät tule lainkaan pääistuntoon.
Jos olet viikoittaisella rajalla
Jos maksat tilausta, jossa on viikoittainen käyttöraja eikä tokenikohtaista laskua, tämä on löytämäni vipu, jolla on paras vaivan ja vaikutuksen suhde. Yksi rivi JSONia, ei muutosta tapaan tehdä työtä, ja sama raja venyy mitattavasti pidemmälle. Minun tapauksessani sama viikoittainen kehotemäärä maksoi 17 % vähemmän ja pitkät istunnot noin puolet.
Lue seuraavaksi
Konteksti-ikkunoita myydään kapasiteettina. Ne käyttäytyvät kuin juokseva mittari, joka veloittaa jokaisella vuorolla kaikesta, mitä olet koskaan laittanut sisään. Jos haluat tämän taustalla olevan mekaniikan etkä vain asetusta, kumppanijuttu käy läpi, mikä konteksti-ikkunan todella täyttää, miksi pitkä istunto maksaa paljon enemmän kuin sen tekemä työ ja miten välimuisti, tyhjentäminen ja tiivistäminen kukin muuttavat laskentaa.
