


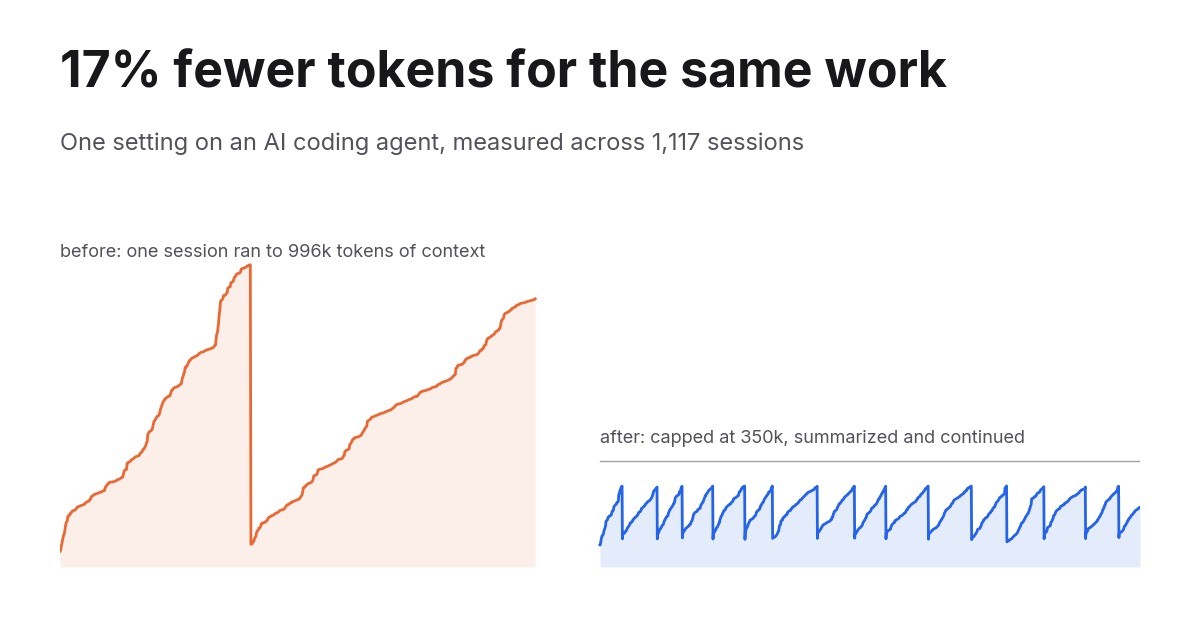
Den korta versionen
- Jag kör en AI-kodagent hela dagen på en modell med ett kontextfönster på 1M tokens. Sessionerna växte förut tills de nästan fyllde det.
- Jag lade till en rad i dess konfiguration, som begränsar en session till 350 000 tokens kontext innan den sammanfattar sig själv och fortsätter.
- Mätt över 1 117 sessionstranskript: 17 % färre tokens för samma antal prompter, och i de långa sessionerna där taket faktiskt slår till, 55 % färre.
Nedan finns metoden, varje diagram och vad det kostar dig i gengäld, så att du kan avgöra om det gäller din uppsättning.
Varför ett fönster på 1M kostar mer än det ser ut
En konversation med en modell är tillståndslös. Varje förfrågan bär hela historiken: systemprompten, varje verktygsdefinition, varje fil agenten har läst, varje verktygsresultat, varje meddelande. Inte en delta. Allt, varje gång.
Så en session som har växt till 900 000 tokens betalar för 900 000 tokens indata vid nästa anrop, och vid anropet efter det. Tur 400 gör inte mer arbete än tur 4. Den kostar bara många gånger mer.
Prompt-cachning mildrar detta. Tokens som modellen har sett tidigare faktureras till ungefär en tiondel av det normala indatapriset. Den rabatten är verklig, den är det som gör långa sessioner genomförbara över huvud taget, och den är också anledningen till att ingen tittar på problemet. I mina data var 98 % av alla indatatokens cache-läsningar. En tiondel av ett mycket stort tal var fortfarande den största posten på räkningen.
Frågan är inte om din historik är cachad. Det är hur stor den tillåts bli innan något nollställer den.

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Vad jag ändrade
Agenten är Claude Code som kör Opus på kontextfönstret på 1M. Inställningen är autoCompactWindow i ~/.claude/settings.json. När en session når så många tokens sammanfattar agenten konversationen och fortsätter från sammanfattningen.
{
  "autoCompactWindow": 350000
}
Jag hade aldrig satt den, så sessionerna körde tills de närmade sig hela fönstret. Under fyra dagar provade jag tre värden:
| Datum | Inställning |
|---|---|
| 14 september | 250 000 |
| 15 september | 300 000 |
| 18 september | 350 000 |
Hur jag mätte
Claude Code skriver varje session till ett JSONL-transkript under ~/.claude/projects/, inklusive tokenanvändningen för varje API-anrop. Jag parsade alla 1 117 av dem, som täcker fem veckor från 19 augusti till 22 september, deduplicerade per request-ID och behöll bara interaktiva sessioner. Körningar i GitHub Actions använder samma konto men kan inte påverkas av en inställning på min laptop, så de är uteslutna.
Råa tokentotaler är missvisande i sig. En hektisk vecka slår en lugn vecka vad du än ändrar. Så varje siffra nedan är cache-viktad, vilket är vad mätaren faktiskt läser: färsk indata vid 1x, cache-skrivningar vid 1,25x (5-minuterscache) eller 2x (1-timmescache), cache-läsningar vid 0,1x. Och varje jämförelse normaliseras efter utfört arbete, antingen prompterna jag skrev eller de API-anrop agenten gjorde.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Två sessioner, samma agent
Detta är mekanismen i en bild. Till vänster en verklig session från 3 september, före taket. Till höger en verklig session från 15 september, efter det.
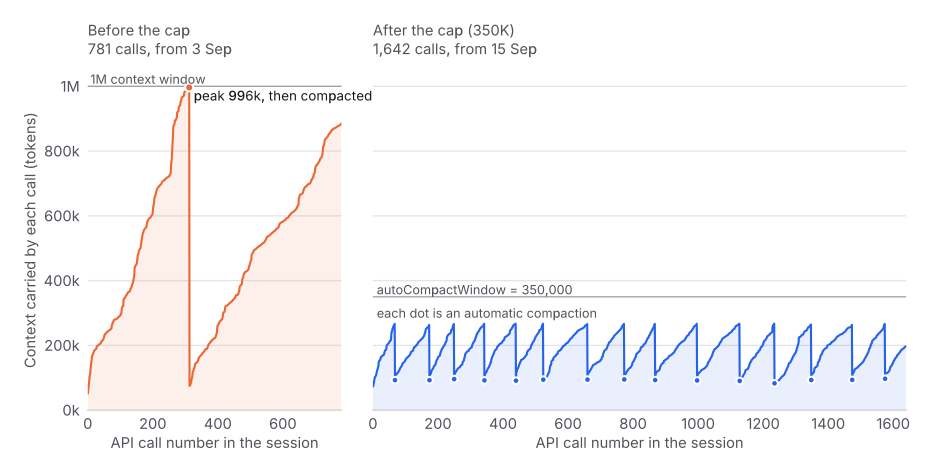
Sessionen till vänster körde 781 anrop. Den klättrade till 996 000 tokens kontext, träffade väggen i 1M-fönstret, kompakterade en gång och klättrade sedan rakt tillbaka till 880 000. Under andra halvan av den sessionen läste varje enskilt anrop om mer än en halv miljon tokens.
Sessionen till höger körde 1 642 anrop, mer än dubbelt så länge, och bar aldrig mer än 270 000. Den kompakterade femton gånger. Varje kompaktering är en prick.
Veckosiffrorna
Endast interaktiva sessioner. Staplarna är cache-viktade indatatokens per API-anrop, vilket är det mest rättvisa enskilda talet eftersom det inte bryr sig om hur mycket jag arbetade en viss vecka.
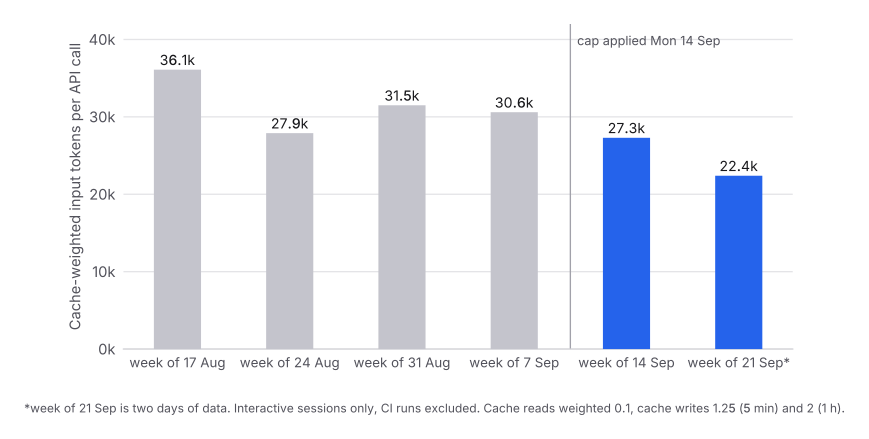
Den renaste jämförelsen i datasetet är veckan den 7 september mot veckan den 14 september, eftersom jag inte valde dem. De råkade helt enkelt hamna på varsin sida om ändringen, och jag skrev nästan exakt lika många prompter i var och en.
| Vecka från | Prompter | API-anrop | Cache-viktad indata | Per anrop |
|---|---|---|---|---|
| 7 sep | 971 | 11 364 | 348,1M | 30,6k |
| 14 sep | 968 | 10 555 | 288,5M | 27,3k |
971 prompter mot 968. Effektiv indata ner från 348,1M till 288,5M. Det är 17 % mindre för samma mängd promptande. De två dagarna i veckan efter kom in på 22,4k per anrop, ännu lägre.
Var pengarna gick
Dela upp varje API-anrop efter hur mycket kontext det bar, och mekanismen syns direkt.
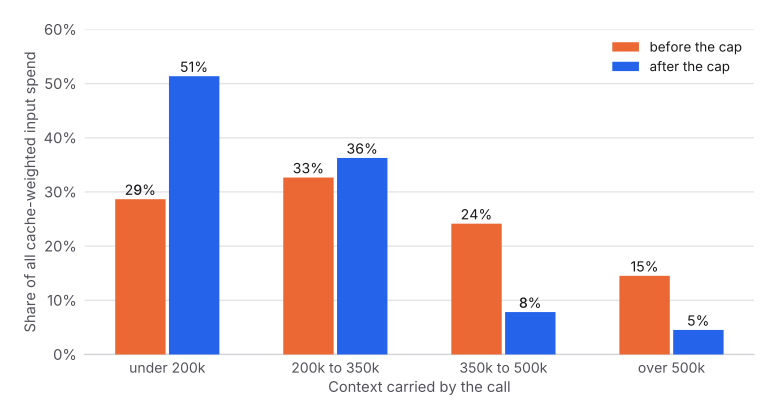
Före taket gick 39 % av allt jag spenderade till anrop som släpade mer än 350 000 tokens historik efter sig. De anropen gjorde inte mer arbete än de andra. De var samma arbete med mer bagage. Efter taket är den andelen 12 %.
Höll taket
En prick per session, placerad vid den största kontext som sessionen någonsin bar.
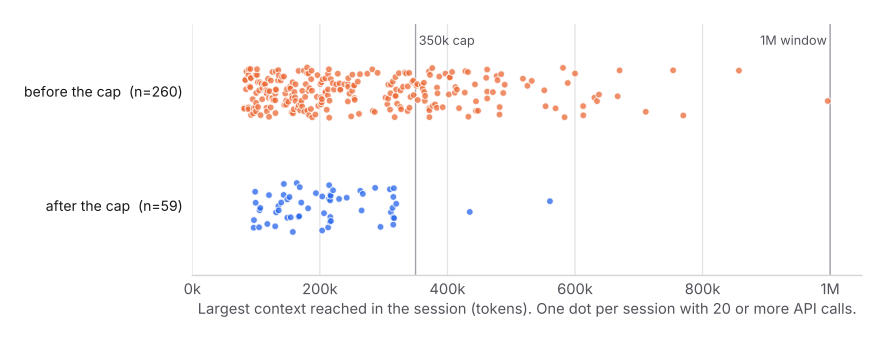
Två sessioner under de första två dagarna körde fortfarande förbi taket, till 434 000 och 561 000, och jag hittade inte varför. Sedan inställningen 350 000 lades in den 18 september har ingen session överskridit den. Svansen av sessioner som levde mellan 500k och 1M, där det mesta av slöseriet fanns, är borta.
Vad det skulle ha kostat utan taket
För att sätta en totalsiffra på det spelade jag upp varje session som startade efter ändringen som om den borttagna kontexten aldrig hade sammanfattats och fortfarande lästes om vid varje senare anrop, begränsad till 1M-fönstret.
| Cache-viktad indata | |
|---|---|
| Faktiskt, 73 sessioner, 9 675 anrop, 55 kompakteringar | 216,8M |
| Samma sessioner utan taket | 479,2M |
| Undviket | 262,5M, eller 55 % |
Sessionen till höger i det första diagrammet står för 118,5M av det på egen hand. En lång refaktorering som annars hade spenderat sina sista flera hundra anrop på att läsa om nära en miljon tokens varje gång.
Behandla 55 % som den optimistiska änden. Utan taket skulle jag inte riktigt ha låtit en session mala på 900k i timmar; till slut skulle jag ha rensat den manuellt, vilket också nollställer kostnaden. Den konservativa änden är den observerade siffran per anrop, 30,6k ner till 22,4k, alltså ungefär 20 % till 27 %. Sanningen ligger någonstans mellan dessa två.
Vad det kostar dig
Detta är inte gratis, och den som rekommenderar det borde säga det.
Väntan. 67 kompakteringar sedan ändringen, i median ungefär tre minuter vardera. Ungefär 3,4 timmar av att titta på när en sammanfattning skrivs, utspritt över åtta dagar.
Visst omarbete. Kompaktering tappar mycket. Vid inställningen 350K tog mediankompakteringen en session på 318 000 tokens ner till 24 000. Agenten tappar detaljer och bygger ibland upp dem igen: filer som lästes om inom samma session gick från 11,5 % av läsningarna före den första kompakteringen till 20,5 % efter. Urvalet bakom den andra siffran är litet, så läs den som en riktning snarare än en mätning.
Valet av tröskel spelar roll. Vid 250K nådde 36 % av mina långa sessioner en kompaktering. Vid 350K gjorde 12 % det, samtidigt som taket höll. Sätt den för lågt och du betalar de tre minuterna och omarbetet gång på gång för en besparing du redan hade säkrat.
Så ställer du in det
Claude Code. Lägg till autoCompactWindow i ~/.claude/settings.json. På en modell med 1M-kontext var 350 000 det bästa av de tre värden jag provade. På en 200K-modell, skala ner och börja runt 120 000 till 140 000. Nya sessioner plockar upp den; en session som redan kör behåller det gamla värdet.
Andra agenter. Leta efter samma idé under ett annat namn: en kompakteringstrigger, en kontextgräns, en tröskel för sammanfatta-och-fortsätt. Om det inte finns någon är den manuella versionen att rensa sessionen oftare än vad som känns naturligt. Instinkten att hålla en lång session vid liv hela dagen för att den “känner till projektet” är den dyra.
Vad du än använder gör två vanor mer än någon inställning. Håll varaktigt tillstånd i filer snarare än i konversationen, så att agenten billigt kan läsa om en fil i stället för att bära varje tidigare svar för evigt. Och skjut läsintensivt arbete till subagenter med egen kortlivad kontext, så att de tjugo filer de läser aldrig kommer in i huvudsessionsen alls.
Om du har en veckogräns
Om du betalar en prenumeration med en veckovis användningsgräns i stället för en räkning per token, är detta den hävstång med bäst förhållande mellan insats och effekt som jag har hittat. En rad JSON, ingen ändring i hur du arbetar, och samma gräns sträcker sig mätbart längre. I mitt fall kostade samma veckovolym av promptande 17 % mindre, och de långa sessionerna kostade ungefär hälften.
Läs nästa
Kontextfönster säljs som kapacitet. De beter sig som en löpande mätare, som debiterar varje tur för allt du någonsin har lagt in. Om du vill ha mekaniken bakom detta i stället för bara inställningen, går den kompletterande artikeln igenom vad som faktiskt fyller ett kontextfönster, varför en lång session kostar mycket mer än arbetet den utför, och hur cachning, rensning och kompaktering var för sig ändrar räkneuppgiften.
