


Krátka verzia
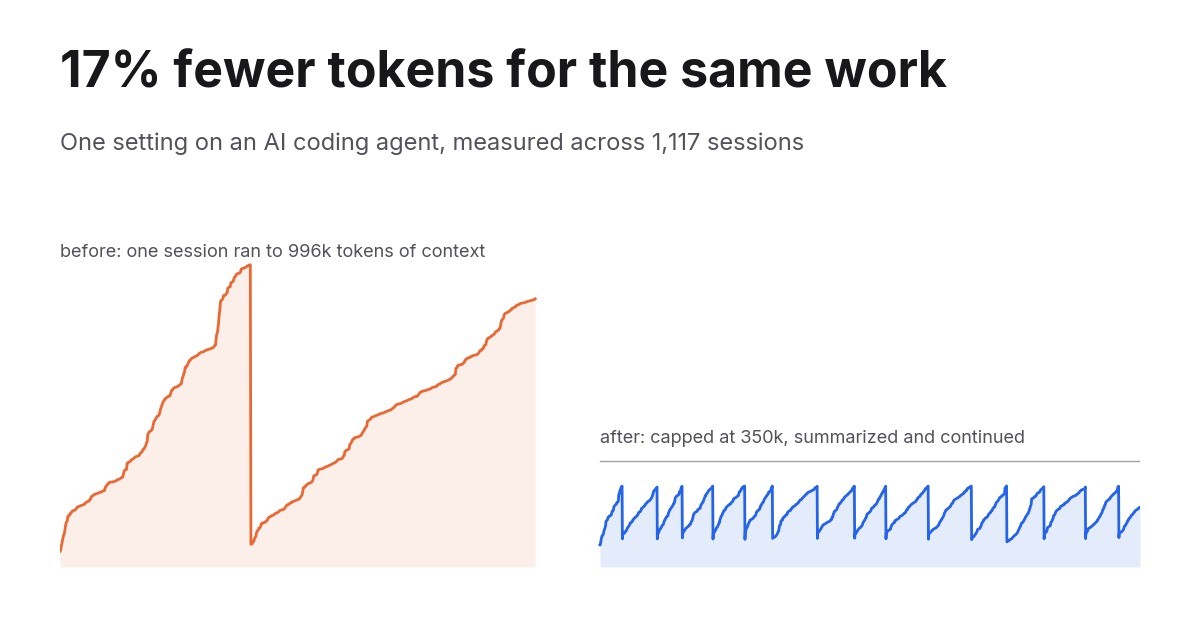
- Celý deň používam AI programovacieho agenta na modeli s kontextovým oknom 1 mil. tokenov. Relácie predtým rástli, až kým ho takmer nenaplnili.
- Do jeho konfigurácie som pridal jeden riadok, ktorý obmedzuje reláciu na 350 000 tokenov kontextu, než sa sama zhrnie a pokračuje.
- Merané na 1 117 záznamoch relácií: o 17 % menej tokenov pri rovnakom počte promptov a v dlhých reláciách, kde sa strop naozaj prejaví, o 55 % menej.
Nižšie je metóda, každý graf a čo vás to na oplátku bude stáť, aby ste sa mohli rozhodnúť, či sa to týka vášho nastavenia.
Prečo okno 1 mil. stojí viac, než sa zdá
Konverzácia s modelom je bezstavová. Každá požiadavka nesie celú históriu: systémový prompt, každú definíciu nástroja, každý súbor, ktorý agent prečítal, každý výsledok nástroja, každú správu. Nie delta. Všetko, zakaždým.
Takže relácia, ktorá narástla na 900 000 tokenov, platí 900 000 tokenov vstupu pri ďalšom volaní a pri tom ďalšom tiež. 400. kolo neurobí viac práce ako 4. kolo. Len stojí mnohonásobne viac.
Cacheovanie promptov to zmierňuje. Tokeny, ktoré model už videl, sa účtujú približne za desatinu bežnej ceny vstupu. Tá zľava je skutočná, je to práve to, čo vôbec robí dlhé relácie životaschopnými, a je aj dôvodom, prečo sa na problém nikto nepozerá. V mojich dátach bolo 98 % všetkých vstupných tokenov čítania z cache. Desatina z veľmi veľkého čísla bola stále najväčšou položkou na účte.
Otázka nie je, či je vaša história v cache. Je, ako veľká sa môže stať, kým ju niečo nevynuluje.

Pripravení rozšíriť svoje podnikanie?
Začnite svoju 30-dňovú skúšobnú verziu ešte dnes a vidzte výsledky behom pár dní.
Čo som zmenil
Agentom je Claude Code, ktorý beží na Opuse s kontextovým oknom 1 mil. Nastavením je autoCompactWindow v ~/.claude/settings.json. Keď relácia dosiahne taký počet tokenov, agent zhrnie konverzáciu a pokračuje zo zhrnutia.
{
  "autoCompactWindow": 350000
}
Nikdy som ho nenastavil, takže relácie bežali, kým sa nepriblížili k plnému oknu. Počas štyroch dní som vyskúšal tri hodnoty:
| Dátum | Nastavenie |
|---|---|
| 14. septembra | 250 000 |
| 15. septembra | 300 000 |
| 18. septembra | 350 000 |
Ako som to meral
Claude Code zapisuje každú reláciu do záznamu JSONL v ~/.claude/projects/, vrátane spotreby tokenov pri každom volaní API. Spracoval som všetkých 1 117 záznamov, pokrývajúcich päť týždňov od 19. augusta do 22. septembra, odstránil duplikáty podľa ID požiadavky a ponechal len interaktívne relácie. Beh v GitHub Actions používa ten istý účet, ale nemôže ho ovplyvniť nastavenie na mojom notebooku, takže je vylúčený.
Surové súčty tokenov sú samy o sebe zavádzajúce. Rušný týždeň porazí pokojný týždeň, nech zmeníte čokoľvek. Preto je každé číslo nižšie vážené podľa cache, čo je to, čo merač naozaj ukazuje: čerstvý vstup za 1x, zápisy do cache za 1,25x (5-minútová cache) alebo 2x (1-hodinová cache), čítania z cache za 0,1x. A každé porovnanie je normalizované podľa vykonanej práce, buď podľa promptov, ktoré som napísal, alebo podľa volaní API, ktoré agent vykonal.
Prihláste sa na newsletter
Získajte najnovšie tipy, trendy a ponuky zadarmo.
Dve relácie, ten istý agent
Toto je mechanizmus na jednom obrázku. Vľavo skutočná relácia z 3. septembra, pred stropom. Vpravo skutočná relácia z 15. septembra, po ňom.
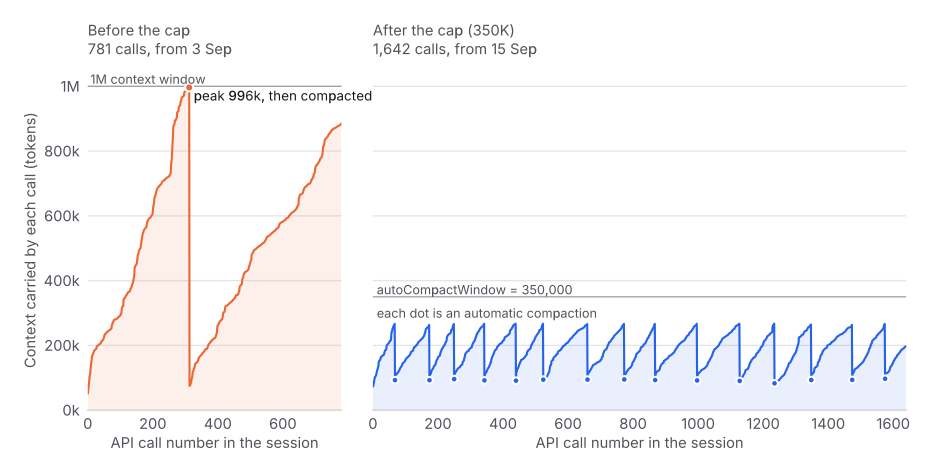
Relácia vľavo bežala 781 volaní. Vystúpila na 996 000 tokenov kontextu, narazila na stenu okna 1 mil., raz sa skompaktovala a potom vystúpila priamo späť na 880 000. V druhej polovici tejto relácie každé jedno volanie znovu prečítalo viac ako pol milióna tokenov.
Relácia vpravo bežala 1 642 volaní, viac ako dvakrát tak dlho, a nikdy nepreniesla viac ako 270 000. Skompaktovala sa pätnásťkrát. Každá kompakcia je bodka.
Týždenné čísla
Iba interaktívne relácie. Stĺpce sú vstupné tokeny vážené podľa cache na volanie API, čo je najspravodlivejšie jednotlivé číslo, pretože nezáleží na tom, koľko som daný týždeň pracoval.
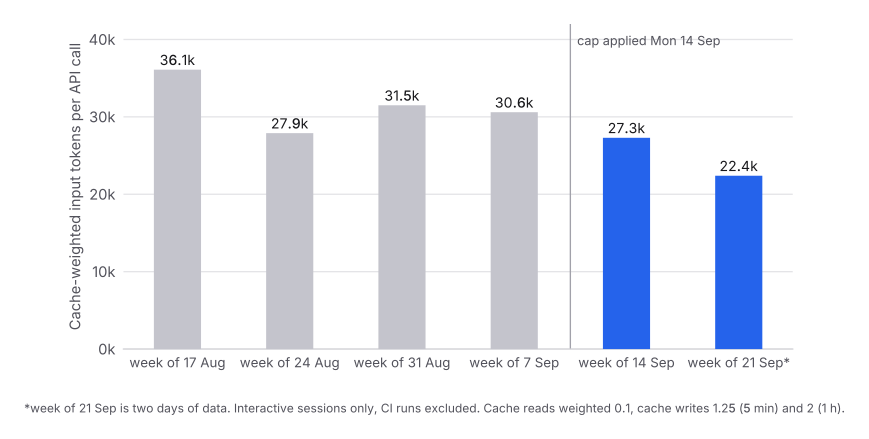
Najčistejšie porovnanie v datasete je týždeň od 7. septembra proti týždňu od 14. septembra, pretože som si ich nevybral. Jednoducho padli na obe strany zmeny a v každom som napísal takmer presne rovnaký počet promptov.
| Týždeň od | Prompty | Volania API | Vstup vážený podľa cache | Na volanie |
|---|---|---|---|---|
| 7. sep | 971 | 11 364 | 348,1 mil. | 30,6 tis. |
| 14. sep | 968 | 10 555 | 288,5 mil. | 27,3 tis. |
971 promptov proti 968. Efektívny vstup klesol z 348,1 mil. na 288,5 mil. To je o 17 % menej pri rovnakom množstve promptovania. Dva dni nasledujúceho týždňa vyšli na 22,4 tis. na volanie, ešte nižšie.
Kam odchádzali peniaze
Rozdeľte každé volanie API podľa toho, koľko kontextu prenášalo, a mechanizmus je viditeľný priamo.
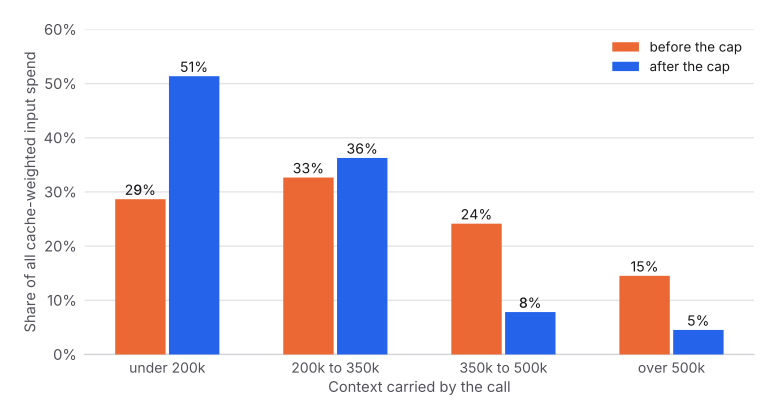
Pred stropom 39 % všetkého, čo som minul, šlo na volania, ktoré za sebou ťahali viac ako 350 000 tokenov histórie. Tie volania nerobili viac práce ako ostatné. Bola to tá istá práca, len s väčšou batožinou. Po zavedení stropu je tento podiel 12 %.
Vydržal strop
Jedna bodka na reláciu, umiestnená pri najväčšom kontexte, ktorý relácia kedy prenášala.
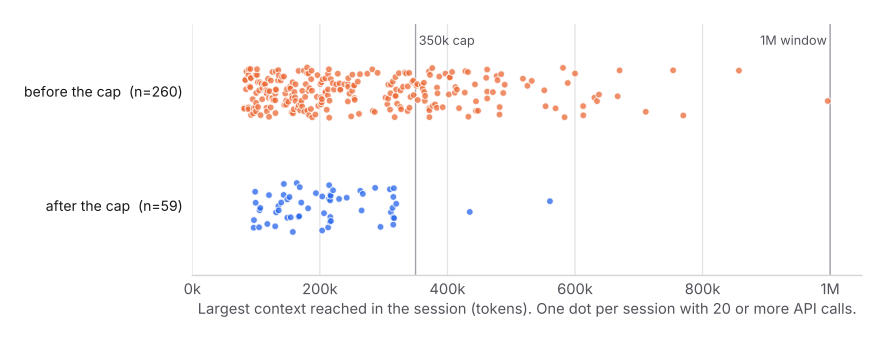
Dve relácie v prvých dvoch dňoch stále bežali za stropom, na 434 000 a 561 000, a nezistil som prečo. Odkedy bolo 18. septembra nasadené nastavenie 350 000, žiadna relácia ho neprekročila. Chvost relácií žijúcich medzi 500 tis. a 1 mil., kde bolo najviac plytvania, je preč.
Čo by to stálo bez stropu
Aby som k tomu priradil súčet, prehral som každú reláciu, ktorá sa začala po zmene, akoby vypustený kontext nebol nikdy zhrnutý a stále sa znovu čítal pri každom ďalšom volaní, ohraničený oknom 1 mil.
| Vstup vážený podľa cache | |
|---|---|
| Skutočnosť, 73 relácií, 9 675 volaní, 55 kompakcií | 216,8 mil. |
| Tie isté relácie bez stropu | 479,2 mil. |
| Ušetrené | 262,5 mil., čiže 55 % |
Relácia vpravo na prvom grafe predstavuje z toho 118,5 mil. sama o sebe. Dlhý refaktoring, ktorý by inak strávil svojich posledných niekoľko stoviek volaní opätovným čítaním takmer milióna tokenov pri každom z nich.
Berte 55 % ako optimistický koniec. Bez stropu by som naozaj nenechal reláciu mlieť na 900 tis. celé hodiny; nakoniec by som ju vyčistil ručne, čo tiež resetuje náklady. Konzervatívny koniec je pozorovaná hodnota na volanie, z 30,6 tis. na 22,4 tis., teda zhruba 20 % až 27 %. Pravda je niekde medzi tými dvoma.
Čo vás to stojí
Nie je to zadarmo a každý, kto to odporúča, by to mal povedať.
Čakanie. 67 kompakcií od zmeny, s mediánom približne tri minúty každá. Zhruba 3,4 hodiny sledovania, ako sa píše zhrnutie, rozložené na osem dní.
Nejaká práca navyše. Kompakcia toho veľa vypustí. Pri nastavení 350 tis. vzala mediánová kompakcia reláciu s 318 000 tokenmi na 24 000. Agent stratí detaily a niekedy ich znovu skladá: súbory znovu prečítané v tej istej relácii vzrástli z 11,5 % čítaní pred prvou kompakciou na 20,5 % po nej. Vzorka za tým druhým číslom je malá, takže to čítajte ako smer, nie ako meranie.
Voľba prahu je dôležitá. Pri 250 tis. narazilo na kompakciu 36 % mojich dlhých relácií. Pri 350 tis. to bolo 12 %, pričom strop stále držal. Nastavte ho príliš nízko a za už uloženú úsporu zaplatíte tri minúty a prácu navyše opakovane.
Ako to nastaviť
Claude Code. Pridajte autoCompactWindow do ~/.claude/settings.json. Na modeli s kontextom 1 mil. bola 350 000 najlepšia z troch hodnôt, ktoré som vyskúšal. Na modeli s oknom 200 tis. to znížte a začnite okolo 120 000 až 140 000. Nové relácie to prevezmú; už bežiaca relácia si ponechá starú hodnotu.
Iní agenti. Hľadajte tú istú myšlienku pod iným názvom: spúšťač kompakcie, limit kontextu, prah zhrň-a-pokračuj. Ak tam žiadny nie je, manuálna verzia znamená čistiť reláciu častejšie, než sa zdá prirodzené. Inštinkt udržiavať jednu dlhú reláciu nažive celý deň, pretože „pozná projekt", je ten drahý.
Nech používate čokoľvek, dva návyky urobia viac než akékoľvek nastavenie. Udržujte trvalý stav v súboroch a nie v konverzácii, aby agent mohol lacno znovu prečítať jeden súbor namiesto toho, aby navždy nosil každú predchádzajúcu odpoveď. A presuňte na čítanie náročnú prácu na subagentov s vlastným krátkodobým kontextom, aby tých dvadsať súborov, ktoré prečítajú, nikdy nevstúpilo do hlavnej relácie.
Ak máte týždenný limit
Ak platíte predplatné s týždenným limitom využitia namiesto účtu za token, toto je páka s najlepším pomerom úsilia k účinku, akú som našiel. Jeden riadok JSON, žiadna zmena v tom, ako pracujete, a ten istý limit sa merateľne natiahne ďalej. V mojom prípade to isté týždenné množstvo promptovania stálo o 17 % menej a dlhé relácie približne polovicu.
Čítajte ďalej
Kontextové okná sa predávajú ako kapacita. Správajú sa ako bežiaci merač, ktorý účtuje pri každom kole za všetko, čo ste kedy vložili. Ak chcete mechaniku za týmto a nielen nastavenie, sprievodný článok prechádza tým, čo vlastne napĺňa kontextové okno, prečo dlhá relácia stojí oveľa viac než práca, ktorú vykoná, a ako cacheovanie, čistenie a kompakcia každé menia aritmetiku.
