


Kortversjonen
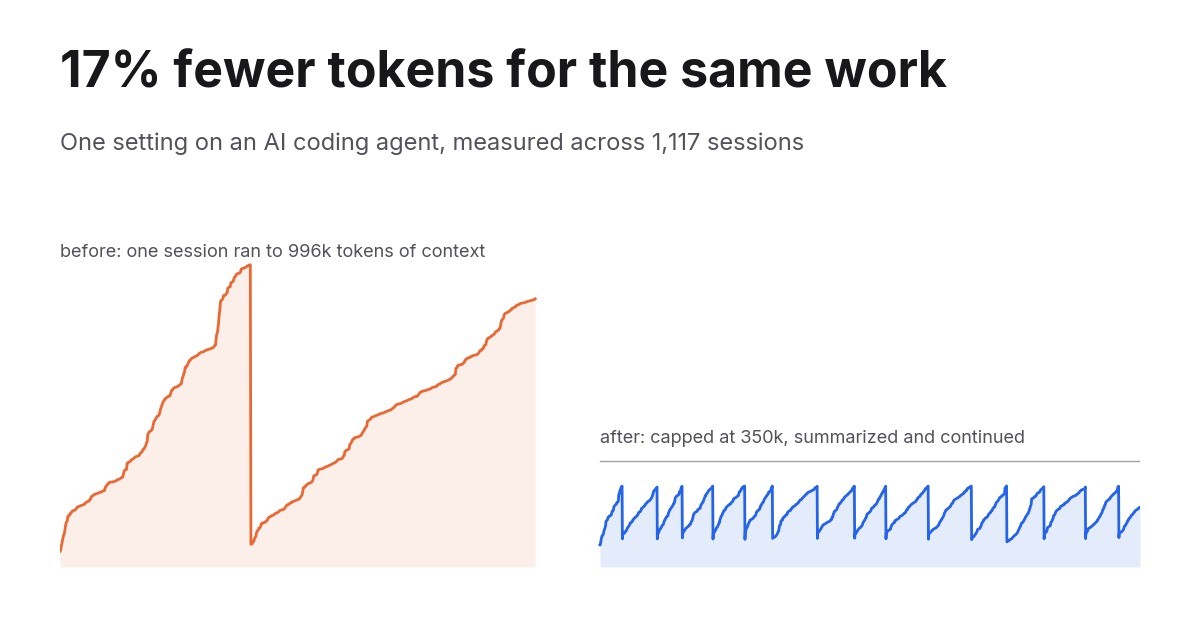
- Jeg kjører en AI-kodeagent hele dagen på en modell med et kontekstvindu på 1M tokens. Sesjonene vokste før helt til de nesten fylte det.
- Jeg la til én linje i konfigurasjonen, som begrenser en sesjon til 350,000 tokens med kontekst før den oppsummerer seg selv og fortsetter.
- Målt på tvers av 1,117 sesjonstranskripsjoner: 17 % færre tokens for samme antall prompter, og i de lange sesjonene der begrensningen faktisk slår inn, 55 % færre.
Nedenfor er metoden, hvert diagram, og hva det koster deg til gjengjeld, slik at du kan avgjøre om det gjelder ditt oppsett.
Hvorfor et vindu på 1M koster mer enn det ser ut
En samtale med en modell er tilstandsløs. Hver forespørsel bærer hele historikken: systemprompten, hver verktøydefinisjon, hver fil agenten har lest, hvert verktøyresultat, hver melding. Ikke en delta. Alt sammen, hver gang.
Så en sesjon som har vokst til 900,000 tokens betaler for 900,000 tokens med input ved neste kall, og ved kallet etter der. Runde 400 gjør ikke mer arbeid enn runde 4. Den koster bare mange ganger mer.
Prompt-caching myker opp dette. Tokens modellen har sett før, faktureres til omtrent en tidel av normal inputpris. Den rabatten er reell, den er det som gjør lange sesjoner mulige i det hele tatt, og den er også grunnen til at ingen ser på problemet. I mine data var 98 % av alle input-tokens cache-lesinger. En tidel av et veldig stort tall var fortsatt den største posten på regningen.
Spørsmålet er ikke om historikken din er cachet. Det er hvor stor den får lov til å bli før noe nullstiller den.

Klar til å vokse bedriften din?
Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
Hva jeg endret
Agenten er Claude Code som kjører Opus på 1M-kontekstvinduet. Innstillingen er autoCompactWindow i ~/.claude/settings.json. Når en sesjon når så mange tokens, oppsummerer agenten samtalen og fortsetter fra oppsummeringen.
{
  "autoCompactWindow": 350000
}
Jeg hadde aldri satt den, så sesjonene kjørte til de nærmet seg det fulle vinduet. Over fire dager prøvde jeg tre verdier:
| Dato | Innstilling |
|---|---|
| 14. september | 250,000 |
| 15. september | 300,000 |
| 18. september | 350,000 |
Hvordan jeg målte det
Claude Code skriver hver sesjon til en JSONL-transkripsjon under ~/.claude/projects/, inkludert tokenbruken for hvert API-kall. Jeg parset alle 1,117 av dem, som dekker fem uker fra 19. august til 22. september, dedupliserte på forespørsels-ID og beholdt bare interaktive sesjoner. Kjøringer i GitHub Actions bruker samme konto, men kan ikke påvirkes av en innstilling på laptopen min, så de er utelatt.
Rå token-totaler er misvisende alene. En travel uke slår en rolig uke uansett hva du endrer. Så hvert tall nedenfor er cache-vektet, som er det måleren faktisk leser: fersk input til 1x, cache-skrivinger til 1,25x (5-minutters cache) eller 2x (1-times cache), cache-lesinger til 0,1x. Og hver sammenligning er normalisert etter utført arbeid, enten promptene jeg skrev, eller API-kallene agenten gjorde.
Bli med i vårt nyhetsbrev
Få de siste tipsene, trendene og tilbudene gratis.
To sesjoner, samme agent
Dette er mekanismen i ett bilde. Til venstre en reell sesjon fra 3. september, før begrensningen. Til høyre en reell sesjon fra 15. september, etter.
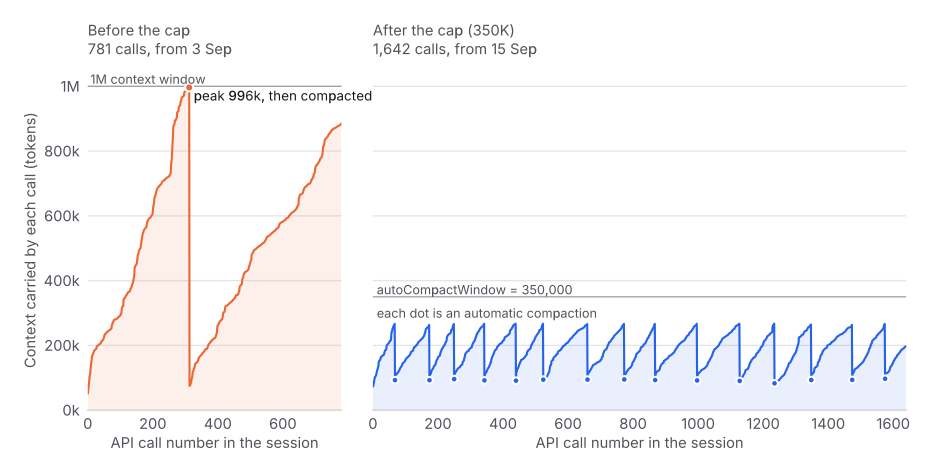
Sesjonen til venstre kjørte i 781 kall. Den klatret til 996,000 tokens med kontekst, traff veggen i 1M-vinduet, kompakterte én gang, og klatret deretter rett tilbake til 880,000. I andre halvdel av den sesjonen leste hvert eneste kall på nytt over en halv million tokens.
Sesjonen til høyre kjørte i 1,642 kall, mer enn dobbelt så lenge, og bar aldri mer enn 270,000. Den kompakterte femten ganger. Hver kompaktering er en prikk.
Tallene per uke
Bare interaktive sesjoner. Søylene er cache-vektede input-tokens per API-kall, som er det enkelt-tallet som er mest rettferdig, fordi det ikke bryr seg om hvor mye jeg jobbet i en gitt uke.
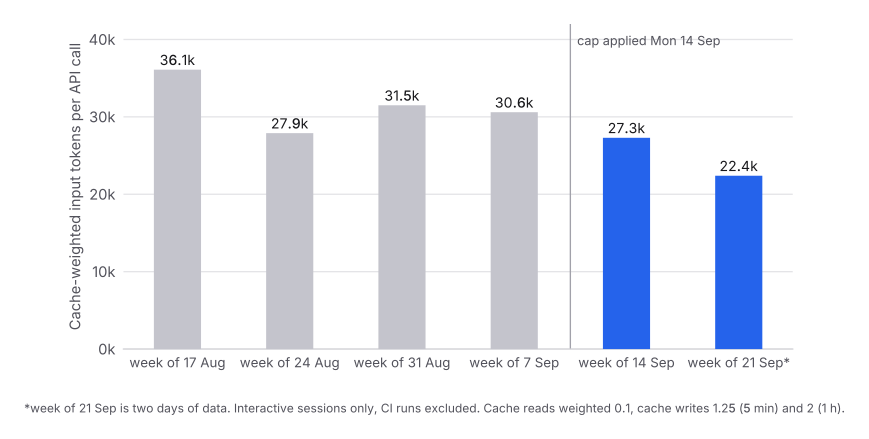
Den reneste sammenligningen i datasettet er uken fra 7. september mot uken fra 14. september, fordi jeg ikke valgte dem. De havnet rett og slett på hver sin side av endringen, og jeg skrev nesten nøyaktig like mange prompter i hver av dem.
| Uke fra | Prompter | API-kall | Cache-vektet input | Per kall |
|---|---|---|---|---|
| 7. sep | 971 | 11,364 | 348.1M | 30.6k |
| 14. sep | 968 | 10,555 | 288.5M | 27.3k |
971 prompter mot 968. Effektiv input ned fra 348.1M til 288.5M. Det er 17 % mindre for samme mengde prompting. De to dagene i den følgende uken kom inn på 22.4k per kall, enda lavere.
Hvor pengene gikk
Del hvert API-kall etter hvor mye kontekst det bar, og mekanismen blir synlig direkte.
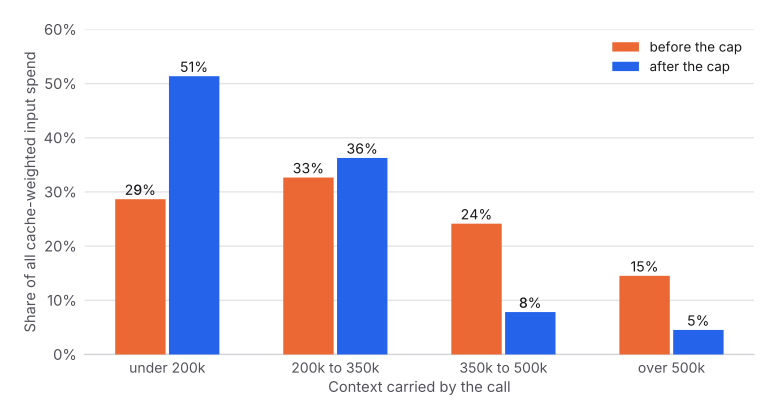
Før begrensningen gikk 39 % av alt jeg brukte, til kall som slepte med seg mer enn 350,000 tokens med historikk. Disse kallene gjorde ikke mer arbeid enn de andre. Det var samme arbeid, med mer bagasje. Etter begrensningen er den andelen 12 %.
Holdt taket?
Én prikk per sesjon, plassert ved den største konteksten sesjonen noen gang bar.
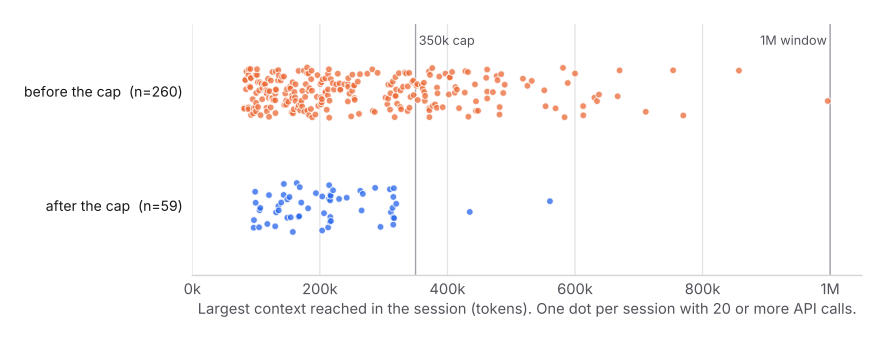
To sesjoner de to første dagene kjørte fortsatt forbi begrensningen, til 434,000 og 561,000, og jeg fant ikke ut hvorfor. Siden innstillingen på 350,000 ble satt inn 18. september, har ingen sesjon overskredet den. Halen av sesjoner som levde mellom 500k og 1M, som er der mesteparten av sløseriet lå, er borte.
Hva det ville ha kostet uten begrensningen
For å sette en total på det spilte jeg av hver sesjon som startet etter endringen, som om den droppede konteksten aldri var blitt oppsummert og fortsatt ble lest på nytt ved hvert senere kall, begrenset til 1M-vinduet.
| Cache-vektet input | |
|---|---|
| Faktisk, 73 sesjoner, 9,675 kall, 55 kompakteringer | 216.8M |
| Samme sesjoner uten begrensningen | 479.2M |
| Unngått | 262.5M, eller 55 % |
Sesjonen til høyre i det første diagrammet står alene for 118.5M av dette. En lang refaktorering som ellers ville ha brukt sine siste flere hundre kall på å lese nesten en million tokens på nytt hver gang.
Behandle 55 % som den optimistiske enden. Uten begrensningen ville jeg egentlig ikke latt en sesjon male på 900k i timevis; til slutt ville jeg ha tømt den manuelt, noe som også nullstiller kostnaden. Den konservative enden er det observerte tallet per kall, 30.6k ned til 22.4k, altså omtrent 20 % til 27 %. Sannheten ligger et sted mellom disse to.
Hva det koster deg
Dette er ikke gratis, og alle som anbefaler det, bør si det.
Venting. 67 kompakteringer siden endringen, med en median på rundt tre minutter hver. Omtrent 3,4 timer med å se på at en oppsummering blir skrevet, spredt over åtte dager.
Litt omarbeid. Kompaktering dropper mye. Ved innstillingen på 350K tok median-kompakteringen en sesjon på 318,000 tokens ned til 24,000. Agenten mister detaljer og bygger dem noen ganger opp igjen: filer som leses på nytt i samme sesjon, gikk fra 11,5 % av lesingene før den første kompakteringen til 20,5 % etter. Utvalget bak det andre tallet er lite, så les det som en retning snarere enn en måling.
Valg av terskel betyr noe. Ved 250K traff 36 % av mine lange sesjoner en kompaktering. Ved 350K gjorde 12 % det, samtidig som taket fortsatt holdt. Setter du den for lavt, betaler du de tre minuttene og omarbeidet gang på gang for en besparelse du allerede hadde sikret deg.
Hvordan sette det opp
Claude Code. Legg til autoCompactWindow i ~/.claude/settings.json. På en modell med 1M-kontekst var 350,000 den beste av de tre verdiene jeg prøvde. På en 200K-modell skalerer du ned og starter rundt 120,000 til 140,000. Nye sesjoner tar den i bruk; en sesjon som allerede kjører, beholder den gamle verdien.
Andre agenter. Se etter den samme ideen under et annet navn: en kompakteringstrigger, en kontekstgrense, en terskel for å oppsummere og fortsette. Finnes det ingen, er den manuelle versjonen å tømme sesjonen oftere enn det føles naturlig. Instinktet om å holde én lang sesjon i live hele dagen fordi den «kjenner prosjektet», er det dyre.
Uansett hva du bruker, gjør to vaner mer enn noen innstilling. Hold varig tilstand i filer i stedet for i samtalen, slik at agenten kan lese én fil billig på nytt i stedet for å bære hvert tidligere svar for alltid. Og skyv lesetungt arbeid til subagenter med sin egen kortlivede kontekst, slik at de tjue filene de leser, aldri kommer inn i hovedsesjonen i det hele tatt.
Hvis du har en ukentlig grense
Hvis du betaler et abonnement med ukentlig bruksgrense i stedet for en regning per token, er dette den spaken med det beste forholdet mellom innsats og effekt jeg har funnet. Én linje JSON, ingen endring i hvordan du jobber, og samme grense strekker seg målbart lenger. I mitt tilfelle kostet samme ukentlige promptvolum 17 % mindre, og de lange sesjonene kostet omtrent halvparten.
Les videre
Kontekstvinduer selges som kapasitet. De oppfører seg som en løpende måler, som belaster deg ved hver runde for alt du noen gang har lagt inn. Hvis du vil ha mekanikken bak dette i stedet for bare innstillingen, går følgeartikkelen gjennom hva som faktisk fyller et kontekstvindu, hvorfor en lang sesjon koster langt mer enn arbeidet den utfører, og hvordan caching, tømming og kompaktering hver for seg endrer regnestykket.
