


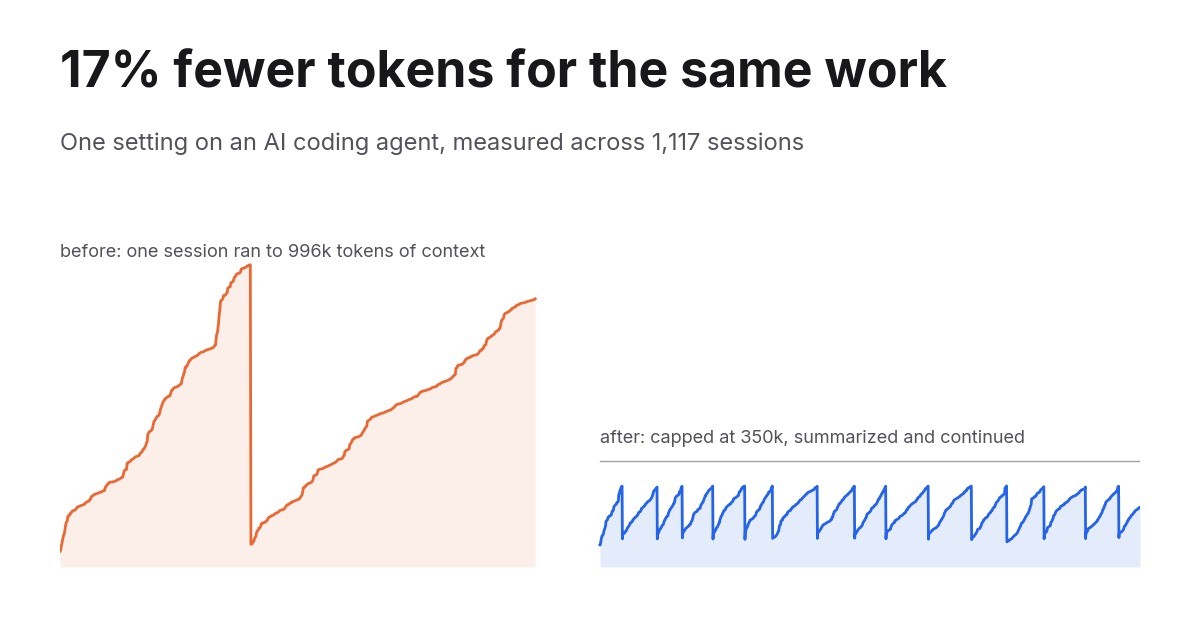
짧은 요약
- 저는 1M 토큰 컨텍스트 윈도우를 가진 모델에서 하루 종일 AI 코딩 에이전트를 사용합니다. 예전에는 세션이 윈도우를 거의 가득 채울 때까지 커졌습니다.
- 설정에 한 줄을 추가해, 세션이 스스로 요약하고 이어서 진행하기 전까지의 컨텍스트를 350,000 토큰으로 제한했습니다.
- 1,117개의 세션 트랜스크립트를 측정한 결과: 같은 프롬프트 수에 토큰은 17% 감소, 상한이 실제로 작동한 긴 세션에서는 55% 감소했습니다.
아래에는 방법, 모든 차트, 그리고 그 대가로 무엇을 지불하게 되는지를 정리했습니다. 자신의 환경에 적용할지 판단하는 데 참고하세요.
1M 윈도우는 보이는 것보다 더 비싸다
모델과의 대화는 상태를 저장하지 않습니다. 모든 요청이 전체 기록을 함께 보냅니다. 시스템 프롬프트, 모든 도구 정의, 에이전트가 읽은 모든 파일, 모든 도구 결과, 모든 메시지까지. 델타가 아닙니다. 매번 전부입니다.
그래서 900,000 토큰까지 커진 세션은 다음 호출에서 900,000 토큰의 입력 비용을 지불하고, 그다음 호출에서도 그렇습니다. 400번째 턴은 4번째 턴보다 더 많은 일을 하지 않습니다. 다만 몇 배 더 비쌀 뿐입니다.
프롬프트 캐싱이 이를 완화합니다. 모델이 이미 본 토큰은 일반 입력 가격의 약 10분의 1로 청구됩니다. 이 할인은 실제이며, 긴 세션을 애초에 가능하게 만드는 요소이고, 동시에 아무도 이 문제를 들여다보지 않는 이유이기도 합니다. 제 데이터에서는 모든 입력 토큰의 98%가 캐시 읽기였습니다. 아주 큰 수의 10분의 1도 여전히 청구서에서 가장 큰 항목이었습니다.
문제는 기록이 캐시되는지 여부가 아닙니다. 무언가가 그것을 리셋하기 전까지 얼마나 커질 수 있게 두느냐입니다.
제가 바꾼 것
에이전트는 1M 컨텍스트 윈도우에서 Opus를 실행하는 Claude Code입니다. 설정은 ~/.claude/settings.json의 autoCompactWindow입니다. 세션이 해당 토큰 수에 도달하면 에이전트가 대화를 요약하고 그 요약에서 이어서 진행합니다.
{
  "autoCompactWindow": 350000
}
그동안 한 번도 설정한 적이 없어서 세션은 전체 윈도우에 근접할 때까지 실행되었습니다. 나흘에 걸쳐 세 가지 값을 시도했습니다.
| 날짜 | 설정 |
|---|---|
| 9월 14일 | 250,000 |
| 9월 15일 | 300,000 |
| 9월 18일 | 350,000 |
측정 방법
Claude Code는 모든 세션을 ~/.claude/projects/ 아래의 JSONL 트랜스크립트로 기록하며, 각 API 호출의 토큰 사용량도 포함합니다. 저는 8월 19일부터 9월 22일까지 5주에 걸친 1,117개 트랜스크립트를 모두 파싱하고, 요청 ID 기준으로 중복을 제거했으며, 대화형 세션만 남겼습니다. GitHub Actions에서의 실행은 같은 계정을 사용하지만 제 노트북의 설정에 영향을 받을 수 없으므로 제외했습니다.
원시 토큰 합계는 그 자체로는 오해를 부릅니다. 무엇을 바꾸든 바쁜 주가 한가한 주를 이깁니다. 그래서 아래의 모든 숫자는 캐시 가중치를 적용했으며, 이는 미터기가 실제로 읽는 값입니다. 신규 입력 1x, 캐시 쓰기 1.25x(5분 캐시) 또는 2x(1시간 캐시), 캐시 읽기 0.1x입니다. 그리고 모든 비교는 수행한 작업량, 즉 제가 입력한 프롬프트나 에이전트가 수행한 API 호출 수로 정규화했습니다.

뉴스레터 가입
최신 팁, 트렌드 및 특가 정보를 무료로 받아보세요.
두 개의 세션, 같은 에이전트
이것이 이 메커니즘을 한 장으로 보여줍니다. 왼쪽은 상한을 두기 전인 9월 3일의 실제 세션입니다. 오른쪽은 상한을 둔 뒤인 9월 15일의 실제 세션입니다.
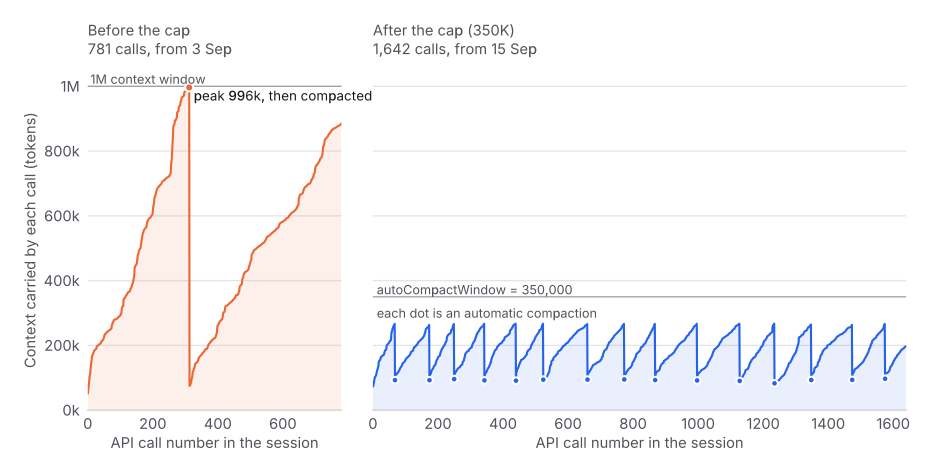
왼쪽 세션은 781번의 호출 동안 실행되었습니다. 컨텍스트가 996,000 토큰까지 올라가 1M 윈도우의 벽에 부딪혔고, 한 번 압축된 뒤 곧바로 880,000까지 다시 올라갔습니다. 그 세션의 후반부 동안에는 매 호출마다 50만 토큰이 넘는 내용을 다시 읽었습니다.
오른쪽 세션은 1,642번의 호출 동안 실행되었습니다. 두 배 이상 긴 세션이었지만 컨텍스트가 270,000을 넘지 않았습니다. 열다섯 번 압축했습니다. 압축 하나하나가 점 하나입니다.
주간 숫자
대화형 세션만 포함했습니다. 막대는 API 호출당 캐시 가중 입력 토큰이며, 특정 주에 제가 얼마나 일했는지에 좌우되지 않으므로 가장 공정한 단일 지표입니다.
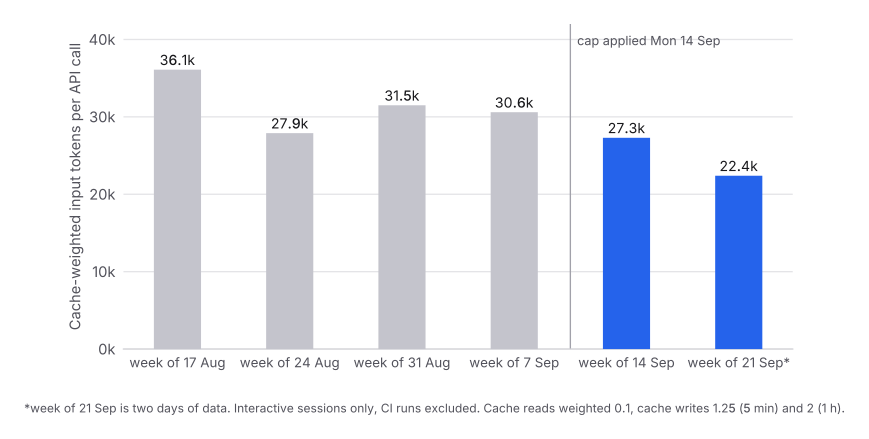
데이터셋에서 가장 깔끔한 비교는 9월 7일 주와 9월 14일 주입니다. 제가 고른 주가 아니기 때문입니다. 두 주가 우연히 변경 지점 양쪽에 놓였고, 두 주에 입력한 프롬프트 수가 거의 정확히 같았습니다.
| 주 | 프롬프트 | API 호출 | 캐시 가중 입력 | 호출당 |
|---|---|---|---|---|
| 9월 7일 | 971 | 11,364 | 348.1M | 30.6k |
| 9월 14일 | 968 | 10,555 | 288.5M | 27.3k |
프롬프트는 971개 대 968개. 유효 입력은 348.1M에서 288.5M로 줄었습니다. 같은 양의 프롬프트로 17%가 줄어든 것입니다. 그다음 주 이틀은 호출당 22.4k로 더 낮았습니다.
돈이 어디로 가고 있었나
모든 API 호출을 얼마나 많은 컨텍스트를 지녔는지에 따라 나누면 메커니즘이 직접 보입니다.
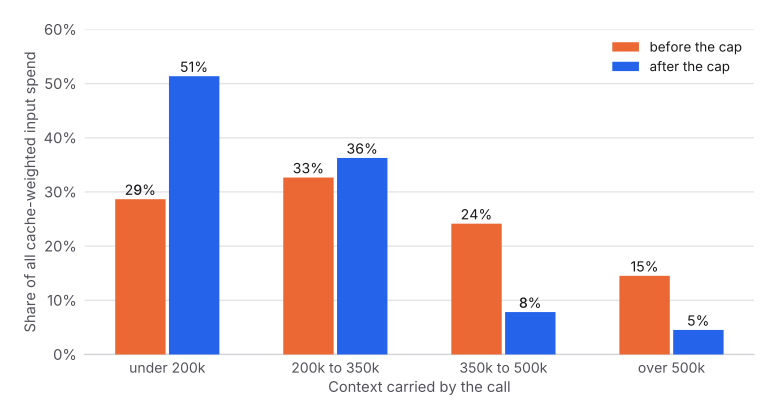
상한 이전에는 제가 쓴 모든 비용의 39%가 350,000 토큰이 넘는 기록을 끌고 다닌 호출에 들어갔습니다. 그 호출들은 다른 호출보다 더 많은 일을 하지 않았습니다. 같은 일을 하면서 더 많은 짐을 지고 있었을 뿐입니다. 상한 이후 그 비중은 12%입니다.
상한이 유지되었나
세션마다 점 하나를, 그 세션이 지닌 가장 큰 컨텍스트 위치에 놓았습니다.
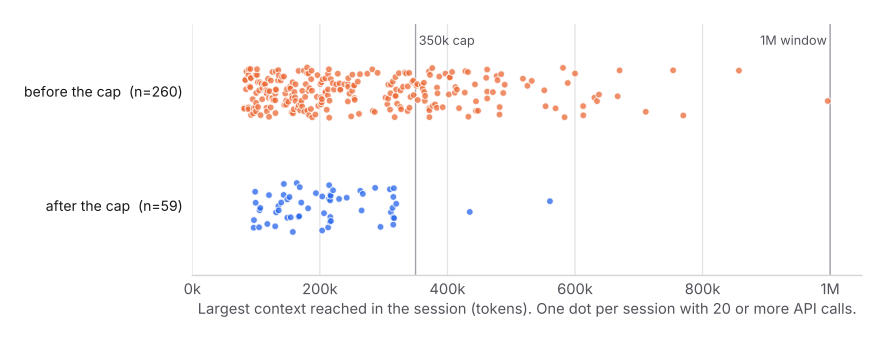
첫 이틀의 두 세션은 여전히 상한을 넘어 434,000과 561,000까지 실행되었고, 저는 그 이유를 밝혀내지 못했습니다. 9월 18일 350,000 설정을 넣은 이후로는 어떤 세션도 이를 넘지 않았습니다. 낭비의 대부분이 있던 500k에서 1M 사이에 머무는 세션들의 꼬리는 사라졌습니다.
상한이 없었다면 얼마가 들었을까
총액을 내기 위해, 변경 이후 시작된 모든 세션을 마치 삭제된 컨텍스트가 요약된 적이 없어 이후 모든 호출에서 계속 다시 읽히는 것처럼, 1M 윈도우를 상한으로 두고 재생했습니다.
| 캐시 가중 입력 | |
|---|---|
| 실제, 73개 세션, 9,675회 호출, 55회 압축 | 216.8M |
| 상한 없이 같은 세션 | 479.2M |
| 절약 | 262.5M, 즉 55% |
첫 번째 차트 오른쪽의 세션이 그중 118.5M를 혼자 차지합니다. 그렇지 않았다면 마지막 수백 번의 호출 동안 매번 거의 100만 토큰을 다시 읽는 데 썼을 긴 리팩터링입니다.
55%는 낙관적인 쪽으로 보세요. 상한이 없었다면 저도 세션이 몇 시간 동안 900k에서 맴돌게 두지 않았을 것입니다. 결국 손으로 비웠을 것이고, 그것 역시 비용을 리셋합니다. 보수적인 쪽은 관측된 호출당 수치인 30.6k에서 22.4k로의 감소이므로 대략 20%에서 27%입니다. 진실은 그 둘 사이 어딘가에 있습니다.
대가로 지불하는 것
이것은 공짜가 아니며, 누구든 이걸 권한다면 그 점을 말해야 합니다.
대기 시간. 변경 이후 압축 67회, 각각 중앙값 약 3분입니다. 8일에 걸쳐 대략 3.4시간을 요약이 작성되는 것을 지켜본 셈입니다.
약간의 재작업. 압축은 많은 것을 버립니다. 350K 설정에서 중앙값 기준 압축은 318,000 토큰 세션을 24,000으로 줄였습니다. 에이전트는 세부 사항을 잃고 때로는 그것을 다시 만들어냅니다. 같은 세션 안에서 다시 읽은 파일의 비율이 첫 압축 이전 11.5%에서 이후 20.5%로 올라갔습니다. 두 번째 수치의 표본은 작으므로 측정값이라기보다 방향으로 읽으세요.
임계값 선택이 중요합니다. 250K에서는 긴 세션의 36%가 압축에 도달했습니다. 350K에서는 12%가 도달했고 상한은 여전히 유지되었습니다. 너무 낮게 잡으면 이미 확보한 절감을 위해 3분과 재작업을 반복적으로 지불하게 됩니다.
설정 방법
Claude Code. ~/.claude/settings.json에 autoCompactWindow를 추가하세요. 1M 컨텍스트 모델에서는 제가 시도한 세 값 중 350,000이 가장 좋았습니다. 200K 모델에서는 그에 맞게 낮춰 120,000에서 140,000 사이로 시작하세요. 새 세션은 이 값을 가져가고, 이미 실행 중인 세션은 예전 값을 유지합니다.
다른 에이전트. 같은 아이디어를 다른 이름으로 찾아보세요. 압축 트리거, 컨텍스트 한도, 요약 후 계속하기 임계값 같은 것입니다. 없다면 수동 버전은 세션을 자연스럽게 느껴지는 것보다 더 자주 비우는 것입니다. “프로젝트를 알고 있다"는 이유로 긴 세션 하나를 하루 종일 살려두려는 본능이 바로 비싼 본능입니다.
무엇을 쓰든, 두 가지 습관이 어떤 설정보다 더 많은 일을 합니다. 오래 유지할 상태는 대화가 아니라 파일에 두어, 에이전트가 이전의 모든 답변을 영원히 끌고 다니는 대신 파일 하나를 저렴하게 다시 읽을 수 있게 하세요. 그리고 읽기 위주의 작업은 자체적인 짧은 컨텍스트를 가진 서브에이전트로 넘겨, 그들이 읽는 스무 개의 파일이 메인 세션에 아예 들어오지 않게 하세요.
주간 한도를 사용 중이라면
토큰당 청구서가 아니라 주간 사용 한도가 있는 구독을 지불한다면, 이것은 제가 찾은 것 중 노력 대비 효과가 가장 좋은 지렛대입니다. JSON 한 줄, 작업 방식의 변화 없음, 그리고 같은 한도가 측정 가능할 만큼 더 오래 갑니다. 제 경우 같은 주간 프롬프트 양의 비용이 17% 줄었고, 긴 세션의 비용은 약 절반이 되었습니다.
다음 글
컨텍스트 윈도우는 용량처럼 팔립니다. 하지만 그것은 매 턴마다 지금까지 넣은 모든 것에 대해 요금이 부과되는 계량기처럼 동작합니다. 설정만이 아니라 그 뒤의 원리가 궁금하다면, 함께 보는 글 에서 컨텍스트 윈도우를 실제로 채우는 것이 무엇인지, 긴 세션이 하는 일에 비해 훨씬 더 비싼 이유는 무엇인지, 그리고 캐싱·비우기·압축이 각각 그 계산을 어떻게 바꾸는지 살펴봅니다.
