


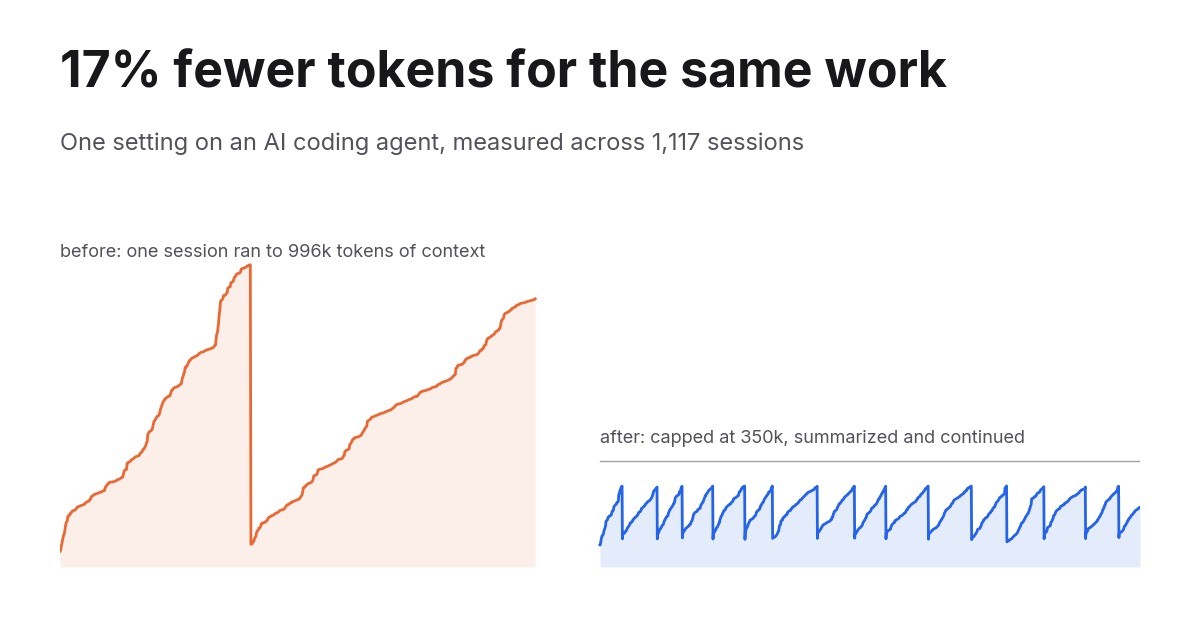
W skrócie
- Cały dzień pracuję z agentem AI do kodowania na modelu z oknem kontekstu 1 mln tokenów. Sesje rosły, aż niemal je zapełniały.
- Dodałem jedną linijkę do jego konfiguracji, ograniczając sesję do 350 000 tokenów kontekstu, zanim sama się podsumuje i będzie kontynuować.
- Zmierzone na 1117 transkryptach sesji: 17% mniej tokenów przy tej samej liczbie promptów, a w długich sesjach, w których limit faktycznie działa, 55% mniej.
Poniżej metoda, każdy wykres i to, ile cię to kosztuje w zamian — żebyś mógł zdecydować, czy dotyczy to twojej konfiguracji.
Dlaczego okno 1M kosztuje więcej, niż wygląda
Rozmowa z modelem jest bezstanowa. Każde żądanie niesie całą historię: prompt systemowy, każdą definicję narzędzia, każdy plik, który agent przeczytał, każdy wynik narzędzia, każdą wiadomość. Nie deltę. Wszystko, za każdym razem.
Więc sesja, która urosła do 900 000 tokenów, płaci za 900 000 tokenów wejścia przy następnym wywołaniu i przy kolejnym. Tura 400 nie wykonuje więcej pracy niż tura 4. Po prostu kosztuje wielokrotnie więcej.
Buforowanie promptów to łagodzi. Tokeny, które model już widział, są rozliczane po około jednej dziesiątej normalnej ceny wejścia. Ta zniżka jest realna, to ona w ogóle czyni długie sesje opłacalnymi, i to także dlatego nikt nie patrzy na ten problem. W moich danych 98% wszystkich tokenów wejściowych to odczyty z pamięci podręcznej. Jedna dziesiąta bardzo dużej liczby wciąż była największą pozycją na rachunku.
Pytanie nie brzmi, czy twoja historia jest buforowana. Brzmi, jak duża może urosnąć, zanim coś ją zresetuje.

Gotowy na rozwój swojej firmy?
Rozpocznij bezpłatny okres próbny już dziś i zobacz rezultaty w ciągu kilku dni.
Co zmieniłem
Agent to Claude Code z modelem Opus na oknie kontekstu 1M. Ustawienie to autoCompactWindow w ~/.claude/settings.json. Gdy sesja osiągnie tyle tokenów, agent podsumowuje rozmowę i kontynuuje od podsumowania.
{
  "autoCompactWindow": 350000
}
Nigdy go nie ustawiałem, więc sesje biegły, aż zbliżały się do pełnego okna. Przez cztery dni testowałem trzy wartości:
| Data | Ustawienie |
|---|---|
| 14 września | 250 000 |
| 15 września | 300 000 |
| 18 września | 350 000 |
Jak to mierzyłem
Claude Code zapisuje każdą sesję do transkryptu JSONL w ~/.claude/projects/, w tym zużycie tokenów każdego wywołania API. Przeanalizowałem wszystkie 1117 z nich, obejmujących pięć tygodni od 19 sierpnia do 22 września, zdeduplikowałem po ID żądania i zostawiłem tylko sesje interaktywne. Uruchomienia w GitHub Actions korzystają z tego samego konta, ale nie może na nie wpłynąć ustawienie na moim laptopie, więc są wykluczone.
Surowe sumy tokenów są same w sobie mylące. Pracowity tydzień bije spokojny tydzień, cokolwiek zmienisz. Dlatego każda liczba poniżej jest ważona buforowaniem, czyli tym, co faktycznie pokazuje licznik: świeże wejście po 1x, zapisy do pamięci podręcznej po 1,25x (pamięć 5-minutowa) lub 2x (pamięć 1-godzinna), odczyty z pamięci podręcznej po 0,1x. A każde porównanie jest znormalizowane przez wykonaną pracę: albo prompty, które wpisałem, albo wywołania API, które wykonał agent.
Dołącz do naszego newslettera
Otrzymuj najnowsze wskazówki, trendy i oferty za darmo.
Dwie sesje, ten sam agent
To mechanizm na jednym obrazku. Po lewej prawdziwa sesja z 3 września, przed limitem. Po prawej prawdziwa sesja z 15 września, po nim.
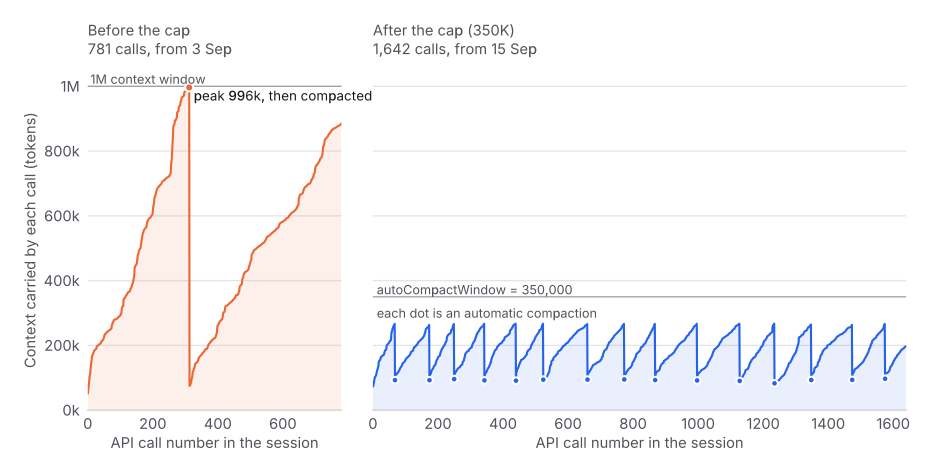
Sesja po lewej trwała 781 wywołań. Urosła do 996 000 tokenów kontekstu, trafiła na ścianę okna 1M, raz się skompaktowała, a potem wróciła prosto do 880 000. Przez drugą połowę tej sesji każde pojedyncze wywołanie odczytywało na nowo ponad pół miliona tokenów.
Sesja po prawej trwała 1642 wywołań, ponad dwa razy dłużej, i nigdy nie niosła więcej niż 270 000. Skompaktowała się piętnaście razy. Każda kompaktacja to kropka.
Liczby tygodniowe
Tylko sesje interaktywne. Słupki to ważone buforowaniem tokeny wejściowe na wywołanie API — to najuczciwsza pojedyncza liczba, bo nie zależy od tego, jak dużo pracowałem w danym tygodniu.
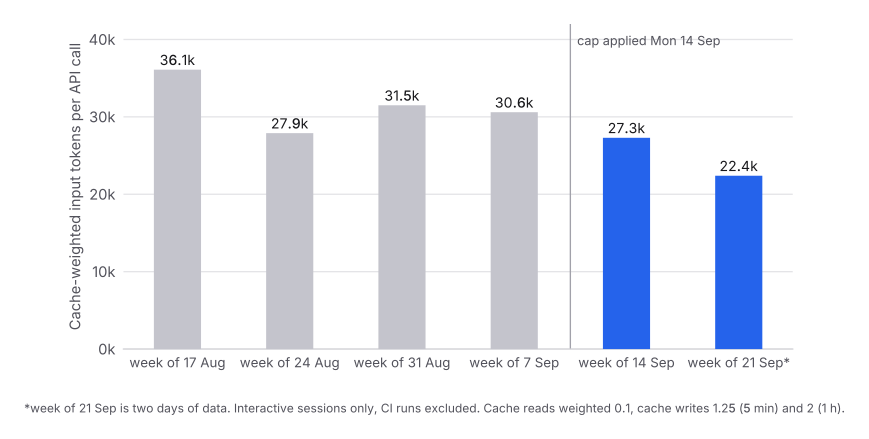
Najczystsze porównanie w zbiorze danych to tydzień od 7 września kontra tydzień od 14 września, bo nie wybierałem ich sam. Po prostu wypadły po obu stronach zmiany, a wpisałem w każdym niemal dokładnie tyle samo promptów.
| Tydzień od | Prompty | Wywołania API | Ważone wejście | Na wywołanie |
|---|---|---|---|---|
| 7 wrz | 971 | 11 364 | 348,1 mln | 30,6 tys. |
| 14 wrz | 968 | 10 555 | 288,5 mln | 27,3 tys. |
971 promptów kontra 968. Efektywne wejście spadło z 348,1 mln do 288,5 mln. To 17% mniej przy tej samej liczbie promptów. Dwa dni kolejnego tygodnia wypadły na 22,4 tys. na wywołanie, czyli jeszcze niżej.
Gdzie uciekały pieniądze
Podziel każde wywołanie API według tego, ile kontekstu niosło, a mechanizm stanie się widoczny wprost.
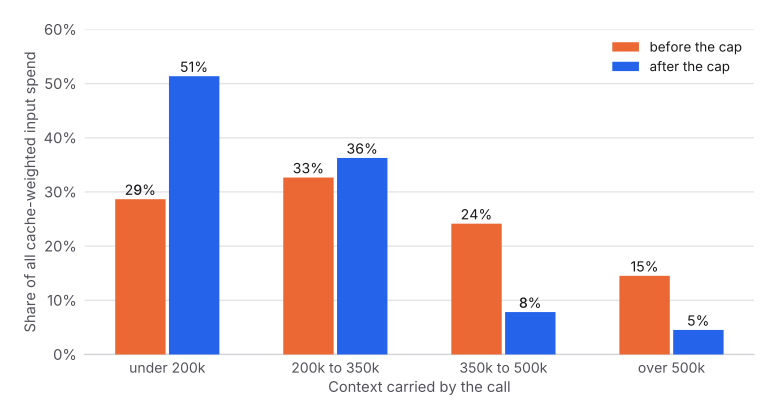
Przed limitem 39% wszystkiego, co wydałem, szło na wywołania wlokące za sobą ponad 350 000 tokenów historii. Te wywołania nie wykonywały więcej pracy niż inne. Wykonywały tę samą pracę, niosąc więcej bagażu. Po limicie ten udział to 12%.
Czy pułap się utrzymał
Jedna kropka na sesję, umieszczona przy największym kontekście, jaki ta sesja kiedykolwiek niosła.
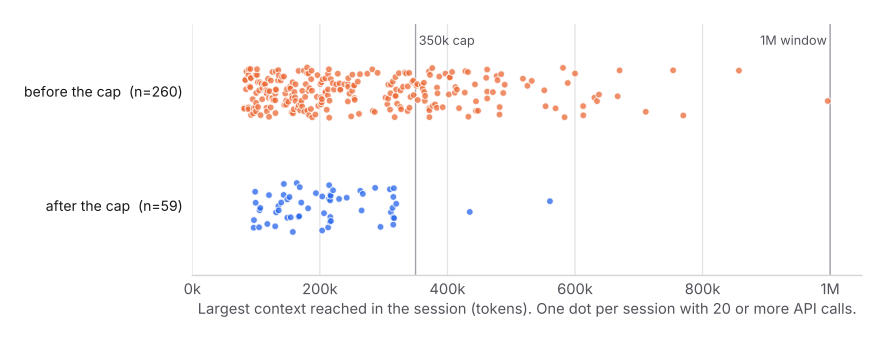
Dwie sesje w pierwszych dwóch dniach wciąż przekroczyły limit, do 434 000 i 561 000, i nie ustaliłem dlaczego. Odkąd 18 września weszło ustawienie 350 000, żadna sesja go nie przekroczyła. Ogon sesji żyjących między 500 tys. a 1 mln, czyli tam, gdzie było najwięcej marnotrawstwa, zniknął.
Ile by to kosztowało bez limitu
Żeby ująć to sumarycznie, odtworzyłem każdą sesję rozpoczętą po zmianie tak, jakby porzucony kontekst nigdy nie został podsumowany i wciąż był odczytywany na nowo przy każdym późniejszym wywołaniu, z ograniczeniem do okna 1M.
| Ważone wejście | |
|---|---|
| Rzeczywiste, 73 sesje, 9675 wywołań, 55 kompaktacji | 216,8 mln |
| Te same sesje bez limitu | 479,2 mln |
| Uniknięto | 262,5 mln, czyli 55% |
Sesja po prawej stronie pierwszego wykresu odpowiada sama za 118,5 mln z tego. Długi refaktor, który inaczej spędziłby swoje ostatnie kilkaset wywołań na odczytywaniu na nowo blisko miliona tokenów każde.
Traktuj 55% jako optymistyczny kraniec. Bez limitu raczej nie pozwoliłbym sesji mielić na 900 tys. przez godziny; w końcu wyczyściłbym ją ręcznie, co też resetuje koszt. Konserwatywny kraniec to zaobserwowana liczba na wywołanie: z 30,6 tys. do 22,4 tys., czyli mniej więcej 20% do 27%. Prawda jest gdzieś pomiędzy tymi dwoma.
Ile to cię kosztuje
To nie jest darmowe i każdy, kto to poleca, powinien to powiedzieć.
Czekanie. 67 kompaktacji od zmiany, mediana około trzech minut każda. Mniej więcej 3,4 godziny patrzenia, jak pisze się podsumowanie, rozłożone na osiem dni.
Trochę przerabiania. Kompaktacja dużo odrzuca. Przy ustawieniu 350K mediana kompaktacji zredukowała sesję o 318 000 tokenów do 24 000. Agent traci szczegóły i czasem je odbudowuje: pliki czytane ponownie w tej samej sesji wzrosły z 11,5% odczytów przed pierwszą kompaktacją do 20,5% po niej. Próba stojąca za tą drugą liczbą jest mała, więc czytaj ją jako kierunek, a nie pomiar.
Wybór progu ma znaczenie. Przy 250K 36% moich długich sesji trafiało na kompaktację. Przy 350K — 12%, a pułap wciąż się trzymał. Ustaw go za nisko, a zapłacisz te trzy minuty i przerabianie raz po raz za oszczędność, którą już zbankowałeś.
Jak to skonfigurować
Claude Code. Dodaj autoCompactWindow do ~/.claude/settings.json. Na modelu z kontekstem 1M najlepsza z trzech wypróbowanych wartości to 350 000. Na modelu 200K przeskaluj w dół i zacznij od około 120 000 do 140 000. Nowe sesje to podchwycą; sesja już działająca zachowuje starą wartość.
Inni agenci. Szukaj tego samego pomysłu pod inną nazwą: wyzwalacz kompaktacji, limit kontekstu, próg „podsumuj i kontynuuj". Jeśli go nie ma, wersją ręczną jest czyszczenie sesji częściej, niż to się wydaje naturalne. Instynkt, by trzymać jedną długą sesję przy życiu przez cały dzień, bo „zna projekt", jest tym drogim.
Czegokolwiek używasz, dwa nawyki dają więcej niż jakiekolwiek ustawienie. Trzymaj trwały stan w plikach, a nie w rozmowie, żeby agent mógł tanio odczytać jeden plik zamiast nosić na zawsze każdą poprzednią odpowiedź. I kieruj pracę ciężką w czytanie do podagentów z ich własnym, krótkotrwałym kontekstem, żeby dwadzieścia plików, które przeczytali, w ogóle nie trafiło do sesji głównej.
Jeśli masz limit tygodniowy
Jeśli płacisz subskrypcją z tygodniowym limitem użycia, a nie rachunkiem za token, to jest dźwignia o najlepszym stosunku nakładu do efektu, jaki znalazłem. Jedna linijka JSON, żadnej zmiany w sposobie pracy, a ten sam limit rozciąga się mierzalnie dalej. W moim przypadku ta sama tygodniowa objętość promptowania kosztowała 17% mniej, a długie sesje około połowy.
Czytaj dalej
Okna kontekstu sprzedaje się jako pojemność. Zachowują się jak licznik, naliczający opłatę za każdą turę za wszystko, co kiedykolwiek w nich umieściłeś. Jeśli chcesz mechaniki stojącej za tym, a nie tylko samego ustawienia, tekst towarzyszący przechodzi przez to, co faktycznie zapełnia okno kontekstu, dlaczego długa sesja kosztuje znacznie więcej niż praca, którą wykonuje, i jak buforowanie, czyszczenie i kompaktacja zmieniają arytmetykę.
